1. 고전적 통찰과 인간의 로봇 동경
인간 능력의 확장과 지능적 조작을 향한 역사적 성찰
인간이 품어온 로봇에 대한 꿈과 본질
"인간이 로봇이나 인조인간, 인조동물에 대하여 품고 있는 꿈과 공상은 크게 나누어서 다음 두 종류로 볼 수 있다. 우선 첫째로 거대한 힘, 하늘을 나는 능력, 물이나 땅속으로 들어갈 수 있는 능력 등 실제 인간에게는 없는 뛰어난 능력을 가진 생물에 대한 동경이며, 다른 하나는 인간 대신에 힘든 작업을 행하며 인간이 말하는 것은 무엇이든지 들어주는 하인과 같은 인조물을 소유하고 싶다는 욕망이다."
인공지능의 진정한 도전 과제
"인공지능 연구의 가장 본질적인 도전 과제는 로봇들에게 10세 수준의 사회적 소양, 6세 수준의 손재주(Dexterity), 4세 수준의 언어 기술, 그리고 2세 수준의 시각적 물체인식 능력을 부여하는 것이다."
이는 전통적인 기호 추론(체스나 논리식 계산)보다 어린아이가 물리 세계에서 장난감을 쥐고 걸어 다니는 감각-운동(Sensory-Motor) 능력이 기계에게 훨씬 어렵다는 통찰을 극명하게 보여줍니다.
인간 기능과 로봇 공학적 대응 체계
인간의 감각기관, 두뇌 인지, 근육 및 골격계가 로봇 센서, 제어 컴퓨터, 액추에이터로 사상되는 메커니즘
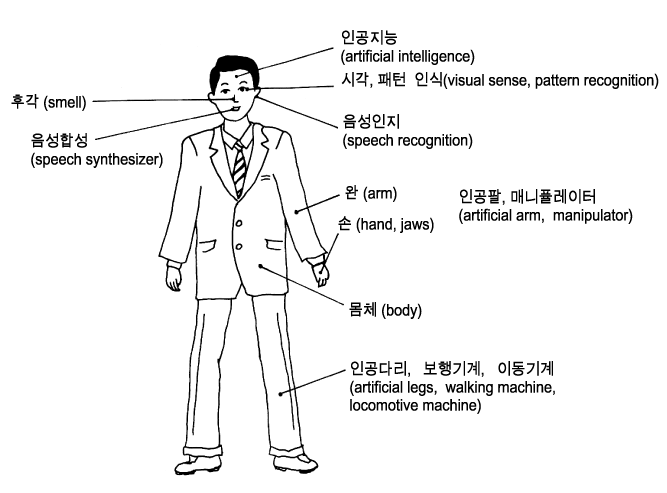
▲ [그림] 인간의 두뇌(사고·기억·판단), 눈·귀·코·피부(감각 수용기), 팔·다리(작동기)와 로봇의 컴퓨터, 센서, 구동기 매핑
시각(카메라), 청각(마이크), 촉각(압력·변형 센서), 후각(인공코), 위치·가속도(엔코더, IMU, 자이로스코프)
상태 추정, 환경 지도 작성(SLAM), 경로 계획(Motion Planning), 판단 및 지능적 의사결정 엔진
전기 모터(서보·BLDC), 유압·공압 실린더, 로봇 팔(Manipulator), 그리퍼(End-effector), 보행 다리/바퀴
2. 인공지능(AI)에서 로봇(Robot)이 가지는 의미
순수 기호 추론을 넘어 물리적 세계와 호흡하는 '체화된 지능(Embodied AI)'의 본질
2.1 체화된 인공지능 (Embodied AI) 과 신체성 (Embodiment)
인공지능 초기 수십 년간 주류를 이루었던 기호주의(Symbolic AI)는 인간의 지능을 튜링 머신처럼 '추상적인 기호의 조작'으로 보았습니다. 그러나 화면 속 소프트웨어 에이전트와 달리, 로봇은 물리적 신체(Physical Body)를 가지고 현실 세계의 법칙(중력, 마찰력, 관성, 예기치 않은 외력)과 직접 부딪히는 유일한 인공지능입니다.
인지과학과 철학의 체화 인지(Embodied Cognition) 이론에 따르면, 지능은 고립된 두뇌 속에서 수학적 연산만으로 발생하는 것이 아니라, 신체와 환경이 끊임없이 상호작용하는 과정에서 발현(Emergence)됩니다. 로봇은 AI가 비물리적 가상 세계의 한계를 깨고 실제 물리 현실을 이해하기 위한 필수불가결한 전제조건입니다.
2.2 감각-인지-행동 폐루프 (Perception-Cognition-Action Closed Loop)
전통적인 컴퓨팅이 입력 ➔ 일회성 처리 ➔ 출력의 단방향 구조라면, 로봇의 지능은 연속적인 닫힌 루프(Closed-loop)입니다.
- 감각(Perception): 카메라, 라이다, 촉각 센서 등을 통해 노이즈와 불확실성이 가득한 외부 환경 데이터를 실시간 수집합니다.
- 인지 및 계획(Cognition & Planning): 현재 자신의 위치와 환경 상태를 추정하고, 목표를 달성하기 위한 최적의 궤적 및 제어 명령을 계산합니다.
- 행동(Action): 액추에이터를 작동시켜 환경에 물리적 힘을 가합니다. 이 행동은 환경을 변형시키고, 변형된 환경은 다시 새로운 감각 입력으로 되돌아옵니다.
이러한 동적 상호작용 루프 속에서만 로봇은 "내가 밀었더니 컵이 넘어졌다"는 인과관계(Causality)와 물리적 상식을 체득할 수 있습니다.
2.3 모라벡의 역설 (Moravec's Paradox) 과 지능의 계층 구조
"체스나 미적분 풀이 등 인간 성인이 수년간 학습해야 하는 고차원 지적 작업은 컴퓨터에게 매우 쉽지만, 한 살짜리 아기도 하는 걷기, 컵 집기, 문손잡이 돌리기, 방 안을 두리번거리며 사물을 인식하는 감각-운동 기능은 컴퓨터에게 가장 어렵다."
— 한스 모라벡 (Hans Moravec), 로드니 브룩스, 마빈 민스키
인간의 추상적 지능(논리, 체스, 언어)은 기껏해야 수만 년의 진화 역사에 불과하지만, 물리 세계에서 이동하고 물체를 다루는 감각-운동계는 수억 년에 걸쳐 진화한 극도로 정교하고 방대한 신경망의 산물입니다. 로봇 공학은 AI가 이 "가장 오래되고 가장 단단한 진화의 기반(Sensory-Motor Intelligence)"을 정복하도록 강제하는 결정적 역할을 합니다.
2.4 포섭 구조 (Subsumption Architecture) 와 심볼 그라운딩 문제 해결
로드니 브룩스 교수는 거대한 세계 모델(World Model)을 기호로 구축하려던 고전 AI의 한계를 비판하며, "세계 그 자체가 최고의 모델이다 (The world is its own best model)"라는 명제를 내세웠습니다. 곤충처럼 단순한 계층적 반사 행동 모듈(장애물 회피 ➔ 전진 ➔ 먹이 탐색)들이 환경과 즉각 반응하며 복잡한 지능을 발현하는 포섭 구조(Subsumption Architecture)를 제안했습니다.
동시에 로봇은 컴퓨터 언어 속 기호(예: '사과', '무겁다', '떨어뜨리다')가 실제 물리 세계의 색상, 형태, 무게, 관성과 어떻게 일치하는지를 검증하는 심볼 그라운딩(Symbol Grounding Problem)을 해결할 수 있는 유일한 열쇠입니다.
[인포그래픽 1] 체화된 인공지능(Embodied AI)의 감각-인지-행동 폐루프 아키텍처
로봇은 물리 세계로부터 감각 정보를 획득하고, 인지 추론을 거쳐 물리적 행동을 가하며, 그 결과로 변화한 환경을 다시 감지하는 끊임없는 체화 순환 고리를 형성합니다.
3. 최신 LLM의 발전이 로봇에게 가지는 특별한 의미
기계 껍데기에 '물리적 상식'과 '범용 두뇌'를 불어넣은 VLA(Vision-Language-Action) 모델의 혁신
오랫동안 로봇 공학은 정밀한 기계 부품과 고출력 모터가 갖추어졌음에도 불구하고, 공장 조립 라인을 벗어나 가정이나 물류 창고 같은 비구조적 환경(Unstructured Environments)에 진입하면 극심한 무력감에 빠졌습니다. 환경이 1cm만 틀어지거나 예상치 못한 장애물이 나타나면 오작동을 일으켰기 때문입니다. 그러나 대규모 언어 모델(LLM)과 시각-언어 모델(VLM)의 발전은 로봇에게 혁명적인 전환점을 가져왔습니다.
3.1 VLA (Vision-Language-Action) 파운데이션 모델의 탄생
구글 딥마인드의 RT-1, RT-2, 스탠퍼드의 OpenVLA, Octo, 코베리언트(Covariant)의 RFM-1 등 최신 로봇 파운데이션 모델은 언어와 이미지 토큰뿐만 아니라 로봇의 행동(Action: 관절 각도, 그리퍼 개폐, 6자유도 이동 벡터)을 하나의 통일된 오토리그레시브(Auto-regressive) 토큰 시퀀스로 취급합니다.
입력 토큰: [시각 이미지] + "테이블 위에 엎질러진 콜라를 닦아줘" (자연어 명령)
출력 토큰: [Action Token: Δx, Δy, Δz, Δroll, Δpitch, Δyaw, Gripper_Open/Close] ➔ 직접 모터 구동
인터넷 상의 수십억 건 텍스트·이미지로 학습된 LLM의 방대한 개념적 지식이 로봇의 구동 명령과 직접 연결됨으로써, 별도의 개별 제어기 없이도 하나의 거대 신경망이 로봇의 감각과 운동을 엔드투엔드(End-to-End)로 통합하게 되었습니다.
3.2 추상적 자연어 지시의 자율적 하위 작업 분해 (Semantic Task Decomposition)
전통 로봇 공학에서는 "사과를 씻어서 접시에 담아라"라는 명령을 수행하려면 수백 줄의 하드코딩된 상태 기계(State Machine)와 조건문이 필요했습니다. 반면 최신 LLM(예: SayCan, Code as Policies, VoxPoser)은 복잡한 자연어 지시를 인간과 같은 상식적 추론을 바탕으로 자율 분해합니다:
LLM의 인과 추론 능력(Chain of Thought)이 로봇에게 "무엇을 어떤 순서로 해야 하는가"를 알려주는 고수준 플래너(High-level Planner)의 역할을 완벽하게 담당합니다.
3.3 제로샷 일반화 (Zero-shot Generalization) 와 물리적 상식 (Physical Commonsense)
기존 로봇 학습은 훈련에 사용된 특정 컵, 특정 장소에서만 작동했습니다. 색깔이나 조명이 바뀌면 즉시 실패했습니다. 그러나 사전 학습된 멀티모달 LLM은 태어나서 처음 보는 기괴한 모양의 머그잔이나 신제품 과자 봉지도 "잡을 수 있는 손잡이"나 "부서지기 쉬운 물체"라는 상식을 즉각 유추합니다.
"목이 마르다"는 모호한 인간의 말에 물이나 음료수 캔을 찾아 가져다주는 의도 파악(Intent Understanding) 및 어포던스 그라운딩(Affordance Grounding)이 제로샷(Zero-shot)으로 실현되었습니다.
3.4 실시간 자가 수정 및 폐루프 리플렉션 (Closed-Loop Reflexion & Error Recovery)
로봇이 물체를 집으려다 미끄러져 떨어뜨렸을 때, 고전 로봇은 물체가 없어진 줄도 모르고 허공에 다음 동작을 수행합니다. 반면 VLM/LLM 기반 로봇은 시각적 피드백을 통해 실패를 즉시 인식하고, "그리퍼가 미끄러졌으니 다시 물체에 접근하여 파지력을 높여 재시도한다"는 자기 교정(Self-Correction / Reflexion)을 실시간으로 수행합니다.
3.5 휴머노이드 (Humanoid) 로봇 르네상스의 '두뇌' 탑재
최근 테슬라의 옵티머스(Optimus), 오픈AI와 협업한 피규어 01/02(Figure), 보스턴 다이내믹스의 전기식 아틀라스(Atlas), 유니트리(Unitree) 등 휴머노이드 하드웨어는 눈부시게 발전했습니다. 그러나 이 몸체를 조종할 '일반 지능(General Intelligence)'이 부재했습니다.
LLM과 VLA의 등장은 마침내 휴머노이드 로봇에게 '인간 수준의 지시를 이해하고 물리 세계를 자율 탐색하는 두뇌'를 선사했으며, 전 세계 AI 산업이 소프트웨어 화면 속 텍스트 챗봇을 넘어 '피지컬 AI(Physical AI)'로 진화하는 기폭제가 되었습니다.
[인포그래픽 2] 전통적 로봇 파이프라인 vs 최신 LLM 기반 VLA 로봇 아키텍처 비교
복잡한 하드코딩 파이프라인 대신, 언어-시각-로봇행동 토큰을 하나로 통합한 VLA 파운데이션 모델이 비구조화된 환경에서 자율적 조작을 완성합니다.
4. 연관 인공지능 학문 분야 (Related Disciplines)
로봇 지능을 구성하는 핵심 인공지능 연구 분야 상호 연결망
5. 추천 강의 및 학술 비디오 (Preserved Video Lectures)
스탠퍼드, MIT 및 국내 과학 다큐멘터리 명강의 아카이브
Introduction to Robotics : Stanford
강의: Oussama Khatib 교수 (2008)
로봇 공간 기하학, 정기구학(Forward Kinematics), 역기구학, 자코비안(Jacobian) 행렬 및 동역학 제어의 세계적 표준 고전 강의.
Underactuated Robotics : MIT OCW
강의: Russell Tedrake 교수 (Spring 2009)
구동기보다 자유도가 많은 과소구동(Underactuated) 시스템, 동적 보행, 비선형 최적 제어 및 강화학습의 기초를 다루는 명강의.
인류를 위한 새바람 4차산업혁명 3회 - 로봇
방송: YTN SCIENCE (2017)
산업용 매니퓰레이터에서 지능형 서비스 로봇과 재난 구호 로봇으로 발전하는 대한민국 및 글로벌 로봇 산업의 생생한 현장.