기계번역 (Machine Translation)
언어의 장벽을 허무는 컴퓨터 자동번역에서 현대 초거대 언어모델(LLM)의 핵심 아키텍처까지
기계번역은 서로 다른 자연어 간의 정보 변환을 컴퓨터가 자동으로 수행하는 인공지능의 기념비적 연구 분야입니다. 1950년대 컴퓨터 최초의 비수치 응용으로 출발하여, 오늘날 생성형 AI와 초거대 언어모델(LLM)을 탄생시킨 트랜스포머(Transformer)와 어텐션 메커니즘의 요람이 되었으며, 다국어 인지 지능의 핵심 교량 역할을 수행하고 있습니다.
기계번역의 개념과 언어학적 도전 과제 (Concept & Linguistic Challenges)
서로 다른 두 개의 자연어, 즉 영어와 한국어 사이, 혹은 일어와 한국어 사이의 번역을 컴퓨터와 소프트웨어가 자동적으로 해주는 것을 기계번역 (Machine Translation) 이라고 한다. 세계화 시대에 언어의 장벽을 없애고 국가 간 경계를 허무는 결과를 초래하여 세계를 하나로 만드는 핵심 지능 기술이다.
컴퓨터의 최초의 비수치 (Non-numeric) 응용 중의 하나는 기계 번역이었다. 원시언어(Source Language)의 문장을 대상언어(Target Language)의 문장으로 단순히 1:1 직역 치환하는 초기 방식은 처참히 실패하였다. 한 문장을 어떤 언어에서 다른 언어로 번역하기 위해서는 반드시 먼저 문장의 심층 의미(Semantics)와 문맥(Context)을 이해하여야 한다. 이를 소홀히 하는 시스템은 다음과 같은 치명적인 문제점을 겪게 된다.
1. 단어의 애매함 (Word Sense Ambiguity)
Polysemy원시언어의 한 단어가 다의어(여러 의미)를 가질 때, 대상언어에서는 각각 서로 다른 단어로 대응됩니다. 문맥을 정밀하게 파악해야만 원시언어에 적합한 단어를 선택할 수 있습니다. (예: 배 = Boat, Pear, Belly)
2. 문법의 애매함 (Syntactic Ambiguity)
Structural원시언어에서 구조적으로 애매한 문장이 가질 수 있는 여러 의미가 대상언어에서 완전히 상이한 문법 구조로 표출될 때, 수식 관계와 어순을 정확히 파악해야 오역을 방지합니다.
3. 대용어 및 상호참조 (Anaphora & Coreference)
Pronouns원시언어의 대명사(It, They, He, She)가 대상언어에서 성별, 수, 존칭 등에 따라 서로 다른 대명사로 바뀌어야 할 때, 해당 대명사가 앞서 언급된 무엇을 가리키는지 정확한 참조(Reference) 해결이 필수적입니다.
4. 숙어 및 관용구 (Idioms & Metaphor)
Cultural원시언어의 관용구나 은유는 글자 그대로 직역되어서는 절대 안 됩니다. 문화적 배경과 관용적 의미를 파악하여 대상언어의 등가 표현으로 재창작되어야 합니다.
📜 기계번역사의 전설적인 오역 사례 (초기 직역 시스템의 한계)
영어 문장 "The spirit is willing but the flesh is weak." (마음은 원이로되 육신이 약하도다 : 마태복음 26:41의 구절로서 인간의 의지가 유혹에 쉽게 흔들린다는 뜻)를 러시아어로 기계번역한 뒤, 그 러시아어를 다시 영어로 역번역(Back-translation)해 보았더니 "The vodka is good but the meat is rotten." (보드카는 좋지만 고기는 상하였다)라는 완전히 엉뚱한 결과가 나온 일화가 유명합니다. 단어 개별의 사전적 의미(Spirit = 알코올/증류주, Flesh = 식용 고기)만을 1:1로 대입했을 때 발생하는 대표적 파국을 보여줍니다.
구식 기계번역 모델 vs 신형 기계번역 모델 (다이어그램 비교)
초기의 직접 번역 방식에서 문맥과 의미를 모델링하는 진보된 기계번역 방식으로의 패러다임 전환을 원본 아카이브 다이어그램을 통해 비교합니다.
직접 대응 사전식 번역 모델
원시언어 문장을 대상언어 문장으로 사전과 지극히 단순한 규칙을 통해 직접 치환합니다. 심층 의미 분석이 배제되어 문법 파괴와 치명적 오역이 불가피했습니다.
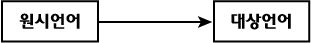
[도식 1] 구식 기계번역 프로그램 : 원시언어 → 사전/단순규칙 → 대상언어
구문 · 의미 분석 기반 번역 모델
원시언어의 구조와 의미를 먼저 완전히 해석(Understanding)하여 추상 표현으로 변환한 뒤, 이를 대상언어의 문법 체계에 맞추어 재생성(Synthesis)합니다.

[도식 2] 신형 기계번역 프로그램 : 원시언어 → 해석/이해 → 생성 → 대상언어
[인포그래픽] 기계번역 70년사 : 4대 세대별 기술 진화
1950년대 조지타운-IBM 실험의 규칙 기반 번역에서 오늘날 전 세계 수십억 명이 실시간으로 사용하는 트랜스포머 및 LLM 기반 번역까지의 비약적 도약 과정입니다.
제1세대 : 규칙 기반 기계번역 (RBMT: Rule-Based MT)
1950s ~ 1980s
• 핵심 기술: 대규모 이중 언어 사전, 형태소 분석기, 촘스키 통사 규칙, 중간언어(Interlingua), SYSTRAN
• 특징: 언어학자가 수작업으로 구축한 수만 개의 문법 규칙으로 번역. 문법적 정확성은 있으나 예외 처리 불가 및 어색한 번역투.
제2세대 : 통계적 기계번역 (SMT: Statistical MT)
1990s ~ 2014
• 핵심 기술: IBM 모델 1~5, 구문 기반 번역(Phrase-based SMT), 언어 모델(N-gram), Moses 엔진, 초기 Google 번역
• 특징: 대규모 병렬 코퍼스(Parallel Corpora)에서 단어·구의 확률적 대응을 학습. 어휘 선택은 자연스러워졌으나 장거리 어순 도치 한계.
제3세대 : 신경망 기계번역 (NMT: Neural MT)
2014 ~ 2017
• 핵심 기술: Sequence-to-Sequence (Seq2Seq), 인코더-디코더(Encoder-Decoder), 바흐다나우(Bahdanau) 어텐션, Google GNMT(2016)
• 특징: 문장 전체를 연속적 고차원 벡터로 압축한 후 어텐션으로 단어 간 연결을 동적 계산. 문맥 이해도와 번역 품질의 극적 혁신.
제4세대 : 트랜스포머 & 초거대 언어모델 번역 (Transformer & LLM MT)
2017 ~ 현재
• 핵심 기술: Transformer(Vaswani et al., 2017), GPT-4, Claude, Gemini, DeepL, Meta NLLB-200, 인컨텍스트 번역, 멀티모달 번역
• 특징: 전 세계 지식과 상식을 갖춘 파운데이션 모델이 문맥·문화·전문 용어를 종합 고려하여 인간 전문 번역가 수준의 번역 구현.
[Deep Research] 현대 AI 와 LLM 에서 기계번역(MT)이 가지는 기념비적 의미
인공지능의 역사에서 기계번역은 단순한 하나의 응용 프로그램이 아니었습니다. 현대 생성형 AI와 초거대 언어모델(LLM)을 탄생시킨 핵심 아키텍처와 개념적 돌파구는 모두 기계번역 문제를 풀기 위한 치열한 연구 과정에서 탄생했습니다.
1. 트랜스포머(Transformer) 아키텍처의 요람
Birth of Transformer2017년 구글의 기념비적 논문 "Attention Is All You Need" (Vaswani et al.)는 다름 아닌 기계번역(WMT 2014 영-독, 영-불 번역 벤치마크)을 정복하기 위해 제안되었습니다. 순환신경망(RNN)의 순차 처리 한계를 극복하고 Self-Attention을 도입한 트랜스포머는 오늘날 GPT, Claude, Gemini 등 모든 현대 LLM의 심장이 되었습니다.
2. 교차 언어 공통 잠재 공간 (Cross-lingual Latent Space)
Universal Embedding기계번역 모델은 서로 다른 언어의 기호들을 수천 차원의 고차원 벡터 공간에서 동일한 '개념(Concept)' 클러스터로 정렬시킵니다. 이로 인해 LLM은 영어로 학습한 지식과 논리적 추론 능력을 한국어나 프랑스어로 질문받았을 때도 즉시 활용하는 제로샷 교차 언어 전이(Zero-shot Cross-lingual Transfer)를 발휘합니다.
3. Seq2Seq와 인코더-디코더 패러다임의 확립
Encoder-Decoder가변 길이의 입력 시퀀스를 가변 길이의 출력 시퀀스로 매핑하는 Seq2Seq(Sutskever et al., 2014)와 어텐션 메커니즘(Bahdanau et al., 2014)은 기계번역에서 시작되어 텍스트 요약, 코드 생성, 대화형 질의응답 등 모든 현대 자연어 생성(NLG)의 표준 프레임워크가 되었습니다.
4. AI-Complete(인공지능 완전) 문제의 시험대
AI-Complete번역은 언어의 문법뿐만 아니라 인간의 상식, 물리 세계 법칙, 화자의 심리, 사회적 문화 맥락을 모두 이해해야만 완전해집니다. 따라서 기계번역 성능의 향상은 곧 인공지능 모델이 인간의 종합적 인지 능력에 얼마나 근접했는지를 평가하는 가장 엄격한 지표로 작동합니다.
기계번역의 최신 기술 트렌드 5선 (State-of-the-Art MT Technologies)
인공지능과 대규모 파운데이션 모델의 결합으로 기계번역은 단순 문장 변환을 넘어 실시간 음성 번역, 문서 전체의 문맥 보존, 전문 도메인 적응으로 비약적인 기술 혁신을 이루고 있습니다.
1. 대규모 다국어 모델 (Massively Multilingual)
NLLB-200Meta의 NLLB(No Language Left Behind) 및 구글 1000개 언어 프로젝트처럼 200개 이상의 언어를 단일 모델로 지원하며, 데이터가 극히 적은 아프리카·아시아의 저자원 언어(Low-resource) 번역 품질을 획기적으로 향상시켰습니다.
2. 문서 수준 문맥 번역 (Document-Level MT)
Context-Aware문장 단위로 쪼개어 번역하던 과거와 달리, 수천 토큰 이상의 문서 전체를 한 번에 입력받아 대명사 참조, 담화 표지(Discourse Markers), 한국어 특유의 경어체(존댓말/반말) 일관성을 문서 전체에서 완벽히 유지합니다.
3. 멀티모달 직접 음성 번역 (Speech-to-Speech)
SeamlessM4T음성을 텍스트로 바꾸고 다시 음성으로 합성하는 3단계 지연을 없애고, 음성에서 음성으로 직접 번역하며 원 화자의 목소리 음색, 억양, 감정을 보존하는 제로샷 보이스 클로닝(Zero-shot Voice Cloning) 번역이 상용화되었습니다.
4. 신경망 품질 추정 (Quality Estimation)
COMET & BLEURT단순 단어 일치율에 의존하던 전통적 BLEU 점수를 극복하고, 사전 훈련된 신경망 임베딩 기반의 COMET, BLEURT 평가 지표를 통해 정답 번역문 없이도 기계번역 결과의 유창성과 충실성을 실시간으로 자동 판정합니다.
5. 검색 증강 번역 (RAG & Adaptive MT)
RAG Terminology법률, 의료, 반도체 등 고도의 전문 분야에서 기업 전용 용어집(Glossary)과 번역 메모리(TM)를 실시간 검색 증강(RAG)하여 프롬프트에 주입함으로써 할루시네이션(환각)을 원천 차단하고 전문 용어 정확도를 극대화합니다.
6. 프롬프트 제어 번역 (In-Context MT)
DeepL & GPT-4"비즈니스 이메일 톤으로 번역해 줘", "초등학생이 이해하기 쉽게 번역해 줘"와 같이 번역의 문체(Tone), 목적, 대상 독자를 자연어 프롬프트 지시(Instruction)만으로 실시간 적응 조절할 수 있습니다.
기계번역의 발전 역사와 국제기구의 대규모 프로젝트
유럽과 미국에서는 기계번역 시스템에 의한 연구와 실용화가 비교적 오래전부터 진행되었다. 기계번역을 가장 절실히 필요로 했던 곳은 다국어 문서 처리가 폭증하던 국제연합(UN)과 유럽공동체(EC) 등 국제기관이었다.
🌐 유럽 EC · EUROTRA 프로젝트 · SYSTRAN
EC에서는 1982년에 이미 라메테크사가 개발한 SYSTRAN이라는 기계번역 시스템을 도입하여 영어·불어 등 공용어 간 번역에 사용하였다. 당시 EC에는 12개국이 가맹되어 9가지 언어를 공식어로 사용하고 있었으므로 총 81개 방향(Pair)의 방대한 번역 작업이 필요했다. 이에 따라 유럽 각국 연구진이 연합하여 EUROTRA라는 대규모 81방향 자동번역 시스템 개발에 착수하였다.
🇰🇷 대한민국 기계번역의 태동 (1985 SERI)
한국에서는 1985년 한국과학기술연구원(KIST) 시스템공학연구소(SERI)에서 한-일, 영-한 기계번역 시스템 개발을 공식 착수하였다. 이후 국내 유수 대학 및 포스텍, 서울대, KAIST, 그리고 솔트룩스 등 국내 전문 기업들로 연구가 확산되어 오늘날 네이버 파파고(Papago) 및 대규모 한국어 LLM 번역 기술로 계승되었습니다.
추천 강연 영상 & 기계번역 학술 자료 (Featured Video & Resources)
국내 자연어처리 및 인공지능 기업 전문가의 강연 영상과 관련 학술 디렉터리 링크입니다.