데이터베이스 내 지식발견(KDD, Knowledge Discovery in Databases)은 1996년 우사마 파이야드(Usama Fayyad), 그레고리 피아테츠키-샤피로(Gregory Piatetsky-Shapiro), 파드릭 스미스(Padhraic Smyth) 등에 의해 정립된 데이터 과학의 핵심 개념입니다.
🎯 KDD가 정의하는 '진정한 지식'의 4대 요건
1. 타당성 (Validity)
발견된 패턴이나 규칙이 새로운 데이터나 미래의 관측치에서도 일정 수준 이상의 확실성(확률)을 가지고 들어맞아야 합니다.
2. 참신성 (Novelty)
기존에 이미 상식적으로 널리 알려진 사실이 아니라, 사용자가 미처 인지하지 못했던 새롭고 예상 밖의 통찰이어야 합니다.
3. 유용성 (Usefulness)
단순한 수학적 호기심에 그치지 않고, 비즈니스 가치 창출, 의사결정 개선, 정책 수립 등에 실질적으로 기여할 수 있어야 합니다.
4. 이해 가능성 (Understandability)
도출된 패턴이 인간 전문가나 최종 사용자에게 해석 가능(Interpretable)하고 논리적으로 납득될 수 있는 형태로 표현되어야 합니다.
⚖️ KDD(지식발견)와 데이터마이닝(Data Mining)의 관계
현업에서는 '데이터마이닝'과 '지식발견'을 혼용하기도 하지만, 학술적·공학적 관점에서 KDD는 문제 정의부터 현장 배포까지의 '전체 생명주기(Lifecycle)'를 의미하며, 데이터마이닝은 그 안에서 알고리즘을 적용하는 '핵심 단위 단계'를 뜻합니다.
| 비교 항목 | 지식발견 (KDD Process) | 데이터마이닝 (Data Mining) |
|---|---|---|
| 개념적 범위 | 비즈니스 문제 정의부터 최종 지식 활용까지 포괄하는 전 과정 | 변환된 데이터로부터 통계/ML 모델을 이용해 패턴을 추출하는 단일 단계 |
| 투입 노력 비중 | 데이터 정제, 통합, 변환, 평가 등 전후 과정에 80% 이상 투입 | 알고리즘 튜닝 및 학습 연산에 약 15~20% 투입 |
| 핵심 목표 | 조직의 문제 해결과 가치 창출을 위한 실행 가능한 지식(Actionable Knowledge) 획득 | 수학적/통계적 관점에서 데이터 내 규칙, 군집, 분류 경계(Patterns) 도출 |
| 작업 특성 | 인간 분석가의 도메인 지식과 상호작용하는 반복적·피드백적 탐색 과정 | 사전 정의된 목적 함수를 최적화하는 수치적·알고리즘적 처리 |
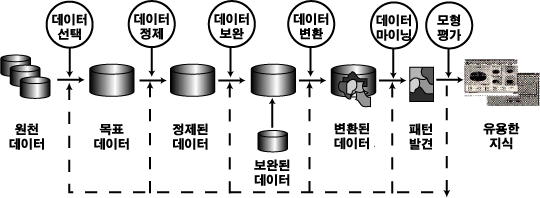
⚠️ 지식발견 프로젝트의 핵심: '80%의 법칙'
많은 이들이 화려한 데이터마이닝 및 딥러닝 알고리즘에만 역량을 집중하기 쉽습니다. 하지만 원천 데이터의 품질이 보장되지 않으면(Garbage In, Garbage Out) 아무리 뛰어난 알고리즘도 무의미한 결과를 도출합니다. 데이터 정제(Cleaning), 보완(Enrichment), 변환(Transformation) 단계는 프로젝트 전체 일정과 노력의 80% 이상을 차지하는 가장 결정적인 단계입니다.
1단계: 데이터의 선택 (Data Selection)
비즈니스 목표를 명확히 이해하고, 해결하고자 하는 문제에 직접 관련된 데이터셋을 식별하여 대상 데이터(Target Data)를 추출합니다. 사내 ERP, CRM, 데이터 웨어하우스(DW), 웹 로그 등 이기종 데이터 소스 중 분석에 필수적인 변수와 샘플을 선별하는 단계입니다.
2단계: 데이터의 정제 (Data Cleaning)
데이터 수집 과정에서 필연적으로 발생하는 결측값(Missing Values), 잡음(Noise), 오기입, 극단적 이상치(Outliers)를 탐지하고 교정합니다. 통계적 대체법(평균/중앙값 대입, 회귀 대체)이나 이상치 제거/보정을 통해 데이터의 순도와 신뢰성을 확보합니다.
3단계: 데이터의 보완 및 통합 (Data Enrichment & Integration)
내부 데이터만으로 현상을 설명하기 부족할 때 외부 공공 데이터, 기상 정보, 거시경제 지표, 시장 데이터 등을 결합하여 분석 대상의 특성을 입체화합니다. 여러 테이블 간의 키(Key) 일치성 및 무결성을 검증하며 풍부한 컨텍스트를 부여합니다.
4단계: 데이터의 변환 및 특징 공학 (Data Transformation & Feature Engineering)
데이터마이닝 알고리즘이 최적의 성능을 낼 수 있도록 수치 범위를 맞추는 정규화(Min-Max) 및 표준화(Z-score), 범주형 변수의 원-핫 인코딩(One-Hot Encoding), 연속형 변수의 구간화(Binning), 주성분 분석(PCA)을 통한 차원 축소를 수행합니다.
5단계: 데이터마이닝 기법 선택 및 적용 (Data Mining Selection & Application)
분석 목적(예측, 분류, 군집, 규칙 발견)에 가장 적합한 지능형 알고리즘을 선택하여 모델을 학습시킵니다. 의사결정나무(Decision Tree), 앙상블(Random Forest, XGBoost), 신경망(Neural Networks), 군집분석(K-Means), 연관규칙(Apriori) 등을 적용하여 숨겨진 패턴을 도출합니다.
6단계: 모형의 평가 및 지식 해석 (Model Evaluation & Interpretation)
도출된 패턴이 통계적으로 유의미한지 교차 검증(Cross-validation), 혼동 행렬(Confusion Matrix), ROC-AUC, Lift 차트 등으로 엄밀히 평가합니다. 발견된 지식이 도메인 상식과 모순되지 않는지 전문가가 정성적으로 검증하고, 시각화 도구를 통해 이해 가능한 형태로 표현합니다.
🔁 지식발견의 본질: 양방향 상호작용 피드백 루프 (Iterative Loop)
지식발견은 결코 1단계에서 6단계로 직진하는 일회성(One-way) 작업이 아닙니다.
- 정제 단계로의 역행: 5단계 마이닝 과정에서 예측 불가능한 왜곡이나 결손치가 발견되면 다시 2단계 정제로 돌아가 결측치 대입 방식을 수정합니다.
- 보완 및 특징 재설계: 모델의 설명력이 떨어질 경우 3단계로 되돌아가 새로운 외부 속성을 결합하거나 4단계에서 새로운 파생 변수를 발굴합니다.
- 도메인 지식의 누적: 6단계에서 최종 검증된 지식은 다음 KDD 주기의 사전 지식(Prior Knowledge)으로 재투입되어 모델의 탐색 정확도를 지속적으로 고도화합니다.
전통적 KDD가 관계형 테이블 형태의 정형 수치 데이터 위주였다면, 현대 인공지능(AI)과 결합된 KDD는 딥러닝 잠재 표현 학습, 멀티모달 비정형 데이터, 지식 그래프 융합, 설명 가능한 AI(XAI)로 혁신적인 진화를 거듭하고 있습니다.
🤖 1) 자동화된 피처 추출 및 AutoML (AutoKDD)
과거 분석가가 수작업으로 파생 변수를 설계하던 방식에서 벗어나, 심층 신경망(Deep Neural Networks)의 오토인코더(Autoencoder)와 트랜스포머 임베딩이 데이터 내의 비선형적 상호작용과 잠재 표현(Latent Features)을 자율적으로 추출합니다.
🌐 2) 비정형 멀티모달 지식 발견 (Multimodal KDD)
텍스트, 이미지, 음성, 비디오, 시계열 센서 등 다양한 모달리티의 데이터를 벡터 공간(Vector Space) 상에 정렬(Alignment)하여, 이종 데이터 간의 의미적 유사성과 은닉된 지식을 통합 마이닝합니다.
🕸️ 3) 뉴로-심볼릭 융합 (Neuro-Symbolic KDD)
딥러닝의 뛰어난 통계적 패턴 인식 능력과 기호주의 AI의 엄밀한 지식 그래프(Knowledge Graph) 및 온톨로지 논리 추론을 결합합니다. 이를 통해 블랙박스 신경망이 도출한 결과에 명확한 인과성(Causality)과 논리적 근거를 부여합니다.
🔍 4) 설명 가능한 AI (XAI) 및 발견 지식의 해석성
SHAP, LIME, 의사결정나무 대리 모델(Surrogate Models)을 도입하여, 복잡한 AI 모델이 어떤 데이터 속성에 기반하여 해당 결론에 도달했는지 설명(Attribution)함으로써 의료, 금융, 제조 등 고위험 분야에서 지식의 신뢰성을 보장합니다.
수천억 개의 파라미터를 가진 초거대 언어 모델(LLM)의 성공은 모델 아키텍처보다 '어떤 데이터를 어떻게 큐레이션하여 학습시켰는가'에 달려 있습니다. KDD 프로세스는 LLM의 사전학습 말뭉치 필터링부터 지식 그래프 구축, 환각 억제에 이르기까지 전 주기를 지배합니다.
사전학습(Pre-training) 원시 웹 코퍼스의 KDD 정제 파이프라인
인터넷 웹 크롤링 데이터(Common Crawl 등)는 광고, 스팸, 기계 번역 오류, 중복 텍스트 등 막대한 노이즈를 포함합니다. KDD의 데이터 정제 및 변환 기법(MinHash LSH 기반 중복 제거, 텍스트 품질 점수 회귀 모델, 유해 텍스트 필터링)을 적용하여 수 페타바이트(PB)의 원시 텍스트에서 상위 10%의 '교과서급 고품질 지식 데이터'만을 정확히 선별해냅니다.
합성 지식 데이터 발견 (Synthetic Data & Reasoning Discovery)
인간이 작성한 고품질 데이터가 고갈되는 '데이터 장벽(Data Wall)'을 극복하기 위해, 강력한 교사 모델(Teacher LLM)로부터 다단계 사고 사슬(Chain-of-Thought, CoT) 추론 과정과 도메인별 고난도 Q&A 지식을 역마이닝(Mining)합니다. 도출된 합성 데이터를 KDD 평가 필터를 거쳐 정제함으로써 학생 모델의 수학·코딩 추론 능력을 비약적으로 끌어올립니다.
비정형 텍스트로부터 지식 그래프 유도 (GraphRAG의 기반)
방대한 문서 데이터베이스로부터 엔티티(Entity)와 관계(Relation)를 자동으로 추출하여 구조화된 지식 그래프(Knowledge Graph)를 구축합니다. 이는 LLM이 답변을 생성할 때 환각(Hallucination)을 방지하고 정확한 팩트에 기반하여 논리적 추론을 전개할 수 있도록 지원하는 GraphRAG(Graph-based Retrieval-Augmented Generation)의 핵심 지식 원천이 됩니다.
모델 지식 감사(Audit) 및 레드팀 취약점 지식 탐색
학습이 완료된 LLM의 신경망 가중치 내부에 축적된 잠재 지식(Latent Knowledge) 중 사회적 편향(Bias), 허위 정보, 탈옥(Jailbreak) 취약점이 존재하는지 KDD의 이상 탐지(Anomaly Detection) 및 군집 마이닝 기법을 통해 체계적으로 스캔하고 정밀하게 정렬(Alignment)합니다.
데이터베이스 내 지식발견(KDD)과 데이터마이닝 학술 연구를 주도하며 현대 인공지능의 데이터 인프라 혁신을 이끌고 있는 글로벌 최고 권위의 학회, 대학 연구소 및 기업 연구소를 소개합니다.
ACM SIGKDD
1995년부터 이어져 온 지식발견 및 데이터마이닝 분야 전 세계 최고 권위의 학술 협의회입니다. 매년 개최되는 KDD 컨퍼런스는 최첨단 데이터 과학, 그래프 마이닝, 초대형 지식 추출 연구의 표준을 정의합니다.
UIUC (일리노이 대학교)
데이터마이닝 분야의 바이블 교과서 저자이자 세계적 석학 자웨이 한(Jiawei Han) 교수가 이끄는 연구실로, 대규모 비정형 텍스트에서의 개체망 마이닝, 텍스트 큐브(TextCube), 구조화된 지식 추출 연구를 선도합니다.
스탠퍼드 대학교
유레 레스코벡(Jure Leskovec) 교수팀의 SNAP은 수십억 개 노드로 구성된 대규모 그래프 네트워크 마이닝, 그래프 신경망(GNN)을 활용한 복합 관계 지식 발견에서 세계 최고 수준의 성과를 창출하고 있습니다.
카네기 멜론 대학교 (CMU)
대규모 복합 데이터에서의 실시간 이상 탐지, 베이지안 네트워크 기반 통계적 지식 발견, 자연어 처리(NLP)와 KDD를 접목한 언어 지식 추출 시스템 구축을 다년간 주도하고 있습니다.
칭화대학교 (Tsinghua)
탕지에(Jie Tang) 교수팀은 전 세계 수억 편의 논문과 연구자를 연결한 학술 지식 그래프 AMiner를 구축했으며, 초거대 파운데이션 모델(GLM)과 지식 그래프를 융합한 지능형 마이닝을 선도합니다.
막스 플랑크 정보학 연구소
게르하르트 바이쿰(Gerhard Weikum) 교수팀은 위키백과와 워드넷을 결합하여 전 세계 오픈 지식 베이스의 표준이 된 YAGO 지식 베이스를 설계했으며, 웹 규모 자동 지식 추출 이론의 선구자입니다.
지식발견(KDD)의 기본 철학, 데이터마이닝과 데이터 파이프라인의 원리, 그리고 최신 AI 지식 추출 메커니즘을 시각적으로 학습할 수 있는 엄선된 강의 영상입니다.