자연언어 처리
(Natural-Language Processing)
C 인공지능 프로그래밍 : Herbert Schildt 지음, 신경숙.류성렬 옮김, 세웅, 1991 (원서 : Artificial Intelligence using C, McGraw-Hill, 1987), page 155~214
1. 자연언어 처리란 무엇인가? (WHAT IS NATURAL-LANGUAGE PROCESSING ?)
2. 자연언어 처리 접근방식 (APPROACHES TO NATURAL-LANGUAGE PROCESSING)
3. 언어 제한 (RESTRICTING LANGUAGE)
4. 상태-머신 NLP 파서 (THE STATE-MACHINE NLP PARSER)
(1) 상태머신 NLP 파서의 분석 (Analysis the state-machine NLP parser)
5. 문맥자유 되부름 하향 파서 (THE CONTEXT-FREE RECURSIVE-DESCENT NLP PARSER)
(1) 문맥자유 Recursive-Descent NLP 파서의 분석
(Analysis of the Context-Free Recursive-Descent NLP Parser)
6. 잡음제거 파서 (THE NOISE-DISPOSAL PARSER)
(1) 잡음제거 파서의 분석 (Analysis of the Noise-Disposal Parser)
제 1 장에서 언급했듯이, 많은 AI 전문가들은 AI 가 해결할 수 있는 가장 중요한 업무는 자연언어 처리라고 믿는다. 이렇게 믿는 이유는 일단 완성만 되면 자연언어 처리는 사람과 컴퓨터 사이에 직접적인 대화의 문을 연다는 것이며, 이것은 보통 사용되는 프로그래밍과 운영체제 프로토콜을 피할 것이다 ; 만약 컴퓨터가 인간의 언어를 이해하고 말할 수 있다면, 대부분의 일이 소프트웨어 기술자들에 의해 프로그램으로 작성될 필요가 더 이상 없게 될 것이다.
이 장에서 보겠지만, 자연언어 처리는 "행할 수 있는 (do-able)" 일이다. 그러나 인간의 언어의 엄청난 크기와 복잡성 때문에 이루어지지 못했다. 그러나, 자연언어 처리가 때때로 얼마나 간단할 수 있는지 놀랄 것이다. 또한 컴퓨터가 문장의 뜻을 이해하도록 하는 어려움도 알게 될 것이다. 이 장에서는 자연언어 처리로의 세가지 일반적인 접근 방식에 대하여 설명하고 각 방법의 예를 개발한다.
앞에서 언급했듯이, 보통 NLP 로 생략하여 부르는 자연언어 처리는 컴퓨터로 하여금 인간의 표준 언어로 쓰여진 명령들을 이해할 수 있게 하려고 시도한다 (이 책의 나머지에서는 영어가 처리될 인간의 언어라고 가정하지만, 제시된 모든 개념들을 다른 어떤 언어에도 적용할 수 있다). NLP 의 다소 덜 중요한 부분은 컴퓨터로 하여금 자연언어와 비슷한 반응을 구성하게 하는 것이다. 컴퓨터로 하여금 자연언어를 이해하게 한 후에, 반응을 생성하는 것은 작은 단계이다. 이 장에서는 반응을 구성하는 데에 관심이 없다.
대부분, 언어 합성과 인식은 실제로 NLP 의 분야가 아니다. 자연언어 처리기는 문장이 컴퓨터에 어떻게 입력되는 지에 관심이 없다. 일은 그 문장으로부터 정보를 뽑아내는 것이다. 이 장에서는 모든 대화가 터미널에서 발생한다고 가정한다.
아마도 생각할 수 있듯이 자연언어 처리기는 연구를 위한 것만을 제외하고 단독으로 사용되지 않는다. 그러나 NLP 는 다른 컴퓨터 프로그램 - 특히 데이터베이스 매니저와 범용 문제해결기 - 를 위한 전후처리기 (front - ends) 로 제공할 수 있다. 또한, 많은 프로그래머들은, 결국 컴퓨터를 사용하는 법을 배우는데 걸리는 시간을 없애줄 NLP 위주의 운영체제에 관심을 갖는다. 구문 민감 (Context-sensitive) 인 외국어 번역기들은 정확한 번역을 하기 위해서 자연언어 처리를 필요로 한다. 마지막으로, NLP 가 결국은 인간세계와 상호작용을 해야하는 자율적인 로봇에 필수적이라는 것은 의심할 바가 없다.
NLP 라는 주제는 매우 크기 때문에, 한 장에 그 모두를 다루려고 하는 것은 바람직하지 못하다. 대신, 이 장에서는 자연언어 처리에 관한 세가지 접근 방식에 초점을 둔다.
어떤 NLP 시스템이라도 그 핵은 파서 (parser) 이다. 파서는 뭐가뭔지 결정하기 위해서 각 문장을 한 단어씩 읽는 코드 부분이다. 공부할 세가지 파서는 다음과 같다.
각 파서는 문장을 다르게 보고 자신의 특별한 응용을 갖는다.
자연언어 처리로의 두 가지 반대 접근방식이 있다. 하나는 인간세계와 똑같이, 문장에 있는 모든 정보를 사용하려고 시도한다. 이 방식의 목표는 컴퓨터로 하여금 대화를 할 수 있게 만드는 것이다. 그러나, 이를 이루기는 매우 어렵다. 다른 접근방식은 컴퓨터로 하여금 자연언어 명령어를 받아들일 수 있게 하고, 그렇지만 그 명령어에 필수적인 정보만 끌어낼려고 한다 - 이것은 프로그램 하기가 훨씬 더 쉬운 일이다. 이 장에서, 단 한가지 파서만이 첫 번째 목표에 도달할 기회를 갖게 되지만 두 번째 목표를 수행하기 위해서도 제시된 모든 파서들을 사용할 수 있다는 것을 알게 될 것이다. 이 장에서는 자연언어가 컴퓨터가 사용할 수 있는 형태로 변환되게 하는 기법들만을 다룬다.
NLP 중심의 시스템을 구성하는 가장 어려운 면들 중의 하나는 인간의 언어의 복잡성과 융통성이다. 자연언어 처리기를 구현할 때, 처리기가 이해할 문장의 유형을 자연언어의 일부로 제한 하려는 유혹을 받게 된다. 만약 처리기가 받아들여야 하는 문법을 제한하면, 일은 휠씬 더 쉬워지고, 올바로 행해진다면, 그 제한은 거의 눈에 띄지 않는다. 어떤 경우에도, 이 장에 있는 처리기들이 받아들일 수 있는 문법을 제한하는 것이 필요하다. 이것이 행해지지 않으면, 각 예로의 코드는 너무 길 것이다.
그러므로 이 장에 있는 대부분의 예들에 대하여, 모든 문장은 선언적 (declarative) 이고, 의문형 (interrogative) 이 아니라는 것과, 표준형 주어, 동사, 목적어 (subject, verb, object) 를 따른다는 것을 가정한다. 또한 모든 형용사는 수식하는 명사 앞에 오는 반면에, 모든 부사는 수식하는 동사 다음에 온다는 것을 가정해야 한다. 그러므로 다음 문장은 타당하다 :
The child runs to the house.
The large child runs quickly to the window.
그러나 이 장에 있는 파서들은 다음과 같은 문장을 부사 quickly 가 동사 runs 앞에 오기 때문에 타당하지 못하다고 결정할 것이다.
The child quickly runs to the house.
이 장의 나머지 부분에 대하여, 이 제한된 문법은 G1 문법으로 일컬어 질 것이다. 이러한 규칙들 외에, 사용할 어휘가 필요할 것이다. 예를 간단히 하기 위해서, 이 장에서는 단어의 수를 최소로 유지하겠지만, 원한다면 리스트에 자유롭게 덧붙일 수 있다. 이 장에 있는 예에 대하여 파서는 유형 (type) 과 함께 다음에 있는 단어들을 인식할 것이다.
|
단어 유형 |
|
문 (door), 창문 (window), 집 (house), 아이 (child) 명사 (noun) |
|
가지다 (has), 달리다 (runs), 놀다 (plays) 동사 (verb) |
|
큰 (large) 형용사 (adjective) |
|
빨리 (quickly) 부사 (adverb) |
|
그 (the), 하나의 (a) 한정사 (determiner) |
|
~로 (to) 전치사 (preposition) |
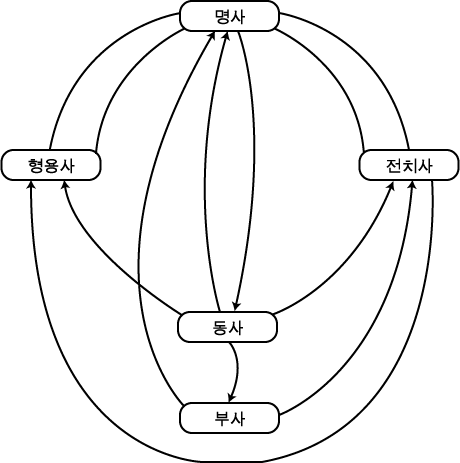
상태-머신 파서는 어떤 유형의 단어가 올바르게 나올 수 있는지 예측하기 위해서 문장의 현재 상태를 사용한다. 그림 1 이 이 장에서 사용할 상태-머신을 보여준다. 상태-머신은 한 상태에서 다른 상태로의 유효한 변이 (transition) 을 보여주는 방향성 그래프이다. 예를들어, 명사 다음에는 동사나 전치사가 올 수 있다.이 상태머신은 앞에서 설명된 G1 문법을 반영한다. 이 상태머신은 C 로 구현함으로써, 구성요소로 문장을 나누기 위하여 그것을 사용할 수 있다. 또한 어떤 문장이 G1 문법의 제한 내에서 올바로 구성되었는지 결정하기 위하여 사용한다.
그림 1 제한된 G1 문법의 상태머신
상태머신을 구현하기 전에, 파서가 인식할 수 있는 어휘와 단어의 유형을 유지할 데이터베이스를 정의해야 한다. 여기서 이 데이터베이스는 구조 (structures) 배열로 정의한다.
|
/* structure of the word database (wdb) */ struct word { char word[20]; char type; } struct word wdb[MAX]; /* array of db structure */ |
데이터베이스는 앞의 여러 장에서 개발된 것과 같은 유형의 기능을 갖는 다른 데이터베이스들과 매우 유사하게 만들었다. 또한 머신의 현재 상태를 유지할 총괄 변수를 필요로 한다. 이 변수는 state 라고 부른다. 수행을 시작할 때, 프로그램은 어휘를 갖는 word 데이터베이스를 로드하고, 그리고 나서 state 를 특정한 초기값을 포함하도록 초기화 시킨다.
프로그램이 키보드로부터 한 문장을 읽을 때 함수 parse 를 호출하는데 문장을 구성 성분으로 쪼개고 상태변이를 관리한다. parse 가 true 를 리턴하면 그 문장은 제한된 문법에 따라 옳다. parse 가 false 를 리턴하면 그 문장은 타당하지 못하다. main() 과 함께 모든 정의와 총괄변수 선언이 다음에 있다.
|
/* state-machine NLP example */ #include "stdio.h" #define MAX 100 #define NOUN 1 #define VERB 2 #define ADJ 3 #define ADV 4 #define DET 5 #define PREP 6 #define TERM 7 #define STARTUP-1 /* structure of the word database (wdb) */ struct word { char word[20]; char type; }; struct word wdb[MAX]; /* array of db structure */ int db_pos=0; /* number of entries in wdb */ char state=STARTUP; /* holds the current state of the machine */ char s[80]; /* holds the sentence */ char *t_pos=0; / *points into the sentence */ char token[80]; /* contains the word */ main() { setup(); printf("Enter Sentence : "); gets(s); t_pos=s; if (parse()) printf("Sentence OK\n"); } |
총괄변수 t_pos 는 입력 문장에 대한 포인터를 갖고, 각 단어가 읽혀질 때마다 앞으로 나아간다. 파서는 한번에 한 단어씩 처리한다. 따라서 한 문장을 그 구성성분으로 쪼갤 루틴이 필요하다. 함수 get_token() 은 다음 일을 한다 : get_token() 은 스페이스 (빈칸) 을 만날 때까지 한 번에 한 문자씩 입력 문장을 읽는다. 읽혀지는 문자들은 문장으로부터 다음 단어를 형성한다. 그리고 나서, get_token() 은 이 단어를 총괄변수 스트링인 token 에 넣는다. 이 연산은 제 3 장의 전문가시스템이 사용한 것과 비슷하다. 여기에 get_token() 이 있다.
|
/* return one token from the input stream */ get_token() { char *p; p=token; /* skip spaces */ while(*t_pos==' ') t_pos++; if(t_pos=='.') { *p++='.'; *p='\0'; return; } /* read word until a space or period */ while(*t_pos!='' && *t_pos!='.'){ *p=*t_pos++; p++; } *p='\0'; } |
get_token() 이 다음 문장을 읽고 있다고 생각해 보자. get_token() 으로부터 리턴한 후, token 은 this 를 포함할 것이고, t_pos 는 this 바로 뒤에 오는 빈칸을 가리킬 것이다. 필요한 모든 지원 함수가 적절한 곳에 있으므로, 다음에 있는 것과 같이, 주요 파서 루틴을 작성할 수 있다.
|
/* state-machine parser */ parse() { char type; do{ get_token(); /* transition to new state */ if (!(state=is_legal(token, state))) { printf("Error in sentence. \n"); return 0; } } while(*token!='.'); return 1; } |
이것이 보여주듯이, parse() 는 상태변이를 수행하기 위하여 is_legal() 함수를 사용한다. 정상적인 변이에서, is_legal 은 머신의 새로운 상태를 리턴하고; 불합리한 변이에서, false 를 리턴한다 - 문장의 구조의 에러를 의미한다. 여기에 is_legal() 이 있다.
|
/* check for valid state transitions */ is_legal(word, state) char *word; int state; { int type; type=find_type(word); if (type==DET) return state; /* skip */ if (type==TERM) return TERM; /* end of sentence */ switch(state) { case STARTUP : if (type!=DET) return type; else return STARTUP; case NOUN : if (type==VERB) return VERB; if (type==PREP) return PREP; break; case VERB : if (type==PREP) return PREP; if (type==NOUM) return NOUN; if (type==ADV) return ADV; if (type==ADJ) return ADJ; break; case ADV : if (type==NOUN) return NOUN; if (type==PREP) return PREP; break; case ADJ : if (type==NOUN) return NOUN; break; case PREP : if (type==ADJ) return ADJ; if (type==NOUN) return NOUN; break; } return 0; } |
is_legal() 함수는 다음과 같이 작동한다. 다음 단어가 a 나 the 와 같은 한정사이면, 상태변이는 발생하지 않는다. 마침표와 같은 종결자는 문장의 끝을 가리키고 처리를 멈추게 한다. 다음 단어가 한정사가 아니면 is_legal() 은 다음 토큰의 유형을 머신의 현재 상태와 비교하고 - 만약 그 유형이 올바르면 적당한 변이를 한다. 상태머신은 초기 상태로서 처음 밝혀진 토큰의 유형을 사용한다. 상태머신 파서 프로그램 전체가 다음에 있다. 이제 컴퓨터에 입력해야 한다.
|
/* state-machine NLP example */ #include "stdio.h" #define MAX 100 #define NOUN 1 #define VERB 2 #define ADJ 3 #define ADV 4 #define DET 5 #define PREP 6 #define TERM 7 #define STARTUP-1 /* structure of the word database (wdb) */ struct word { char word[20]; char type; }; struct word wdb[MAX]; /* array of db structure */ int db_pos=0; /* number of entries in wdb */ char state=STARTUP; /* holds the current state of the machine */ char s[80]; /* holds the sentence */ char *t_pos=0; / *points into the sentence */ char token[80]; /* contains the word */ main() { setup(); printf("Enter Sentence : "); gets(s); t_pos=s; if (parse()) printf("Sentence OK\n"); } setup() { assert_wdb("door", NOUN); assert_wdb("window", NOUN); assert_wdb("house", NOUN); assert_wdb("child", NOUN); assert_wdb("has", VERB); assert_wdb("runs", VERB); assert_wdb("plays", VERB); assert_wdb("large", ADJ); assert_wdb("quickly", ADV); assert_wdb("the", DET); assert_wdb("a", DET); assert_wdb("to", PREP); assert_wdb(".", TERM); } /* place facts into database */ assert_wdb(word, type) char *word; int type; { if (db_pos<MAX) { strcpy(wdb[db_pos].word, word); wdb[db_pos].type=type; db_pos++; } else printf("Word database full. \n"); } /* state-machine parser */ parse() { char type; do{ get_token(); /* transition to new state */ if (!(state=is_legal(token, state))) { printf("Error in sentence. \n"); return 0; } } while(*token!='.'); return 1; } /* check for valid state transitions */ is_legal(word, state) char *word; int state; { int type; type=find_type(word); if (type==DET) return state; /* skip */ if (type==TERM) return TERM; /* end of sentence */ switch(state) { case STARTUP : if (type!=DET) return type; else return STARTUP; case NOUN : if (type==VERB) return VERB; if (type==PREP) return PREP; break; case VERB : if (type==PREP) return PREP; if (type==NOUM) return NOUN; if (type==ADV) return ADV; if (type==ADJ) return ADJ; break; case ADV : if (type==NOUN) return NOUN; if (type==PREP) return PREP; break; case ADJ : if (type==NOUN) return NOUN; break; case PREP : if (type==ADJ) return ADJ; if (type==NOUN) return NOUN; break; } return 0; } /* find the type G1ven the word */ find_type(word) char *word; { int t; for(t=0 ; t<db_pos ; t++) if(!strcmp(word, wdb[t].word)) return wdb[t].type; return 0; } /* return one token from the input stream */ get_token() { char *p; p=token; /* skip spaces */ while(*t_pos==' ') t_pos++; if(t_pos=='.') { *p++='.'; *p='\0'; return; } /* read word until a space or period */ while(*t_pos!='' && *t_pos!='.'){ *p=*t_pos++; p++; } *p='\0'; } |
이 프로그램을 수행하면, G1 문법을 가정하여 어휘 words 를 사용하는 올바로 구성된 문장을 받아들일 것이라는 것을 알게 된다. 어떻게 동작하는지 알기 위해서, 다음 문장으로 간단한 예를 통해 실행해 보자.
the child runs quickly to the large house.
문장에 대한 다이아그램 (diagram) 은 G1 문법을 따른다는 것을 증명한다.
|
the |
child |
runs |
quickly |
to |
the |
large |
house. |
||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
한정사 |
명사 |
동사 |
부사 |
전치사 |
한정사 |
형용사 |
명사 |
||||||||
(DET) |
(NOUN) |
(VERB) |
(ADVERB) |
(PREP) |
(DET) |
(ADJ) |
(NOUN) |
||||||||
상태머신 파서가 하는 것과 같은 방법으로 이 문장을 수행할 때 그림 1 에서 제시한 상태머신 다이어그램을 기억하면 좋다. 추출된 첫 번째 단어는 the 이다. the 는 한정사 이기 때문에, 파서는 그것을 버리고 상태변화는 일어나지 않는다. 다음 단어는 명사인 child 이고 이것은 머신의 현재 상태가 NOUN 이 되게 한다. 상태머신이 이제 시작되었다. 다음 단어는 동사인 runs 이다. 그림 1 에서 보여주었듯이, 명사로부터 두가지 가능한 변이가 있다 : 동사로의 변이 또는 전치사로의 변이. runs 가 동사이기 때문에, 이 변이는 성공하고 새로운 상태 VERB 를 state 에 놓는다 ; 그러므로, 상태머신은 이제 노드 VERB 에 있다. 다음 단어는 부사 quickly 이다. 상태머신 다이어그램을 보면, VERB 로 부터의 한 가지 유효한 변이는 ADVERB 로 라는 것을 알 수 있다 ; 따라서 시스템은 상태 ADVERB 로 간다. ADVERB 로 부터, 다음에 올 수 있는 상태는 두 가지이다 : NOUN 또는 PRPOSITION. 문장의 다음 단어는 전치사 to 이기 때문에 파서는 상태 PREPOSITION 으로 간다. 여기서는 명사나 형용사가 따라와야 한다. 다음 단어는 한정사 the 이므로 파서는 그것을 버리므로 상태변화는 일어나지 않는다. 그리고 나서, 형용사 large 가 오고, 그것은 ADJECTIVE 로의 변이를 일으킨다. 상태 ADJECTIVE 는 NOUN 만이 뒤에 올 수 있는데, 이것은 house 가 파스될 때 발생하는 것이다. 마지막으로, 파서는 마침표를 읽고 문장을 완전히 파스한다.
잘못 쓰여진 문장에서 무슨 일이 일어나는지 보기 위하여 다음을 생각해 보자.
the house child runs to the.
여기는 두 개의 명사가 앞뒤에 있다. 파서가 첫 번째 명사를 만날 때, 상태머신은 NOUN 상태가 된다. 상태머신의 G1 문법에 따라, NOUN 으로부터의 유일한 변이는 VERB 나 PREPOSITION 으로의 변이이다. 그러므로, 명사 child 가 나올 때, 상태변이는 성공할 수 없고, is_legal() 은 false 를 리턴하므로 이것은 parse() 로 하여금 에러를 보고하게 한다.
결과를 보기 위하여 여러 문장을 시도해 보라. 이 상태머신은 매우 미숙하고 실제 영어의 모든 세밀한 부분들을 인식하지는 못하기 때문에 쉽게 혼동할 수 있다는 것을 기억해야 한다.
자연언어에 적용될 때, 상태머신 파서가 갖는 가장 나쁜 문제는 복잡성이다. 간단한 G1 문법에 대하여서 조차도, 상태변이의 적합성을 결정하기 이해서 독립된 조건문을 여러개 필요로 한다. 때때로 한가지 상태에서 다른 상태로 합칠 수 있지만, 전체 영어 문법에 대해서 얼마나 많은 상태들이 있을 것인지 상상해 보라. 이 이유 때문에, 상태머신 파서는 문법의 극히 일부를 이용할 수 있는 상황을 제외하고는 거의 사용되지 않는다.
상태머신 파서가 갖는 또 다른 문제는, 파서가 어떤 특정한 상태에서 어떻게 도달했는지 모른다는 것이다. 예를들면, 한정수 (수식구) 를 특정한 명사와 관련시킬 수 없다. 이것은 현재상태 이외의 어떤 정보라도 공급하도록 상태머신 파서에게 요구할 수 없다는 것을 의미한다.
긍정적인 면에서, 상태머신 파서는 운영체제 작업제어 언어와 어떤 데이터베이스 응용과 같은 특정 응용에는 이상적이다. 이러한 환경에서, 사용자가 명령을 유효한 포맷으로 넣어야 하는 것과 컴퓨터가 각 단어를 안다는 것만을 보증할 필요가 있다. 상태머신 파서는 문장의 유효한 유형이 얼마 없으므로, 상태가 몇 개 없기 때문에 이런 상황에서는 작동할 수 있다.
문맥자유 파서를 이해하기 위해서, 문장의 구성을 상태머신 모델에서 본 것과 완전히 다른 시각에서 봐야한다. 문맥자유 파서에 대하여, 문장이 여러 항목들로 구성되어 있고, 각 항목들은 다른 항목들로 구성되어 있는 등, 문장을 작은 요소 - 명사, 동사, 형용사 등 - 로 쪼갤 때 까지 그렇게 구성되어 있는 것으로 생각하자. 각 부분이 어떻게 구성될 수 있는가를 지배하는 규칙을 문법의 생성 규칙이라고 부른다. 문맥자유 파서는 문장을 분석하기 위하여 이 생성 규칙들을 사용한다.
|
문장 → 명사구 + 동사구 명사구 → 한정사 + 명사, 명사구 → 한정사 + 형용사 + 명사, 명사구 → 전치사 + 명사구 동사구 → 동사 + 명사구, 동사구 → 동사 + 부사 + 명사구, 동사구 → 동사 + 부사, 동사구 → 동사 |
그림 2 G1 문법의 생성 규칙
그림 2 가 G1 문법에 대한 생성 규칙을 보여준다. 이 규칙들을 공부할 때, 오른쪽 화살표를 "생성한다 (produces)" 라고 읽어야 한다. 이 그림에서, NP 는 "명사구 (noun phrase)" 를 나타내고, VP 는 "동사구 (verb phrase)" 를 나타낸다.
명사구는 전치사구를 만날 때, 자기 호출적 (recursive) 이다. 그리고 동사구는 명사구를 호출할 때 간접 자기 호출적 (indirectly recursive) 이다.
이 규칙들을 문장에 어떻게 적용할 수 있을지 보기 위하여, 다음 다이아그램을 생각해 보자.

생성 규칙은 일종의 트리를 형성한다. 이 트리는 파서가 문장을 보는 방법을 표현하기 때문에 파스 트리 (parse tree) 라고 한다. 이런 유형의 파스 트리를 생성하는 파서는, 트리가 각 요소의 문맥에 기초한 것이 아니기 때문에 문맥자유 (context-free) 라고 부른다 ; 규칙들은 각 구 (phrase) 의 문맥에 관계없이, G1 문법에 따르는 어떤 문장에 대해서도 작동할 것이다.
여기에, 문맥자유 파서의 의미를 이해하는데 도움을 줄 몇가지 점이 있다. 먼저, 문맥자유 파싱은 AI NLP 프로그램 뿐만 아니라 결국 모든 컴퓨터 언어에서도 사용된다. 예를들어, Pascal, BASIC, C, Modula-2, 그리고 다른 언어들을 문맥자유 파서로 파스할 수 있다. 문맥자유 파서가 파스할 수 있는 생성 규칙을 사용하여 영어의 일부라도 표현할 수 있다는 사실은 상당한 의미를 갖는다. 먼저, 어떤 방법으로, 영어는 엄밀한 규칙들을 따른다는 것을 보증한다 - 즉, 영어는 단순히 앞뒤가 맞지 않는 임의의 제한이 혼합된 것이 아니다. 두 번째, 컴퓨터 언어를 위하여 개발된 이해하기 쉬운 파싱기법 몇가지를 자연언어에 적용하게 한다 - 바퀴를 재발명할 필요가 없다. 마지막으로, 문맥자유 생성 규칙은 구에서부터 실제로 그것들을 구성하는 단어로 구성되기 때문에, 개개의 단어뿐만 아니라 전체 구를 이끌어내는 것은 쉽다. 그러므로, 개개의 단어뿐 아니라 구를 파스할 수 있고 - 각 구가 어디서 왔는지 알 수 있다 ; 의미 정보 (semantic information) 가 모아질 수 있는 기초. 이 모든 점들이 문맥자유 파서를 상태머신 보다 한 단계 낫게 만든다.
앞에서 주어진 생성 규칙을 사용하는 문맥자유 파서를 구현할 많은 방법들이 있다. 특히 C 를 사용할 때 가장 쉬운 것은, 되부름 하향 파서를 만드는 것인데, 이것은 문장이 완전히 파스될 때 까지 생성 규칙을 따라 하향 (descend) 하는 상호 자기 호출적인 (recursive) 루틴들의 모임을 사용한다.
문맥자유 되부름 하향 파서를 만드는 것은 상태머신 파서가 사용했던 것과, 같은 어휘 데이터베이스와 문장으로부터 단어를 추출해 내는 지원함수를 요구한다. 이 루틴들을 가정한, 문맥자유 되부름 하향파서가 다음에 있다.
|
/* Context-free recursive-descent NLP parser */ parse() { if (!nounphrase()) return 0; if (!verbphrase()) return 0; if (!terminator ()) return 0; return 1; } /* read a noun phrase from the input stream */ nounphrase() { char type; get_token(); type=find_type(token); switch(type) { case DET : get_token(); type=find_type(token); if (type=NOUN) return 1; else if (type==ADJ) { get_token(); type=find_type(token); if (type==NOUN) return 1; } break; case PREP : return nounphrase(); } return 0; } /* read a verb phrase */ verbphrase() { char type, *pos: get_token(); type=find_type(token); if (type!=VERB) return 0; /* must start with a verb */ pos=t_pos; /* save current position for backtracking */ /* verb + adverb + NP */ if (verb_adv_np()) return 1; /* verb + NP */ t_pos=pos; /* back up */ if (verb_np()) return 1; /* verb + adverb -- no NP */ t_pos=pos; if (verb_adv()) return 1; /* just adverb */ return 1; } verb_np() { /* verb + NP */ return nounphrase(); } verb_adv_np() { char type; get_token(); type=find_type(token); if (type==ADV && nounphrase()) return 1; return 0; } verb_adv() { char type; get_token(); type=find_type(token); return(type==ADV); } terminator() { get_token(); return(find_type(token)==TERM); } |
파서는 다음과 같이 작동한다. 최상위 수준에서, 문장은 명사구, 동사구, 그리고 이 경우 종결자 (terminator) 로서 마침표로 구성된다. 그러므로 함수 parse() 는 루틴 nounphrase() 를 호출하고, 다음에는 verbphrase() 를 호출한다. 이것이 성공한다고 가정하면 - 여기서 성공한다는 것은 문장이 G1 문법규칙을 만족한다는 것을 의미한다 - 파서는 문장이 마침표로 끝나는 것을 확인하기 위하여 terminator 를 호출한다. nounphrase() 와 verbphrase() 함수는 앞에서 설명된 방식으로 문맥자유 규칙을 구현하기 위해서 여러 가지 지원 함수를 사용한다. 어떤 문장이 이 규칙에 따르지 않으면, nounphrase() 와 verbphrase() 는 실패할 것이고, 문장은 거절당할 (reject) 것이다.
파서가 어떻게 작동하는지 정확히 보기 위해서, 다음 문장을 파스하는 방법을 따라가 보자.
the child runs quickly to the large house.
먼저, parse() 는 nounphrase() 를 호출하고, 이것은 한정사 the 와 명사 child 를 발견하기 때문에 성공한다. 그러고나서 parse() 는 verbphrase() 를 호출하고, 이것은 부사가 따라 나오고 차례로 명사구가 따라나오는 동사로 구성되어 있는지 알기위하여 verb_adv_np() 를 호출한다. 이 경우에, 동사구는 다음을 포함한다 : 동사 runs 다음에는 부사 quickly 가 오고, 이것 다음에는 전치사적 명사구 (prepositional noun phrase) to the large house 가 온다. 다음, 이 전치사적 명사구는 nounphrase() 로 하여금 자기 자신을 (recursively) 호출하게 한다. 마지막 구가 읽혀진 후, 모든 자기 호출은 종결되고 verbphrase() 는 성공하여 phrase() 로 리턴한다. 파서는 terminator() 를 사용하여 마침표를 확인한다. 마지막으로, parse() 가 성공하는데, 이는 그 문장이 실제로 G1 문법 규칙을 만족시킨다는 것을 의미한다.
문맥자유 되부름 하향 파서 프로그램 전체가 다음에 있다. 컴퓨터에 넣어, 작동을 잘 이해하도록 여러 문장을 가지고 시도해 보아야 한다.
|
/* Recursive-descent NLP example */ #include "stdio.h" #define MAX 100 #define NOUN 1 #define VERB 2 #define ADJ 3 #define ADV 4 #define DET 5 #define PREP 6 #define TERM 7 /* structure of the word database (wdb) */ struct word { char word[20]; char type; }; struct word wdb[MAX]; /* array of db structure */ int db_pos=0; /* number of entries in wdb */ char s[80]; /* holds the sentence */ char *t_pos=0; / *points into the sentence */ char token[80]; /* contains the word */ main() { setup(); printf("Enter Sentence : "); gets(s); t_pos=s; if (parse()) printf("Sentence OK\n"); else printf("Error in sentence\n"); } setup() { assert_wdb("door", NOUN); assert_wdb("window", NOUN); assert_wdb("house", NOUN); assert_wdb("child", NOUN); assert_wdb("has", VERB); assert_wdb("runs", VERB); assert_wdb("plays", VERB); assert_wdb("large", ADJ); assert_wdb("quickly", ADV); assert_wdb("the", DET); assert_wdb("a", DET); assert_wdb("to", PREP); assert_wdb(".", TERM); } /* place facts into database */ assert_wdb(word, type) char *word; int type; { if (db_pos<MAX) { strcpy(wdb[db_pos].word, word); wdb[db_pos].type=type; db_pos++; } else printf("Word database full. \n"); }
/* Context-free recursive-descent NLP parser */ parse() { if (!nounphrase()) return 0; if (!verbphrase()) return 0; if (!terminator ()) return 0; return 1; } /* read a noun phrase from the input stream */ nounphrase() { char type; get_token(); type=find_type(token); switch(type) { case DET : get_token(); type=find_type(token); if (type=NOUN) return 1; else if (type==ADJ) { get_token(); type=find_type(token); if (type==NOUN) return 1; } break; case PREP : return nounphrase(); } return 0; } /* read a verb phrase */ verbphrase() { char type, *pos: get_token(); type=find_type(token); if (type!=VERB) return 0; /* must start with a verb */ pos=t_pos; /* save current position for backtracking */ /* verb + adverb + NP */ if (verb_adv_np()) return 1; /* verb + NP */ t_pos=pos; /* back up */ if (verb_np()) return 1; /* verb + adverb -- no NP */ t_pos=pos; if (verb_adv()) return 1; /* just adverb */ return 1; } verb_np() { /* verb + NP */ return nounphrase(); } verb_adv_np() { char type; get_token(); type=find_type(token); if (type==ADV && nounphrase()) return 1; return 0; } verb_adv() { char type; get_token(); type=find_type(token); return(type==ADV); } terminator() { get_token(); return(find_type(token)==TERM); } /* find the type G1ven the word */ find_type(word) char *word; { int t; for (t=0; t<db_pos; t++) if (!strcmp(word, wdb[t].word)) return wdb[t].type; return 0; } /* return one token from the input stream */ get_token() { char *p; p=token; /* skip spaces */ while(*t_pos==' ') t_pos++; if (*t_pos=='.') { *p++='.'; *p='\0'; return; } /* read word until a space or period */ while (*t_pos != ' ' && *t_pos != '.') { *p=*t_pos++; p++; } *p='\0'; } |
parse(), nounphrase(), verbphrase() 그리고 지원함수들을 약간 변형하여, 문장을 그 성분구들로 쪼개기 위하여 이 루틴들을 사용할 수 있다. 단어만을 다룰 수 있는 상태머신 파서와는 달리, 구 (phrase) 를 추출해 내기 위하여 문맥자유 되부름 하향 파서를 사용할 수 있다. 이것은, 그 파서가 컴퓨터로 하여금 문장을 단순히 검증하지 않고 실질적으로 이해할 수 있는 길을 열어주기 때문에 중요한 기능이다 : 그러므로, 컴퓨터로 하여금 관련된 단어들의 그룹을 가지고 작동할 수 있게 한다. 여기에 있는 개정된 파서는 한 문장의 명사구와 동사구를 리턴한다.
|
/* Context-free recursive-descent NLP parser that displays phrases */ parse() { char noun[80], verb[80]; noun[0]='\0'; verb[0]='\0'; if (!nounphrase(noun)) return 0; if (!verbphrase(verb)) return 0; if (!terminator()) return 0; printf("noun phrase : %s\n", noun); printf("verb phrase : %s\n", verb); return 1; } /* read a noun phrase from the input stream */ nounphrase(s) char *s; { char type; get_token(); type=find_type(token); switch(type) { case DET : strcat(s, token); strcat(s, " "); get_token(); type=find_type(token); strcat(s, token); strcat(s, " "); if (type==NOUN) return 1; else if (type==ADJ) { get_token(); strcat(s, token); strcat(s, " "); type=find_type(token); if (type==NOUN) return 1; } break; case PREP : strcat(s, token); strcat(s, " "); return nounphrase(s); } return 0; } /* read a verb phrase */ verbphrase(s) char *s; { char type, *pos, temp[80]; get_token(); type=find_type(token); if (type!=VERB) return 0; /* must start with a verb */ strcat(s, token); strcat(s, " "); strcpy(temp, s); /* save for backtracking */ pos=t_pos; /* save current position for backtracking */ /* verb + adverb + NP */ if (verb_adv_np()) return 1; /* verb + NP */ t_pos=pos; /* back up */ strcpy(s, temp); if (verb_np()) return 1; /* verb + adverb -- no NP */ t_pos=pos; strcpy(s, temp); if (verb_adv(s)) return 1; /* just adverb */ return 1; } verb_np(s) char *s; { /* verb + NP */ return nounphrase(); } verb_adv_np(s) char *s; { char type, temp[80]; get_token(); type=find_type(token); strcat(s, token); strcat(s, " "); temp[0]='\0'; if (type==ADV && nounphrase(temp)) { strcat(s, temp); return 1; } return 0; } verb_adv(s) char *s; { char type; get_token(); type=find_type(token); strcat(s, token); strcat(s, " "); return(type==ADV); } terminator() { get_token(); return(find_type(token)==TERM); } |
여기서 이 버전의 파서를 이용하는 완전한 프로그램을 제시한다.
|
/* Recursive-descent NLP example that reports the phrases */ #include "stdio.h" #define MAX 100 #define NOUN 1 #define VERB 2 #define ADJ 3 #define ADV 4 #define DET 5 #define PREP 6 #define TERM 7 /* structure of the word database (wdb) */ struct word { char word[20]; char type; }; struct word wdb[MAX]; /* array of db structure */ int db_pos=0; /* number of entries in wdb */ char s[80]; /* holds the sentence */ char *t_pos=0; / *points into the sentence */ char token[80]; /* contains the word */ main() { setup(); printf("Enter Sentence : "); gets(s); t_pos=s; if (parse()) printf("Sentence OK\n"); else printf("Error in sentence\n"); } setup() { assert_wdb("door", NOUN); assert_wdb("window", NOUN); assert_wdb("house", NOUN); assert_wdb("child", NOUN); assert_wdb("has", VERB); assert_wdb("runs", VERB); assert_wdb("plays", VERB); assert_wdb("large", ADJ); assert_wdb("quickly", ADV); assert_wdb("the", DET); assert_wdb("a", DET); assert_wdb("to", PREP); assert_wdb(".", TERM); } /* place facts into database */ assert_wdb(word, type) char *word; int type; { if (db_pos<MAX) { strcpy(wdb[db_pos].word, word); wdb[db_pos].type=type; db_pos++; } else printf("Word database full. \n"); } /* Context-free recursive-descent NLP parser that displays phrases */ parse() { char noun[80], verb[80]; noun[0]='\0'; verb[0]='\0'; if (!nounphrase(noun)) return 0; if (!verbphrase(verb)) return 0; if (!terminator()) return 0; printf("noun phrase : %s\n", noun); printf("verb phrase : %s\n", verb); return 1; } /* read a noun phrase from the input stream */ nounphrase(s) char *s; { char type; get_token(); type=find_type(token); switch(type) { case DET : strcat(s, token); strcat(s, " "); get_token(); type=find_type(token); strcat(s, token); strcat(s, " "); if (type==NOUN) return 1; else if (type==ADJ) { get_token(); strcat(s, token); strcat(s, " "); type=find_type(token); if (type==NOUN) return 1; } break; case PREP : strcat(s, token); strcat(s, " "); return nounphrase(s); } return 0; } /* read a verb phrase */ verbphrase(s) char *s; { char type, *pos, temp[80]; get_token(); type=find_type(token); if (type!=VERB) return 0; /* must start with a verb */ strcat(s, token); strcat(s, " "); strcpy(temp, s); /* save for backtracking */ pos=t_pos; /* save current position for backtracking */ /* verb + adverb + NP */ if (verb_adv_np()) return 1; /* verb + NP */ t_pos=pos; /* back up */ strcpy(s, temp); if (verb_np()) return 1; /* verb + adverb -- no NP */ t_pos=pos; strcpy(s, temp); if (verb_adv(s)) return 1; /* just adverb */ return 1; } verb_np(s) char *s; { /* verb + NP */ return nounphrase(); } verb_adv_np(s) char *s; { char type, temp[80]; get_token(); type=find_type(token); strcat(s, token); strcat(s, " "); temp[0]='\0'; if (type==ADV && nounphrase(temp)) { strcat(s, temp); return 1; } return 0; } verb_adv(s) char *s; { char type; get_token(); type=find_type(token); strcat(s, token); strcat(s, " "); return(type==ADV); } terminator() { get_token(); return(find_type(token)==TERM); } /* find the type G1ven the word */ find_type(word) char *word; { int t; for (t=0; t<db_pos; t++) if (!strcmp(word, wdb[t].word)) return wdb[t].type; return 0; } /* return one token from the input stream */ get_token() { char *p; p=token; /* skip spaces */ while(*t_pos==' ') t_pos++; if (*t_pos=='.') { *p++='.'; *p='\0'; return; } /* read word until a space or period */ while (*t_pos != ' ' && *t_pos != '.') { *p=*t_pos++; p++; } *p='\0'; } |
이 버전의 파서를 이용하면, 다음 입력 문장에 대하여
the child runs quickly to the house.
스크린에 다음 출력을 보게 될 것이다.
|
noun phrase : the child verb phrase : runs quickly to the house |
문맥자유 파싱은 많은 장점을 갖는다. 첫째, C 로 구현하기가 쉽다. 둘째, 단어 수준과 구 수준에서 문장을 다루기 위하여 사용할 수 있다. 셋째, 항상 문장의 어디에 있는지 "안다 (knows)". 이것은 자기가 문장의 어디에 있었는지 모르는 상태머신의 예와 다르다.
문맥자유 파서가 갖는 주요 단점은 영어 문장이 구성될 수 있는 많은 유효한 방법들을 다룰 수 없을런지도 모른다는 것이다. 앞에서 주어진 간단한 G1 문법을 사용했을 때, 문법을 충분히 기술한 일단의 생성 규칙들을 정의하는 것은 쉬웠다. 그러나, 실세계의 영어 (또는 다른 언어라도) 에서, 규칙은 매우 복잡할 것이고, 이것은 폭발적 증가 (combinatoric explosion) 가 일어날 것이고, 이 방법을 사용할 수 없게 만든다. 그러나, 이것이 유일한 가능성이다 - 아직 아무도 이를 증명하지 못했다.
어떤 응용 프로그램에서는 문장이 포함되는 몇가지 키워드에만 관계되고, 언어를 구성하는 모든 관련 단어에 관련있는 것은 아니다. 본질적으로, 이런 유형의 응용들은 문장이 포함하는 정보에만 관심이 있다. 이 생각은 잡음제거 파서 라고하는 문맥자유 파서의 변형을 만들게 한다. 이 파서는 모르는 모든 단어를 잡음으로 다루고 그것들을 제거한다. 전형적으로, 모든 문장들은 자연언어를 닮은 고정된 포맷을 따라야 한다.
이런 유형의 파서는 실제로 명령어 처리기와 같은 데이터베이스 유형의 응용에서 아주 흔하다. 예를들어, 회사 이름과 주식가격으로 구성되는 데이터베이스를 생각해보자. 데이터베이스는 다음과 같은 질문을 받을 것이라고 가정하자.
show me all companies with stock prices > 100.
show me all.
show me XYZ.
show me one with stock price < 100.
is XYZ stock selling at > 40 ?
알 수 있듯이, 이런 유형의 질문들은 기본 유형에 맞는다.
명령어 <수식어> <이름> <연산자> <값>.
(command <modifier> <name> <operator> <value>.)
여기서, 명령어 (command) 는 항상 나타나야 하지만, 다른 네 개의 요소는 선택적이다. 그러나, 만약 연산자가 있다면 값도 또한 나타나야 한다는 것을 주목해야 한다. 필요한 요소들이 나타나 있는 한, 얼마나 많은 잡음 단어들이 나타나 있는지는 중요하지 않다. 왜냐하면 그것들은 파서의 연산에 영향을 미치지 않기 때문이다. 그러나, 질문의 각 부분의 순서는 정확히 같아야 한다.
그러한 파서의 예를 보기 위하여, 간단한 데이터베이스에 대한 질문 처리기 (query processor) 를 만들어보자. 이 예에서, 회사와 그 회사의 현재 주식가격이 들어있는 stock 이라는 데이터베이스를 사용한다. stock 의 정의는 다음과 같다.
다음, 유효한 명령에서 사용될 수 있는 단어와 기호들의 리스트를 필요로 할 것이다. 이 예에 있는 것과 같은 명령어 처리기에 대해서, 단어와, 그 사용을 반영하기 위한 단어의 유형을 변경시켜야 한다. 새로운 단어와 유형들이 다음에 있다.
단어 유형
보이다 (show) 명령어
~이다 (is) 명령어
xyz 이름
abc 이름
ucl 이름
all 수식어
one 수식어
> 연산자
< 연산자
= 연산자
여기서, xyz, abc, 그리고 ucl 은 회사 이름이다. 이 예에서는 질문을 허용하기 때문에, 물음표로 문장을 끝낼 수 있다.
프로그램을 시작할 때, stock 데이터베이스는 다음 정보를 가지고 로드될 것이다.
회사명 (NAME) 가격 (PRICE)
ucl 123
abc 35
xyz 100
파서는 앞 절에서 개발된 문맥자유 파서와 유사하다 ; 그러나, 단지 명령어 문장의 순서를 강요하는 반면, 불필요한 모든 단어를 버린다. 다음을 기억해야 한다 : 만약 word 데이터베이스에 있지 않은 단어를 읽으면, 단순히 그 단어를 버린다. 파서가 여기에 있다 :
|
/* Noise-disposal NLP parser */ parser() { char com[80], mod[80], name[80], op; float quant; if (!get_com(com)) return 0; get_mod(mod); get_name(name); op=get_op(); quant=get_quant(); perform(com, mod, name, op, quant); return 1; } |
이와같이, 파서는 마치 다섯 부분, 즉 명령어 자체, 수식어, 이름, 연산자, 그리고 한정사로 구성된 것처럼 질문을 파스한다. 모든 명령어는 마침표나 물음표로 끝나야 한다. 모든 명령어가 파스된 후에, perform() 은 지정된 명령을 수행한다. 다음에 지원함수들이 나와있다.
|
/* get the command */ get_com(s) char *s; { get_noise(); get_token(); if (find_type(token)!=COMMAND) { strcpy(s, ""); return 0; } strcpy(s, token); return 1; } /* get a modifier or default to "all" */ get_mod(s) char *s; { get_noise(); get_token(); if(find_type(token)!=MODIFIER) { strcpy(s, "all"); put_back(); return; } strcpy(s, token); } /* get the name */ get_name(s) char *s; { get_noise(); get_token(); if(find_type(token)!=NAME) { strcpy(s, ""); put_back(); return; } strcpy(s, token); } /* get an operator */ get_op() { get_noise(); get_token(); if(find_type(token)==OPERATOR) return *token; else return 0; } /* get a number */ float get_quant() { float t; get_token(); if (*token!='.') sscanf(token, "%f", &t); return t; } /* check for noise */ get_noise() { do{ get_token(); } while(!find_type(token)); put_back(); /* return a valid token to stream */ } |
각 단계에서, 프로그램은 먼저 get_noise() 를 호출한다는 것을 주목해야 한다. 이것은 중요한 단어 앞에 올 수 있는 어떤 잡음 단어도 제거한다. 또한 명령어 문법의 선택적 부분은 기정값 (default) 인 경우가 있음을 주목해야 한다. 이 기정값의 경우는 명령을 수행하는 루틴과 일관된 인터페이스를 유지하기 위하여 필요하다. get_noise() 가 중요한 단어 앞의 잡음을 제거할 때, 함수 put_back() 은 읽혀진 마지막 토큰을 입력 스트링으로 리턴한다.
질문이 처리된 후에, 질문이 요구하는 것을 실제로 하는 것은 perform() 이다. 이 책은 데이터베이스가 아니라 인공지능에 관한 것이기 때문에, perform() 함수는 충분한 범위의 질문 가능성들에 반응할 수 없다. 그러나, 논증에는 적절하다 (약간의 노력으로, 그것을 확장시킬 수 있다). perform() 함수와 지원 함수, 그리고 전체 프로그램을 다음에 제시한다.
|
/* Noise-disposal NLP database query example. */ # include "stdio.h" # define MAX 100 # define NOISE 0 # define COMMAND 1 # define NAME 2 # define MODIFIER 3 # define OPERATOR 4 # define TERM 5
/* structure of the word database (wdb) */ struct word { char word[20]; char type; }; struct word wdb[MAX]; /* array of db structures */
/* structure of the stock db */ struct companies { char name[20]; float price; }; struct companies stock[MAX]; /* array of db structures */
int db_pos=0; /* number of entries in wdb */ int stock_pos=0; /* number fo entries in stock db */ char s[80]; /* holds the sentence */ char *t_pos=0; /* points into the sentence */ char token[80]; /* contains the word */
float get_quant(), find_price(), find_name();
main() { setup(); printf("Enter query : "); gets(s); printf("\n"); t_pos=s; if (!parse()) printf("Query not understand. \n"); }
setup() assert_wdb("xyz", NAME); assert_wdb("ucl", NAME); assert_wdb("abc", NAME); assert_wdb("show", COMMAND); assert_wdb("is", COMMAND); assert_wdb("all", MODIFIER); assert_wdb("one", MODIFIER); assert_wdb(">", OPERATOR); assert_wdb("<", OPERATOR); assert_wdb("=", OPERATOR); assert_wdb(".", TERM); assert_wdb("?", TERM); assert_stock("ucl", 123.00); assert_stock("abc", 35.75); assert_stock("xyz", 100.0); }
/* place facts into database */ assert_wdb(word, type) char *word; int type; { if (db_pos < MAX) { strcpy(wdb[db_pos].word, word); wdb[db_pos].type=type; db_pos++; } else printf("Word database full. \n"); }
/* place companies into database */ assert_stock(name, price) char *name; float price; { if (stock_pos<MAX) { strcpy(stock[stock_pos].name, name); stock[stock_pos].price=price; stock_pos++; } else printf("Stock database full. \n"); }
/* Noise-disposal NLP parser */ parser() { char com[80], mod[80], name[80], op; float quant;
if (!get_com(com)) return 0; get_mod(mod); get_name(name); op=get_op(); quant=get_quant(); perform(com, mod, name, op, quant); return 1; }
/* get the command */ get_com(s) char *s; { get_noise(); get_token(); if (find_type(token)!=COMMAND) { strcpy(s, ""); return 0; } strcpy(s, token); return 1; } /* get a modifier or default to "all" */ get_mod(s) char *s; { get_noise(); get_token(); if (find_type(token)!=MODIFIER) { strcpy(s, "all"); put_back(); return; } strcpy(s, token); }
/* get the name */ get_name(s) char *s; { get_noise(); get_token(); if (find_type(token)!=NAME) { strcpy(s, ""); put_back(); return; } strcpy(s, token); }
/* get an operator */ get_op() { get_noise(); get_token(); if (find_type(token)==OPERATOR) return *token; else return 0; }
/* get a number */ float get_quant() { float t; get_token(); if (*token!='.') sscanf(token, "%f", &t); return t; }
/* check for noise */ get_noise() { do{ get_token(); } while(!find_type(token)); put_back(); /* return a valid token to stream */ }
perform(com, mod, name, op, quant) char *com, *mod, *name, op; float quant; { if (!strcmp("show", com) { if (*name) printf("%f\n", find_price(name)); else search(mod, op, quant); } else { /* is */ switch(op) { case '=' : if (quant==find_price(name)) printf(" yes\n"); else printf(" no\n"); break; case '<' : if (find_price(name)<quant) printf(" yes\n"); else printf(" no\n"); break; case '>' : if (find_price(name)<quant) printf(" yes\n"); else printf(" no\n"); break; } } }
search(mod, op, quant) char *mod, op; float quant; { char name[80]; float price; find_name("", quant, op, 1); /* restart */ if (!strcmp(mod, "all")) { while ((price=find_name(name, quant, op, 0))!=0) { printf("%s", name); printf(" %f\n", price); } } else { price=find_name(name, quant, op, 0); printf("%s", name); printf(" %f\n", price); } }
/* return the last token to the input stream */ put_back() { int t; for (t=0; t<strlen(token); t++) t_pos--; } terminator() { get_token(); return(find_type(token)==TERM); }
/* given name find price */ float find_price(name) char *name; { int t; for (t=0; t<stock_pos; t++) { if (!strcmp(name, stock[t].name)) return stock[t].price; } return -1.0; }
/* given price and op find name */ float find_name(name, price, op, restart) char *name, op, restart; float price; { static int t; if (restart) { t=0; return; } do { switch(op) { case '=' : if (stock[t].price==price) { strcpy(name, stock[t].name); t++; return stock[t-1].price; } break; case '<' : if (stock[t].price<price) { strcpy(name, stock[t].name); t++; return stock[t-1].price; } break; case '>' : if (stock[t].price>price) { strcpy(name, stock[t].name); t++; return stock[t-1].price; } break; case '\0' : strcpy(name, stock[t].name); t++; return stock[t-1].price; } t++; } while(t<=stock_pos); return 0; }
/* find the type given the word */ find_type(word) char *word; { int t; for (t=0; t<db_pos; t++) if (!strcmp(word, wdb[t].word)) return wdb[t].type; return 0; } get_token() { char *p; p=token; /* skip spaces */ while (*t_pos==' ') t_pos++; if (*t_pos=='.') { *p++='.'; *p='\0'; return; } /* read word until a space or period */ while (*t_pos!=' ' && *t_pos!='.') { *p=*t_pos++; p++; } *p='\0'; } |
수행될 때, 이 프로그램은 다음 질문들을 옮게 해석해서 반응할 것이다.
|
show me all companies with prices > 100. ucl 123 show me all. ucl 123 abc 35 xyz 100 please show me one with a price < 50 abc 35 is the price of ucl > 100 ? yes |
비록 이 간단한 프로그램은 두 개의 명령어만을 갖지만, 선택한다면 다른 것들은 쉽게 첨가할 수 있다.
잡음제거 파서의 한가지 단점은 방금 주어진 데이터베이스의 예와 같은 제한된 상황 밖에는 유용하지 못한데, 왜냐하면 두가지 가정에 기초하기 때문이다. 첫 번째 가정은 그 문장이 엄밀한 포맷을 따른다는 것이다. 두 번째 가정은 단 몇 개의 키워드나 기호들만이 중요하다는 것이다. 알겠지만, 실제의 대화에서, 대부분의 단어들은 어떤 다른 것보다 더 중요하다.
두 번째 단점은, 많은 상황에서 다음과 같은 문장을 받아들이고, stock 데이터베이스의 내용을 디스플레이한다는 것이다. 이런 유형의 단점은 프로그램을 신뢰하기 어렵게 한다.
the big pig show house all > 100.
잡음제거 파서의 주요한 장점은 구현하기가 간단하고, 문장에 있는 정보를 빨리 받아들인다는 것이다. 더욱이, 다른 유형의 파서와 함께 사용될 때, 받아들여져야 하는 변화 (variation) 의 수를 줄일 수 있다. 사실, 어떤 성공적인 자연언어 처리기도 최소한 어떤 잡음제거 시스템을 가질 것이라는 것은 의심할 여지 없다.