
기호 프로그래밍
인공지능 이론 및 실제 : Thomas Dean. James Allen. John Aloimonos 공저, 김진형.박승수.백은옥. 서정연.이일병 공역, 사이텍미디어, 1998 (원서 : Artificial Intelligence: Theory and Practice, 1995), Page 25~70
Fred 는 모든 아파트 건물은 천장의 높이가 적어도 2.5 미터 이상이어야 한다는 도시건설법을 집주인이 어겼다고 확신하고 있다. Fred 의 키는 정확히 2 미터인데, 10 센티미터의 나무블록 세 개를 쌓아두고 그 위에 올라서면, 그의 머리는 그의 아파트 천장에 바로 닿는다. 이러한 정보를 이용하여, Fred 는 (2.0 + (3 × 0.10)) 라는 식을 계산하여 2.3 을 얻음으로써, 천장의 높이를 계산할 수 있었다.
Fred 는 머리 속으로, 또는 계산기를 써서, 또는 간단한 프로그램을 작성함으로써 이 결과를 쉽게 계산할 수 있다. 우리는 일반적인 지식으로부터 이와 같은 식을 구성하고, 그것을 계산해서 결론을 낼 수 있는 시스템을 만들고자 한다. 천장의 높이를 구하는 문제에서와 같이 알고 있는 값을 이용하여 측정값을 구할 수 있는 방법을 원하기 때문에 우리의 목표는 단순하지 않다고 할 수 있다.
2.0, 3, 0.10 은 기호 (symbol) 에 해당하고 일반적으로 숫자를 표현하는 데 사용된다. 숫자는 "홀수" 또는 "짝수" 와 같은 특성과 "같다" 또는 "크다" 와 같은 관계, 그리고 역시 기호로 표현되며 (3 × 0.10) 과 같이 기호 수식을 만드는데 사용되는 "더하기" 또는 "곱하기" 와 같은 조합 방법을 가지고 있다. 기호 프로그래밍 (symbolic programming) 에서는 기호와 기호식을 만들고 그것을 인수로 프로시저 (procedure) 에 보내며 새로운 수식을 추론해 내기 위해서 조작한다.
기호는 숫자 이외의 다른 것을 추론하기 위해 사용될 수 있다. 예를 들어, Fred 는 fred 라는 기호로, 세 개의 토막은 block1, block2, block3 이라는 기호로 나타낼 수 있다. 필요할 때마다, 기호를 위한 특성, 관계, 조합 방법들을 정의할 수 있다. 예를 들어, (height fred) 라는 수식은 Fred 의 키를 나타내는 것으로 사용할 수 있고, (on block1 block2) 는 하나의 토막이 다른 토막 위에 있다는 관계를 나타내는 것으로 사용할 수 있다. 주어진 수식 (on block1 block2) 와 (on block2 block3) 로 세 개의 토막으로 이루어진 토막 더미라는 새로운 관계인 (stack block1 block2 block3) 를 추론할 수 있다.
이 장에서 기호 프로그래밍을 위해서 설계된 Lisp (list processing language) 프로그래밍에 관하여 설명한다. Lisp 는 기호와 기호식 (symbolic expression) 을 다루기 위한 기능들을 많이 포함하고 있다. 또한 프로그래머가 하급의 상세한 부분으로부터 자유로워질 수 있게 되어있다. Lisp 의 구문 (syntax) 은 간단하기 때문에 배우기 쉽고 프로그램하기도 쉽다.
이 장에서는 적어도 하나 이상의 다른 프로그래밍 언어로 프로그램하는 방법을 이미 알고 있다고 가정한다. 우선, 기호와 기호식의 사용을 유발하기 위해서 로봇 프로그래밍 문제로부터 시작해 본다. 우리는 이 장의 마지막 부분에서 다시 이 예로 돌아와서 앞 절에서 배웠던 것을 사용하여 그 문제를 해결하는 Lisp 코드를 작성할 것이다. Lisp 에 대한 사항은 기본적인 구문의 소개로부터 Lisp 에서 사용할 수 있는 대화 도구의 소개를 하고자 설명한다. 이러한 도구들은 Lisp 로 쉽게 실험할 수 있게 해준다. 다른 프로그래밍 언어에서 많이 사용하는 기술 뿐만 아니라 재귀 호출과 반복 구조도 설명될 것이다. 또한 리스트는 기호식을 다루는 데 기본적인 것이므로 리스트를 생성하고 조작하는 기술에 대해서도 자세히 설명할 것이다. 또한 간단하지만 자료 추상화 (data abstraction) 에 대한 설명도 할 것이다.
이 장에서 설명하는 Lisp 를 사용하는 데에는 복잡한 프로그램을 작성하는 데에 일상적으로 필요한 입출력, 디버깅 (debugging), 모듈화 (modularity) 등에는 거의 시간을 보내지 않을 것이다. 이 장의 설명은 Lisp 에 대한 자세한 소개가 아니다. 학생들이 개념을 소화하고 실험할 수 있을 정도로, 프로그래밍을 할 수 있는 Lisp 의 기능에만 집중할 것이다. 앞으로 계속될 여러 페이지에 걸쳐서 작은 프로그램들을 많이 작성해야 하고, 이 책에 나온 예들을 변형시켜가면서 실험해야 할 것이다. 가능하다면, Lisp 가 실행되는 컴퓨터 앞에 앉아서 대화도구를 사용하면서 실험하라. 이 장은 하나의 예를 보임으로써 결론을 맺을 것이다.
어떤 회사가 사무실 빌딩에서 우편물을 배달하는 로봇을 위한 제어 시스템을 개발하고 있다. 그들은 로봇에게 한 사무실에서 다른 사무실로 이동할 때 어떤 복도를 사용할 것인가를 알리는 상위급의 계획 시스템 (planning system) 을 이미 작성했다. 우리는 로봇이 실제로 물건들과 부딪히지 않고 빌딩의 복도를 지나갈 수 있도록 하는 제어 시스템 부분에 관심이 있다. 로봇이 복도를 지나갈 때 길에 있는 사람들과 상자들을 피해야 한다. 이 간단한 행동은 규칙기반 반응 시스템 (rule-based reactive system) 에 의해서 생성된다. 그 시스템은 다음에 무엇을 할 것인가를 결정하는 기호식으로 표현되는 규칙들을 사용하기 때문에 규칙을 기반 (rule-based) 하고 있다고 한다. 또한 그 시스템을 반응 (reactive) 시스템이라고 하는데, 그것은 로봇의 감각기기에 의해 인지되는 환경의 변화에 거의 직접적으로 반응하기 때문이다. 우선 감각기기와 제어를 표현하는 데에 사용되는 기호들을 소개한다.
감각기기와 감각기기값을 기호로 표현하기
로봇은 장애물이 근처에 있는지를 감지할 수 있으나, 장애물의 모양이나 위치를 상세히 파악하지 못하는 여섯 개의 감각기기를 가지고 있다. 만일 장애물이 감지되면, 그것의 위치는 그 로봇에 가까이 있거나, 떨어져 있거나, 또는 아주 멀리 있다는 것으로 보고된다. 이러한 대략적인 값은 로봇이 장애물을 부딪히지 않고 이동하는 데에 충분하다.
그림 1 이동 로봇을 위한 장애물 감지 감각기기
여섯 개의 감각기기는 로봇 주위에 있는 장애물에 대한 정보를 제공한다. 그 감각기기들은 로봇이 항해하고 장애물을 피하는 것을 돕기 위해서 로봇 앞에 무엇이 있는가에 대해 보다 많은 정보를 제공하도록 배치되어 있다. 기호 forward, jright, jleft, right, left, rear 는 여섯 개의 감각기기를 나타내기 위해서 사용된다. 각 감각기기는 로봇 주위의 정해진 지역에 있는 장애물의 존재에 대한 보고에 책임이 있는데, near, away 또는 far 중 하나의 값을 리턴한다. 그림 1a 는 감각기기들의 배열을 보여주고 있고, 그림 1b 는 길을 부분적으로 막고 있는 물 냉각기가 있는 한 사무실 빌딩의 복도에 있는 로봇을 묘사하고 있다.
감각기기 외에도, 로봇의 행동을 결정하는 두 개의 제어 매개변수 (control parameter) 가 있다. 이들 매개변수를 조정함으로써 규칙기반 반응 프로그램은 로봇에게 어떻게 움직여야 하는지를 지시한다. 로봇의 속도는 speed 라는 기호로 표현되고, zero, slow, fast 의 세 개 중의 하나의 값으로 지정된다. 로봇이 가는 방향은 tum 이라는 기호로 표현되고 left, straight, right 중 하나의 값으로 할당된다.
다음 절에서는 규칙들을 기호식으로 표현하고, 이러한 규칙들을 사용하여 로봇을 제어하는 프로시저를 구현하는 방법들을 소개한다. 이 장의 마지막에 이 예로 돌아와서 간단한 규칙기반 반응 시스템을 구현하는 Lisp 코드를 제공할 것이다.
Lisp 은 프로시저를 정의하고 다른 프로시저로부터 그 프로시저를 호출할 수 있는 점에서 Pascal 이나 C 와 같은 언어와 여러 면에서 Lisp 는 그것이 보다 간단한 구문을 가지고 있다는 것과, 자료 형태의 명확한 요구가 적다는 것과, 미리 구현되어 있는 내부 프로시저 (built-in procedure) 가 많고 프로그램 개발을 위한 대화적인 환경을 제공한다는 면에서 다른 언어와 다르다고 할 수 있다. 일반적으로 프로그래머가 Pascal 에 대해서 말할 때, Pascal 프로그램을 서술하기 위한 문법적인 사항, 컴파일러, 실행 코드를 생성하기 위한 관련된 도구 모두를 지칭하고 있다. 프로그래머가 Lisp 에 대해서 말할 때에는 사용자가 작성한 Lispㆍ프로그램과 많은 내부 프로시저를 서술하는 문법적인 사항과 Lisp 프로그램을 컴파일하고 디버깅하고 대화하기 위한 여러 도구를 지칭하는 것이다.
우선 프로그래밍 언어에는 무엇이 필요한가를 생각해 보면서 Lisp 에 대한 소개를 시작하도록 하자. 숫자, 문자열, 포인터 등과 같은 모든 표준 자료형, 그러한 자료에 가할 수 있는 연산들, 예를 들어 더하기, 곱하기, 문자열 붙이기, 포인터 쫓아가기 등이 요구된다. 그 외에는 순서처리, 조건분기, 프로시저 호출을 제공하는 제어 구조가 필요하다. 파일과 터미널과 같은 표준 장치로부터 읽고 쓰는 방법들은 실제 응용을 위해서 유용할 것이다. 마지막으로, 프로그램을 구조화하기 위한 방법 (예를 들어, 서브루틴 (subroutine) 과 모듈 (module)) 과 새로운 제어 구조와 추상적 자료형 (abstract data type) 을 위한 장치가 있다면 복잡한 프로그램을 작성하는 데 도움을 줄 것이다.
Lisp 에는 여러 종류가 있다. 이 책에서는 Common Lisp 라 불리우는 Lisp 를 사용한다. 우리는 훨씬 다양한 다른 Lisp 들 대신에 Common Lisp 를 이용하는데, 그것은 Common Lisp 가 일반적으로 수용될 수 있는 표준이 되었기 때문이다. 우리는 Common Lisp 가 부분집합만으로 관심 사항을 제한하고, 다루는 대부분의 것을 다른 Lisp 들에도 역시 적용될 수 있는 것으로 한다. 우리가 선택한 Common Lisp 의 특정 부분집합은 이 책에 있는 예와 연습문제를 위해 필요한 모든 기능들을 포함하고, Lisp 에 대해서 더 배울 수 있도록 하는 좋은 밑거름을 제공할 것이다. 이러한 부분집합을 사용할 수 있도록 하기 위해서, 이 책의 뒷부분에 일반적인 기호 프로그래밍 용어, 함수 이름, 특수 형식 (special form), 특수 문자와 같은 Lisp 표기 방법에 대한 인덱스를 포함하였다.
Lisp 의 문법은 비교적 간단하다. 사실, 매우 간단해서 문법적 제약이 훨씬 많은 언어에 익숙한 프로그램들에게 Lisp 은 구조적으로 보이지 않을 수도 있다. Lisp 에서는 프로그램과 자료는 리스트로 표현되는데, 하나의 리스트는 열린 괄호, 0 개 이상의 표현식 (expression) 은 닫는 괄호로 표현된다.
표현식은 Lisp 객체 (예를 들어, 숫자나 문자열) 이거나, 0 개 이상의 표현식을 포함하는 하나의 리스트에 해당한다. 예를 들어 ( ), (1), (1 (2)) 는 모두 리스트이고, 첫번째 것은 공 (empty 또는 null) 리스트이다. 리스트 (1) 은 숫자 1 의 하나의 표현식으로 이루어져 있다. 리스트 (1 (2)) 는 숫자 1 과 리스트 (2) 의 두 개의 표현식으로 이루어져 있다. 여기서 잠시 주목하고 넘어갈 것은 모든 표현식은 잘 구성된 (well-formed) Lisp 프로그램에 해당한다는 것이다.
리스트는 프로그래밍 작업의 많은 변형을 간단하게 하는 포인터의 추상화를 제공한다. 만일 당신이 포인터에 익숙하지 않다면 그 점은 염려하지 않아도 좋다. Lisp 의 리스트는 포인터를 세부적으로 조작하도록 요구하지 않는다.
또한 숫자 (정수와 실수), "string" 과 같이 보통 두 개의 따옴표로 표현되는 문자열 그리고 다양한 원시 자료형을 가지고 있는데, 리스트 조작의 용이성이 Lisp 의 가장 중요한 특성 중의 하나이다.
또 다른 Lisp 의 중요한 자료형은 기호이다. 기호는 문자열과 매우 비슷하게 생겼으나 따옴표로 만들지 않는다. 기호들은 sym 과 sym4 와 같이 영문자와 숫자로부터 이루어지고, sym_one 과 sym_two 와 같이 하이픈과 밑줄선이 포함되기도 한다. Lisp 에서 숫자는 기호가 아니다. 따라서 모든 Lisp 기호는 숫자나 소수점이 아닌 문자를 적어도 하나는 포함해야 한다. 일반적으로 대소문자 구별은 하지 않는다. 즉, foo 는 FOO 또는 Foo 와 같은 기호이다. 리스트는 기호들을 포함할 수 있다. 예를 들어 (foo bar (baz)) 는 foo, bar, (baz) 의 세 개의 식으로 구성된 리스트이다.
하나의 Lisp 프로그램은 연속적인 Lisp 표현식으로 이루어져 있다. 이 책에서는 Lisp 프로그램을 형식을 갖춘 Lisp 표현식으로 표시하고, 표현식을 설명하는 문장을 간간이 삽입하여 보여줄 것이다. Lisp 프로그램을 구성하면 파일로 저장해야 할 것이다. 파일로 저장된 하나의 Lisp 프로그램은 연속적인 Lisp 식과 프로그램을 해설하는 주석 (comment) 으로 구성되어 있다.
|
;; 이 주석은 바로 하나의 식 앞에 나타난다. (defun square (x) ;; 주석은 하나의 식 안쪽에 나타날 수도 있다. (* x x)) ;; 주석은 식 오른편에 나타날 수도 있다. ;; 주석은 식에 대해 충분히 해설하기 위해서, ;; 필요한 만큼 여러 줄에 걸쳐서 나타날 수 있다. (defun cube (x) (* x x x)) ;; 주석 오른편에 있는 식은 무시된다! (+ x x x) |
그림 2 파일에서와 같이 나타나게 될 주석의 예
주석은 컴파일러나 다른 도구들이 문장으로부터 프로그램을 분리할 수 있도록 특별한 구두법으로 분리되어 있다. 세미콜론 (;) 은 표준 주석 문자이다. 세미콜론의 오른쪽 같은 줄에 있는 문자들은 그 파일을 읽는 Lisp 도구에 의해서 무시된다. 구두점의 목적으로 사용되는 것과 차별화 하기 위해서 보통은 주석을 위해서 두 개의 세미콜론 (;;) 을 사용한다. 그림 2 는 Lisp 프로그램을 포함하고 있는 파일에서 흔히 볼 수 있는 주석의 예를 보여주고 있다.
좀더 진행하기 위해서 Lisp 의 의미에 대해서 좀더 알아볼 필요가 있다. 이것은 전통적인 언어에서 컴파일, 링킹 (linking), 그리고 프로그램을 실행하는 방법에 해당한다. 우리는 Lisp 에서 다른 Lisp 프로그램을 해석 (interpret) 하고 평가 (evaluate) 하는 eval 이라는 Lisp 프로그램을 집중적으로 살펴볼 것이다. Eval 은 다른 프로그래밍 언어에서 컴파일러가 하는 것과 같은 일을 한다. Eval 로 Lisp 프로그램을 복잡한 링킹없이 점진적으로 컴파일할 수 있다는 사실은, Lisp 코드로 간단하게 실험할 수 있도록 해준다. Common Lisp 은 eval 에 의한 컴파일 말고도 다른 컴파일 형태도 제공하는데, 이 책에서는 그것을 다루지 않겠다.
대부분의 Lisp 시스템은 사용자로 하여금 Lisp 식을 터미널에서 입력하고 eval 을 실행시킬 수 있도록 대화적인 프로그램을 제공하고 있다. 이러한 대화 프로그램을 read-eval-print 루프 (loop) 라고 부르는데, 이것이 터미널로부터 하나의 식을 읽고, 그 식을 평가하고, 그리고 평가의 결과를 터미널로 출력하면서 또 다른 식의 입력을 요구하기 때문이다. 우리는 해석기 (interpreter) 라 부르는 이러한 대화적인 프로그램을 앞으로 계속 사용할 것인데, 가능하다면 터미널 앞에서 이것을 직접 수행하면서 따라오기 바란다. 주위에 있는 Lisp 전문가에게 해석기를 어떻게 실행시키고 오류를 어떻게 극복하는지를 물어 보라. 실험해 보는 것을 어려워하지 말라. 해석기는 탐험을 도와주도록 설계되어 있다.
Lisp 해석기가 실행되면 일반적으로 버전을 나타내는 숫자, 복제에 대한 제한 사항, 그리고 이 단계에서 무시할 수 있는 다른 정보에 관한 여러 메시지가 프린트된다. 이러한 첫 인사가 끝나면, 당신이 타이핑을 시작할 수 있다는 것을 알리는 프롬프트 (prompt) 를 표시한다. 해석기는 하나의 완전한 식을 기다린다. 이러한 식을 타이핑한 후에 리턴을 치면 해석기는 그것을 읽고, 평가하고 그리고 결과를 출력한다. 예를 들어, Lisp 에서 문자열과 숫자는 자기 자신으로 평가된다.
> "string"
"string"
>
3.14
3.14
기호와 식은 다르게 취급된다. 해석기에 아무 기호나 입력하면, 아마도 오류가 발생할 것이다. 이 책에서 사용하는 해석기는 모든 기호를 대문자로 표시하는 것에 유의하라. 이것은 대부분의 Lisp 시스템들이 사용하는 방법이다.
> sym
Error:
The symbol SYM has no global value
나중에 하나의 기호가 전역값 (global value) 을 갖는다는 것이 어떤 의미이고 그것을 어떻게 지정하는가를 명확히 설명할 것이다. 우선 지금은, 어떤 기호들은 전역값을 갖는다는 것을 아는 것만으로 충분하다. 특히, t 와 nil 이라는 기호는 Lisp 의 기본 부울값 (default boolean value) 인데, 그것들은 자기 자신으로 평가된다. Lisp 에서 t 는 부울 참 (boolean true) 에 해당하고, nil 은 부울 거짓 (boolean false) 에 해당한다. Nil 과 공 리스트 ( ) 는 이 장의 뒷부분에서 설명하겠지만 같은 기호이다.
> t
t
>
nil
nil
중첩된 리스트는 리스트의 괄호를 올바로 맞추어야 하기 때문에 초보자가 입력하기 어려워한다. 우리는 앞으로 당신이 해석기와 대화하는 것에 대해서 도움말을 주지 않을 것이다. 당신은 필요할 때, 매뉴얼이나 옆에 있는 Lisp 전문가에게 조언을 구하기 바란다. 아마도 당신의 Lisp 는 자동적으로 괄호를 맞추고, 줄맞춤 (indentation) 을 조절하고 그 밖에도 좀더 생산적인 기능을 포함하고 있을 것이다.
만일 해석기에 입력된 식이 문자열, 숫자, 기호 또는 다른 원시 객체가 아니면, 그것은 리스트이어야 한다. 그것이 리스트라면 특수 형식 (special form) 이거나, 하나의 함수를 호출하는 표현식이어야 한다. 우리는 이 책에서 함수라는 용어와 프로시저라는 용어를 같이 사용한다. 특수 형식은 조건문과 Lisp 에 의해 특별히 다루어지는 제어 구조의 흐름을 말한다.
함수는 기호를 함수에 대응시키는 하나의 전역 테이블 (global table) 에 저장되어 있다고 가정한다. 실제 Common Lisp 의 경우에 꼭 그렇게 되어야 할 필요는 없다. 그러나 이렇게 가정하면 설명을 쉽게 할 수 있다. Eval 은 함수의 호출을 다루기 위해서 또 다른 Lisp 프로그램인 apply 를 사용한다. Apply 는 두 개의 인수를 취하는데, 하나의 함수와 0 개 이상의 인수로 이루어진 리스트를 취한다. Eval 과 apply 는 다음과 같이 함께 동작한다.
① eval 은 함수 호출에 해당하는 리스트에서 그 리스트의 첫번째 요소와 그 나머지 요소들로 이루어진 인수 리스트를 뽑아낸다.
② 리스트의 첫번째 요소가 기호가 아니거나 또는 그 기호가 전역 테이블 (global table) 에 있는 함수들과 관련되어 있지 않으면, eval 은 오류를 발생시키고, 그렇지 않으면 eval 은 그 기호와 연관되어 있는 함수와 인수의 리스트를 apply 로 넘긴다.
③ Apply 는 eval 을 이용해서 인수의 리스트를 왼쪽에서 오른쪽의 순서로 평가한다.
④ Apply 는 그 함수와 연관되어 있는 정의 (definition) 부분을 뽑아낸다. 만일 그 정의에 연관되어 있는 형식 매개변수 (formal parameter) 의 개수가 인수의 수와 다르면 apply 는 오류를 발생시킨다.
⑤ Apply 는 세번째 단계의 결과들을 함수 정의의 복사본에 있는 형식 매개변수들로 치환하고 결과로 생긴 식을 평가하기 위해서 eval 로 보낸다.
앞의 설명은 함수 호출을 위한 치환모델 (substitution model) 이라고 부른다. 치환모델에서 함수의 호출이란 그 함수 정의의 복사본에 있는 형식 매개변수를 값으로 치환하고 그 결과로 생긴 식을 평가하는 것이다. 이제 Lisp 가 어떻게 함수 호출을 다루는지를 알아보았으니 호출할 함수들을 알아보자.
Common Lisp 는 내부 함수 (built-in function) 를 많이 가지고 있다. 함수가 어떤 것이 있는지를 대충 알아보기 위해서 참조 매뉴얼 (Steele [1990]) 을 훑어 볼 수 있다. 널리 사용되고 있는 다른 프로그래밍 언어에서 찾을 수 있는 함수들은 대부분은 Common Lisp 에서도 어떠한 형태로든 찾을 수 있다. 수식 연산에 대해서 Common Lisp 는 하나 이상의 인수를 수반하는 더하기 (+), 빼기 (-), 곱하기 (*), 나누기 (/) 에 대한 함수들을 포함하고 있다. 이들 함수는 정수와 실수의 어떠한 혼합도 합리적으로 수행할 수 있도록 고려되었다. 다음은 세 개의 수를 더하는 예와 4 로부터 2 와 1 를 빼는 예를 보이고 있다.
> (+ 3 4 5)
12
>
(- 4 2 1)
1

그림 3 중첩된 함수의 평가 순서
하나의 함수 호출에 해당하는 리스트를 평가할 때 인수는 왼쪽에서 오른쪽의 순서로 평가된다. 중첩된 함수 호출 시의 평가 방법은 가장 깊은 곳에 있는 인수를 먼저 평가하는 방식으로 이루어지게 된다. 그림 3 은 다음 호출로부터 기인하는 평가 트리 (evaluation tree) 를 보여주고 있다. 부 표현식 (subexpression) 의 평가 순서는 [ ] 에 있는 숫자로 표시되어 있다.
> (+ (*
(+ 1 2) 3) (/ 12 2))
15
부 표현식을 적절히 줄맞춤 (indentation) 함으로써 평가트리를 확실하게 보일 수 있다.
> (+ (*
(+ 1
2)
3)
(/ 12
2))
15
Lisp 구문은 프로그램의 구조를 명확하게 하도록 강요하지는 않는다. 인텐테이션은 프로그램의 구조를 나타내는 데 선택적으로 사용할 수 있다.
함수는 defun 이라는 특수 형식 (special form) 을 사용하여 정의되는데, defun 은 함수의 이름을 나타내는 기호와 그 함수의 형식 매개변수 (formal parameter) 에 해당하는 기호들의 리스트와 하나 이상의 식으로 정의되어 있다. Defun 은 주어진 이름으로 전역 테이블에 함수를 정의한다. 함수 정의로 프로시저를 서술할 수 있다. 예를 들어, ( * 3 3) 은 숫자 3 의 제곱을 계산한다. 다음과 같이 defun 을 사용하여 임의의 숫자의 제곱을 구하는 프로시저를 정의할 수 있다.
> (defun square
(x) (* x x))
SQUARE
> (square 3)
9
Eval 이 (square 3) 이라는 식을 만나면 그 식이 함수 호출이라는 것을 결정하고 square 와 인수 리스트인 (3) 을 apply 에 보낸다. Apply 는 전역 테이블에서 square 에 대한 정의를 찾는다. 이 경우에 그 정의는 (* x x) 이다. Apply 는 eval 을 사용하여 단 하나의 인수를 평가하여 3 을 얻고, (* x x) 에서 x 를 치환하여 (* 3 3) 를 얻고 다시 그 식을 평가하기 위해서 eval 로 보낸다.
|
;; Hypotenuse 는 직사각형의 두 변에 대한 길이에 ;; 해당하는 두 개의 인수를 취하고, ;; 직각삼각형의 빗변의 길이를 리턴한다. (defun hypotenuse (a b) ;; Sqrt 은 임의의 수의 제곱근을 계산하는 ;; 내부 함수이다. (sqrt (+ (square a) (square b)))) ;; Square 는 인수의 제곱을 계산한다. (defun square (x) (* x x)) |
그림 4 파일에서와 같이 나타나게 될 함수의 정의
그림 4 는 두 개의 함수 정의를 주석 (comment) 의 형태로 해설하고 있다. hypotenuse 가 파일 안에서 square 의 정의가 나타나기 전에 square 를 참조하고 있음을 주의하라. 실제로 호출되기 전에 함수가 정의된다면, 파일 안에서 어떠한 순서로 나타나도 된다.
Lisp 는 제어의 흐름을 위해 편리한 if 문의 형식을 제공하고 있다. Lisp 의 if 문은 (if test conditional alternate) 의 형태인데, 마지막의 alternate 는 선택 사양이다. eval 이 if 문을 만나면 test 식이 즉각 평가된다.
Lisp 에서 모든 식은 하나의 테스트 기능을 한다. 만일 식이 nil (또는 ( )) 를 리턴하면, 그 테스트는 실패라고 말하고 그렇지 않으면 성공이라고 말한다. 예를 들어, Lisp 의 술어 (predicate) 인 =, >, <, >= 는 수치적 관계를 테스트할 수 있도록 한다. Numberp 는 그것의 인수가 숫자인지를 테스트하고, symbolp 는 기호인가를 테스트를 한다. If 문에서 conditional 식은 그 테스트가 성공적이었을 때만 평가되고, alternate 식은 그 테스트가 실패했을 때만 평가된다.
함수 next-odd-number 는 인수로 지정된 정수의 다음으로 오는 홀수를 리턴한다. Next-odd-number 는 그것의 인수가 짝수인가를 테스트하기 위해서 evenp 를 사용한다. 또한 홀수인지를 테스트하는 oddp 라는 함수가 있다.
> (defun nex-odd-number
(n)
(if (evenp n)
(+
n 1)
(+
n 2))
NEXT-ODD-NUMBER
> (next-odd-number 1)
3
우리는 or, and, not 의 부울 연산자 (boolean operator) 를 사용하여 보다 복잡한 테스트를 만들 수 있다.
> (or (oddp
2) (and (not (oddp 4)) (evenp 6)))
T
not 이라는 연산자는 하나로 이루어진 인수가 nil 로 평가될 때 t 를 리턴하고, 그렇지 않은 경우에는 nil 을 리턴한다. and 라는 연산자는 임의의 수의 인수를 받아서 모든 인수가 nil 이 아닐 경우에는 마지막 인수의 값을 리턴하고 그렇지 않을 때에는 nil 을 리턴한다. or 이라는 연산자는 임의의 수의 인수를 받아서 nil 이 아닌 첫번째 인수의 값을 리턴하고 모든 인수가 nil 일 경우에는 nil 을 리턴한다.
Lisp 는 또한 보다 일반적인 조건문을 제공하고 있다. cond 문은 (cond clause1, clause2 ...) 라는 형식을 취하는데, 여기서 clause 들은 (test body) 의 형식으로 되어 있고, body 는 0 개 이상의 식으로 구성되어 있다. cond 문은 그것의 각 clause 의 test 를 그 중 하나가 성공할 때까지 차례로 평가한다. 성공이 되면, 그 clause 의 body 에 있는 식들이 순서대로 평가되고, 마지막 식의 값이 그 cond 문의 값으로서 리턴된다. 만일 clause 가 body 에 아무 식을 가지고 있지 않으면 test 의 값이 리턴된다. test 가 참이 아니면, 그 cond 는 nil 를 리턴한다.
다음에 49 보다 작은 수가 소수인지를 테스트하는 primep 라는 서술형 명제를 정의한다. Primep 는 주어진 숫자가 범위를 벗어날 때에 princ 라는 Lisp 프린트 함수를 사용한다. princ 라는 함수는 하나의 인수를 평가하여 그 결과값을 프린트하고 그 값을 리턴한다. Primep 는 또한 Lisp 의 나머지 (modulo) 함수인 mod 를 사용하여 숫자가 2, 3 또는 5 에 의해서 나누어질 수 있는지를 결정한다.
> (defun primep
(n)
(cond ((>= n 49) (princ ( "Can't
count that high.") nill)
((or
(= n 2) (= n 3) (= n 5)) t)
((or
(= (mod n 2) 0)
(=
(mod n 3) 0)
(=
(mod n 5) 0)) nil)
(t
t)))
> (primep 32)
NIL
> (primep 37)
T
> (primep 76)
Can't
count that high.
NIL
함수 primep 에서 t (자신을 평가하는 하나의 기호) 는 항상 성공하는 테스트의 역할을 한다. 어떤 테스트도 성공하지 않는 cond 문을 작성하는 것은 안 좋은 형태라고 생각한다. 따라서, 종종 마지막 clause 가 (t body) 의 형태인 cond 문을 보게 될 것이다.
재귀적인 (recursive) 문제해결 방법은 주어진 문제를 하나 이상의 보다 간단한 문제들로 줄이고, 그 간단한 문제들을 해결하기 위해서 자기 자신을 적용한다. 그것은 문제가 더 이상 줄여지지 않을 때까지 쉽게 해결될 수 있는 문제들의 조각으로 계속해서 나눈다. 이러한 방식으로 동작하는 함수를 정의할 수 있다.
이 책에서 서술하는 많은 함수들은 재귀적으로 정의되어 있다. 재귀함수 (recursive function) 란 그 함수가 그것의 정의 부분에서 재귀적으로 호출되는 함수를 말한다. 재귀 호출에서는 일반적으로 원래의 인수의 크기를 점점 줄여가면서 문제를 해결한다. 각 재귀 호출은 베이스 케이스 (base-case) 라는 판단기준이 만족할 때까지 계속해서 문제를 줄여나간다.
함수 raise 는 하나의 숫자와 음이 아닌 정수 n 의 두 개의 인수를 취하고, n 제곱으로 계산된 수를 리턴한다. 그것의 재귀함수는 다음과 같다.
> (defun raise
(x n)
(if (= n 0)
1)
* x (raise
x (- n 1)))))
RAISE
> (raise 3 3)
27
재귀 호출을 위한 베이스 케이스 (base-case) 판단기준, 즉 끝내는 조건은 n = 0 인 경우이다. 모든 수의 0 제곱은 1 이다. 만일 n 이 0 이 아니라면, x 와 (-n 1) 으로 이루어진 인수로 raise 를 호출한 결과를 x 에 곱한다.
앞으로 재귀함수의 예를 많이 제시할 것이다. 또한 재귀 호출이 어색한 경우를 위해서 반복 구조 (iterative construct) 에 대한 소개를 할 것이다.
이제, 함수를 작성할 수 있게 되었으니 아마도 그들 중 어떤 것을 Lisp 해석기에서 반복적으로 타이핑하지 않아도 되도록 파일에 저장하고 싶을 것이다. 하나의 Lisp 프로그램에 있는 연속된 Lisp 식들로 볼 수 있다. Lisp 프로그램을 실행하는 것은 프로그램에 있는 식들을 나타나는 순서대로 평가하는 것으로 이루어진다. 만일 여러 개의 식을 하나의 파일에 작성했다면, Lisp 해석기로부터 그 파일을 로딩 (loading) 함으로써 실행시킬 수 있다. 로딩은 (load file-specification) 이라는 형태의 식을 평가함으로써 이루어지는데, file-specification 은 하나의 파일을 지칭하는 문자열로 평가되는 식이다.
File-specification 의 정확한 형태는 당신이 사용하는 Common Lisp 프로그램과 운영체제에 따라 다를 수 있다. 그러나, 일반적으로 program.lisp 라는 파일이 존재하는 디렉토리에서 Common Lisp 를 실행시킨다면, (load "program.lisp") 을 평가하는 것으로 그 파일을 로드하고 그 안에 있는 식들을 평가하게 된다. 또한 load 문을 파일 안에 끼워넣음으로써 파일들간의 의존관계 (dependency) 를 설정할 수 있다. 예를 들어, program.lisp 가 functions.lisp 안에 있는 정의에 의존한다면 (load "function.lisp") 문을 program.lisp 의 어딘가에 놓아야 한다.
앞선 토론에서 값지정 (assignment) 의 표기에 대한 사항은 소개하지 않았다. 사실, 심지어 변수 (variable) 란 단어조차도 언급하지 않았다. 함수 정의에서 형식 매개변수의 치환에 대해서는 이야기했지만, 형식 매개변수에 값을 "지정" 할 수는 없었을 것이다. defun 으로 함수 정의를 기호로 지정할 수 있는 것은 사실이다. 하지만, 다음 절에서 언급할 이름없는 함수를 사용함으로써 defun 을 피할 수도 있다. 함수 이름이 아닌 기호들은 t 나 nil 같은 상수였다. 이제까지 소개한 Lisp 의 부분집합은 기본적으로 순수 Lisp 이다. 즉 함수, 상수, 부울 연산자만을 갖고, 값지정이 없는 Lisp 이다. 계속해서 값지정과 변수를 Lisp 에 추가할 것이고 그렇게 함으로써 Lisp 가 메모리를 사용하는 몇 가지 방법에 대해 확실하게 설명할 것이다.
사실 Lisp 에서 변수와 기호간에 차이점은 없고 그 용어를 바꾸어 쓰기도 한다. 기호는 바꿀 수 있는 값 (value) 을 가지고 있다. Lisp 에서의 기호는 값에 의한 호출 (call-by-value) 변수를 사용하는 언어에서의 변수에 해당한다. 우리는 setq (set equal 에서 기인함) 라는 특수 형식을 사용하여 기호의 값을 지정하거나 바꿀 수 있다.
> (setq sym
2)
2
> sym
2
> (setq sym 3)
3
> sym
3
setq 는 최소한 두 개의 인수를 갖는데, 첫번째 것은 반드시 기호이면서 평가되어서는 안되고, 두번째 것은 어떤 식이라도 될 수 있고 평가된다.
> (setq new sym)
3
>
new
3
Setq 는 (setq new 1 old 0) 과 같이 여러 개의 기호의 값을 한번에 지정할 수 있다.
Eval 이 기호를 만나면 테이블 같은 구조에서 그 기호의 값을 찾는다. 만일 그 테이블에 그 기호에 대한 아무런 등록 사항이 없으면 오류를 보고한다. 그 구조는 환경 (environment) 이라고 하는데, eval 은 찾아야 할 적당한 환경을 알아내야 한다. 앞의 예에서 eval 은 전역 환경 (global environment) 에서 기호값을 찾는다. 나중에 어떻게 부가적인 환경이 생성되고, eval 에 의해서 참조되는지를 설명할 것이다.
Common Lisp 에서 기호는 그것이 함수의 인수로 나타날 때 사용되는 값과, 그것이 함수 호출로 해석되는 리스트의 첫번째 원소로 나타날 때 사용되는 함수정의를 가질 수 있다.
이 시점에서 기호와 환경을 고려하는 eval 과 apply 의 동작에 대해서 다시 생각해보자. Eval 은 식에 해당하는 하나의 인수를 갖는다. 또한, eval 에게는 우선 하나의 환경으로 전역 환경이 주어진다. 다음에 eval 의 동작을 설명하는 의사코드 (pseudo code) 가 있다.
① 만일 식이 숫자 혹은 문자열이면 그 식을 리턴한다.
② 만일 식이 기호이면 환경에서 그것의 값을 찾는다.
③ 만일 식이 특수 형식 (special form) 이면 그에 알맞게 처리한다.
④ 만일 식이 리스트이면서 특수 형식이 아니면 리스트의 첫번째 항목에 해당하는 기호와 관련된 함수와 리스트의 나머지 부분에 해당하는 인수들을 apply 에 보낸다.
앞 절에서 치환모델을 사용하여 apply 를 설명하였다. 이제 환경의 관점에서 또 다른 모델을 설명한다. Apply 는 하나의 함수와 그것의 인수에 해당하는 식들의 리스트를 인수로 취한다. 각 함수는 그것이 정의된 환경과 연관되어 있다. 많은 경우에 있어서 연관된 환경은 오직 전역 환경이지만, 예외적인 경우도 있다. Apply 는 주어진 함수와 연관된 환경을 사용하여 새로운 환경을 만드는데, 거기서 그 함수의 정의를 평가하게 된다. 다음 절에서 한 환경으로부터 어떻게 다른 환경들이 생성되는가를 명확하게 설명할 것이다. eval 과 마찬가지로 apply 도 환경이 주어진다.
① 인수로 주어진 함수의 정의를 찾는다.
② eval 을 사용하여 그 환경에 있는 각 인수를 평가한다.
③ 정의 부분에 있는 각 형식 매개변수가 인수 리스트의 해당 항목의 값을 갖는 새로운 환경을 생성한다. 이 새로운 환경은 apply 에 주어진 환경이 아닌 함수에 관련된 환경을 사용하여 생성된다.
④ Eval 을 사용하여 새로운 환경에 있는 정의 부분을 평가한다.
eval 과 apply 모두 Lisp 프로그램에서 호출될 수 있는 함수라는 것에 유념해야 한다. apply 는 나중에 설명할 것이다. Lisp 코드에서 eval 을 사용하는 것은 대부분의 Lisp 함수와 마찬가지로 eval 이 그것의 인수를 평가한다는 사실 때문에 복잡해진다. 이것이 순환적으로 보인다면 그것은 실제로 그렇기 때문이다. 앞에서는 첫번째 단계의 평가가 어떤 식으로 나온 것처럼 그 첫번째 단계의 평가를 무시하고 eval 이 무엇을 하는가 만을 고려했다. 거의 사용할 필요는 없지만 프로그램을 작성할 때에 혹시 eval 을 사용하고자 하면 주의하기 바란다.
하나의 환경은 기호의 값을 위한 저장소 (storage) 를 할당한다. 전역 테이블은 단지 하나의 커다란 테이블로 생각할 수 있다. 새로운 기호를 setq 할 때마다 그 기호의 값을 가리키는 전역 환경에서 메모리가 잡힌다. 함수를 적용하는 동안과 어떤 특수 형식을 평가할 때에 생성된 환경은 보다 복잡한 구조를 갖는다. 일반적으로 하나의 환경은 테이블의 연결 리스트 (linked list) 이다. 새로운 환경은 기존의 환경으로부터 생성되는데, 이때 새로운 테이블을 생성하고 그것이 기존의 부모 환경을 가리키도록 한다. 함수 정의의 경우에 형식 매개변수를 위하여 테이블에 공간이 마련된다. 환경 안에서 기호의 값을 결정하기 위하여 eval 은 우선 환경이 가리키는 테이블을 조사해 본다. 그 테이블에 기호에 대한 등록이 없으면, eval 은 부모 환경을 들여다보고 계속해서 전역 환경에 도달할 때까지 계속하게 된다. 당신은 전역 환경의 값을 바꾸지 않고 한 환경에 있는 기호의 지역값 (local value) 을 바꿀 수 있다.
> (setq x 2)
2
>
(defun local (x)
(setq x (+
x 1))
(* x x))
LOCAL
> (local (+ x 1))
16
> x
2

그림 5 함수 호출 동안에 생성된 환경들
그림 5 는 (local (+ x 1)) 의 수행 동안에 각 단계에서 나타나는 환경을 보여주고 있다. 일반적으로 이렇게 하는 중요한 이유 중의 하나는, 전역 변수들은 긴 코드에서 추적하기가 어렵다는 것이다. 널리 흩어져 있는 전역 변수들은 큰 프로그램을 이해하기 어렵게 만든다.
> (defun global
(x)
(setq sym (+ x 1))
(* sym sym))
GLOBAL
>
(global 1)
4
> sym
2
지역 변수 (local variables) 로 사용하기 위해서 형식 매개변수로 기호를 도입할 필요는 없다. 특수 형식인 let 은 새로운 환경을 만들어 내기 위해 사용된다. let 을 사용하여 지역 변수를 만들어내고 나중에 특정 값으로 setq 하거나 또는 그것을 도입할 때에 바로 값을 할당할 수 있다. 일반적인 형식은 (let variable-specifications body) 인데, 여기서 variable-specifications 는 0 개 이상의 식으로 이루어진 리스트이고, 각각의 식은 하나의 변수 또는 (variable initial-value-expression) 형태의 식에 해당한다. body 는 하나 이상의 식으로 구성되어 있다. 그러한 형식을 평가할 때 Lisp 는 각 변수에 해당하는 초기값 식 (initial value expression) 이 있을 경우에는 그 값을 할당하고, 없을 경우에는 nil 을 할당한다. 이러한 지정은 병렬적으로 이루어져서 다른 초기값 식에 있는 변수를 참조할 수 없다. let* 라고 불리우는 let 의 변형이 있는데, 그것은 지역 변수를 순차적으로 값을 지정해서 variable-specifications 리스트에서 나중에 나타나는 다른 변수의 초기값 식에 앞선 변수를 참조할 수 있다.
다음은 하나의 선상에 있는 x, y 좌표로 표현되는 두 점을 취하고, 세번째 점의 x 좌표가 주어졌을 때에, 그 점의 y 좌표를 리턴하는 간단한 선형보간 (linear interpolation) 함수의 정의를 이용해서 지역 변수를 지정하는 두 가지 방법을 설명한다.
> (defun interpolate
(x1 y1 x2 y2 x3)
(if (= x1
x2)
y1
(let
((m (/ (- y2 y1) (- x2 x1)))
(b
y1)
(x
(- x3 x1)))
(+
(* m x) b))))
INTERPOLATE
> (interpolate 1 1 5 5 4)
4
>
(interpolate 1 3 4 3 2)
3
0 으로 나누는 것을 피하기 위해서 if 문을 사용하였다.
다음 함수는 let 을 사용하는 다른 예를 보여주는데 이 경우는 cond 문을 사용한다. Read 는 인수가 없이 표준 입력 (주로 터미널) 으로부터 하나의 식을 읽는 함수이고, random 은 양수 n 에 해당하는 하나의 인수를 취하고, 0 에서 n 사이 (이때 0 은 포함되나 n 은 포함되지 않음) 의 같은 형의 수 (이 경우에는 정수) 를 리턴하는 함수이다. n 이 정수인 경우에 가능한 결과들은 대략적으로 1/n 의 빈도로 나타난다.
> (defun guess
()
(princ "Guess an integer
from 0 to 9: ")
(let
((response (read)) (number (random 10)))
(cond
((> response number) (princ "Too high!"))
((<
response number) (princ "Too low!"))
(t
(princ "Lucky guess!")))))
GUESS
> (guess)
Guess an
integer from 0 to 9: 3
Too low!
3 은 프롬프트 (prompt) 에 대응해서 사용자가 입력한 것이다.

그림 6 중첩된 let 문을 사용하여 생성된 환경들
우리는 let 문을 여러 개 중첩함으로써 보다 복잡한 구조의 환경을 만들 수 있다. 하나의 환경을 통해서 도입된 변수의 유효범위 (scope) 는 let 또는 defun 에서 정의된 괄호의 범위에 의해서 결정된다. 이러한 이유로 그런 변수들을 가끔 사전적 또는 정적 (static) 변수로 부르고, 그것들의 유효범위를 결정하는 규칙을 사전적 유효범위 (lexical scoping) 라고 부른다. 많은 Lisp 변형들은 유효범위가 평가 시간에 결정되는 동적 (dynamic) 변수를 지원한다. 사전적으로 유효범위가 결정된 변수에 전적으로 의존하는 코드는 프로그래머가 보다 이해하기 쉽고 컴파일러가 효율적인 코드를 생성한다는 장점을 가지고 있다. 변수는 전역적 (global) 이거나 지역적 (local) 이고, 지역적인 경우에는 사전적 유효범위 결정 방법을 취한다.
다음의 코드에서 Lisp 의 프린트 함수인 princ 를 사용하여 변수의 사전적 유효범위 결정을 설명한다. princ 는 그것의 인수를 평가하고, 그 결과를 프린트하고, 프린트 문의 값으로 그 결과를 리턴하는 함수이다.
> (let ((x
1))
(let ((x 2))
(let
((x 3))
(princ
x))
(princ x))
(princ x))
321
1
let 문 다음에 오는 첫번째 줄은 세 개의 princ 를 호출한 결과이다. 두번째 줄은 let 문에 의해 리턴된 값이다. 그림 6 은 코드의 실행 동안에 다른 단계에서 존재하는 환경을 보여주고 있다.
Let 문은 복잡한 구조의 환경을 구축할 수 있도록 해준다. 이제까지 설명한 것으로부터 하나의 함수가 호출될 때 평가는 새로운 환경에서 시작하며 형식 매개변수를 저장하고 전역 환경을 가리키는 새로운 테이블을 포함한다는 것을 알 수 있다. let 이 없으면 모든 환경은 전역 환경을 가리키는 하나의 테이블만으로 구성될 것이다. 그림 7 은 재귀함수를 포함하는 하나의 예로서, (raise 3 2) 의 실행 동안에 다른 단계에 존재하는 환경들을 보여주고 있다. 다음 절에서는 환경을 이용하는 보다 복잡한 방법에 대해서 생각해 본다.
이제까지 소개한 함수를 정의하고 사용하는 방법들은 약간의 제한을 가지고 있다. 예를 들어, 함수는 전역 변수를 제외하고는 이전에 호출된 값을 다시 불러낼 수 없다. 모든 함수는 이름을 가져야 한다. 함수는 새로운 함수를 생성하거나, 인수로 함수를 전달하거나, defun 으로 정의되지 않은 함수를 사용할 수 없다. 이 절에서는 이러한 제한을 어떻게 극복할 수 있는지를 설명한다.
자료 또는 상태 (state) 를 하나의 특정 함수 또는 여러 함수로 연관시키는 것이 종종 유용할 때가 있다. 이렇게 하기 위한 방법은 다수의 전역 변수를 생성하고 적당한 값으로 setq 하는 것이다. 그러나 앞에서 지적했듯이 이렇게 전역 변수를 이용하면 프로그램을 이해하기 힘들어진다. 다른 방법은 지역상태 (local state) 를 참조하는 환경에 지역 변수를 사용하는 함수들을 중첩하는 형태로 환경을 생성하는 것이다.
하나의 환경이 존재해 있는 동안을 그것의 유효기간 (extent) 이라고 부른다. 이제까지 우리가 언급해왔던 환경의 유효기간은 단지 하나의 프로시저를 실행하는데 걸리는 시간이다. 한 가지 주목해야 할 예외가 있다. 전역 환경의 유효기간은 Lisp 프로세스가 실행되고 있는 전체 시간이다. 기호와 연관된 Lisp 객체가 생성될 때마다 그 객체는 그것의 환경을 가리키는 포인터를 유지하여 그 환경이 참조할 수 있도록 한다. 그 객체가 존재하는 한 그것과 연관된 환경은 계속 존재하게 된다. 이제까지 우리가 살펴본 Lisp 객체 중에서 변수를 참조할 수 있는 객체는 단지 함수들뿐이었으나 곧 그러한 다른 객체를 어떻게 생성하는지를 배울 것이다.
이제까지 고려해 왔던 모든 함수들은 그것과 관련된 환경으로 전역 환경을 가지고 있으나 다른 환경으로도 쉽게 함수를 정의할 수 있다. 다음의 squrelast 라는 함수는 마지막으로 사용한 인수에 해당하는 숫자를 기억하기 위해 지역상태를 사용하고 그 숫자의 제곱값을 리턴한다. Squarelast 는 사용자가 사용하기 바로 이전 단계의 답을 낸다.
> (let (x (y
1))
(defun squarelast (z)
(setq
x y) (setq y x) (* x x)))
SQUARELAST
> (squarelast 2)
1
>
(squarelast 3)
4

그림 7 재귀함수의 호출 동안에 생성된 환경들
defun 으로 정의되어 이름이 붙여진 함수는 변수에 의해 참조될 수 없는 Lisp 의 유일한 객체이다. Lisp 는 람다 (lambda) 함수라고 불리우는 이름이 없는 함수를 생성할 수 있다. (function (lambda arguments body)) 의 식은 arguments 에 있는 형식 매개변수와 body 에 있는 식으로 정의된 함수로 평가한다. Function 은 그것의 인수를 평가하지 않는다. 첫번째 원소가 lambda 인 리스트나 (function square) 에서의 square 와 같이 하나의 함수로 정의된 기호가 인수로 사용된다. 함수는 편리한 단축형을 가지고 있다. Common Lisp 에서는 (function expression) 의 단축형으로 #'expression 이라고 쓸 수 있다. Common Lisp 에서는 그러한 함수를 단순히 리스트의 첫번째 원소로 하여 호출할 수 없고 (Scheme 이라는 Lisp 버전에서는 할 수 있다), funcall 또는 apply 를 써야 한다.
Funcall 은 인수로 함수로 평가되는 식과 그 함수가 갖게 되는 인수들을 취한다. 즉, (funcall #'square 3) 의 형태이다. Apply 는 두 개의 인수만을 갖는다는 점 이외에는 funcall 과 비슷한데 두번째의 인수는 첫번째의 인수에 해당하는 함수에 제공되는 인수의 리스트로 평가되어야 한다. 아직 리스트로 평가되는 식을 만드는 방법을 설명하지 않았기 때문에 apply 를 사용한 예는 잠시 미루도록 한다. 다음에 함수와 funcall 을 설명하는 간단한 예가 있다.
> (funcall
#'(lambda (x) (* x x)) 3)
9
이름을 가진 함수와 lambda 함수는 모두 종종 변수로 전달되거나 funcall 의 인수로 전달되기 위해 리스트 안에 있게 된다.
> (defun decreasingp
(x y f)
(if (> (funcall f x)
(funcall f y)) t nill))
DECREASINGP
> (decreasingp 1 2 #'(lambda
(x) (* x x )))
NIL
> (setq reciprocal #/(lambda (x)
(/ 1 x)))
#<Interpreted-Function (LAMBDA (x) (/ 1 x)) 104BB75>
>
(decreasingp 1 2 reciprocal)
T
Lambda 함수도 연관되어 있는 상태 (associated state) 를 가질 수 있다.
> (let ((x 0))
(setq counter #'(lambda () (setq x (+ x
1)))))
#<Interpreted-function (LAMBDA () (SETQ X (+ X 1))) 104BB76>
>
(funcall counter)
1
> (funcall counter)
2
만일 counter 라는 기호에 새로운 어떤 것을 할당한다면, 생성되었던 환경은 유효기간이 끝이 나서 더 이상 존재하지 않게 된다.
이제까지 리스트는 프로그램을 위한 표현으로서만 사용했다. Lisp 에서는 프로그램과 자료 (data) 모두 리스트로 나타날 수 있다. 우리는 추상적 자료형 (abstract data type) 을 구축하고 Lisp 저장소의 추상화를 위해 리스트를 사용한다.
모순적으로 들릴지는 모르겠지만 기호 조작의 목적을 위해서 기호는 값을 갖지 않아도 된다. 하나의 기호를 참조하기 위해 (그것의 값을 참조하는 것이 아님) eval 이 평가를 중지하도록 하는 것이 종종 유용할 때가 있다. 이것은 Lisp 에서 quote 함수로 이루어진다. Quote 문은 Lisp 프로그램에서 매우 자주 쓰이기 때문에 편리한 생략형이 있다. 'expression 은 (quote expression) 의 생략형이다. quote 는 어떤 식이라도 eval 로 하여금 그것의 평가를 중지하도록 한다.
> (quote sym)
SYM
>
'sym
SYM
> '(first second third)
(FIRST SECOND THIRD)
기호들이 어떤 것인지 미리 알고 있다면 quote 를 사용하여 그 기호들의 리스트를 만들 수 있다. 또한 list 를 사용하여 프로그램 실행 중에 보다 융통성 있게 리스트들을 만들 수 있다.
list 라는 함수는 리스트를 만드는 편리한 방법을 제공한다. list 는 임의의 개수의 인수를 취해서 그 값들의 리스트를 리턴한다.
> (list 1 2
3 4)
(1 2 3 4)
> (list 1 (list 2 (list 3)))
(1 (2 (3)))
first 라는 함수는 리스트의 첫번째 원소에 접근할 수 있도록 해준다. Second, third, fourth, fifth, sixth, seventh, eighth, night, tenth 도 또한 각각 한 리스트의 두번재, 세번째, 네번째, 다섯번째, 여섯번째, 일곱번째, 여덟번째, 아홉번째, 열번째의 원소에 접근하도록 여러 다른 Lisp 버전에서 구현되어 있다. 보다 일반적으로는 (nth i l) 이라는 것이 있어 리스트의 l 의 i 번째 원소를 접근할 수 있게 해준다. 여기서 nth 라는 것은 0 으로부터 시작하는 것이므로, 리스트 l 의 첫번째 원소는 (nth 0 l) 이고, 두번째는 (nth 1 l) 이런 식으로 계속된다.
> (setq four
(list 2 3 4))
(1 2 3 4)
> (list (first four) (second four)
(nth 2 four))
(1 2 3)
> (rest four)
(2 3 4)
우리는 first 와 rest 를 이용하여 리스트를 분리할 수 있고, 두 개의 인수를 갖는 cons (constructor 에서 유래) 를 써서 다시 합칠 수 있다.
> (setq first
1)
1
> (setq rest (list 2 3 4))
(2 3 4)
> (cons first
rest)
(1 2 3 4)
대부분의 경우에 있어 cons 의 두번째 인수는 리스트지만, 반드시 그럴 필요는 없다.
Cons 는 점으로 연결된 쌍 (dotted pair) 을 만드는데, 그 이유는 곧 알게 될 것이다. 그것은 두 인수의 값을 참조하는 두 개의 포인터를 위한 저장소를 할당한다.
> (setq x (cons
1 2))
(1. 2)
> (setq y (cons 1 (cons 2 ())))
(1 2)
점으로 연결된 쌍에 대응하는 메모리의 구조는 콘스셀 (cons cell) 이라고 불리우고 포인터를 가진 맞붙여진 네모의 그림으로 묘사된다. 그림 8 은 앞의 식을 평가함으로써 얻은 구조를 보여주고 있다.
Lisp 에 대한 다른 책을 읽을 때 car 와 cdr 이란 함수를 보게 될지도 모른다. First 와 rest 가 car 와 cdr 보다 더 편하고 기억하기 쉬운 이름이다. car 와 cdr 의 이름은 Lisp 가 처음 설계되어 운용될 때에 컴퓨터의 기계 구조로 생겨났다.
> (car x)
1
>
(cdr y)
(2)
> (car (cdr y))
2

그림 8 메모리 상의 리스트 구조
몇몇 프로그래머들은 car 와 cdr 이란 고풍의 이름을 고집하는데, 그 이유 중의 하나는 여러 car 와 cdr 들이 연속적으로 오는 경우에 매우 편리한 생략형을 제공하기 때문이다. Lisp 의 많은 변형들에서는 연속된 car 와 cdr, 예를 들어 (car (cdr (car expression))) 과 같은 것들을 c[a|d]*r 의 형, 즉 (cadar expression) 의 형태로 생략할 수 있도록 해준다. 만일 이러한 함수가 당신의 Lisp 버전에 없으면 그것을 쉽게 정의할 수 있다.
사실 Lisp 로 프로그래밍하기 위해 메모리의 구조를 알 필요는 없다. 만일 한 기호가 가리키는 리스트를 변형하고자 한다면 새로운 리스트를 구성해서 그 기호에 새로운 리스트를 setq 하면 된다. 이러한 방법은 커다란 리스트를 복사하고 지루한 잡일을 하는 데에 상당량의 시간을 소비하는 결과를 낳는다. 예를 들어 새로운 리스트는 전 리스트와 하나 또는 두 개의 작은 차이만 있을 것이므로 거의 동일할 것인데도 전 리스트의 대부분을 다시 구성해야 할 것이다. 게다가 만일 두 개의 기호가 같은 리스트를 가리키거나, 한 기호가 다른 기호가 가리키는 리스트의 하부표현 (subexpression) 을 가리키면 그에 알맞도록 대처해야 할 것이다. 메모리의 내용을 직접적으로 변경함으로써 우리는 불필요한 복제나 기록을 피할 수 있다.
Lisp 는 메모리의 내용을 바꿈으로써 기존의 리스트 구조를 변경할 수 있도록 해준다. Setf 는 기호값에 의한 참조나 first, rest 의 호출에 의해서 제공되는 메모리 상의 위치와 하나의 식을 인수로 취해서 그 위치상에 있는 것을 식의 값으로 바꾼다. Self 는 첫번째 인수를 파괴적으로 변경한다.
> (setq x (list
1 (list 2)))
(1 (2))
> (self (first (first (rest x))) 1)
1
>
x
(1 (1))
Self 는 setq 보다 더 일반적이지만 setq 는 아직도 기호가 복잡한 메모리 변경이 아니라 그냥 값을 지정하는 것이라는 것을 나타내는 문서화의 목적으로 쓰이고 있다. self 는 부주의하게 사용되면 가끔 프로그램에서 민감한 오류를 유발할 수 있기 때문에 주의해야 한다. Self 는 표현상의 목적으로 유용한 순환적인 리스트 구조를 만들 수 있게 해준다. 그러나, 그러한 구조를 프린트할 때에는 조심하지 않으면 안된다.
> (self (first
(rest x)) x)
(1 (1 (1 (1 (1 (1 (1 (1 (1 (1 (1 ...
이 호출에 의한 해석기의 실행은 중단되어야 한다. 그렇지 않으면 끝없이 프린팅을 계속할 것이다. 그림 9 는 결과로 나온 구조를 그림으로 보여주고 있다. Common Lisp 는 순환적인 리스트 구조를 알맞게 출력하기 위한 프로시저를 포함하고 있다.

그림 9 메모리 상의 리스트 구조의 변경
해석기와의 다음 대화에서 설명되듯이 Lisp 는 값에 의한 호출 (call-by-value) 로 인수를 전달한다.
> (defun foo
(x) (setq x 0))
FOO
> (let ((x 1)) (foo x) (princ x))
1
우리는 포인터와 self 를 사용하여 다른 인수 전달 방법들을 흉내낼 수 있다. 다음은 참조에 의한 호출 (call-by-reference) 방식을 흉내내는 방법을 설명한다.
> (defun bar
(x) (self (first x) 0))
BAR
> (let ((x (list 1))) (bar x) (princ
(first x)))
0
그러나 Lisp 에는 기호를 참조에 의한 호출을 할 수 있는 방법은 없다.
Lisp 는 리스트에 대한 테스트를 수행하기 위한 다양한 부울 술어 (boolean predicate) 를 가지고 있다. listp 는 리스트에 대해서, consp 는 점으로 연결된 짝들 (dotted pair) 에 대해서, null 은 공백 리스트 nil 또는 ( ) 에 대해서 테스트를 한다. 리스트의 구조를 비교하기 위한 것으로 eq 와 equal 이 있다. eq 는 두 개의 인수가 메모리상의 같은 위치를 가리키는가를 결정한다. Nil 과 ( ) 는 eq 이다. Equal 은 두 개의 인수가 구조적으로 비슷한가를 결정한다.
> (setq sym
'foo)
FOO
> (eq sym 'foo)
T
> (setq sym (list 'foo)
(FOO)
>
(eq sym (list 'foo))
NIL
> (setq new sym)
(FOO)
> (eq
new sym)
T
> (equal sym (list 'foo))
T
리스트를 다루는 함수들 중에서 append 는 리스트로 평가되는 0 개 이상의 인수를 취해서 그들 리스트 안에 있는 모든 원소로 이루어진 새로운 리스트를 리턴한다. Nconc 는 마지막 원소를 제외한 모든 인수를 파괴적으로 변경한다는 점을 제외하고는 append 와 비슷하다.
> (setq x '(1
2) y '(3 4))
(3 4)
> (append x y)
(1 2 3 4)
> x
(1
2)
> (nconc x y)
(1 2 3 4)
> x
(1 2 3 4)
Reverse 는 하나의 리스트를 인수로 취해서 그것의 역순으로 배열된 원소들로 이루어진 새로운 리스트를 리턴한다. member 는 임의의 Lisp 객체와 리스트에 해당하는 두 개의 인수를 취하는 매우 유용한 Lisp 함수이다. 첫번째 인수에 해당하는 객체가 두번째에 해당하는 리스트의 원소이면 member 는 그 리스트에서 객체와 eq 관계인 첫번째 원소로부터 시작하는 리스트 (꼬리에 해당하는) 를 리턴한다. 만일 그 객체가 리스트의 원소가 아니면 member 는 nil 을 리턴한다.
> (member 5
(append '(1 2 3) '(4 5) '(6 7 8)))
(5 6 7 8)
Common Lisp 의 많은 함수들은 키워드로 끼워 넣을 수 있는 함수를 선택 사양의 인수로 취하고 있다. 키워드는 첫번째 문자가 콜론 (예를 들어, :test) 인 기호로서 인수 리스트에 나타난다. 예를 들어, 앞에서 member 는 리스트에 있는 객체를 테스트하기 위해서 eq 를 쓴다고 했다. 만일 (member x l) 이라고 쓰는 대신에 (member x l :test #'equal) 이라고 쓴다면, member 는 eq 대신에 equal 를 사용하여 테스트를 할 것이다. 또한 테스트 방법으로서 lambda 함수를 서술할 수도 있다.
> (member '(2)
'((1) (2) (3)))
NIL
> (member '(2) '((1) (2) (3)) :test #'equal)
((2)
(3))
> (member '(1 2) '((0 4) (1 3))
:test
#'(lambda (x y) (eq (first x)
(first
y))))
((1 3))
새로운 리스트 처리 방법을 사용하여 이제 하나의 숫자쌍 (예를 들어, (1 2)) 과 숫자 쌍의 리스트 (예를 들어, ((1 2) (2 4) (4 8))) 의 두 개의 인수를 가진 insert 라는 함수를 정의한다. 쌍의 리스트는 각 쌍의 첫번째 원소의 크기에 의해서 작은 수가 앞에 오도록 정렬되어 있다고 하자. 숫자쌍의 리스트는 x 와 f(x) 의 숫자쌍의 형태를 가진 샘플을 표현한다. 여기서 f(x) 는 하나의 변수를 갖는 스칼라 (scalar) 함수이다. 첫번째 원소가 같은 두 쌍을 리스트에 포함할 필요는 없다. 그 쌍들이 같은 함수에서 온 것이고 두 쌍의 첫번째 원소가 같다면 (=), 두번째 원소들도 역시 같고 두 쌍은 equal 일 것이다. Insert 는 첫번째 인수의 쌍을 새로 포함하는 정렬된 리스트를 생성한다. 이것은 first 와 rest 로 리스트를 분리하고, 필요한 곳에 새로운 쌍을 삽입하고, 다시 cons 로 이음으로써 만들게 된다.
> (defun insert
(new pairs)
(cond ((null pairs)
(cons new ()))
((=
(first new) (first (first pairs))) pairs)
((<
(first new) (first (first pairs))) (cons new pairs))
(t
(cons (first pairs) (insert new (rest pairs))))))
INSERT
> (insert
'(3 4) '((1 2) (2 4) (5 6)))
((1 2) (2 4) (3 4) (5 6))
> (insert
'(1 2) (insert '(3 4) ()))
((1 2) (3 4))
Insert 는 두번째의 인수에 해당하는 리스트가 nil 일 때까지 그 리스트의 rest 에 자기 자신을 재귀적으로 적용한다. 복잡하게 중첩된 리스트 구조로 되어있는 인수의 first 와 rest 모두에 재귀적으로 호출하는 방법은 종종 유용하게 사용된다. 다음 함수는 리스트의 first 와 last 모두 재귀적인 호출을 하여 주어진 기호의 모양을 테스트하는 것이다.
> (defun search
(symbol expression)
(cond ((null
expression) nil)
((symbolp
expression) (eq expression symbol))
(t
(or (search symbol (first expression))
(search
symbol (rest expression))))))
SEARCH
> (search 'fred '(student
(name fred) (year junior)))
T
이제 숫자와 숫자쌍의 리스트를 입력으로 받아 그 숫자가 쌍들의 첫번째 원소들 중 가장 큰 것보다 크거나 가장 작은 것보다 작으면 nil 을 리턴하는 함수를 정의한다. 만일 쌍 중에서 첫번째 원소가 주어진 숫자와 같은 (=) 것이 있으면, 그 함수는 그 쌍으로 이루어진 리스트를 리턴한다. 그렇지 않으면, 그 함수는 두 개가 연속적으로 존재하는 두 쌍 중에서 앞 쌍의 첫번째 원소는 그 숫자보다 작고, 뒤 쌍의 첫번째 원소는 그 숫자보다 큰 것을 쌍으로 만들어 리턴한다 (즉, ((1 2) (3 6))).
> (defun nearest-pairs
(x pairs)
(cond ((null pairs)
nil)
((=
x (first (first pairs)))
(list
(first pairs)))
((or
(< x (first (first pairs)))
(null
(rest pairs))) ())
((<
x (first (second pairs)))
(list
(first pairs) (second parties)))
(t
(nearest-pairs x (rest pairs)))))
NEAREST-PAIRS
> (setq pairs '((1
2) (2 4) (5 6)))
((1 2) (2 4) (5 6))
> (nearest-pairs 2 pairs)
((2
4))
> (nearest-pairs 3 pairs)
((2 4) (5 6))
지역상태 (local state) 를 사용한 예에서와 같이 자료를 계속 기억하면서 계산하는 두 함수를 정의한다. Remember 는 함수 f 에 대한 (x f(x)) 형태의 숫자쌍을 기억한다. 특정 x 값에 대한 f(x) 의 평가값을 계산해야 할 때 estimate 는 x 가 데이터의 범위를 벗어나면 경고하고, (x f(x)) 의 쌍을 저장하고 있으면 f(x) 의 값을 리턴하고, 그렇지 않으면 앞에서 설명한 선형 보간법 (linear interpolation) 을 호출한다. 그림 10 은 두 함수의 코드를 보여주고 있다.
|
;; 지역 상태 변수에 있는 자료를 추적한다. (let ((data ())) ;; 기존의 자료 집합에 새로운 자료를 추가한다. (defun remember (x y) (setq data (insert (list x y) data))) ;; 자료를 기반으로 평가를 한다. (defun estimate (x) (let ((pairs (nearest-pairs x data))) (cond ((null pairs) "Outside range!") ((null (ret pairs)) (second (first pairs))) (t (interpolate (first (first pairs)) (second (first pairs)) (first (second pairs)) (second (second pairs)) x))))))) |
그림 10 자료를 기억하고 평가하기 위한 함수들
> (remember
1 1)
((1 1))
> (remember 2 3)
((1 1) (2 3))
> (remember
3 3)
((1 1) (2 3) (3 3))
> (estimate 2.4)
3
> (estimate
1.2)
1.4
cons 와 list 를 사용하여 임의의 자료 구조를 구축하고 first 와 rest 로 그것들은 참조할 수 있고 self 로 그것들을 변경할 수 있다. 그러나, 그렇게 구현된 복잡한 자료 구조는 이해하기 힘든 코드를 유발하는 경향을 보인다. 대부분의 프로그래머는 자료 구조가 어떻게 구성되어 있는지에 대한 상세한 부분을 숨기는 자료 추상화 (data abstraction) 를 설계하게 된다. 이것은 여러 명의 프로그래머에게 구현을 해야 한다는 부담과 그 구현이 함부로 변경될 것이라는 걱정을 없애준다.
명칭이 붙은 이진트리 (labeled binary tree) 를 조작하는 프로그램을 작성하고 있다고 가정하자. Cons, first, rest 와 같은 기초적인 함수들로 이진트리를 조작하는 것 대신에 우리가 정의하고 기억하기 쉬운 이름을 가진 함수를 사용한 자료 추상화를 설계하자. 그림 11 은 명칭이 붙은 이진트리의 사례 (instance) 를 생성, 테스트, 접근, 변경하는 연산을 가진 추상적 자료형을 정의하는 함수를 보여주고 있다.
|
;; 명칭이 붙은 이진트리의 인스턴스를 하나 생성한다. (defun make-TREE (label left right) (list 'labeled-binary-tree label left right)) ;; 하나의 개체가 명칭을 가진 이진트리인가를 결정한다. (defun is-TREE (x) (and (listp x) (eq (first x) 'labeled-binary-tree))) ;; 명칭을 가진 이진트리의 명칭을 리턴한다. (defun TREE-label (tree) (second tree)) ;; 명칭을 가진 이진트리의 왼쪽 가지 (branch) 를 리턴한다. (defun TREE-left (tree) (third tree)) ;; 명칭을 가진 이진트리의 오른쪽 가지를 리턴한다. (defun TREE-right (tree) (fourth tree)) ;; 명칭을 가진 이진트리의 명칭을 지정한다. (defun set-TREE-label (tree value) (self (second tree) value)) |
그림 11 명칭이 붙은 이진트리를 위한 추상적 자료형
추상적 자료형을 포함하는 코드를 보다 쉽게 읽기 위해서 추상적 자료형을 정의하는 데에 몇 가지의 관례가 있다. TYPE 이라는 추상적 자료형을 만들고 싶다고 가정하자. TYPE 의 사례를 만들기 위한 함수는 make-TYPE 이라고 불리워질 것이다. 임의의 Lisp 객체가 TYPE 의 사례인지를 테스트하는 함수는 is-TYPE 이라고 부른다. 만일 그 자료형이 slot 이라고 불리우는 어떤 내부 구조에 대한 접근을 허용한다면 그 접근 함수는 TYPE-slot 이라고 부른다. slot 에 의해서 식별된 내부 구조가 변경될 수 있는 것이면, 그 변경하는 함수는 set-TYPE-slot 이라고 부른다. 비록 Lisp 가 일반적으로는 대문자와 소문자를 구별하지 않지만, Lisp 코드를 표시하는 데에 있어서 우리는 추상적 자료형을 가리키는 데에 그것 자체가 소문자를 포함하고 있는 경우는 제외하고는 대문자를 사용한다. 이러한 관례는 Lisp 코드를 보다 이해하기 쉽게 만들기 위한 것이다.
자료 추상화를 생성하고 난 후 상세한 부분에 대해서는 잊어버리고 그 추상화된 것을 사용하여 프로그램을 작성할 수 있다. 그림 12 는 명칭이 붙은 이진트리에서 명칭을 변경하는 함수를 보여주고 있다. TREE-sub 는 연속적인 식들을 하나의 형식으로 모으는 Lisp 구조인 progn 을 사용한다. Eval 은 progn 안에 있는 각각의 식을 차례로 평가하고 마지막 것의 값을 리턴한다.
|
;; tree 의 old 를 new 로 치환한다. (defun TREE-sub (tree old new) ;; tree 가 아니면, 아무것도 하지 않는다. (if (is-TREE tree) ;; 요구된 치환을 수행한다. (progn (if (eq old (TREE-label tree)) (set-TREE-label tree new)) ;; 왼쪽과 오른쪽 가지에 재귀적으로 적용한다. (TREE-sub (TREE-left tree) old new) (TREE-sub (TREE-right tree) old new)))) |
그림 12 이진트리에서 명칭을 변경하는 프로그램
여기에 하나의 명칭이 붙은 이진트리를 생성하고 명칭을 치환하기 위해서 TREE-sub 를 사용하는 예가 있다.
> (setq tree
(make-TREE 1 (make-TREE 2 ( ) ( ))
(make-TREE
3 ( ) ( ))))
> (LABELED-BINARY-TREE 1 (LABELED-BINARY-TREE 2 NIL NIL)
(LABELED-BINARY-TREE
3 NIL NIL))
> (TREE-sub tree 3 7)
NIL
> tree
(LABELED-BINARY-TREE
1 (LABELED-BINARY-TREE 2 NIL NIL)
(LABELED-BINARY-TREE
7 NIL NIL))
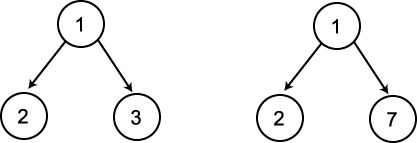
그림 13 명칭을 가진 이진트리의 명칭이 치환되기 전과 치환된 후의 모양
그림 13 은 이러한 호출에 생성된 추상적 자료형의 사례와 명칭 치환으로부터의 변화를 설명하고 있다.
이 장에서는 Lisp 가 제공하는 순차적인 기능과 자료 추상화 기능을 대략적으로만 설명한다. Common Lisp 과 그것의 확장된 버전에서는 큰 프로그램을 구성하고 복잡한 자료형을 다루기 위한 다양한 기술을 포함하고 있다. Lisp 는 추상화를 통하여 실험하는 데에 훌륭한 환경을 제공한다. Lisp 가 영향을 크게 끼친 한 분야를 꼽는다면 객체지향 프로그래밍 (object-oriented programming) 에 대한 상당량의 연구가 Lisp 를 사용하여 행해졌다는 것이다. 오늘날, Common Lisp 안에서도 객체지향 프로그래밍을 위해 많은 기능이 제공되고 있다.
앞 절에서 재귀 호출에 대한 강조를 했지만, Lisp 프로그래밍에서 다른 반복 구조 형식을 사용하는 것을 말리지는 않는다. 단지, 재귀적인 표현이 가장 자연스러운 형태로 표현되는 논리 (logic) 와 논리 프로그래밍 (logic programming) 에 대한 지식을 가능하면 이용하고자 하는 것이다. Common Lisp 는 반복을 위한 다양한 구조를 제공한다. 계속해서 다음 장에서 사용하게 될 구조에 대해서 서술한다.
종종 같은 연산을 리스트에 있는 모든 구성요소에 적용하는 것이 편리할 때가 있다. Lisp 은 이것을 위해서 다양한 대응 구조 (mapping construct) 를 제공하고 있다. Mapcar 은 첫번째 인수를 다음에 오는 리스트들에 대해 각기 대응되는 원소들끼리 적용하여 그 결과들의 리스트를 리턴한다. 여기에 숫자들의 리스트로 표현된 두 벡터의 합을 계산하는 간단한 방법이 있다.
> (mapcar #'(lambda
(x y)
(if
(> x y) x y))
'(2
7 5) '(1 9 4))
> (2 9 5)
Mapc 는 결과에 대해서 아무것도 하지 않는다는 것 외에는 mapcar 와 비슷하다. Mapc 는 단지 부작용 (side effect) 만을 위해서 사용된다. Mapcan 은 nconc 를 이용하여 결과를 덧붙이는 것 외에는 mapcar 와 비슷하다.
> (mapcan #'(lambda
(x)
(if
(numberp x) (list x) nill))
'(1
2 nil 3 4 nil 5 6 7 nil 8 9 ))
(1 2 3 4 5 6 7 8 9)
Reduce 는 이진연산에 해당하는 함수와 하나의 리스트를 인수로 취해서 이진연산을 사용하여 리스트의 원소들을 결합한다. 다음에 reduce 를 설명하는 두 예가 있다.
> (reduce #'+
'(1 2 3))
6
> (reduce #'(lambda (v w) (mapcar #'+ v w))
'((1
0 0) (0 1 0) (0 0 1)))
(1 1 1)
첫번째 예는 숫자들의 리스트의 합을 계산한다. 두번째 예는 벡터들의 리스트의 합을 계산한다. 첫번째 경우에는 (apply #'+ '(1 2 3) 을 사용해도 된다.
do 구조는 Common Lisp 에서 가장 널리 쓰이는 반복 구조 중의 하나이다. 일반적인 형식은 (do index-variable-specifications (end-test result) body) 인데, 여기서 index-variable-specifications 는 (step-variable initial-value step-value) 형태의 항목들의 리스트이고, end-test 는 임의의 식 그리고 result 와 body 는 하나 이상의 식으로 이루어져 있다. Step value 또는 step value 와 initial value 는 생략될 수 있다. 뒤의 경우에는 괄호 안에 index variable 을 포함시킬 필요가 없다. do 를 처음 실행할 때 스텝변수 (step variable) 는 초기값 (initial value) 이 되거나, 초기값이 없는 경우에는 nil 이 된다. do 에 의해 반복되는 루프에서 각 스텝변수는 그것의 step value 가 되거나, step value 가 없는 경우에는 변하지 않는다. 스텝변수의 값지정은 병렬적으로 수행된다. 각각의 루프에서 스텝변수들이 지정되고 나서, end test 가 평가된다. 만일 end test 가 nil 이 아닌 값을 리턴하면 result 식이 순서적으로 평가되고 마지막 것의 값을 리턴한다. 그렇지 않으면 body 에 있는 식들이 순서적으로 평가된다. 다음에 9! 을 계산하고 부작용 (side effect) 으로 1 부터 9 까지의 수를 프린트하는 do 루프의 간단한 예가 있다.
> (do ((i 1
(+ i 1))
(j
1 (* j i)))
((=
i 10) j)
(princ
l))
123456789
362880
다음에 do 루프가 대응 함수를 포함하는 식을 어떻게 대치할 수 있는지를 설명하는 예가 있다.
> (setq list
'(1 2 3 4))
(1 2 3 4)
> (do ((args list (rest args))
(result
nil (cons (oddp (first args)) result)))
((null
args) (revere result)))
(T NIL T NIL)
> (mapcar #'oddp list)
(T
NIL T NIL)
이와 같이 특별한 경우에는 mapcar 식이 훨씬 간결하지만, do 루프가 대응 함수보다 훨씬 적절하게 도움이 되는 경우가 많이 있다.
do 의 특별한 경우에 해당하는 것으로서 자주 쓰이는 편리한 반복 구조들이 있다. Dolist 는 일반적으로 (dolist (var expr result) body) 의 형태로 사용되는데, 여기서 var 는 expr 을 평가함으로써 만들어진 리스트의 원소들로 연속적으로 지정되는 기호이고, body 는 리스트의 각 원소에 대해서 한번씩 평가되고, result 는 body 가 평가된 후에 dolist 의 값으로 평가되어 리턴되는 선택 사양이다. 만일 result 가 주어지지 않으면, dolist 는 nil 을 리턴한다. expr 은 처음으로 루프의 body 에 들어가기 전에 오직 한번만 평가되고, expr 에 있는 변수의 값을 바꾸는 것이 body 가 평가되는 회수를 변경하지 않는다. 이러한 방법을 사용하지 않는 것이 좋다. Dotimes 는 일반적으로 (dotimes (var expr result) body) 의 형태로 사용되는데, 이 경우에 var 는 0 부터 expr 의 평가로부터 나온 정수 (이것은 포함하지 않음) 에 이르는 정수들로 지정된다. body 에 있는 var 의 값을 변경하는 것은 위험하다. 이와 같은 반복 구조들을 설명하는 예들은 다음과 같다.
> (dolist (x
'(a b c)) (princ x))
ABC
> (dotimes (i 10 i) (princ i))
0123456789
10
다음 장에서 우리는 대응 함수, 재귀 호출 그리고 이들 반복 구조들을 사용한 다른 스타일의 프로그래밍 방법을 설명할 것이다. 책에 나온 프로그램을 작성하는 방법은 한 가지 방법만 있는 것은 아니다. 편하게 느낄 수 있는 코딩 스타일을 찾는 연습을 해야 한다.
대부분의 경우에 있어서 Lisp 프로그램을 디버깅하는 것은 다른 언어의 프로그램을 디버깅하는 것과 다르지 않다. 코드가 기대했던 대로 실행되지 않으면 우선 함수 이름의 철자가 틀리지 않았는가, 괄호가 맞지 않았는가, 함수에 전달되는 인수의 개수가 맞지 않았는가, 부적당한 인수 또는 값을 지정하기 전에 변수를 이용하지 않았는가 등 가장 흔한 오류를 검사하면서 디버깅을 시작하라.
대부분의 최근에 구현된 Lisp 들은 정교한 디버깅 도구를 제공하고 있으나, 이러한 도구들에 대한 논의는 이 책의 범위를 벗어난다. 그 대신 모든 Common Lisp 시스템에서 사용할 수 있고, 이 책에 있는 연습문제를 위해서도 충분히 쓸 수 있는 간단한 디버깅 도구와 기술들을 살펴본다.
코드가 실행되고 있는 동안에 정보를 프린트하기 위해서 princ 나 이 절의 마지막 부분에 설명할 format 이라는 좀더 복잡한 프린트 기능을 사용할 수 있다. 가장 간단하게 디버깅을 도울 수 있는 방법 중의 하나는 변수의 값의 변화를 추적하기 위해 코드에 임의로 프린트 문을 첨가하는 것이다.
Common Lisp 의 trace 기능을 사용하여 언제 어떤 인수로 어떠한 함수가 호출되는지를 추적할 수 있다. 다음의 예는 이 장의 앞부분에서 정의된 두 개의 함수를 어떻게 추적하는지를 설명하고 있다.
> (trace raise
square)
(RAISE SQUARE)
> (square (raise 2 2))
1 Enter RAISE
2 2
| 2 Enter RAISE 2 1
| 3 Enter RAISE 2 0
| 3 Exit
RAISE 1
| 2 Exit RAISE 2
1 Exit RAISE 4
1 Exit SQUARE 4
1 Exit
SQUARE 16
16
untrace 를 사용하여 함수를 추적하는 것을 그만둘 수 있다.
> (untrace
raise)
(RAISE)
> (square (raise 2 2))
1 Enter SQUARE 4
1
Exit SQUARE 16
16
가끔 trace 는 충분한 정보를 제공하지 않거나, 반대로 우리가 원하는 것보다 너무 많은 정보를 제공하기도 한다. 그런 경우에는 한 단계만을 조사하는 것이 유용할 것이다. step 이라는 것이 바로 그 기능을 한다. trace 의 상세한 부분과 마찬가지로 step 의 상세한 부분은 Common Lisp 의 시스템에 따라 제각기 다르다. 다음 예는 step 을 사용하면 무엇이 유용한지를 보여줄 것이다.
> (setq
n 3)
3
> (step (square n))
(SQUARE N)
→ :h
:n Eveluate current
expression in step mode.
:s
Evaluate current expression without stepping.
:x
Finish evaluation, but tum Stepper off.
:p
Print current expression.
:b
Enter the Debugger.
:q
Exit to Top Level.
:h
Print this text.
(SQUARE N) → :n
(FUNCTION SQUARE) →
:n
#<Interpreted-function (NAMED-LAMBDA SQUARE (x)
(BLOCK
SQUARE (* X X))) 100DCD6>
N = 3
(BLOCK
SQUARE (* X X)) → :n
(*
X X) → :n
(function *)
→ :n
#<Compiled-function
* 4ABA76>
X
= 3
X = 3
이 예에서 :h 와 :n 는 → 프롬프트에 대응해서 사용자가 입력한 것이다.
오류없이 평가되는 프로그램을 작성하는 것은 거의 불가능하다. 오류가 일어날 때마다 자동적으로 디버거에 들어가서 어지러운 정보들이 나타나고, 곧 또 하나의 프롬프트가 나타나게 될 것이다. 보통 ? 또는 help 라고 입력하면 오류로부터 계속 진행해 나아갈 수 있도록 해주는 메뉴들의 리스트를 보여주거나 오류를 일으킨 원인에 대한 정보를 보여줄 것이다.
오류와 디버깅은 프로그래밍에 있어 피할 수 없는 것이다. 사용하고 있는 Common Lisp 의 디버깅 도구에 친숙해 지도록 충분한 시간을 들이는 것이 좋다.
우리는 이미 프로그램으로부터 서식 출력 (formatted output) 을 생성하는 princ 라는 함수를 보았다. princ 와 선 복귀 (line feed) 를 만들어내는 terpri 라는 함수를 사용하여 대부분의 원하는 출력을 다룰 수 있다. Common Lisp 에서는 그것들보다 발전된 방법들이 있으나, 그 중에 하나만을 간단히 설명한다.
Format 은 복잡한 프린팅 또는 서식 도구이다. (format destination string arguments) 의 형태가 format 을 호출하는 일반적인 방법인데, 여기서 string 은 탭기능 (tabbing), 선 복귀 그리고 인수들을 프린트하는 서식 명령을 포함한다. 서식 명령은 틸드 (tilde) 문자 (~) 로 표시되고 그 뒤에 하나 이상의 문자가 더 온다. 다음 예는 format 을 사용하는 몇 가지 방법을 보여주고 있다.
> (format nil
:~D is an integer, ~A is a symbol" 17 'foo)
"17 is an integer,
FOO is a symbol"
> (format nil "~4,2F is a real number"
1.2356)
"1.23 is a real number"
> (let ((x 6) (y 1.2))
(format nil "~D times ~4,2F
is ~4,2F" x y (*x y)))
"6 times 1.20 is 7.20"
>
(format nil "Here~%is a line break.")
"Here
is a line
break."
서식 명령 ~4,2F 는 정해진 서식을 프린트할 때 사용되는데, 여기서는 소수점을 포함하여 최소 네 개의 자리수로 실수를 표현하고, 소수점 이하는 두 자리로 표현하라는 것을 지시한다. 서식 명령 ~A 는 princ 로 프린트하는 것과 마찬가지로 임의의 객체를 프린트하는 데에 사용된다. 만일 destination 이 nil 이면 format 은 서식화된 문자열을 리턴한다. 그렇지 않으면, format 는 nil 을 리턴하면서 문자열을 지정된 destination 으로 보낸다. 만일 destination 이 t 이면 format 은 일반적으로 Lisp 해석기가 사용하고 있는 터미널이나 화면인 기본 출력 (standard output) 으로 프린트한다.
Common Lisp 는 오류에 대처하거나 해석기와 대화하기 위한 다양한 프린트 루틴을 제공한다. Lisp 해석기를 다루면서 유용하다고 생각되는 것 하나를 소개하겠다. (setq *print-pretty* t) 라고 실행하면 많이 중첩된 리스트 구조를 훨씬 읽기 쉽도록 보이게 할 수 있다.
이 장의 처음 부분에서 배달 로봇의 행동을 제어하는 규칙들을 사용하는 응용 예를 설명했다. 감각기기와 감각기기의 값들을 표현하고 제어 매개변수와 그것들의 가능한 값을 표현하기 위한 기호를 도입하였다. 이제 로봇을 제어하기 위해 사용되는 필요한 규칙과 프로시저를 묘사하기 위한 필요한 준비를 모두 갖추었다. 우선, 감각기기의 값과 제어 매개변수의 값에 대한 리포트를 위한 자료 추상화로부터 알아보자.
(defun make-TUPLE
(param value) (list param value))
(defun TUPLE-param (tuple) (first tuple))
(defun
TUPLE-value (tuple) (second tuple))
예를 들어, (forward near) 는 forward 감각기기가 near 의 값을 가지고 있다는 리포트에 해당한다.
같은 감각기기는 다른 시간에 다른 보고를 할 것이다. 리포트의 시간에 대한 사항을 계속 유지하기 위해서, 우리는 각 리포트가 발생한 시간에 해당하는 정수를 연관시킨다. 다음의 자료 추상화는 감각기기와 매개변수 리포트에 사용된다.
(defun make-REPORT
(tuple stamp) (list tuple stamp))
(defun REPORT-tuple (report) (first
report))
(defun REPORT-stamp (report) (second report))
(defun REPORT-param
(report) (TUPLE-param (first report)))
예를 들어, ((forward far) 1012) 는 forward 감각기기가 시간 1012 에 far 를 보고한 것을 나타낸다. 계속되는 설명에서 자료를 생성해내는 제어 시스템에 관한 부분에 관해서는 언급하지 않을 것이므로 make-REPORT 와 make-TUPLE 는 사용하지 않겠다.
제어 알고리즘은 감각기기와 제어 매개변수의 가장 최근의 리포트로 이루어진 리스트를 사용한다. 우선 처음으로 고려할 update 라는 루틴은 새로운 리포트의 리스트와 이전의 리포트의 리스트를 인수로 취하고 그것들을 결합한다. 이전의 리스트는 모든 감각기기들과 제어 매개변수들로부터의 리포트를 포함하고 있지만, 새로운 리스트는 그렇지 않다. 리포트를 결합하는 방법은 각각의 이전 리포트를 고려하여 새로운 리포트에서 갱신이 되었는가를 조사하는 것이다.
Common Lisp 의 assoc 함수는 하나의 식과 nil 이 아닌 리스트로 이루어진 두 개의 인수를 취한다. 두번째 인수는 결합 리스트 (association list) 라고 불리우는데, 기호식 간에 대응이 가능하도록 해준다 (예를 들어, ((type truck) (color red) (year 1950))). 간단하게 사용할 수 있는 것으로 assoc 은 하나의 기호와 기호 쌍들의 리스트를 인수로 취해서 first 에 해당하는 원소가 첫번째 인수와 eq 인 쌍이 있으면 그 첫번째 쌍을 리턴하고, 그러한 쌍이 없으면 nil 을 리턴하는 것이다. 예를 들어, (assoc 'left '((left far) (right near))) 은 (left far) 를 리턴한다.
Assoc 은 키워드에 의해 지정된 선택 인수를 사용할 수 있다. 시간 도장이 찍힌 리포트의 리스트는 ((left far) 1) 형태로 되어 있는 것을 유의하라.
> (assoc '(left
far) '(((left far) 1)))
NIL
> (assoc '(left far) '(((left far)
1)) :test #'equal)
((left far) 1)
갱신된 리포트를 찾기 위해서 같은 매개변수에 대해 다른 값을 가진 새로운 리포트를 찾는다.
> (assoc '(left
far) '(((left near) 1)) :test #'equal)
NIL
> (assoc '(left far)
'(((left near) 1))
:test
#'(lambda (x y) (eq (first x) (first y))))
> ((left near) 1)
또 다른 선택 키워드 인수를 사용하여 연상 리스트에 있는 쌍들의 첫번째 원소를 가리키도록 하여 같은 결과를 얻을 수 있다.
> (assoc 'left
(((left far) 1)) :key #'first)
((left far) 1)
결합 리스트에 있는 각 쌍의 첫번째 원소에 대해서 assoc 의 첫번째 인수를 테스트하는 대신에 :key 에 의해서 도입되는 함수를 결합 리스트에 있는 각 쌍의 원소에 대해서 적용한 결과에 대해 첫번째 인수를 테스트한다.
대단치 않은 문제가 하나 있다. assoc 에 대해서 언급할 때 튜플 (tuple) 이 두 개의 원소를 가진 리스트로서 구현되어 있고, 리포트는 한 튜플과 하나의 정수로 이루어진 리스트로서 구현되어 있다고 가정했다. 이것은 괜찮은 방법이지만 자료 추상화를 이용하는 중요한 이점은 그것이 어떻게 구현되어 있는지에 대하여 생각할 필요가 없도록 하는 것이었다. 앞에서 했던 것처럼 assoc 을 사용함으로써 구현하는 데 장점이 있었지만 결과적으로는 자료 추상화를 위반한다. 만일 어떤 사람이 그 구현을 변경하려 한다면 예를 들어 리스트 대신에 배열 (array) 을 사용한다든지, 마지막의 시간 도장 대신에 처음 것에 시간 도장을 찍는다든지 하면, assoc 이 사용된 모든 위치를 찾아내어서 새로운 구현에 맞도록 바꾸어야만 한다.
리포트가 반드시 리스트로 구현되어 있다고 가정할 수 없기 때문에 assoc 를 사용할 수 없다. 그러나, assoc 에 대해서 배운 것은 헛된 것이 아니다. 우리는 assoc 을 다음 장에서 친숙하게 사용할 것이다. assoc 대신에 find 라는 보다 일반적인 함수를 사용할 수 있다. Find 는 임의의 Lisp 객체와 하나의 리스트를 인수로 취하고, 리스트상에서 그 객체와 eq 인 첫번째 원소를 리턴하거나, 그런 원소가 없는 경우에는 nil 을 리턴한다. 선택 사항인 :key 함수는 assoc 에서와 같이 원소의 first 에 적용되는 것이 아니라 리스트의 원소에 적용된다. 예를 들어 (assoc item list) 는 (find item list :key #'first) 와 같다.
find 를 사용하여 자료 추상화를 유지하면서 리포트의 리스트에 대한 연관계산을 수행하는 두 개의 함수를 정의해보자. 첫번째 함수는 특정 매개변수를 튜플로 리포트를 찾는 것이고, 두번째 함수는 튜플로 리스트를 찾는다.ㅏ
(defun param-assoc
(param reports)
(find param
reports :key #'REPORT-param))
(defun tuple-assoc (tuple reports)
(find tuple reports :test #'equal
:key #'REPORT-tuple))
이제, update 에 대한 알고리즘을 다음과 같이 서술할 수 있다. 우리는 시간 도장이 찍힌 리포트의 두 리스트로 update 를 호출한다. 이전 리포트들의 리스트에 있는 각 시간 도장 찍힌 리포트에 대하여 같은 매개변수를 가진 새로운 리포트가 있는가를 살펴본다. 만일 그렇다면, 리포트의 리스트에 새로운 리포트를 첨가하고 update 에 의해서 리턴이 되도록 한다. 그렇지 않으면 이전 리포트를 리포트의 리스트에 첨가하고 리턴한다. 이 알고리즘은 Lisp 으로 다음과 같이 구현된다.
(defun update
(new old)
(mapcar #' (lambda (item)
(or
(param-assoc (REPORT-param item) new)
item))
old))
(or first second) 의 형식은 (let ((result first)) (if (null result) second result)) 를 계산하고 있다.
update 를 구현하는 또 다른 방법을 생각해 보자. 이 경우에서는 이전 것이나 새로운 리포트 모두 감각기기와 제어 매개변수에 대한 리포트를 반드시 포함할 필요가 없고 같은 매개변수의 여러 시간에서의 리포트들을 포함할 수 있다고 가정해보자. 다음의 구현에서 dolist 의 반복 구조와 리포트를 인수로 하고 그것을 이전 리포트와 결합하는 fuse 라는 서브루틴을 사용한다. 이전 알고리즘에서와 같이 시간 도장이 찍힌 리포트들의 두 리스트로 update 를 호출한다. 그러나 이 경우에는 fuse 서브루틴을 사용하여 이전의 리포트의 리스트를 갱신하면서 새로운 리포트들을 한번에 하나씩 단계적으로 처리한다.
(defun update
(new old)
(dolist (item new
old) (setq old (fuse item old))))
Fuse 는 하나의 리포트와 리포트들의 리스트를 인수로 취한다. 만일 첫번째 인수보다 빠른 시간 도장을 가지며 같은 매개변수에 대해 보고하는 리포트가 리스트에 있으면 처음 나오는 그 리포트를 첫번째 인수로 치환하고, 그런 리포트가 없으면 리포트 리스트의 마지막에 첫번재 인수를 첨가한다. Fuse 는 재귀 호출을 사용하여 first 와 rest 로 이전 리포트 리스트를 분리하고, cons 로 다시 합친다. 같은 매개변수를 가진 이전 리포트 대신에 새로운 리포트를 치환하거나 또는 그러한 이전 리포트가 없으면 이전 리포트들의 끝에 새로운 리포트를 덧붙인다.
(defun fuse (report
old)
(cond ((null old) (list report))
((eq
(REPORT-param report) (REPORT-param (first old)))
(if
(> (REPORT-stamp report) (REPORT-stamp (first old)))
(cons
report (rest old)) old))
(t
(cons (first old) (fuse report (rest old)))))))
다음은 update 가 어떻게 동작하는지를 보여주는 예이다.
> (update '(((forward
near) 2) ((left near) 2) ((left far) 1))
'(((forward
far) 0) ((left away) 0) ((right near) 1)
((rear
far) 0) ((speed slow) 1)))
(((LEFT NEAR) 2) ((FORWARD NEAR) 2) ((RIGHT
NEAR) 1)
((REAR FAR) 0) ((SPEED SLOW) 1))
다음에 fuse 의 또 다른 구현방법으로 param-assoc 와 Common Lisp 에서 제공하는 remove 함수를 사용하는 방법이 있다. Remove 는 하나의 식과 리스트를 인수로 취하며 그 결과는 식과 eq 인 원소만을 나머지 원소들로 이루어진 새로운 리스트가 된다. 예를 들어, (remove 1 '(1 2 3 1)) 은 (2 3) 을 리턴한다. Remove 는 선택적인 키워드 인수를 가진다. 예를 들어, (remove '(1 2) '(a (1 2) b c) :test #'equal) 은 (a b c) 를 리턴한다.
(defun fuse (report
old)
(let ((a (param-assoc (REPORT-param report) old)))
(cond ((null a) (cons report old))
((<
(REPORT-stamp report) (REPORT-stamp a)) old)
(t
(cons report (remove a old)))))))
(cons report (remove a old)) 대신에 (substitute report a old) 로 바꾸어 쓸 수도 있다. Substitute 는 세번째 인수에 해당하는 리스트의 원소들 중에 세번째 인수로 나타나는 모든 원소들을 첫번째 인수로 치환하는 것이다. Subst 는 중첩된 리스트 구조에서 치환을 행한다. 예를 들어, (substitute 1 0 '(0 1 (1 0))) 은 (1 1 (1 0)) 을 리턴하는 데에 반해서 (subst 1 0 '(0 1 (1 0))) 은 (1 1 (1 1))) 을 리턴한다.
이 책에서 서술한 대부분의 Common Lisp 함수는 언급했던 것보다 훨씬 융통성이 있다. 즉, 많은 함수들은 설명한 것보다 키워드를 더 많이 가지고 있다. 게다가 리스트에 적용할 수 있는 함수 중 대부분은 리스트와 일차원 배열을 포함하는 보다 일반적인 순차적인 자료에도 적용할 수 있다.
이제, 감각기기 리포트를 갱신할 수 있게 되었으니 어떠한 행위를 취해야 하는가를 결정할 필요가 있다. 그 제어 전략은 규칙의 집합으로 코드화되어 있다. 우리는 규칙을 위해 다음과 같은 자료 추상화를 사용한다.
(defun RULE-conditions
(rule) (first rule))
(defun RULE-action (rule) (second rule))
조건 (condition) 은 감각기기/값쌍에 해당하고, 행위 (action) 는 제어 매개변수/값의 쌍에 해당한다. 규칙의 각 조건이 리포트와 equal 의 관계로 연관되어 있으면 그 규칙은 주어진 리포트들의 집합에 대해서 적용가능하다라고 한다. 다음 함수는 규칙이 적용가능한가를 결정하는 술어를 구현한 것이다.
(defun applicablep
(rule reports)
(aux-applicablep
(RULE-conditions rule) reports))
(defun aux-applicablep (tuples reports)
(or (null tuples)
(and
(tuple-assoc (first tuples) report)
(aux-applicablep
(rest tuples) reports))))
Applicablep 는 규칙과 시간 도장이 찍힌 리포트들의 리스트를 인수로 취하고, 그 규칙의 조건 리스트에 있는 각 조건이 리포트 리스트에 있는 한 리포트에 해당하는가를 재귀 호출을 사용하여 검사한다. 보조 함수는 재귀 호출에 들어가는 tuples 라는 변수를 도입하여 재귀 호출을 완성한다. 이와 같은 보조 함수는 재귀적인 프로시저를 구현하는 데에 많이 쓰인다.
우리는 또한 부울함수와 같이 동작하는 특별한 대응 함수를 사용하여 applicablep 를 구현할 수 있다. (every test arguments) 라는 식은 test 가 arguments 의 각각의 원소에 끼리끼리 적용될 때에 모두 nil 이 아니면 t 를 리턴한다. 예를 들어 (every #'oddp '(3 5 9)) 와 (every #'eq '(a 1) '(a 1)) 은 모두 t 를 리턴한다.
(defun applicablep
((rule reports)
(every #'(lambda (tuple) (tuple-assoc
tuple reports))
(RULE-conditions
rule)))
다음 함수는 규칙 집합에 있는 모든 규칙을 테스트하고, 그 중 적용가능한 규칙에 따라 실행한다.
(defun react (rules
reports)
(dolist (rule rules reports)
(if
(applicablep rule reports)
(setq
reports (fuse (act (RULE-action rule)) reports)))))
우리가 간단하게 구현한 것에서 실제로 이루어지는 것은 단지 규칙의 행위에 시간 도장을 추가하는 것뿐이다. Common Lisp 함수인 get-intermal-real-time 은 현재의 시간을 표현하는 정수값을 리턴한다.
(defun act (action) (list action (get-internal-real-time)
여기에 react 의 결과를 보여주는 간단한 예가 있다.
> (react '((((forward
near) (jleft far)) (turn left)))
'(((forward
near) 0) ((turn right) 1) ((jleft far) 1)))
(((TURN LEFT) 2214639) ((FORWARD
NEAR) 0) ((JLEFT FAR) 1))
만일, 서로 어긋나는 두 개 이상의 적용가능한 규칙이 있는 경우에는 함수는 각 행위에 act 를 모두 적용할 것이다. 보다 현실적인 구현에서는 적용가능한 규칙의 충돌을 해결하는 방법들을 제공해야 할 것이다.
다른 유용한 대응함수를 사용하여 react 를 구현하는 방법을 알아보자. Mapcan 은 nconc 를 사용하여 결과를 결합한다는 점을 제외하면 mapcar 와 거의 비슷한 기능을 한다. 예를 들어 (mapcan #'rest '((0) (1 a) (2) (3 b) (4 c))) 와 (apply #'nconc (mapcar #'rest '((0) (1 a) (2) (3 b) (4 c))))) 는 모두 (a b c) 를 리턴한다.
(defun react (rules
reports)
(update (mapcan #'(lambda (rule)
(and
(applicablep rule reports)
(list
(act (RULE-action rule)))))
rules)
reports))
run 이라는 함수는 Lisp 의 반복 구조인 dotimes 를 사용하여 react 와 update 를 한 사이클에서 적용한다. collect 가 가장 최근의 감각기기 리포트를 리턴한다고 가정하자.
(defun run (rules
reports)
(dotimes (index 100 reports)
(setq
reports (react rules (update (collect) reorts)))))
이 함수는 0 부터 99 까지의 index 값으로 100 번의 사이클을 수행한다. 또 다른 방법으로 상호간에 호출하는 재귀함수를 사용하여 run 을 구현할 수 있을 것이다.
(defun run (rules
reports)
(aux-update rules (collect) reports 0))
(defun
aux-update (rules new old i)
(if (< i 100) (aux-react
rules (update new old) i)))
(defun aux-react (rules reports i)
(aux-update
rules (collect) (react rules reports) (+ i 1)))
설명한 바와 같이, Common Lisp 은 알고리즘을 구현하는 데에 있어 매우 다양한 방법들을 가능하게 해준다. 다음 장부터는 가장 간단하거나 혹은 매우 간결한 구현방법을 선택하여 설명할 것이다.
이 장에서는 Lisp 로 기호 프로그래밍을 하는 방법을 소개하였다. 여기서는 표준으로 자리잡아 가고 있는 Lisp 버전인 Common Lisp 의 부분집합을 다루었다. 이것은 이 책에 나오는 모든 프로그래밍 예를 이해하는 데 충분하고 Lisp 에 관해 더 공부할 수 있도록 하는 훌륭한 기초가 될 것이다. 규칙을 기호식으로 나타내고 추론을 수행하기 위하여 식을 조작하는 것을 응용 예로 들어 설명하였다. 이 장의 마지막에서는 Lisp 로 특정한 규칙기반 시스템을 구현하는 방법을 설명함으로써 끝을 맺었다.
Lisp 의 문법은 리스트의 일반화된 형태인 표현식을 기본으로 하고 있다. Lisp 프로그램은 단지 식의 연속된 형태라고 볼 수 있다. Lisp 의 의미론적 해석은 두 개의 Lisp 프로그램인 eval 과 apply 의 관점에서 설명할 수 있다. 함수, 상수, 부울연산을 포함하지만 값지정은 갖고 있지 않은 순수 Lisp 에 대한 설명을 먼저 하였다. Lisp 속에 구축되어 있는 몇몇 함수들은 다른 함수들, 특히 재귀함수를 정의하기 위한 기술과 함께 설명하였다.
Lisp 에서 기호와 변수는 같은 것이다. 값지정은 변수들에 연관되어 있는 값을 변경시킬 수 있도록 해준다. 환경은 변수의 값을 추적하는 데에 사용된다. Lisp 의 변수들은 프로그램의 어떤 부분이 변수의 값을 변경할 수 있겠는가를 쉽게 결정하기 위해서 사전적으로 유효 범위가 결정된다. let 과 같은 환경 구성자는 프로그래머로 하여금 지역 변수를 사용하고 지역상태를 함수에 연관시킬 수 있게 해준다. 지역상태를 가진 함수는 이전의 호출에 대한 정보를 보관할 수 있다.
Lisp 는 함수들을 다른 함수의 인수로 전달할 수 있도록 해준다. Lisp 의 내부 함수들은 함수가 인수로 사용되는 선택적인 키워드 인수를 가지고 있다. 함수의 키워드 인수는 프로그래머로 하여금 일반적으로 함수들을 특정 응용에 맞추어 사용할 수 있게 한다. 또한 특정 목적을 위해서 구축하고 사용 후에 버릴 수 있는 람다 (lambda) 함수라 불리우는 이름이 없는 함수를 만들 수 있다.
Lisp 는 리스트를 만들고, 접근하고, 변경하고, 탐색하기 위한 다양한 함수들을 제공한다. Lisp 의 리스트는 포인터의 추상화를 제공하여 많은 작업들을 간단하게 만든다. 기호에는 메모리 상의 리스트 구조를 가리키는 포인터에 해당하는 값이 지정될 수 있다. 리스트는 종종 집합, 큐 (queue), 트리, 그래프를 표현하기 위한 원시적 자료 구조로 사용된다. 또한 리스트를 사용하여 하위 단계의 프로그래밍 세부 사항을 감추고 코드를 보다 쉽게 이해할 수 있도록 하기 위한 추상적 자료형을 구축할 수 있다.
이 책에서 알고리즘이 자연스럽게 재귀적으로 구현되는 경향을 띠는 경우에 자주 재귀함수를 사용하여 프로그램을 작성할 것이다. 또한 반복을 설명하기 위한 다른 방법들도 이용할 것이다. Lisp 는 대응함수와 일반적이면서 특정화되어있는 반복 형식을 포함한 여러 반복 구조들을 지원하고 있다.
입력과 출력을 다루고, 디버깅하고, 파일에 있는 함수들을 평가하는 기본 방법들에 대해서 설명하였다. 만일 Lisp 로 커다란 프로그램을 작성하려면 Lisp 에 대해 보다 자세하게 설명된 것이 필요할 것이다. 그러나 다음 장부터 나오는 프로그램들을 이해하고 실험하는 데에 있어서는 이 장에서 설명한 것으로 충분할 것이다.
Lisp 는 John McCarthy 에 의해서 발명되었고 Lambda Calculus 라고 불리우는 형식 시스템 (formal system) 에 기본을 두고 있다. Lisp 는 현재까지 사용되고 있는 컴퓨터 언어 중에서 FORTRAN 다음으로, 두번째로 오래된 것이다. Lisp 가 리스트와 기호식을 조작하도록 고안된 첫번째 언어는 아니었다. IPL 이라고 불리우는 보다 이전의 리스트 처리 언어가 Herbert Simon 과 Allen Newell 에 의해서 자동 문제해결에 관한 작업을 위해 개발되었다. MaCarthy 는 Lisp 의 부분집합이 튜링 머신이 계산할 수 있는 어떠한 함수도 계산할 수 있다는 것을 보였다 [McCarthy, 1960]. 그는 어떤한 Lisp 함수도 해석할 수 있는 보편적인 함수를 Lisp 으로 어떻게 작성할 수 있는가를 보임으로써 증명하였다. McCarthy 의 그 보편적인 함수는 eval 이라고 불렀다.
Lisp 는 기호 프로그래밍을 용이하게 하기 위해 고안되었다. 지적하지는 않았지만 정말 편하다고 느끼게 될 중요한 특징 중의 하나는 대부분의 자료형을 위한 저장소를 할당하고 회수하는 것을 Lisp 가 담당하고 있다는 것이다. 임의의 리스트 구조를 만들고 계산 수행을 위해서 그것을 임시적으로 사용하고, 사용을 끝냈을 때에 그것에 연관된 저장소를 회수하는 것을 모두 Lisp 에 맡길 수 있다. 어떠한 기호에도 (직접적으로 또는 간접적으로) 참조되어 있지 않은 저장소를 자동적으로 회수하는 것을 garbage collection 이라고 부른다. garbage collection 과 같은 특징은 바르게 시안을 만들고 시험적인 연구의 목적으로 Lisp 가 훌륭하게 사용될 수 있도록 해준다.
만일 Common Lisp 에 대해서 좀더 배우고 싶다면 Steele 의 해설 [Steele, 1990] 을 참고하도록 하라. Lisp 로 프로그래밍하는 방법을 좀더 배우고 싶다면 [Wilensky, 1986] 와 같이 Common Lisp 에 관한 책이나 [Touretsky, 1986] 와 같이 Lisp 에 대한 일반적인 개론에 관한 것을 고려하는 것도 좋을 것이다. Scheme 이라는 Lisp 의 변형에 대한 Lisp 프로그래밍에의 개론을 위해서는 Abelson 과 Sussman [1985] 에 의한 책을 참조하기 바란다.