함수 프로그래밍 언어
프로그래밍 언어론 : Robert W. Sebesta 원저, 유원희.하상호 역, 홍릉과학출판사, 1999 (원서 : Concepts of Programming Languages, 4th ed), Page 659~700
이 장은 함수 프로그래밍과 소프트웨어 개발에 함수 프로그래밍을 적용하기 위해 설계된 몇 개의 프로그래밍 언어를 소개한다. 이 언어들은 수학 함수에 기초를 두었기 때문에, Church 의 람다 함수 기호를 포함하여 함수의 기본 개념을 복습하면서 시작한다. 또한, 이 절은 범함수 형태의 간단한 논의와 몇 개의 가장 일반적인 범함수 형태를 포함한다. 다음으로, 함수 프로그래밍 언어의 개념을 소개하고, 뒤 이어 첫번째 함수 언어인 LISP 과 LISP 의 리스트 데이터 구조와 람다 기호에 기초한 함수 구문을 소개한다. 다음의 약간 긴 절에서 Scheme 을 소개하고 몇 개의 기본 함수, 특수 형태, 범함수 형태 (functional form), Scheme 으로 작성한 몇 개의 간단한 함수가 포함된다. 그런 후, Scheme 의 몇 개의 명령형 특징을 간단히 논의한다. 다음에 함수 프로그래밍 언어의 몇 개의 다른 (Scheme 과 다른) 설계 고려사항을 보이기 위해 COMMON LISP, ML, Haskell 을 간단히 소개한다. 다음 절은 함수 프로그래밍 언어의 응용을 서술한다. 마지막으로, 함수 언어와 명령형 언어를 간단하게 비교한다.
이 책의 처음 13 개장은 주로 명령형 언어와 객체지향 언어에 관한 것이었다. Smalltalk 를 제외하고는 우리가 논의한 객체지향 언어는 명령형 언어와 유사한 형태를 갖는다. 이 장이 비명령형 언어 부류에 초점을 맞춘 첫번째 장이다.
명령형 언어들 사이에 높은 유사성은 부분적으로는 그들 설계의 공통 기초인 von Neumann 구조 (1 장에서 서술함) 에 기인한다. 명령형 언어들을 총괄하여 기본 모델 (FORTRAN I) 을 개선시키는 개발의 진행과정으로 생각할 수 있다. 이 모든 언어가 von Neumann 컴퓨터 구조를 효율적으로 이용하기 위해 설계되었다. 명령형 스타일의 프로그래밍이 대부분의 프로그래머에 의해서 받아들이는 것으로 알려졌을지라도, 기본 구조에 지나친 의존은 소프트웨어 개발과정에 불필요한 제한으로 생각되고 있다.
언어 설계에 대한 다른 기준이 존재하며, 이들 중 많은 것이 특별한 컴퓨터 구조에서 효율적인 실행보다는 특별한 프로그래밍 패러다임이나 방법론에 더 지향적이다. 그러나 지금까지, 이들 언어에 작성된 프로그램을 실행하는 데 있어서 효율성의 감소가 이들이 명령형 언어처럼 대중적으로 되는 것을 막았다.
수학 함수에 기초한 함수 프로그래밍 패러다임은 가장 중요한 비명령형 스타일 언어 중 하나의 설계 기준이다. 이런 스타일의 프로그래밍은 함수형 즉 적용형 프로그래밍 언어에 의해서 지원된다.
LISP 은 순수한 함수 언어로 시작됐지만, 곧 실행 효율을 증가시킨 몇 개의 중요한 명령형 특징을 수용했다. LISP 은, 적어도 광범위하게 사용되는 언어라는 의미에서, 아직도 함수 언어 중 가장 중요한 언어이다. Scheme 은 작고, 정적-영역 규칙을 사용하는 LISP 의 파생언어이다. COMMON LISP 는 LISP 의 1980 년대 초반의 여러 파생 언어들의 혼합형이다. ML 은 LISP 와 Scheme 보다 더 편리한 구문을 갖는 강 타입 함수 언어이다. Haskell 은 부분적으로 ML 에 기초를 두고 있지만 순수 함수 언어이다.
이 장의 목적은 함수 프로그래밍의 개념을 소개하는 것이지, 함수 프로그래밍의 과정은 아니다. 또한 함수 프로그래밍의 편리한 장치를 제공하기 위해 언어가 설계되는 여러 방법을 서술할 것이다. 우리의 접근 방법은 수학 함수와 함수 프로그래밍을 논의한 후 함수 프로그래밍 스타일을 설명하기 위해 순수 함수 언어인 Scheme 의 부분 집합을 소개한다. 독자가 작지만 흥미있는 프로그램을 작성하도록 Scheme 에 관한 충분한 자료가 포함되었다. 실제적인 프로그래밍 경험 없이 함수 프로그래밍의 실제적인 느낌을 얻는 것은 어렵다. 따라서 이것이 강력히 권장된다.
수학 함수는 정의역 (domain set) 이라 불리는 집합의 원소를 치역 (range set) 이라 불리는 집합으로의 사상 (mapping) 이다. 함수 정의는 사상과 함께 명시적 혹은 묵시적으로 정의역과 치역을 명시한다. 사상은 표현식 또는 어떤 경우에는 테이블로 서술된다. 함수는 가끔 정의역의 특정 원소에 적용된다. 정의역 집합은 여러 집합의 곱집합일 수 있음에 유의하라. 함수는 치역 집합의 원소를 산출 또는 반환한다.
수학 함수의 기본적 특성 중 하나는 사상 표현식의 평가 순서는 명령형 프로그래밍 언어에 일반적인 순차와 반복보다는 재귀와 조건식으로 제어된다는 것이다.
함수의 다른 중요한 특성은 부작용 (side effect) 이 없기 때문에, 동일한 인자 집합이 주어지면 항상 동일한 값을 정의한다는 것이다. 프로그래밍 언어의 부작용은 메모리 기억장소를 모델하는 변수와 관계된다. 수학 함수는 값을 생산하기 위해 메모리에 있는 값에 대한 연산들의 순서를 명시하기 보다 값을 정의한다. 명령형 언어 의미의 변수는 없다. 따라서 부작용이 있을 수 없다.
함수 정의는 종종 함수 이름, 괄호로 작성된 매개변수 리스트, 사상 표현식 순으로 작성된다. 예를 들면,
cube (x) ≡ x * x * x, 단 x 는 실수
이 정의에서 정의역과 치역은 실수이다. 기호 ≡ 는 "로 정의된다" 를 의미한다. 매개변수 x 는 정의역의 임의의 원소를 나타내지만, 함수식을 평가하는 동안 특정한 원소를 나타내도록 고정된다. 이것이 수학 함수의 매개변수가 명령형 언어의 변수와 다른 방법이다.
함수 적용은 함수 이름과 정의역 집합의 특별한 원소와 쌍을 형성함으로써 명시된다. 치역 원소는 각 매개변수가 정의역 원소로 치환된 함수 사상식을 평가함으로써 얻는다. 예를 들면, cube (2.0) 은 8.0 을 산출한다. 다시 한번, 평가 동안 함수의 사상식은 바인딩 안된 매개변수는 없다는 것 (바인딩된 매개변수는 특별한 값의 이름이다) 에 유의하는 것이 중요하다. 모든 매개변수는 정의역 집합의 원소에 바인딩되고 평가동안 상수로 생각된다.
함수에 관한 초기 이론 연구는 함수를 정의하는 작업과 함수를 명명하는 작업을 분리했다. Alonzo Church (Church, 1941) 가 고안한 람다 기호는 무명 (이름 없는) 함수를 정의하는 방법을 제공한다. 람다식 (lambda expression) 은 매개변수와 함수의 사상을 명시한다. 람다식이 함수 자체이다. 예를 들면, 다음을 생각하자.
λ (x) x * x * x
앞에서 언급한대로, 평가전에 매개변수는 정의역의 임의의 원소를 나타내지만, 평가동안 매개변수는 특별한 원소에 바인딩된다. 람다식이 주어진 매개변수에 평가될 때, 그 식은 그 매개변수에 적용된다고 말한다. 그러한 적용의 동작 구조는 함수 평가와 동일하다. 위 람다식의 적용은 다음 예제처럼 나타낸다.
(λ (x) x * x * x) (2)
이 식의 결과는 8 이다.
다른 함수 정의와 마찬가지로 람다식은 한 개 이상의 매개변수를 가질 수 있다.
고차 함수 또는 범함수 형태 (functional form) 는 매개변수로 함수를 취하거나 결과로 함수를 산출하는 (또는 두 가지) 함수이다. 가장 일반적인 종류의 범함수 형태는 합성 함수 (function composition) 이다. 합성함수는 두 개의 함수 매개변수를 취하여 두번째 매개변수 함수의 결과에 첫번째 매개변수 함수를 적용한 결과를 값으로 갖는 함수를 산출한다. 합성 함수는 o 를 연산자로 사용하여 다음과 같이 작성한다.
h ≡ f o g
예를 들면,
f (x) ≡ x + 2
g (x) ≡ 3 * x
구성 연산자 (construction) 는 매개변수로 함수 리스트를 취하는 범함수 형태이다. 인자에 적용했을 때, 구성 연산자는 각 함수 매개변수를 그 인자에 적용하여 결과를 리스트 또는 수열에 수집한다. 구성 연산자는 [f, g] 처럼 함수를 각괄호 (bracket) 안에 놓음으로서 구문으로 표시된다. 다음 예제를 생각하자.
g (x) ≡ x * x
h (x) ≡ 2 * x
i (x) ≡ x / 2
라면, [g, h, i] (4) 는 (16, 8, 2) 를 산출한다.
모두-적용 (apply-to-all) 연산자는 매개변수로서 단일 함수를 취하는 범함수 형태이다. 인자 리스트에 적용했다면, 모두-적용 연산자는 인자 리스트에 있는 각 값에 범함수 매개변수를 적용하여 결과를 리스트나 수열로 수집한다. 모두-적용 연산자는 α 로 나타낸다. 다음 예제를 생각하자.
h (x) ≡ x * x
라면
α (h, (2, 3, 4)) 는 (4, 9, 16) 을 산출한다.
다른 범함수 형태가 많이 있지만, 이 예제들은 그들의 특성을 설명하고 있다.
함수 프로그래밍 언어의 설계 목적은 가능한 많이 수학 함수를 모방하자는 것이다. 이것은 문제 해결에 명령형 언어에서 사용한 방법과는 기본적으로 전혀 다른 접근 방법이 된다. 명령형 언어에서 표현식은 평가되고 결과는 메모리 장소 - 프로그램에서 변수로 표시된다 - 에 저장된다. 메모리 셀에 대한 이런 필연적인 관심은 상대적으로 저급 프로그래밍 방법론에 귀착된다. 어셈블리 언어 프로그램은 또한 가끔 표현식의 부분 평가의 결과를 저장해야 한다. 예를 들면, 다음 식을 평가하기 위해
(x + y) / (a - b)
(x + y) 의 값을 먼저 계산된다. 그런 후 그 값은 (a - b) 가 평가되는 동안 저장되어야 한다. 이 문제를 완화하기 위하여, 컴파일러는 고급언어에 있는 표현식 평가의 중간 결과의 기억장소를 처리한다. 중간 결과의 기억장소는 요구되지만, 세부사항은 프로그래머에게 은폐된다.
순수 함수 프로그래밍 언어는 변수나 배정문을 사용하지 않는다. 이것은 프로그램이 실행되는 컴퓨터의 메모리 셀에 대한 염려로부터 프로그래머를 자유롭게 한다. 변수 없이 반복 구문은 불가능하다. 왜냐하면, 반복 구문은 변수로 제어되기 때문이다. 반복은 반복이 아니라 재귀로 수행되어야 한다. 프로그램은 함수 정의와 함수 적용 명세이고, 실행은 함수 적용을 평가하는 것으로 이루어진다. 변수 없이 순수 함수 프로그램의 실행은 연산 의미론과 표기 의미론 의미에서 상태를 갖지 않는다. 함수의 실행은 동일한 매개변수가 주어진다면 항상 동일한 결과를 생산하다. 이것을 참조 투명성 (referential transparency) 이라 한다. 순수 함수 언어의 의미론은 명령형 언어와 명령형 특징을 포함하는 함수 언어의 의미보다 훨씬 간단하다.
함수 언어는 원시 함수 집합, 원시 함수로부터 복잡한 함수를 구성하는 범함수 형태의 집합, 함수 적용 연산, 데이터를 나타내는 구조 등을 제공한다. 이 구조들은 매개변수나 함수에 의해서 계산되는 값을 나타내기 위해서 사용된다. 잘 정의된 함수 언어는 단지 적은 수의 원시 함수만을 요구한다. 함수 언어는 종종 인터프리터로 구현될지라도, 또한 컴파일될 수 있다.
명령형 언어는 일반적으로 함수 프로그래밍을 위한 제한된 지원을 제공한다. 예를 들면, 대부분의 명령형 언어는 어떤 종류의 함수 정의와 실행 장치를 포함한다. 함수 프로그래밍을 하기 위해 명령형 언어를 사용하는 가장 심각한 단점은 명령형 언어의 함수는 반환되는 값의 타입에 대해 제한을 갖는다는 것이다. FORTRAN 과 Pascal 같은 많은 언어에서 단지 스칼라 타입만이 반환될 수 있다. 더욱 더 중요한 것은, 명령형 언어는 함수를 반환할 수 없다는 것이다. 그러한 제한은 제공될 수 있는 범함수 형태의 종류를 제한한다. 명령형 언어의 함수에 다른 심각한 문제는 함수적 부작용 (functional side effect) 의 가능성이다.
많은 함수 프로그래밍 언어가 개발되었다. 가장 오래되고 가장 광범위하게 사용되는 언어는 LISP 이다. LISP 을 통해 함수 언어를 공부하는 것은 FORTRAN 을 통하여 명령형 언어를 공부하는 것과 약간 비슷하다. LISP 이 첫번째 함수 언어이지만, 현재 일부 사람들은 LISP 가 지난 30 년 동안 꾸준히 발전되었을지라도, 그것이 함수 언어의 최근 설계 개념을 나타내지 않는다고 믿는다. 더구나, 처음 버전을 제외하고는, 모든 LISP 파생어는 명령형-스타일 변수, 배정문, 반복문과 같은 명령형 언어 특징을 포함한다 (명령형 언어 변수는 프로그램 실행동안 값이 여러 번 변할 수 있는 메모리 셀을 명명하기 위해 사용된다). 이것과 약간 이상한 형태임에도 불구하고, 원형 LISP 의 후손 언어는 함수 프로그래밍의 기본 개념을 잘 나타내고 있으므로 공부할 가치가 있다.
원형 LISP 에는 단지 두 개 타입의 객체-원자 (atom) 와 리스트 - 가 있다. 그들은 명령형 언어가 타입을 갖는 의미에서 타입이 아니다. 사실상, 원형 LISP 는 타입이 없는 언어다. 식별자 형태를 갖는 원자는 LISP 의 기호이다. 또한 수치 상수도 원자라고 생각된다.
리스트는 리스트 처리에 있어서 필요한 부분이라고 생각되기 때문에 LISP 는 원래 리스트를 데이터 구조로 사용했음을 2 장으로부터 회상하라. 그러나 결국 개발된 것처럼, LISP 는 거의 삽입과 삭제 연산을 요구하지 않는다. 리스트는 소괄호 (parentheses) 안에 원소를 정함으로써 명시한다. 간단한 리스트의 원소는 다음과 같이 원자에 제한된다.
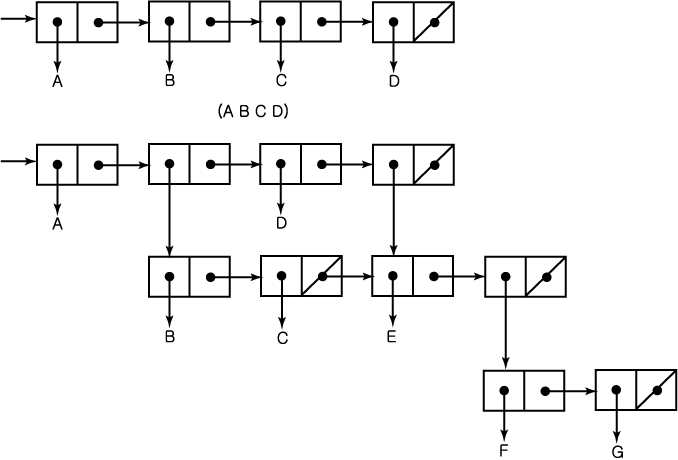
(A B C D)
중복 리스트 구조 또한 괄호로 명시된다. 예를 들면, 리스트
(A (B C) D (E (F G)))
는 4 개의 원소를 갖는 리스트이다. 첫 원소는 원자 A 이고, 두번째 원소는 부리스트 (B C) 이고, 세번째 원소는 원자 D 이고, 네번째 원소는 두번째 원소로 부리스트 (F G) 를 갖는 부리스트 (E (F G)) 이다.
내부적으로, 리스트는 일반적으로 단일-연결 리스트 구조로 저장되며, 이 구조에서 각 노드는 두 개의 포인터를 갖고 한 개의 원소를 나타낸다. 원자를 위한 노드는 원자의 표현 - 기호나 수치 값 - 을 가리키는 첫번째 포인터를 찾는다. 부 리스트 원소를 위한 노드는 그 부리스트의 첫 노드를 가리키는 첫 포인터를 갖는다. 양 경우에, 노드의 두번째 포인터는 첫 노드를 가리키는 첫 포인터를 갖는다. 양 경우에, 노드의 두번째 포인터는 리스트의 다음 원소를 가리킨다. 리스트는 첫 원소를 가리키는 포인터로 참조된다.
두개의 예제 리스트의 내부 표현은 그림 1 에서 보여진다. 리스트의 원소는 수평으로 보여지고 있음에 유의하라. 리스트의 마지막 원소는 후행자가 없다. 따라서 그 링크는 NIL 이다. 부리스트는 동일한 구조로 보여진다.
그림 1 두 LISP 리스트의 내부 표현
원래의 의도는 가능한 한 FORTRAN 에 가까운 (필요할 때는 추가하여) LISP 프로그램을 위한 기호를 갖는 것이었다. 이 기호를 M-기호 (M-notation) - 메타 기호 (meta-notation) 의 약자 - 라고 부른다. M-기호로 작성된 프로그램을 의미적으로 같은 IBM 704 를 위한 기계 코드 프로그램으로 변환하는 컴파일러가 있었다.
LISP 개발 초기에 McCarthy 는 일반적인 기호 처리에 접근 방법으로 리스트 처리를 증진시키는 논문을 쓰기로 결정했다. McCarthy 는 리스트 처리는 그 당시에 Turing 기계를 사용하여 일반적으로 연구되었던 계산이론을 연구하는 데 사용할 수 있다고 믿었다. McCarthy 는 기호 리스트의 처리가 Turing 기계보다 더 자연스러운 계산 모델이라고 생각했다. 계산 이론 연구의 일반적 요구 중에 하나는 사용되는 계산 모델의 집합의 어떤 계산 특성을 증명할 수 있어야 한다는 것이다. Turing 기계 모델인 경우, 다른 Turing 기계의 연산을 모방할 수 있는 범용 Turing 기계를 구성할 수 있다. 이 개념으로부터 LISP 의 다른 함수를 평가할 수 있는 범용 LISP 함수를 구성한다는 개념이 나왔다.
범용 LISP 함수의 첫 요구는 데이터가 표현되는 동일한 방법으로 함수가 표현될 수 있는 기호이다. (1) 절에서 서술한 괄호속에 포함된 리스트 기호는 이미 LISP 데이터 표현으로 채택되었다. 따라서, 리스트 기호로 표현될 수 있는 함수 정의와 함수 호출을 위한 규칙을 고안하기로 결정했다. 함수 호출은 다음과 같이 Cambridge Polish 라 불리는 전위 리스트 형태로 명시되었다.
(함수_이름 인자_1 ... 인자_n)
예를 들면, + 가 두 개의 수치 매개변수를 취하는 함수라면,
(+ 5 7)
은 12 로 평가된다.
(1) 절에서 서술된 람다 기호는 함수 정의를 명시하기 위해 선택되었다. 그러나 함수가 다른 함수와 자기 자신에 의해서 참조되도록 이름에 함수의 바인딩을 허용하도록 수정되어야 했다. 이런 이름 결합은 다음과 같이 함수 이름과 람다 표현식을 포함하는 리스트로 구성된 리스트에 의해서 명시되었다.
(함수_이름 (LAMBDA (인자_1 ... 인자_n) 표현식)
함수 프로그래밍에 대한 사전 지식이 없다면, 이름 없는 함수를 생각하는 것이 이상하게 보일는지 모른다. 그러나 이름 없는 함수는 때때로 함수 프로그래밍 (수학에서처럼) 에서 유용하다. 예를 들면, 매개변수 리스트에 즉시 적용하는 함수를 생산하는 함수를 생각하자. 생산된 함수는 생산된 시점에서만 적용되기 때문에 이름을 가질 필요가 없다. 그러한 예제는 5.6 절에 주어진다.
이 새로운 기호로 표시된 LISP 함수는 S-표현식 (S-expression) - 기호 표현식 (symbolic expression) 의 약자 - 이라 불린다. 마침내, 모든 LISP 구조 (데이터와 코드) 는 S-표현식이라 불린다. S-표현식은 리스트나 원자이다. 종종 S-표현식을 단순히 표현식이라고 언급한다.
McCarthy 는 다른 함수를 평가할 수 있는 범용 함수를 성공적으로 개발했다. 이 함수를 EVAL 이라고 명명하였고 그 자체도 표현식 형태이다. AI 프로젝트에 참여한 사람 중 두 명 - Stephen B. Russel 과 Daniel J. Edwards - 은 EVAL 의 구현은 LISP 의 인터프리터로 사용할 수 있다는 것을 인식했고, 그들은 즉각 그러한 구현을 구성했다 (McCarthy et al., 1965)
이 즉각적이고, 쉽고, 예상치 않던 구현이 몇 개의 중요한 결과를 가져왔다. 첫째, 모든 초기 LISP 시스템은 EVAL 을 복사했고, 그러므로 인터프리터이다. 둘째, LISP 의 계획된 프로그래밍 기호인 M-기호의 정의는 완성되지도 구현되지도 않았다. 따라서, S-기호가 LISP 의 단 하나의 기호가 되었다. 데이터와 코드에 동일한 기호의 사용은 5.7 절에서 논의할 중요한 결과를 갖는다. 셋째, 조건 표현식과 널 (null) 주소와 논리 값 거짓에 영 (zero) 의 사용과 같은 이상한 특징을 언어에 유지하면서 원본 언어 설계의 많은 부분이 효과적으로 동결되었다.
분명히 우연이었던 초기 LISP 시스템의 다른 특징은 동적 영역의 사용이다. 함수는 호출환경에서 평가된다. 그 당시 아무도 영역에 관해서 많이 알지 못했고, 많은 사고가 영역 규칙 선택에 주어진다는 것에 회의적이었다. 동적 영역 규칙은 1975 년 전까지 LISP 의 대부분의 파생어에서 사용되었다. 현대 파생어는 정적 영역 규칙을 사용하거나 프로그래머에게 정적 영역 규칙과 동적 영역 규칙에서 선택하도록 허용한다.
이 절에서, Scheme 의 일부를 서술한다 (Dybvig, 1996). Scheme 은 상대적으로 간단하고, 대학에서 인기가 있고, Scheme 인터프리터는 다양한 컴퓨터에서 사용가능하기 때문에 여기서 선택되었다. 이 절에서 서술된 Scheme 은 Scheme 4 이다.
LISP 의 파생어인 Scheme 언어는 1970 년대 중반에 MIT 에서 발표되었다 (Sussman and Steele, 1975). Scheme 은 작은 크기, 정적 영역 규칙의 독점적 사용, 일등급 개체로 함수의 취급등에 의해서 특성화된다. 일등급 개체로서, Scheme 함수는 표현식의 값과 리스트의 원소가 될 수 있고, 변수에 배정될 수 있고, 매개변수로 전달될 수 있다. LISP 의 초기 버전은 이런 능력을 제공하지 않았다.
간단한 구문과 의미론을 가진 작은 언어로서 Scheme 은 함수 프로그래밍과 일반 프로그래밍 개론과 같은 교육적 응용에 매우 적합하다.
Scheme 으로 작성된 다음절의 대부분의 함수는 LISP 함수로 만들기 위해 약간의 변경을 요구한다는 것에 유의하라.
Scheme 에서 이름은 문자, 숫자, 괄호를 제외한 특수 문자로 구성된다. 이름은 대소 구별이 없지만 숫자로 시작해서는 안된다.
Scheme 인터프리터는 read-evaluate-write 무한 루프이다. 그것은 반복적으로 사용자가 작성한 표현식 (리스트 형태) 을 읽고, 표현식을 해석하고, 결과 값을 디스플레이한다. 리터럴은 리터럴로 평가된다. 따라서 인터프리터에 숫자를 치면, 단순히 숫자를 디스플레이한다. 원시 함수에 대한 호출인 표현식은 다음 방식으로 평가된다. 첫째, 각 매개변수 표현식은 특별한 순서 없이 평가된다. 그런 후, 원시 함수는 그 매개변수 값에 적용되고, 결과 값이 디스플레이된다.
Scheme 은 기본 산술 연산을 위한 원시함수를 포함한다. 이 원시함수들은 덧셈, 뺄셈, 곱셈, 나눗셈을 위한 +, -, *, / 이다. * 와 + 는 0 또는 그 이상의 매개변수를 갖는다. * 에 매개변수가 주어지지 않는다면, 1 이 반환된다. + 에 매개변수가 주어지지 않는다면, 0 이 변환된다. + 는 모든 매개변수를 함께 더한다. * 는 모든 매개변수를 함께 곱한다. / 와 - 는 두 개 또는 그 이상의 매개변수를 갖는다. 뺄셈인 경우에, 첫 매개변수를 제외한 모든 매개변수는 첫 매개변수에서 뺀다. 나눗셈도 뺄셈과 유사하다. 예제는 다음과 같다.
|
표현식 42 (* 3 7) (+ 5 7 8) (- 5 6) (- 15 7 2) (- 24 (* 4 3)) |
값 42 21 20 -1 6 12 |
매개변수 값이 음수가 아니라면, SQST 는 수치 매개변수의 제곱근을 반환한다.
서술할 다음 Scheme 원시함수는 Scheme 함수 적용 연산의 본질에 의해서 요구되는 유틸리티 함수 EVAL 이다. EVAL 은 Scheme 의 모든 함수 평가 - 원시함수이든 아니든 간에 - 의 기본이다. 그것은 Scheme 인터프리터의 read-evaluate-write 동작의 evaluate 부분을 처리하기 위해 호출된다. 원시함수에 적용됐을 때, EVAL 은 먼저 주어진 함수의 매개변수를 평가한다. 이 동작은 함수 호출의 실 매개변수가 함수 호출일 때 (자주 있는 경우임), 필요하다. 그러나 어떤 호출에서는, 매개변수가 함수 참조가 아닌 데이터 원소 - 원자나 리스트 - 이다. 매개변수가 함수 참조가 아닐 때는 분명히 평가되어서는 안된다.
예를 들면, 두 개의 매개변수 (원자와 리스트) 을 갖고 주어진 원자가 주어진 리스트의 원소인지를 결정하는 것이 목적인 함수가 있다고 가정하자. 원자나 리스트는 평가되어서는 안된다. 그들은 조사될 리터럴 데이터이다. 매개변수 평가를 피하기 위해, 원시함수 QUOTE (변화없이 단순히 매개변수를 반환함) 에 매개변수로 먼저 주어진다. 다음 예는 QUOTE 를 설명한다.
(QUOTE A) 는 A
를 반환한다.
(QUOTE (A B C)) 는 (A B C) 를 반환한다.
이 장의 나머지에서는 QUOTE 호출의 일반적 약어를 사용한다. 이것은 단순히 인용되는 표현식 앞에 따옴표 (') 를 선행시킴으로서 수행된다. 그러므로, (QUOTE (A B)) 대신에 '(A B) 를 사용한다.
컴퓨터 프로그램은 언어가 명령형이든 함수형이든 관계없이 데이터를 다룬다. 리스트는 Scheme 의 기본 데이터 구조이므로 Scheme 은 리스트를 조작하는 원시함수를 포함해야 한다. 특히, 리스트의 일부를 선택하는 연산 (어떤 의미에서 리스트를 분해하는) 과 적어도 한 개의 리스트를 구성하는 연산을 제공해야 한다. 함수 언어의 주요 연산은 함수로 제공되기 때문에, Scheme 은 이 연산들을 위한 원시함수를 포함한다.
Scheme 에는 두 개의 기본적인 리스트 선택자 - CAR 과 CDR ("could-er" 커더라 발음함) - 가 있다. CAR 함수는 주어진 리스트의 첫 원소를 반환한다. 다음 예제는 CAR 를 설명한다.
(CAR '(A B
C)) 는 A 를 반환한다.
(CAR '((A B) C D)) 는 (A B) 를 반환한다.
(CAR
'A) 는 오류다 (A 는 리스트가 아님).
(CAR '()) 는 오류다.
CDR 함수는 CAR 가 제거된 후 리스트의 나머지를 반환한다.
(CDR '(A B
C)) 는 (B C) 를 반환한다.
(CDR '((A B) C D)) 는 (C D) 를 반환한다.
(CDR
'A) 는 오류다.
(CDR '(A)) 는 () 를 반환한다.
CAR 과 CDR 함수의 이름은 특이하다. 이 이름의 기원은 IBM 704 에서 구현된 LISP 의 첫번재 구현에 기인한다. 704 의 메모리 워드는 여러 피연산자 주소에 사용되었던 감소 (decrement) 와 주소 (address) 라는 두 필드를 갖는다. 각 필드는 기계 메모리 주소를 저장할 수 있었다. 또한 704 는 관련 필드를 추출하는 CAR (주소 레지스터의 내용-contents of address register) 라는 두 기계 명령어를 포함했다. 메모리 워드가 한 노드를 산뜻하게 저장할 수 있도록 리스트 노드의 두 포인터를 저장하기 위해 두 필드를 사용하는 것은 자연스럽다. 이 규칙을 사용하여, CAR 과 CDR 명령어는 효율적인 리스트 선택자를 제공했다. 이 이름은 모든 LISP 파생어의 원시함수로 이어졌다.
CONS 는 기본 리스트 구성자다. 두 개의 인자 - 첫째 인자는 원자나 리스트, 두번째 인자는 항상 리스트 - 로부터 리스트를 구성한다. 이 연산자의 동작은 첫 매개변수를 두번째 매개변수의 새로운 CAR 로 삽입하는 것이다. 다음 예제를 생각하자.
(CONS 'A '())
는 (A) 를 반환한다.
(CONS 'A '(B C)) 는 (A B C) 를 반환한다.
(CONS
'() '(A B)) 는 (() A B) 를 반환한다.
(CONS '(A B) '(C D)) 는 ((A B) C
D) 를 반환한다.
이 CONS 연산들의 결과는 그림 2 에 보여진다. 어떤 의미에서 CONS 는 CAR 와 CDR 의 연산이다는 것에 유의하라. CAR 과 CDR 는 리스트를 분리하고 CONS 는 주어진 리스트 부분으로부터 새 리스트를 구성한다. CONS 의 두 매개변수는 새 리스트의 CAR 과 CDR 가 된다. 그러므로, lis 가 리스트이면,
(CONS (CAR lis) (CDR lis))
는 항등 함수이다.
LIST 는 여러 개의 매개변수로부터 리스트를 구성하는 함수다. 그것은 다음에서 서술된 것처럼 중첩 CONS 함수의 축약형이다.
(LIST 'apple 'orange 'grape)
는 다음과 동등하다.
(CONS 'apple (CONS 'orange (CONS 'grape '() )))
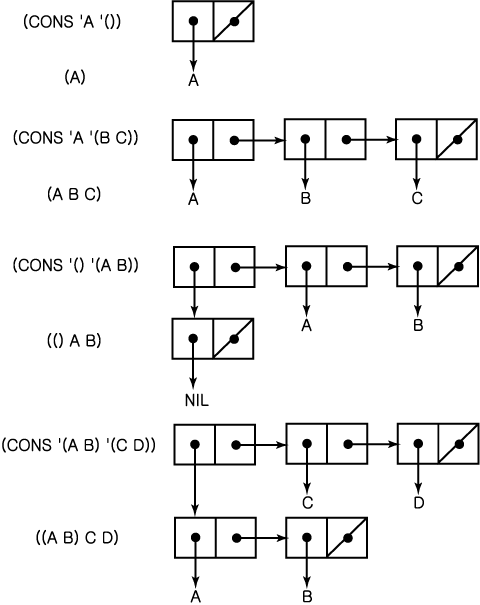
그림 2 여러 CONS 연산의 결과
Scheme 원시함수 중 3 개의 중요한 술어 함수는 EQ?, NULL?, LIST? 이다. 모든 미리 정의된 술어함수는 물음표로 끝나는 이름을 갖음에 유의하라. 술어 함수는 불리안 값 (참 또는 거짓) 을 반환한다. Scheme 에서 두 개의 불리안 값은 #T 와 #F 이다. Scheme 인터프리터는 #F 대신에 공 (empty) 리스트 () 를 반환한다. 술어함수가 반환한 공이 아닌 리스트는 #T 로 해석된다.
EQ? 함수는 두 개의 기호 매개변수를 갖는다. 두 매개변수가 원자이고 같은 #T 를 반환한다. 그렇지 않으면, () 를 반환한다. 다음 예제를 생각하자.
(EQ? 'A 'A) 는 #T 를 반환한다.
(EQ? 'A 'B) 는 () 를 반환한다.
(EQ? 'A '(A B)) 는 () 를 반환한다.
(EQ? '(A B) '(A B)) 는 () 또는 #T 를 반환한다.
마지막 경우처럼, EQ? 로 리스트를 비교하는 결과는 구현 종속적 - 어떤 것은 #T 를 어떤 것은 () 를 반환함 - 이다. 이 차이의 이유는 EQ? 가끔 포인터 비교 (두개의 주어진 포인터는 같은 장소를 가리키는가?) 로 구현되고 정확히 같은 두 개 리스트는 가끔 메모리에 복제되지 않는다. Scheme 시스템이 리스트를 생성할 때, 그러한 리스트가 이미 존재하는가를 조사한다. 존재한다면, 새 리스트는 기존 리스트에 대한 새로운 포인터이다. 이 경우, 두 리스트는 EQ? 에 의해서 같은 것으로 판정된다. 그러나 어떤 경우에서는 동일한 리스트의 존재를 탐지하는 것이 어렵다. 그 경우 새 리스트가 생성된다. 이 상황에서는 EQ? 는 () 를 산출한다.
EQ? 는 기호 원자에 대해서 동작하지만 수치 원자에는 반드시 동작하지 않는다는 것에 유의하라. 수치 원자를 비교하는 술어는 다음과 같다. 위에서 논의한 것처럼, EQ? 리스트 매개변수에도 신뢰할 정도로 잘 동작하지 않는다.
LIST? 술어 함수는, 다음 예제처럼, 단일 인자가 리스트이면 #T 를 반환하고 아니면 () 를 반환한다.
(LIST? '(X Y)) 는 #T 를 반환한다.
(LIST? 'X) 는 () 를 반환한다.
(LIST? '()) 는 #T 를 반환한다.
NULL? 술어 함수는 매개변수가 공 리스트인지를 결정하기 위해 매개변수를 검사하고 공 리스트이면 #T 를 반환한다. 다음 예제를 생각하자.
(NULL? '(A B)) 는 () 를 반환한다.
(NULL? '()) 는 #T 를 반환한다.
(NULL? 'A) 는 () 를 반환한다.
(NULL? '(())) 는 () 를 반환한다.
마지막 경우는 매개변수가 공 리스트가 아니기 때문에 () 이다. 오히려, 단일 원소, 공 리스트를 포함한 리스트이다.
Scheme 은 수치 데이터를 위한 술어 함수 집합을 포함한다. 다음은 그들 중 일부이다.
|
함수 = <> > < >= <= EVEN? ODD? ZERO? |
의미 같다 같지 않다 보다 크다 보다 작다 보다 크거나 같다 보다 작거나 같다 짝수인가? 홀수인가? 영(zero) 인가? |
EQ? 는 기호 원자에는 동작하지만 수치 원자에는 반드시 동작하는 것은 아니다라고 앞에서 언급했다. = 술어 함수는 수치 원자에는 동작하지만 기호 원자에는 반드시 동작하는 것은 아니다.
기호 원자인지 수치 원자인지 알지 못할 때 동등에 대해서 두 원자를 검사할 수 있는 것이 때때로 편리하다. 이런 목적으로, Scheme 은 수치와 기호원자에 동작하는 다른 술어함수 (EQV?) 를 갖는다. 가능할 때 EQV? 대신에 EQ? 나 = 를 사용하는 주 이유는 EQ? 와 = 가 EQV? 보다 빠르다는 것이다.
Scheme 은 다음과 같은 2-3 개의 간단한 출력함수를 갖는다.
(DISPLAY 표현식)
(NEWLINE)
그러나 Scheme 프로그램의 대부분의 출력은 EVAL 을 최상위-레벨 함수에 적용한 결과를 디스플레이하는 인터프리터의 정상적인 출력이다.
Scheme 매개변수는 값으로 전달된다. 따라서 함수가 매개변수에 어떤 연산을 하든 간에 실 매개변수는 영향을 받지 않는다.
앞에서 언급하였듯이, LISP-기초 언어는 함수를 정의하기 위해 리스트 형태로 람다 기호를 사용한다. 예를 들면, 람다식 리스트
((LAMBDA (L) (CAR (CDR L)))
는 주어진 매개변수 (리스트) 의 두번째 원소를 반환하는 함수이다. 이 함수는 유명 (이름이 있는) 함수가 적용되는 방법으로 적용된다. 즉 실 매개변수를 포함하는 리스트의 앞에 함수를 놓음으로서 적용된다. 예를 들면, 다음 함수는 B 를 산출한다.
((LAMBDA (L) (CAR (CDR L))) '(A B C))
람다식의 매개변수로 정의된 Scheme 함수의 실 매개변수는 인용되지 않음에 유의하라. 위 표현식에서 CDR 호출의 매개변수 L 이 그 예이다. L 은 람다식내에서 바인드 변수 (bound variable) 라 불린다. 바인드 변수는 람다식이 평가를 위해 처음으로 호출되었을 때 실 매개변수에 바인딩된 후 표현식에서 변하지 않는다.
특수형 함수 DEFINE 은 Scheme 프로그래밍의 2 가지 기본적인 필요 - 이름을 값에 바인딩과 이름을 표현식에 바인딩 - 에 사용된다. 전자의 사용은 DEFINE 이 명령형 언어 스타일 변수를 만드는 데 사용되는 것처럼 보인다. 그러나 이 이름 바인딩은 변수가 아닌 이름 상수를 만든다.
DEFINE 은, 곧 알게 되겠지만, CAR 나 산술 함수 같은 정상적인 원시함수와는 다른 방식으로 인터프리트되기 때문에 특수형이라고 불리어 진다.
DEFINE 의 가장 간단한 형식은 기호를 표현식의 값에 바인딩하기 위해 사용되는 형식이다. 이 형식은 다음과 같다.
(DEFINE 기호 표현식)
예를 들면, 다음과 같다.
(DEFINE pi 3.14159)
(DEFINE two_pi (* 2 pi))
이 두 표현식을 Scheme 인터프리터에 주어진 후 pi 가 주어지면 3.14159 가 디스플레이될 것이고, two_pi 가 주어지면 6.28318 이 디스플레이될 것이다.
또한 DEFINE 함수는 람다식을 이름에 바인딩시키는데 사용된다. 이 경우, 람다식은 단어 람다를 제거하기 위해 축약된다. 이 형식에서, DEFINE 은 매개변수로서 두 개의 리스트를 취한다. 첫번째 매개변수는 함수 이름 다음에 형식 매개변수 (모두 리스트에 있음) 를 갖는 함수 호출의 프로토타입이고, 두번째 매개변수 (리스트) 는 이름이 바인딩되는 표현식이다. 이 DEFINE 의 일반적인 형식은 다음과 같다.
(DEFINE (함수_이름
매개변수)
몸체
)
여기서 매개변수는 콤마 (comma) 가 아닌 공백 (spaces) 으로 분리되고 몸체는 리스트 형태의 표현식들의 순서열이다.
DEFINE 에 대한 호출 예제는 이름 square 를 이름 다음에 있는 표현식과 바인딩한다.
(DEFINE (square number) (* number number)
일단 인터프리터가 이 함수를 평가한다면, 이것은 다음과 같이 사용될 것이다. 이 함수의 평가 결과로 25 를 디스플레이 할 것이다.
(square 5)
함수를 정의하기 위해 사용되었을 때, 특수형 DEFINE 의 의미는 다음과 같다. 첫 매개변수의 매개변수 부분과 두번째 매개변수 전체는 함께 람다식을 구성하는 것으로 생각된다.
원시함수와 DEFINE 특수형의 차이를 설명하기 위해 다음을 생각하자.
(DEFINE × 10)
만약 DEFINE 이 원시함수라면, 이 표현시에 대한 EVAL 의 첫 동작은 DEFINE 의 두 매개변수를 평가하는 것이다. x 가 이미 어떤 값에 결합되지 않았다면, 이것은 오류이다.
단순함수의 다른 예로서 다음을 생각하자.
(DEFINE (second 1st) (CAR (CDR 1st)))
이 경우, 이름 second 는 다음 람다식에 바인딩된다.
((LAMBDA (1st) (CAR (CDR 1st)))
이 함수가 평가된다면, 다음처럼 사용될 수 있다.
(second '(A B C))
은 B 를 반환한다.
Scheme 의 제어 흐름 동작구조는 수학 함수의 제어 흐름 동작구조를 모방했다. 수학 함수 정의에서 제어흐름은 명령형 프로그래밍 언어로 작성된 프로그램의 제어 흐름과는 매우 다르다. 명령형 언어의 함수는 여러 종류의 순서 제어 흐름을 포함하는 문장의 집합으로 정의되는 반면에 수학함수는 다중문을 가지고 있지 않고 평가 흐름을 위해 단지 재귀 (recursion) 와 조건 표현식을 사용한다. 예를 들면, 계승 함수 (factorial function) 는 다음과 같이 두 개의 연산으로 정의된다.

수학 조건식은 쌍 (보호 표현식) 의 리스트 형태임에 유의하라. 각 보호 표현식 (guarded expression) 은 술어 보호와 표현식으로 구성된다. 그러한 조건식의 값은 참인 술어와 관련된 표현식의 값이다. 술어 중 하나만이 주어진 매개변수 또는 매개변수 리스트에 대해서 참이다.
Scheme 은 두 개의 조건구조 - 2 방향 - 선택과 다중 선택 - 를 갖는다. 이것들은 특수형태이다. 2 방향 - 선택자 (IF) 는 3 개의 매개변수 - 술어, then_표현식, else_표현식 - 를 갖는다. IF 의 호출은 다음과 같다.
(IF 술어 then_표현식 else_표현식)
예를 들면, 다음과 같다.
(DEFINE (factorial
n)
(IF (= N 0)
1
(*
n (factorial (- n 1)))
))
이 함수의 형태가 위에서 주어진 factorial 의 수학적 정의의 형태와 얼마나 가까운지에 유의하라.
Scheme 다중 선택자는 COND 라고 명명된다. COND 는 수학 조건식의 약간 일반화된 형태이다. 그것은 한 개 이상의 술어가 동시에 참인 것을 허용한다. 다른 수학 조건식은 다른 개수의 매개변수를 가지므로, COND 는 고정된 개수의 매개변수를 요구하지 않는다. COND 의 각 매개변수는 첫 표현식이 술어인 표현식의 쌍이다.
COND 의 일반적인 형식은 다음과 같다.
(COND
(술어_1
표현식 {표현식} )
(술어_2 표현식 {표현식} )
...
(술어_n 표현식 {표현식}
)
(ELSE 표현식 {표현식} )
)
어떤 구현에서는 ELSE 는 선택적이다.
COND 의 의미는 다음과 같다. 매개변수의 술어는 처음부터 순서대로 #T 로 평가될 때까지 한 번에 하나씩 평가된다. 그런 후, #T 로 알려진 첫 술어 다음에 오는 표현식이 평가되고 마지막 표현식의 값이 COND 의 값으로 반환된다. 원자 #T 는 COND 에서 상수 술어로 사용될 수 있음에 유의하라. 이 경우, #T 의 표현식은 항상 평가되고 마지막 식의 값이 COND 의 값으로 반환된다. 물론, #T 를 COND 의 마지막 매개변수의 술어로 사용하는 것이 의미가 있다. 특수한 술어상수 ELSE-#T 를 의미함 - 는 항상 이 상황에서 일반적으로 사용된다.
만약 COND 의 매개변수 중 어느 것도 #T 로 평가되는 술어를 갖지 않는다면, COND 는 () 를 반환한다. COND 와 Ada case 문처럼 끝에 "otherwise" 절을 갖는 다중 선택문의 유사성에 유의하라.
이 절은 Scheme 함수 정의의 여러 가지 예제를 포함한다. 이 프로그램은 단순 리스트 처리 문제를 해결한다.
주어진 원자가 주어진 단순 리스트의 원소인가 하는 문제 (소속 문제 - membership problem) 를 생각하자. 단순 리스트는 부리스트를 갖지 않는 리스트이다. 함수가 member 라고 명명되었다면, 그것은 다음과 같이 사용될 수 있다.
(member 'B '(A B C))
는 #T 를 반환한다.
(member 'B '(A C D E)) 는 () 를 반환한다.
반복 관점에서 생각하면, 소속 문제는 주어진 원자와 주어진 리스트의 각 원소를, 부합이 발견될 때까지 또는 비교할 원소가 없을 때까지, 어떤 순서로 한번에 하나씩 단순히 비교하는 것이다. 이 과정은 재귀를 사용하여 성취할 수 있다. 함수는 주어진 원자와 리스트의 CAR 를 비교할 수 있다. 부합하면, 값 #T 가 반환된다. 부합되지 않으면, 원자는 리스트의 나머지에서 발견될 수 있다. 따라서, 함수는 리스트 매개변수로서 리스트의 CDR 를 사용하여 자신을 호출하여 이 재귀 호출의 결과를 반환해야 한다. 이 과정에서, 재귀로부터 두 가지 방식 - 리스트가 어떤 호출에서 공 리스트이고 () 이 반환되거나 부합이 발견되어 #T 가 반환되는 - 이 있다.
모두 합하여, 이 함수에서 처리해야할 3 가지 경우 - 공 입력 리스트, 원자와 리스트의 CAR 와 부합, 원자와 리스트의 CAR 와 불일치 (재귀 호출이 발생함) - 가 있다. 이 3 가지 경우가 정확히 COND 의 3 가지 매개변수이다. 마지막이 ELSE 술어로 구동되는 디폴트 경우이다. 다음은 완전한 함수 정의이다.
(DEFINE (member atm
lis)
(COND
((NULL?
lis) '())
((EQ? atm (CAR
lis)) #T
(ELSE (member atm
(CDR lis)))
))
이 형식은 전형적인 단순한 Scheme 리스트-처리 함수이다. 이 함수에서, 리스트에 있는 데이터는 한번에 한 원소씩 처리된다. 각 원소는 CAR 에 의해서 얻어지고 처리는 리스트의 CDR 에 재귀를 사용하여 계속된다.
공 리스트의 CAR 는 오류이기 때문에 널 검사는 동등 (equality) 검사 전에 이루어짐에 유의하라.
다른 예로서, 두 개의 주어진 리스트가 동등한가를 결정하는 문제를 생각하자. 두 리스트가 단순하다면, 비록 친숙치 못한 기술이 사용될지라도, 해답은 상대적으로 쉽다. 단순 리스트를 비교하는 술어함수는 다음과 같다.
(DEFINE (equalsimp
lis1 lis2)
(COND
((NULL?
lis1) (NULL? lis2))
((NULL?
lis2) '())
((EQ? (CAR lis1)
(CAR lis2))
(equalsimp (CDR lis1) (CDR lis2)))
(ELSE '())
))
COND 의 첫 매개변수에 의해서 다루어지는 첫 경우는 첫 리스트 매개변수가 공 리스트인 경우이다. 첫 리스트 매개변수가 처음부터 공 리스트라면 외부호출에서 발생할 수 있다. 재귀 호출은 매개변수로서 두 매개변수의 CDR 를 사용하기 때문에, 첫 리스트가 이전의 재귀 호출에서 자신의 모든 원소를 제거하게 했다면 이런 호출에서 첫 리스트는 공 리스트가 될 수 있다. 첫 리스트가 공 리스트일 때, 두번째 리스트도 공 리스트인지 검사되어야 한다. 그렇다면, 그들은 갖고 (처음부터 또는 모든 전 재귀 호출에서 CAR 가 같다), NULL? 은 정확히 #T 를 반환한다. 두번째 리스트가 공 리스트가 아니라면, 그것은 첫 리스트보다 크고 NULL? 에 의해서 () 가 반환되어야 한다. 술어함수에 의해서 반환되는 공이 아닌 리스트는 #T 로 해석된다는 것을 회상하라.
다음 경우는 첫 리스트가 공 리스트가 아니고 두번째 리스트가 공 리스트인 경우를 다룬다. 이 상황은 첫 리스트가 둘째 리스트보다 클 때 발생한다. 첫 경우가 첫 리스트가 공 리스트인 모든 경우를 처리하기 때문에 단지 두 번째 리스트만이 검사되어야 한다.
세번째 경우는 두 리스트에서 대응되는 원소의 동등을 검사하는 재귀적 단계이다. 두 개의 공이 아닌 리스트의 CAR 를 비교함으로서 이것을 수행한다. 그들이 같다면, 두 리스트는 이 지점까지 같다. 따라서 재귀는 두 리스트의 CDR 에서 사용된다. 두 개의 같지 않은 원자가 발견될 때 이 경우는 실패한다. 이것이 발생하면, 분명히 계속하기를 원하지 않는다. 따라서 마지막 경우인 디폴트 경우가 실행되어 더 비교없이 함수 값은 () 이 된다.
equalsimp 는 매개변수로 리스트를 기대하고 한 개 혹은 두 매개변수가 원자이면 정확하게 동작하지 않음에 유의하라.
일반 리스트를 비교하는 문제는, 부리스트가 비교 과정에서 완전히 추적되어야 하기 때문에, 이것 보다 약간 더 복잡하다. 부리스트의 형태가 주어진 리스트의 형태와 동일하기 때문에, 이것이 재귀의 능력이 다시 없이 적당한 상황이다. 두 개의 주어진 리스트의 대응하는 원소가 리스트일 때, 그들은 두 부분 - CAR 과 CDR - 으로 분리되어 각각에 재귀가 사용된다. 이것은 분할-정복 (divide-and-conquer) 접근 방법이 유용한 완벽한 예이다. 두 개의 주어진 리스트의 대응하는 원소가 원자라면, 그들은 단순히 EQ? 를 사용하여 비교할 수 있다.
다음은 완전한 함수의 정의이다.
(DEFINE (equal lis1
lis2)
(COND
((NOT
(LIST? lis1)) (EQ? lis1 lis2))
((NOT
(LIST? lis2)) '())
((NULL? lis1)
(NULL? lis2))
((NULL? lis2)) '())
((equal (CAR lis1) (CAR lis2))
(equal (CDR
lis1) (CDR lis2)))
(ELSE '())
))
COND 의 처음 두 경우는 매개변수 중 하나가 리스트 대신 원자인 상황을 처리한다. 세번째와 네번째 경우는 한 개 또는 두 개의 리스트가 공 리스트인 경우이다. 또한 이 경우는 부속된 경우가 공 리스트의 CAR 를 취하는 것을 막는다. 다섯째 COND 경우는 매우 흥미롭다. 술어는 매개변수로서 리스트의 CAR 을 갖는 재귀 호출이다. 이 호출이 #T 를 반환하면, 재귀는 다시 리스트의 CDR 에 사용된다. 이것은 두 리스트가 임의의 깊이의 부 리스트를 포함하는 것을 허용한다.
equal 의 이 정의는 리스트가 아닌 표현식의 쌍에서 동작한다. equal 은 시스템 술어함수 EQUAL? 와 동일하다. EQUAL? 은 EQ? 와 EQV? 보다 훨씬 느리기 때문에 필요할 때 (실 매개변수의 형태가 알려지지 않을 때) 만 사용되어야 함에 유의하라.
다른 일반적으로 필요한 리스트 연산은 두개의 주어진 리스트 인자의 모든 원소를 포함하는 새 리스트를 구성하는 연산이다. 이것은 일반적으로 append 라는 Scheme 함수로 구현된다. 이것은 첫 리스트 인자의 원소를 두번째 리스트 인자에 놓기 위해 CONS 를 반복적으로 사용함으로써 구성될 수 있다. append 의 동작을 명확하게 하기 위해 다음 예제를 생각하자.
(append '(A B) '(C D)) 는 (A B C D) 를 반환한다.
(append '((A B) C) '(D (E F))) 는 ((A B) C D (E F)) 를 반환한다.
append 의 정의는 다음과 같다.
(DEFINE (append lis1
lis2)
(COND
((NULL?
lis1) lis2)
(ELSE (CONS (CAR lis1)
(append (CDR lis1) lis2)))
))
이 절에서 서술한 member 함수를 사용하는 quess 라 명명된 다음 Scheme 함수를 생각하자. 아래에 있는 설명을 읽기 전에 그것이 무엇을 하는지를 결정하도록 시도하라. 매개변수는 단순 리스트라고 가정하라.
(DEFINE (guess lis1
lis2)
(COND
((NULL?
lis1) '())
((member (CAR lis1)
lis2)
(CONS
(CAR lis1) (quess (CDR lis1) lis2)))
(ELSE
(quess (CDR lis1) lis2)
))
quess 의 두 매개변수는 단순 리스트라고 가정한다. quess 는 두 매개변수 리스트의 공통 원소를 포함하는 단순 리스트를 산출한다. 따라서, 매개변수 리스트가 집합이라면, quess 는 두 집합의 교집합을 나타내는 리스트를 계산한다.
LET 는 이름이 임시로 부 표현식의 값에 바인딩되는 것을 허용하는 함수이다. 그것은 더 복잡한 표현식에 공통 부 표현식을 인수로 분해하기 위해 가끔 사용된다. 그런 후, 이 이름은 다른 표현식의 평가에 사용된다. 일반적인 형식은 다음과 같다.
(LET (
(이름_1
표현식_1)
(이름_2 표현식_2)
...
(이름_n
표현식_n)
몸체
)
LET 의 의미는 처음 n 개의 표현식은 평가되고 결과 값이 관련 이름에 바인딩된다는 것이다. 그런 후, 몸체의 표현식은 평가된다. LET 의 결과는 몸체의 마지막 표현식의 값이다. 다음 예제는 LET 의 사용을 설명한다.
(DEFINE (quadratic_roots
a b c)
(LET (
(root_part_over_2a
(/ (SQRT (-
(* b b) (* 4 a c))) (* 2 a)))
(minus_b_over_2a
(/ (- 0 b) (* 2 a)))
)
(DISPLAY
(+ minus_b_over_2a root_part_over_2a))
(NEWLINE)
(PISPLAY
(- minus_b_over_2a root_part_over_2a))
))
두 개의 결과를 디스플레이하기 위해 DISPLAY 함수를 원하기 때문에 DISPLAY 함수는 quadratic_roots 에서 편리핟.
Ada 의 declare 와 동일한 방법으로 LET 는 새로운 지역 정적 영역을 생성한다. 새 변수가 생성되고, 사용되고, 새 영역의 끝이 도달했을 때 폐기된다. LET 의 명명된 구성요소는 배정문과 비슷하지만, LET 의 새 영역에서만 사용될 수 있다. 더욱이, 그들은 LET 에서 새 값에 재 바인딩될 수 없다.
LET 는 실제로 LAMBDA 표현식의 축약이다. 다음 두 예제는 동일하다.
(LET ((alpha 7)) (*
5 alpha))
((LAMBDA (alpha) (* 5 alpha)) 7)
첫번째 표현식에서, 7 은 LET 로 alpha 에 바인딩된다. 두번째 표현식에서 7 은 LAMBDA 표현식의 매개변수를 통해서 alpha 에 바인딩된다.
이 절은 Scheme 에서 제공되는 두 개의 일반적인 수학 범함수 형태 - 함수 합성과 모든-적용 - 를 서술한다.
① 함수합성
함수합성은 원본 LISP 가 제공한 단 하나의 원시 범함수 형태이다. 또한 Scheme 을 포함한 모든 LISP 파생어는 범함수 형태를 제공한다. 합성 함수는 EVAL 이 동작하는 방법의 본질이다. 모든 비-인용 리스트는 함수 호출로 해석된다. 함수 호출은 매개변수가 먼저 평가되는 것을 요구한다. 이것은 표현식의 가장 적은 리스트에 재귀적으로 적용한다. 이것이 정확히 합성 함수가 의미하는 것이다. 다음 예제는 합성 함수를 설명한다.
(CDR (CDR '(A B C)))
는 (C) 를 반환한다.
(CAR (CAR '((A B) B C))) 는 A 를 반환한다.
(CDR (CAR
'((A B C) D))) 는 (B C) 를 반환한다.
(NULL? (CAR '(() B C))) 는 #T 를 반환한다.
(CONS
(CAR '(A B)) (CDR '(A B))) 는 (A B) 를 반환한다.
내부 호출에서 함수 이름은 리터럴 데이터로서 취급되기보다는 평가되어야하기 때문에 인용되지 않음에 유의하라.
② 모두-적용 범함수 형태
보통 함수 프로그래밍 언어에 제공된 가장 일반적인 범함수 형태는 수학의 모든-적용의 범함수 형태이다. 이것 중 간단한 것은 두 개의 매개변수 - 함수와 리스트 - 를 갖는 mapcar 이다. mapcar 는 주어진 함수를 주어진 리스트의 각 원소에 적용하여 이 적용의 결과의 리스트를 반환한다. mapcar 의 Scheme 정의는 다음과 같다.
(DEFINE (mapcar fun
lis)
(COND
(NULL?
lis) '())
(ELSE (CONS (fun (CAR
lis)) (mapcar fun (CDR lis))))
))
복잡한 범함수 형태를 표현하는 mapcar 의 간단한 형태에 유의하라. 이것은 Scheme 의 대단한 표현력의 증거이다.
mapcar 사용의 예로서, 리스트의 모든 원소를 세 제곱하기를 원한다고 하자. 이것을 다음과 같이 수행할 수 있다.
(mapcar (LAMBDA (num) (* num num num)) '(3 4 2 6))
이 호출은 (27 64 8 216) 을 반환한다.
이 예제에서 mapcar 의 첫 매개변수는 LAMBDA 표현식임에 유의하라. EVAL 이 LAMBDA 표현식을 평가할 때, 이름이 없는 함수를 제외하고 미리-정의한 함수와 같은 형태를 갖는 함수를 구성한다. 위 표현식에서, 이 이름 없는 함수는 즉시 매개변수 리스트의 각 원소에 적용되고 결과는 리스트로 반환된다.
프로그램과 데이터가 동일한 구조를 갖는다는 사실은 프로그램 구성에도 이용될 수 있다. 사용자 프로그램이 함수 EVAL 를 호출할 수 있기 때문에 다른 프로그램을 구성하여 즉시 평가할 수 있다.
이 방법의 가장 간단한 예제 중 하나는 수치 원자를 포함한다. 대부분 Scheme 시스템은, 매개변수로 임의의 개수의 수치 원자를 취하여 그 합을 반환하는 + 라 불리는 수치 원자에 대한 함수를 포함한다. 예를 들면, (+ 3 7 10 2) 는 22 를 반환한다.
프로그램에서 수치 원자의 리스트를 가지고 그 합을 구한다고 가정하자. + 는 수치 원자의 리스트가 아닌 수치 매개변수만을 취할 수 있기 때문에 + 를 직접 리스트에 적용할 수 없다. 물론, 리스트를 조사하기 위해 재귀를 사용하여 리스트의 CAR 를 CDR 의 합에 반복적으로 더하는 함수를 작성할 수 있다. 그러한 함수는 다음과 같다.
(DEFINE (adder lis)
(COND
((NULL?
lis) 0)
(ELSE (+ (CAR lis) (adder
(CDR lis))))
))
이 문제에 대한 다른 해결책은 적당한 매개변수 형태로 + 를 호출하는 함수를 작성하는 것이다. 이것은 원자 + 를 수치 리스트에 삽입하기 위해 CONS 를 사용함으로써 수행된다. 그런 후, 이 새 리스트는 다음과 같이 평가를 위해 EVAL 에 제출한다.
(DEFINE (adder lis)
(COND
((NULL?
lis) 0)
(ELSE (EVAL (CONS '+ lis)))
))
+ 함수 이름은 CONS 평가에서 EVAL 이 + 를 평가하는 것을 막기 위해 인용되었다. 예로서, 호출
(adder '(3 4 6))
은 adder 에게 다음 리스트를 구성하게 한다.
(+ 3 4 6)
그런 후, 리스트는 EVAL 에 제출되며, EVAL 은 + 를 호출하여 결과 13 을 반환한다.
Scheme 의 모든 초기 버전에서, EVAL 함수는 프로그램의 가장 외각 영역에 있는 표현식을 평가한다. Scheme 의 최신 버전 (Scheme 4) 은 표현식이 평가되는 영역을 지정하는 EVAL 의 두번째 매개변수를 요구한다. 간단히 하기 위하여, 예제에서 영역 매개변수는 생략하였고 여기서는 더 이상 논의하지 않는다.
다른 현대 LISP 파생어와 마찬가지로 Scheme 은 명령형 언어로부터 빌린 여러 가지 특징을 포함하고 있다. 예를 들면, 이름은 값에 바인딩되고, 그러한 바인딩은 후에 변경될 수 있다. 이것은 다음과 같이 함수 SET! 를 사용하여 수행된다.
(SET! pi 3.11593)
SET! 함수는 바인딩한 값을 반환한다.
LISP 의 순수 함수형에서 리스트는 변경될 수 없다. 그들은 CAR 과 CDR 로 분리될 수 있지만, 주어진 리스트는 변경될 수 없다. 왜냐하면, 이것은 함수 호출의 명령형 언어 특징 - 부작용 - 을 요구하기 때문이다. Scheme 은 그러한 부작용 (side effect) 를 생성하는 두 개의 함수, SET-CAR! 와 SET-CDR!, 를 포함한다. 다음 예제를 생각하자.
(DEFINE 1st (LIST
'A 'B))
(SET-CAR! 1st 'C)
(SET-CAR! 1st '(D))
SET-CAR! 는 1st 에 바인딩된 리스트를 (A B) 에서 (C B) 로 변경한다.
SET_CDR! 는 리스트 (C B) 를 (C D) 로 변경한다.
위에서 서술한 Scheme 의 명령형 특징은 효율성을 위해 Scheme 에 포함되었지만, 함수 프로그래밍으로부터 이탈은 또한 비용이 든다. 프로그램은 별칭 (aliasing) 의 가능성과 부작용은 동일한 함수가 다른 시간에 다른 결과를 생산하는 것을 허용하기 때문에, 프로그램은 디버그와 유지보수하기가 더욱더 어려워진다. 예를 들어, 다음을 생각하자.
(DEFINE count
0)
(DEFINE (inc_count number)
(SET! count
(+ count number))
)
inc_count 에 대한 아래의 두 호출이 동일할지라도, 다른 결과를 산출한다.
(inc_count 1)
1
(inc_count
1)
2
COMMON LISP (Steele, 1984) 는 Scheme 를 포함하여 LISP 의 1980 년대 초반의 여러 파생어의 특징을 하나의 언어로 결합하기 위한 노력으로 탄생했다. 결합이기 때문에 매우 크고 복잡한 언어이다. 그러나 기반이 원본 LISP 이므로 구문, 원시함수, 기본 성질은 LISP 에서 가져온 것이다.
정적 영역 규칙의 단순성과 동적 영역 규칙의 특별한 유연성을 인정하여. COMMON LISP 는 둘 다 허용한다. 변수의 디폴트 영역 규칙은 정적이지만, 변수를 "special" 로 선언함으로써, 그 변수는 동적 영역 규칙 변수가 된다.
COMMON LISP 의 특징의 목록은 길다 : 레코드, 배열, 복소수, 문자 스트링 등을 포함한 많은 데이터 타입과 구조, 강력한 입출력 연산, 함수와 데이터의 집합을 모듈화하는 패키지, 접근 제어의 제공, Scheme 의 명령형 특징 - 특히 Scheme 의 SET!, SET-CAR!, SET-CDR! 가 수행하는 것을 수행하는 함수 등 - 자체의 특징 등을 가지고 있다.
Scheme 을 제외한 LISP 의 많은 파생어와 함께 COMMON LISP 는 명령형 언어에서 일반적인 문장 순서 제어를 허용하는 PROG 라는 함수를 포함한다. 레이블과 두 함수 - GO 와 RETURN - 반복 제어를 제공하기 위해 포함되었다. GO 는 제어를 PROG 안에 있는 레이블로 옮기는데 사용된다. RETURN 은 PROG 를 끝내는 방법이다. PROG 의 일반적인 형식은 다음과 같다.
(PROG (지역 변수)
표현식_1
. . .
표현식_n
)
지역 변수는 NIL 로 초기화되고, PROG 영역을 갖고, PROG 실행동안만 존재한다. 지역 변수와 같은 전역 변수가 있다면, 그 전역 변수는 PROG 에서 영향을 미치지 못한다 (은폐된다). 원자인 PROG 의 표현식은 레이블로 처리된다. GO 는 제어를 PROG 표현식 리스트 안에 있는 레이블인 매개변수로 전달한다. RETURN 은 PROG 의 값이 되는 매개변수를 갖는다.
PROG 는 LISP 의 옛 파생어와 후향 호환성을 제공하기 위해 LISP 의 현대판에 포함되었음에 유의하라. COMMON LISP 는 PROG 의 능력을 제공하기 위한 더 좋은 구조를 가지고 있다. 예를 들면, COMMON LISP 는 반복을 위한 DOTIMES 와 DOLIST, 순차 구성을 위한 PROG1, PROG2, PROGN 을 갖는다.
SETQ 는 Scheme 의 SET! 에 대응되는 COMMON LISP 함수이고, DEFUN 은 DEFINE 의 COMMON LISP 버전이다. 리스트 소속원소 함수의 다음 반복 버전을 생각하자. 반복 버전 뒤에 5.5 절에 보였던 것과 유사한 재귀형이 주어진다.
(DEFUN iterative_member
(atm 1st)
(PROG ()
loop_1
(COND
((NULL
1st) (RETURN NIL))
((EQUAL
atm (CAR 1st)) (RETURN T))
)
(SETQ
1st (CDR 1st))
(GO loop_1)
))
(DEFUN recursive_member
(atm 1st)
(COND
((NULL
1st) NIL)
(EQUAL atm (CAR
1st)) T)
(T (recursive_member
atm (CDR 1st)))
))
T 는 불리안 값 참의 COMMON LISP 버전이고, NIL 은 불리안 값 거짓이고, ATOM 은 매개변수가 원자인가를 결정하는 술어함수이고, 널 리스트는 리스트와 원자로 간주됨에 유의하라.
다른 예로서, 리스트의 길이를 계산하는 반복과 재귀 함수를 생각하자.
(DEFINE iterative_length
(1st)
(PROG (sum)
(SETQ
sum 0)
again
(COND
((ATOM 1st (RETURN sum)))
)
(SETQ
sum (+ 1 sum))
(SETQ 1st (CDR
1st)
(GO again)
))
(DEFUN recursive_length
(1st)
(COND
((NULL
1st) 0)
(T (+ 1 (recursive_length
(CDR 1st))))
)
)
어떤 의미에서, Scheme 과 COMMON LISP 는 정반대다. Scheme 은 정적 영역 규칙만을 사용하기 때문에 훨씬 작고 더 깔끔하다. COMMON LISP 는 상업업용 언어로 고안되었고 AI 응용에서 광범위하게 사용되는 데 성공한 언어다. 한편, Scheme 은 함수 프로그래밍에 관한 대학 과정에서 자주 사용된다. 또한 Scheme 은 상대적으로 작은 크기 때문에 함수 언어로 연구되고 있다. 매우 큰 언어가 되게 한 COMMON LISP 의 중요한 설계기준은 LISP 의 여러 이전 파생어와 호환성을 갖도록 하는 요구이다.
ML (Milner et al., 1990) 은 Scheme 과 마찬가지로 정적 영역 함수 프로그래밍 언어다. ML 은 여러 중요한 면에서 LISP 와 Scheme 을 포함한 LISP 파생어와는 다르다. ML 은 LISP 보다는 Pascal 에 유사한 구문을 사용한다. ML 은 타입 선언을 갖고, 타입 추론 (변수가 선언될 필요가 없음을 의미함) 을 사용하며, 강타입 언어다. 모든 변수와 표현식의 타입은 컴파일 시간에 결정될 수 있다. 이것이 본질적으로 타입이 없는 Scheme 과 뚜렷한 대조를 이룬다. ML 은 예외 처리와 추상 데이터 타입을 구현하는 모듈 장치를 포함한다. ML 개발의 간단한 역사와 중요한 특징은 2 장에 주어졌다. 4 장은 ML 에서 사용되는 것과 같은 타입 추론의 개념에 대한 소개를 포함하고 있다.
ML 에서, 이름은 다음 형태의 값 선언문으로 값에 바인딩된다.
val 새로운_이름 = 표현식 ;
예를 들면, 다음과 같다.
val distance = time * speed ;
이 문장은 명령형 언어의 배정문과 같지 않기 때문에 이 문장이 명령형 언어의 배정문과 같다는 생각을 갖지 말라. val 문장은 이름을 값에 바인딩하지만, 이름은 후에 새 값에 재바인딩될 수 없다. 글쎄, 어떤 의미에선 가능할 수도 있다. 실제로, 만약 이름에 두번째 val 문장으로 재바인딩한다면, 그 이름의 전 버전과는 관계없는 새 항목이 환경에 생긴다. 실제로, 타입이 같을 필요가 없다. val 문장은 부작용을 갖지 않는다. 단순히 이름을 현재 상황에 첨가하고, LISP 의 LET 처럼, 그것을 값에 바인딩한다. val 은 일반적으로 let 표현식에서 사용되고, 일반적인 형식은 다음과 같다.
let val 새로운_이름 = 표현식_1 in 표현식_2 end
예를 들면, 다음과 같다.
let
val
pi = 3.14159
in
pi * radius * radius
end ;
ML 은 리스트와 리스트 연산을 갖는다. 하지만 외형은 LISP 의 외형과 같지 않다. 또한 ML 은 열거형 타입, 배열, 레코드인 튜플 (tuple) 을 갖는다.
ML 에서 함수선언은 다음과 같다.
fun 함수_이름 (형식_매개변수) = 함수_몸체_표현식 ;
예를 들면, 다음과 같다.
fun square (x : int) = x * x ;
x 의 타입이 컴파일러에 의해서 결정될 수 없기 때문에, 다음 함수 정의는 허용되지 않는다.
fun square (x) = x * x ;
그래서 산술 연산자를 사용하는 함수는 다형 함수가 될 수 없다. =, <>, 불리안 연산자를 제외한 관계 연산자를 사용하는 함수도 마찬가지다. 그러나 리스트 연산, =, <>, 튜플 연산자 (튜플을 구성하는 연산자와 구성 원소를 선택하는 연산자) 를 사용하는 함수는 다형 함수가 될 수 있다.
ML 선택 제어 흐름 구조는 실제로 다음 형식을 갖는 조건 표현식이다.
if E then then_표현식 else else_표현식
E 는 불리안으로 평가되어야 한다. 단지 두 개의 표현식 중 하나만 평가된다. ML 에는 강제 타입 변환 (type coercion) 은 없다.
연산자나 배정문의 피연산자의 타입은 구문 오류를 피하기 위해 단순히 일치되어야 한다.
Haskell (Thompson, 1996) 은 유사한 구문을 사용하고, 정적 영역 규칙이고, 강타입이고, 동일한 타입 추론 방법을 사용한다는 면에서 ML 과 유사하다. Haskell 은 순수 함수형이라는 면 - 부작용과 배정문이 없음 - 에서는 ML 과 다르다. 실제로, 부작용을 허용하지 않고 어떠한 종류의 명령형 언어 특징도 포함하지 않는다. 이것이 Haskell 를 거의 모든 다른 프로그래밍 언어와 분리시킨다. 두 개의 다른 특성이 Haskell 과 ML 를 분리한다. 첫째, Haskell 은 지연 평가 (lazy evaluation) - 부 표현식은 그 값이 요구될 때까지 평가되지 않는다 - 라는 다른 평가 기술을 사용한다. 둘째, Haskell 은 무한 리스트를 허용하는 리스트를 정의하는 방법을 가지고 있다. 이것을 리스트 함축 (list comprehension) 이라고 부른다. Haskell 의 다른 몇 개의 특징은 Miranda 언어에 기원을 두고 있다 (Turner, 1996).
이 절의 코드는 Haskell 의 1.4 버전으로 작성되었다.
계승 함수의 다음 정의를 생각해 보자. 함수 정의와 함수 적용의 구문은 함수 이름을 단순히 매개변수 옆에 작성됨에 유의하라.
fact 0 = 1
fact n = n * fact (n - 1)
이 정의는 함수 정의가 한 줄 이상을 포함할 수 있음을 보여준다. 여기서 줄은 다른 형태의 실 매개변수를 형식 매개변수에 패턴 매칭함으로써 선택된다. 상수인 형식 매개변수는 분명히 실 매개변수에서 자체에 부합된다. 형식 매개변수의 이름은 상수 패턴에서 부합되지 않은 실 매개변수에 부합된다. 그런 후, 부합된 실 매개변수 값은 우변 표현식에서 이름의 값으로 사용된다. 위에서 정의된 함수-음수 매개변수에는 값을 정의할 수 없기 때문에 - 는 부분함수이다.
패턴 매칭을 사용하여, 다음과 같이 n 번째 피보나치 수를 계산하는 함수를 정의할 수 있다.
fib 0 = 1
fib
1 = 1
fib (n + 2) = fib (n + 1) + fib n
보호 (guard) 는 함수 정의가 적용되는 상황을 지정하기 위해 함수 정의에 첨가할 수 있다. 예를 들면, 다음과 같다.
fact n
|
n == 0 = 1
| n > 0 = n * fact (n - 1)
이 정의는, 실 매개변수의 범위를 계승함수가 동작하는 범위로 제한하기 때문에, 앞의 정의보다 더 상세한 계승함수의 정의이다. 물론, 매개변수 패턴이 둘다 n 이기 때문에, 패턴 매칭은 여기에서 실패한다. 이 형태의 함수정의를 조건 표현식이라 한다.
otherwise 는 조건 표현식에서 마지막 조건으로 나타날 수 있다. 예를 들면, 다음과 같다.
fun n
|
n < 100 = 0
| n > 100 = 2
|
otherwise = 1
리스트는 다음과 같이 각괄호 (bracket) 로 작성된다.
colors = ["blue", "green", "red", "yellow"]
Haskell 은 리스트 연산자의 집합을 포함한다. 예를 들면, 리스트는 ++ 로 접합할 수 있고, : 는 CONS 의 중위 연산자로 사용되며, .. 는 산술 급수 (arithmetic series) 로 사용된다. 예를 들면, 다음과 같다.
5 : [2, 7, 9]
는 [5, 2, 7, 9] 가 된다.
[1, 3..11] 는 [1, 3, 5, 7, 9, 11] 이 된다.
[1,
3, 5] ++ [2, 4, 6] 는 [1, 3, 5, 2, 4, 6] 이 된다.
리스트에 연산하는 함수의 두 예제는 다음과 같다.
sum [] = 0
sum
(a : x) = a + sum x
product [] = 1
product
(a : x) = a * product x
두 예제에서, a : x 는 CAR (헤드) 로서 a 를 CDR (테일) 로서 x 를 갖는 리스트를 지정한다. sum 은 주어진 리스트의 원소의 합을 변환한다. product 는 주어진 리스트의 원소의 곱을 반환한다. sum 과 product 는 표준 Haskell 함수이다. product 를 사용하여, 계승함수는 다음 간단한 형식으로 작성될 수 있다.
fact n = product [1..n]
length 함수는 주어진 리스트의 원소의 개수를 반환한다. 예를 들면,
length (colors) 는 4 를 반환한다.
Haskell 에서 where 절은 바인딩이 표현식 뒤에 사용된다는 것만 제외하고는 ML 의 let 의 val 과 유사하다. 예를 들면, 다음과 같이 작성할 수 있다.
quadratic_root
a b c =
[minus_b_over_2a - root_part_over_2a,
minus_b_over_2a
+ root_part_over_2a]
where
minus_b_over_2a
= - b / (2.0 * a)
root_part_over_2a
= sqrt (b ^ 2 - 4.0 * a * c) / (2.0 * a)
리스트 함축은 집합을 나타내는 리스트를 서술하는 방법을 제공한다. 리스트 함축의 구문은 수학에서 집합을 서술하기 위해 가끔 사용하는 구문과 같다. 일반적인 형식은 다음과 같다.
[몸체 | 한정사]
예를 들면, [n * n * n | n <-- [1..50]]
은 1 에서 50 까지 정수의 3 제곱의 리스트를 정의한다. 이것은 "n 이 정수 1 에서 50 까지 취할 때 모든 n * n * n 의 리스트" 로 읽는다. 이 경우 한정사는 생성자 (generator) 형태이다. 그것은 1 에서 50 까지의 수를 생성한다. 다른 경우에, 한정사의 형태는 불리안 식 - 이것은 테스트 (test) 라고 불린다 - 이다. 이 기호는 리스트의 치환을 찾거나 리스트를 정렬과 같은 많은 일을 하는 알고리즘을 서술하는 데 사용된다. 예를 들면, 수 n 이 주어졌을 때, n 의 모든 약수의 리스트를 반환하는 다음 함수를 생각하자.
factors n = [i | i ← [1..n div 2], n mod i == 0]
다음, quicksort 알고리즘의 아래 구현에서 보여진 Haskell 의 간결함을 보라.
sort [] = []
sort
(a : x) = sort [b | b ← x, b <= a]
++ [a] ++
sort [b | b ← x, b > a]
quicsort 의 이 정의는 명령형 언어로 작성된 같은 알고리즘보다 상당히 짧다.
이제 지연 평가 주제로 돌아가자. Scheme 에서 함수의 매개변수는 함수가 호출되기 전에 충분히 평가되어야 한다는 것을 회상하라. 지연 평가는 함수의 매개변수는 함수를 평가하는 데 필요할 때만 평가되어야 한다는 것을 의미한다. 따라서 함수가 두 개의 매개변수를 가지지만, 함수의 특수한 평가에서 첫 매개변수가 사용되지 않는다면, 그 실행에 전달된 첫번째 실 매개변수는 평가되지 않는다. 더욱이, 실 매개변수의 일부만이 함수 실행에 평가되어야 한다면, 나머지는 평가되지 않은 채 남는다. 마지막으로, 실 매개변수는, 평가한다면, 꼭 한번만 평가한다.
언어가 지연 평가를 사용한다는 사실은 몇 개의 재미있는 가능성을 제시한다. 이것 중에 하나가 무한 데이터 구조를 정의하는 것이다. 예를 들어, 다음을 생각하자.
positives = [0..]
evens
= [2, 4..]
squares = [n * n | n ← [0..]]
물론, 어떤 컴퓨터도 실제적으로는 이 리스트의 모든 원소를 나타낼 수 없지만, 지연 평가가 사용된다면 그들의 사용을 막지는 않는다. 예를 들면, 어떤 수가 완전 제곱수인지를 알고자 한다면, 소속 원소 함수로 squares 리스트를 검사할 수 있다. 주어진 리스트가 주어진 원소를 포함하는지를 결정하는 member 라는 술어 함수가 있다고 가정하자. 그러면 그것을 다음과 같이 사용할 수 있다.
member squares 16
은 True 를 반환한다. squares 정의는 16 이 발견될 때 평가될 것이다. member 함수는 주의 깊게 작성되는 것이 필요하다. 특히, 그것이 다음과 같다면,
member [] b =
False
member (a : x) b = (a == b) || member x b
주어진 수가 완전 제곱수라면 member 는 squares 에서 정확하게 동작할 것이다. 그렇지 않다면, squares 는 영원히 또는, 주어진 수를 리스트에서 찾으면서, 어떤 메모리 한계에 도달할 때까지 squares 를 계속 생성할 것이다. 다음 함수는, 찾고자 하는 수보다 큰 수가 발견될 때에는 탐색을 포기하고 False 를 반환하면서, 순서 리스트에서 소속원소 검사를 수행한다.
member2 (m : x)
n
| m < n = member2 x n
|
m == n = True
| otherwise =
False
지연 평가는 비용이 없는 것은 아니다. 그런 표현력과 유연성이 공짜라면 분명히 놀랄만하다. 이 경우, 비용은 훨씬 느린 실행 속도를 야기하는 매우 복잡한 의미론이다.
고급 프로그래밍 언어 역사상 지난 35 년 이상동안 단지 2 - 3 개의 함수 언어만이 광범위하게 사용되었다. 이것 중에 가장 눈에 띄는 것이 LISP 이다. 배정문을 많이 사용함에도 불구하고, APL 또한 부분적으로 범함수 형태를 사용하기 때문에 가끔 함수 언어로 생각된다.
APL 은 하드웨어 서술에서부터 정보관리 시스템에 이르기까지 다양한 응용을 위해 사용되고 있다. 전형적인 APL 프로그램을 읽는 어려움 때문에 현대 계산학 분야에서 가장 자연스러운 위치는 대충 작성하는 프로그래밍 분야이다. 배열 연산의 강력한 집합으로, APL 은 많은 배열 연산을 포함하는 문제에 빠르지만 정결하지 못한 해답을 위한 훌륭한 도구이다.
LISP 는 융통성 있고 강력한 언어다. 처음 15 년 동안, 사용하는 비용이 많이 드는 이상한 언어로 주로 비사용자에 의해서 생각되었다. 실제로, 1960 년대와 1970 년대 초반에 언어는 두 가지 분류 - LISP 를 포함한 부류와 모든 다른 프로그래밍 언어를 포함한 부류 - 로 생각되는 것이 일반적이었다.
이 장에서 서술한대로, LISP 는 기호 계산과 리스트-처리 응용 (계산학의 AI 분야) 을 위해 개발되었다. AI 응용에서, LISP 와 그 파생어는 아직도 표준 언어이다.
AI 내에서 주로 LISP 를 사용하여 여러 분야가 발달되었다. 다른 종류의 언어 - 주로 논리 프로그래밍 언어 - 가 사용될 수 있을지라도, 대부분의 기존 전문가 시스템은 LISP 로 개발되었다. 또한 LISP 는 지식 표현, 기계 학습, 자연어 처리, 지능 훈련 시스템, 언어 및 시각 모델링 분야에서 압도적이다.
AI 분야 밖에서도, LISP 는 또한 성공적이다. 예를 들면, 기호 계산을 수행하는 기호 수학 시스템, MACSYMA 처럼, EMACS 텍스트 에디터도 LISP 로 작성되었다. LISP 기계는 모든 시스템 소프트웨어가 LISP 로 작성된 개인용 컴퓨터이다. 또한 LISP 는 다양한 응용 분야에서 실험 시스템을 구성하는 데 성공적으로 사용되었다.
Scheme 은 함수 언어를 교육하는 데 광범위하게 사용된다. 또한 Scheme 은 어떤 대학에서는 기초 프로그래밍을 가르치는 데 사용된다. ML 과 Haskell 의 사용은, 대부분, 연구 실험실이나 대학에 제한되었다.
함수 프로그래밍과 함수 프로그래밍 언어의 장점 - 어떤 것은 광범위하게 인정되고 어떤 것은 광범위하게 추측되는 - 의 간단한 논의가 차례로 주어진다.
함수 프로그래밍과 명령형 언어에서의 프로그래밍을 비교하는 것이 자연스럽다. 명령형 언어는 직접 von Neumann 구조를 기초로 하기 때문에, 명령형언어를 사용하는 프로그래머는 변수의 관리와 변수에 값의 배정을 다루어야 한다. 이 결과는 실행 효율성은 증가하지만, 프로그램 구성에는 많은 노력이 든다. 함수 언어에서, 메모리 셀은 언어에 추상화 될 필요가 없기 때문에 프로그래머는 변수를 걱정할 필요가 없다. 이 결과는 실행 효율의 감소이다. 그러나 다른 결과는, 명령형 언어에서의 프로그래밍보다 노동력을 적게 요구하는 고수준의 프로그래밍이다. 많은 사람들은 이것은 사실이고 함수 프로그래밍의 명확한 장점이라고 믿는다.
함수 언어는 매우 간단한 구문 구조를 가질 수 있다. LISP 의 리스트 구조가 그 예이다. 명령형 언어의 구문은 훨씬 복잡하다. 또한 함수 언어의 의미론은 명령형 언어의 의미론과 비교하여 간단하다.
명령형 언어에서 동시성 실행은 설계하기도 어렵고 사용하기도 어렵다. 예를 들면, 동시성 태스크 사이의 협동이 프로그래머 책임인 Ada 의 태스크 모델을 생각하자. 함수 프로그램은 먼저 그래프로 번역하여 실행될 수 있다. 그런 후, 이 그래프는 프로그래머가 명시하지 않은 많은 양의 동시성으로 실행될 수 있는 그래프 감축 과정을 통해서 실행된다. 그래프 표현은 동시성 실행을 위한 많은 기회를 자연스럽게 표현한다. 이 과정에서 협동 동기화는 프로그래머의 관심사가 아니다. 이 과정의 상세한 서술은 이 책의 범위를 넘는다.
명령형 언어에서, 프로그래머는 프로그램을 동시성 부분으로 정적으로 분할하고, 이 부분을 다시 태스크로 작성한다. 이것은 복잡한 과정이다. 함수 언어 프로그램은 동적으로 실행 시스템에 의해서 동시성 부분으로 나누어진다. 따라서 이 과정을 프로그램이 실행되는 하드웨어에 강하게 적응하게 만든다. 명령형 언어에서 동시성 프로그램을 이해하는 것은 더욱 어렵다.
수학 함수는 평가를 제어하기 위해 조건과 재귀만을 사용하는 유명 (named) 또는 무명 사상 (unnamed mapping) 이다. 복잡한 함수는 함수가 매개변수, 반환 값 (또는 둘 다) 으로 사용되는 범함수 형태를 사용하여 구성될 수 있다. 함수 프로그래밍 언어는 수학 함수를 모델로 하고 있다. 순수한 형태에서 결과를 생산하기 위해 변수나 배정문을 사용하지 않는다. 오히려 함수 적용, 조건식, 실행 제어를 위한 재귀, 복잡한 함수를 구성하기 위한 범함수 형태를 사용한다. LISP 는 순수한 함수 언어로 시작되었다면, 곧 효율성과 사용의 용이함을 증가시키기 위하여 다수의 명령형 언어의 특징을 첨가했다.
LISP 의 첫 버전은 AI 응용에 리스트-처리 언어를 위한 필요성에서 생겨났다. LISP 는 아직도 AI 분야에서 가장 광범위하게 사용되는 언어다.
LISP 의 첫 구현은 뜻밖의 발견이었다. EVAL 의 원래 버전은 범용 LISP 함수가 작성될 수 있다는 것을 증명하기 위해 개발되었다.
LISP 데이터와 LISP 프로그램은 같은 형태이기 때문에, 프로그램이 다른 프로그램을 구성하게 하는 것이 가능하다. EVAL 의 이용성은 그러한 프로그램을 즉시 실행하는 것을 허용한다.
Scheme 은 정적 영역 규칙을 독점적으로 사용하는 LISP 의 상대적으로 단순한 파생어다. LISP 와 마찬가지로, Scheme 의 주요 원시함수는 리스트를 구성하고 분해하는 함수, 조건식을 위한 함수, 수, 기호, 리스트를 위한 단순한 술어함수를 포함한다. Scheme 은 주어진 리스트의 원소를 변경과 같은 명령형 연산을 포함한다.
COMMON LISP 는 1980 년대 초반의 LISP 파생어의 대부분의 특징을 포함하도록 설계된 커다란 LISP-기반 언어다. COMMON LISP 는 정적과 동적영역 규칙 변수를 허용하고 많은 명령형 특징을 포함한다.
ML 은 LISP 보다는 Pascal 에 더 유사한 구문을 사용하는 정적영역이고 강타입 함수 프로그래밍 언어다. ML 은 타입 추론 시스템과 예외 처리를 포함하고 ML 로 추상 데이터 타입을 구현하는 것이 가능핟.
Haskell 은 ML 과 유사하지만, 순수 함수형이다. 변수도 없고 배정문도 없다. Haskell 에서 모든 표현식은 지연 평가 방법을 사용하여 평가된다. 리스트 함축으로서 Haskell 은 프로그램이 무한 리스트를 처리하도록 한다.
LISP 의 주요 응용 분야가 AI 일지라도, 많은 다른 문제 해결 분야에서 성공적으로 사용되고 있다.
명령형 언어에 비해서 순수 함수 언어의 장점이 있을지라도, von Neumann 기계에서 낮은 실행 효율성은 많은 사람이 함수 언어를 대체 언어로서 생각하는 것을 막고 있다.
LISP 의 발표된 첫 버전은 McCarthy (1960) 에서 발견될 수 있다. 1960 년대 중반부터 1970 년대 말까지 광범위하게 사용된 버전은 McCarthy et al. (1965) 과 Weissman (1967) 에 서술되어 있다. 약간 표준화된 현대 버전인 COMMON LISP 는 Steele (1984) 에 의해 서술되었다. 몇 개의 혁신과 장점과 더불어 Scheme 언어는 Rees 와 Clinger (1986) 에서 논의되었다. Dybvig (1996) 는 Scheme 프로그래밍에 관한 좋은 정보 자료이다. ML 은 Milner et al. (1990) 에서 정의되었다. Ullman (1994) 은 ML 에 관한 훌륭한 입문 교과서이다. Haskell 에서의 프로그래밍은 Thompson (1996) 에서 소개되었다.
일반적으로 함수 프로그래밍에 관한 정밀한 논의는 Henderson (1980) 에서 발견될 수 있다. 그래프 감축을 통한 함수 언어의 구현 과정은 Peyton Jones (1987) 에서 상세히 서술되었다.
1. 범함수 형태와 참조 투명성을 정의하시오.
2. 원본 LISP 의 데이터 타입은 무엇인가?
3. EQ?, EQV?, = 의 차이점은 무엇인가?
4. Scheme 의 DEFINE 함수에서 사용된 평가 방법과 원시함수에서 사용된 평가 방법의 차이점은 무엇인가?
5. DEFINE 의 두 가지 형은 무엇인가?
6. COND 의 의미를 서술하시오.
7. LET 의 의미를 서술하시오.
8. 명령형 특징이 왜 대부분의 LISP 파생어에 첨가되었는가?
9. COMMON LISP 와 Scheme 은 어느 면에서 정반대인가?
10. Scheme , COMMON LISP, ML, Haskell 에서 사용되는 영역 규칙은 무엇인가?
11. ML 이 Scheme 과 세 가지 다른 면이 무엇인가?
12. ML 에서 사용된 타입 추론은 무엇인가? (4 장을 보시오)
13. Scheme 과 매우 다른 Haskell 의 세 가지 특징은 무엇인가?
14. 지연 평가는 무엇을 의미하는가?
1. 간단한 리스트 매개변수의 역 리스트를 반환하는 Scheme 함수를 작성하시오.
2. 두 개의 주어진 리스트의 구조적 동등성 (structurally equality) 을 검사하는 Scheme 술어함수를 작성하시오. 두 리스트는 동일한 리스트 구조를 갖는다면 (원자는 다를지라도) 구조적으로 같다고 한다.
3. 집합을 나타내는 두 개의 단순 리스트 매개변수의 합집합을 반환하는 Scheme 함수를 작성하시오.
4. 주어진 원자가 제거된 리스트를 반환하는 두 개의 매개변수 - 원자와 리스트 - 를 갖는 Scheme 함수를 작성하시오. 반환된 리스트는 제거된 원자대신 어느것도 포함할 수 없다.
5. 매개변수로 리스트를 위하고 두번째 상위 수준 원소가 제거된 리스트를 반환하는 Scheme 함수를 작성하시오. 만약 주어진 리스트가 두 개의 원소를 갖지 않는다면, 함수는 () 를 반환해야 한다.
6. FP (Backus, 1978) 에 관한 John Backus 의 논문을 읽고 이 장에서 서술한 Scheme 의 특징과 FP 의 대응되는 특징을 비교하시오.
7. Scheme 함수 EVAL 과 APPLY 의 정의를 찾고, 그들의 동작을 설명하시오.
8. 임의의 언어를 위한 가장 현대적이고 완전한 프로그래밍 환경 중 하나는 LISP 을 위한 INTERLISP 시스템이다. 이 시스템은 "The INTERLISP Programming Environment," by Teitelmen and Masinter (IEEE, Computer, Vol. 14, No. 4, April 1981) 에 서술되어 있다. 이 논문을 주의 깊게 읽고 당신 시스템에서 LISP 를 작성하는 어려움과 INTERLISP 를 사용하는 어려움을 비교하시오 (단 여러분이 일반적으로 INTERLISP 를 사용하지 않는다고 가정한다).
9. LISP 프로그래밍에 관한 책을 참고하고 PROG 특징을 LISP 에 포함하는 것을 지지하는 논조를 결정하시오.
10. 함수 언어는 리스트가 아닌 어떤 데이터 구조를 사용할 수 있다. 예를 들면, 기호의 순서열 (sequence of symbols) 을 사용할 수 있다. 그러한 언어는 Scheme 의 CAR, CDR, CONS 원시함수 대신에 어떤 원시함수를 갖는가?
11. 다음 Scheme 함수는 무엇을 하는가?
(define (y s lis)
(cond
((null?
lis) '() )
((equal? s (car
lis)) lis)
(else (y s (cdr
lis)))
))
12. 다음 Scheme 함수는 무엇을 하는가?
(define (x lis)
(cond
((null?
lis) 0)
((not (list? (car
lis)))
(cond
((eq?
(car lis) nil) (x (cdr lis)))
(else
(+1 (x (cdr lis))))))
(else
(+ (x (car lis)) (x (cdr lis))))
))