Robert E. Tarjan
컴퓨터를 만든 15 인의 과학자 : Dennis Shasha. Cathy Lazere 공저, 박영숙 옮김, 세종연구원, 1998 (원서 : Out of Their Minds : 1995)
합집합 찾기 (union-find) 와 상각 (amortization)
컴퓨터 과학 분야에서는 훌륭한 아이디어가 세 가지 특징을 가진다. 그것은 우선 실제로 흔히 사용된다는 점, 일찍부터 젊은 컴퓨터 과학자들에게 가르친다는 점, 마지막으로 연구의 길을 제시한다는 점이다. 이러한 기준에 비추어 볼 때 로버트 앙드레 타잔 (Robert Endre Tarjan) 은 수많은 좋은 아이디어들을 내놓았다.
그가 스탠퍼드 대학에서 존 홉크로프트 (John Hopcroft) 와 함께 한 박사 과정의 연구는 평면 검사 (planarity testing) 와 그 밖의 그래프 알고리즘들에 대한 것으로서, 보다 효율적인 칩 레이아웃에서 보다 나은 도형 (map) 레이아웃에 이르기까지 다양한 응용 프로그램을 탄생시켰다. 이들 알고리즘은 모든 학부생들이 배우게 되는 '깊이 우선 검색 (depth-first search)' 이라는 프로그래밍 기술의 위력을 강조한다. 또한, 깊이 우선 검색은 게임이나 스프레드 시트, 그래픽 프로그램 등의 분야에서도 하루에 수십억 차례씩 사용되고 있다. 이후 타잔이 댄 슬리터 (Dan Sleator), 앤드류 골드버그 (Andrew Goldberg) 와 함께 진행하였던 효율적인 네트워크 흐름에 대한 연구는 설계자들이 연안의 석유에서 전화 통화에 이르기까지 모든 것의 흐름을 개선하기 위해서는 네트워크에서 각각의 연결에 얼마나 많은 용량을 부여해야 하는지를 알아내는 데 도움을 주었다. 뿐만 아니라, 상향 트리 (up-tree) 와 사선 트리 (splay-tree) 라고 알려져 있는 한 쌍의 단순한 자료 구조에 대한 그의 연구는 알고리즘의 효율성을 측정하는 새로운 기법을 도입시켰다.
닐 사나크 (Neil Sarnak), 슬리터, 제임스 드리스콜 (James Driscoll) 등과 함께 한 또 다른 연구는 현재 뿐만 아니라 과거에 대한 정보까지 보유할 수 있는 자료 구조를 아주 효율적인 형태로 제시하였다. 그처럼 '영속적인' 자료 구조는 오늘날 로봇 공학과 데이터 베이스 시스템 분야에서 점점 더 사용이 늘고 있다.
타잔은 또한 컴퓨터 과학의 연구에 문화적 변화를 가져왔다. 그것은 적절한 '큰 아이디어 (big idea)' 를 얻은 다음, 그것을 가장 효율적으로 지원할 자료 구조를 만들어 내는 방식이다. 그를 비롯해 여러 사람이 그러한 전략으로 다이크스트라의 최단 경로 알고리즘과 또 다른 기본 알고리즘들에서 중대한 개선을 밀어붙였다.
그의 연구는 미니멀리즘 (minimalism), 세련됨, 그리고 보편성을 향한 무언의 추구 등으로 특징지을 수 있다.
|
좋은 아이디어는 보다 단순해져 원래 목표했던 것 이외의 문제들까지 해결할 수 있는 방법을 가지고 있습니다. |
로버트 앙드레 타잔은 1948 년 캘리포니아 주 포모나에서 태어났다. 어린 나이부터 그는 과학에 흥미를 느꼈다.
|
아마 7 학년쯤 되었을 때일 겁니다. 난 『사이언티픽 아메리칸 Scientific American』지에 실린 마틴 가드너 (Martin Gardner) 의 칼럼을 읽으면서 수학에 흥미를 느끼게 되었습니다. 그 이전에는 천문학에 관심이 있었지요. 난 화성에 발을 내딛는 최초의 사람이 되고 싶었습니다. |
소아정신과에서 정신 지체 분야 전문의였던 타잔의 아버지는 주립 병원을 운영하고 있었다. 타잔은 중학교 시절 그 곳에서 일자리를 얻어 그가 '예비 컴퓨터 (precomputer)' 라 불렀던 IBM 천공 카드 조합기들에 대한 작업을 하였다. 1964 년 중학 과정에 이어진 하계과학 프로그램에서 타잔은 처음으로 실제 컴퓨터들을 가지고 작업을 하게 되었다.
|
당시의 발상은 하나의 소행성을 관찰하고 그것의 궤도를 계산하는 것이었습니다. 우리는 UCLA 에서 컴퓨터를 직접 사용해 볼 기회를 가졌고 그렇게 해서 난 포트란을 배우게 되었지요. 그 무렵 주립 병원에서도 아주 작은 컴퓨터를 한 대 갖게 되었습니다. 그래서 난 여름이면 캘테크를 떠나 그 컴퓨터를 가지고 환자들을 모집단으로 한 통계적 연구의 프로그래밍을 실행하였습니다. |
캘테크에서 타잔은 수학을 전공하였지만, 컴퓨터 과학쪽에서도 대학원생들에게 개설된 과정은 빠짐없이 수강하였다.
|
난 보다 응용력 있는 유형의 수학이라는 이유 때문에 컴퓨터 과학을 하고 싶었습니다. 대체로 논리와 정리 증명의 측면에서 인공지능에 흥미를 느꼈지요. 하지만 정작 스탠퍼드에 들어가 AI 과정을 시작하게 되었을 때에는 그것이 아주 모호한 것이라는 결론을 내렸습니다. |
스탠퍼드는 도널드 크누스와 존 매커시를 포함해 컴퓨터 과학의 선구적 인물들을 배출했다는 것을 자랑스럽게 여기고 있었다.
|
크누스는 우선 고무적이었습니다. 그가 아주 구체적인 분석에 관심의 초점을 두었다는 점에서 고무적이었지요. 그는 항상 정확한 결과를 얻어내는 수학의 엄밀성에 흥미를 보이고 있었습니다. |
또 한명의 고무적인 인물은 코넬에서 안식년을 맞아 스탠퍼드에 와 있었던 존 홉크로프트였다. 그는 타잔이 대학원 2 학년 과정을 시작하기 전이었던 여름에 그 곳에 도착하여 그의 옆방에 들어왔다. 그 두 사람은 곧 공동 연구를 시작하여 마침내 1986 에는 튜링상을 수상하기에 이른다.
|
난 매커시의 기호 처리 과정을 택했습니다. 그 강의는 대부분 리스프에 대한 내용이었지요. 그는 학생들에게 그래프가 평면인지 아닌지를 식별하는 프로그램을 쓰도록 제안하였습니다. 난 아무런 기대도 갖고 있지 않았습니다. 단지 흥미로운 문제들을 풀려고 애쓰는 한 명의 대학원생일 뿐이었지요. |
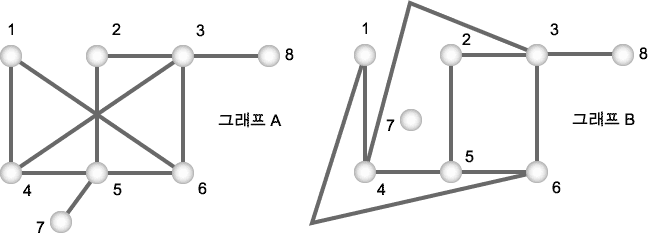
그래프는 노드 (node) 들과 노드 사이를 연결하는 간선 (edge) 들의 집합이다. (그림 1 의 그래프에서 노드는 작은 원을 가리키며 간선은 그것을 연결하는 직선들이다.) 그래프는 각기 다른 실제 세계의 많은 현상들을 표현하는 데 사용된다. 예를 들어, 노드가 분자를 나타내고 간선이 분자 결합을 나타내는 경우도 생각해 볼 수 있고, 노드가 있으며, 노드가 교차로를 나타내고 간선은 도로들을 나타낼 수도 있는 것이다.
|
그림 1 평면 그래프 그래프는 A 는 그래프 B 에서 보이는 것처럼 간선들이 겹치지 않으면서 그 연결 관계는 그대로 유지되도록 다시 그려질 수 있다. |
특정한 응용 사례에서는 간선이 겹치지 않도록 하는 것이 중요하다. 예를 들어, 배선도의 레이아웃인 경우 간선 (배선) 의 중복은 누전을 초래할 수 있다. 따라서, 어떤 그래프를 작성할 때 과연 그 연결 상태는 그대로 유지하면서 간선들이 겹치지 않도록 그릴 수 있는가 하는 질문이 자연스럽게 제기될 것이다. 그와 같은 그래프를 '평면 (planar)' 그래프라고 부른다. 그림 1 의 그래프 A 에서는 간선들이 겹쳐있지만, 그 그래프를 펼쳐서 그래프 B 와 같이 간선들이 중복되지 않게 만들 수 있다.
그래프가 평면인지 아닌지를 가리는 검사의 기원은 18 세기의 오일러 (Euler) 까지 거슬러 올라간다. 그 스위스 수학자는 노드의 수가 N 일 때 N 이 최소한 3 이상이라면 간선의 수가 3N - 6 이상이 되는 그래프는 있을 수 없음을 보여 주었다.
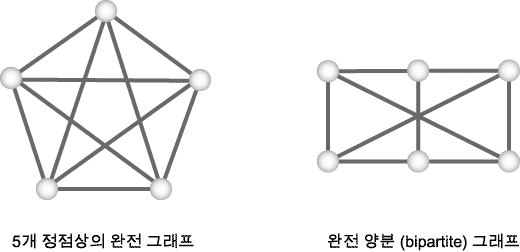
1930 년 폴란드의 수학자 쿠라토프스키 (Kuratowski) 는 모든 비평면 그래프는 그림 2 에 제시된 그래프 가운데 하나의 연결 관계를 가진 그래프를 포함 '해야만' 한다는 사실을 보여 주었다. 매커시는 학생들에게 쿠라토프스키의 조건을 프로그램에 사용하도록 제안하였다. 타잔은 곧 그렇게 만들어지는 알고리즘은 너무도 비효율적일 것이라는 결론을 내렸다. 쿠라토프스키의 검사가 알고리즘으로 변환될 수는 있지만, 거기에 요구되는 시간은 꼭지점 수의 6 제곱에 비례한다는 이유 때문이었다. 그것은 만일 꼭지점의 수가 100 개 가량인 그래프의 경우 1012 만큼의 단계가 필요하게 된다는 것을 암시한다.
|
그림 2 모든 비평면 그래프는 여기서 보여 주는 것 가운데 하나와 같은 구조 (부분 그래프) 를 가져야만 한다. |
|
그래서 나는 이미 평면 검사에 관해 생각하고 있었습니다 홉크로프트가 도착하였을 때 우리는 알고리즘과 효율성에 관해 논의하기 시작하였지요. 홉크로프트는 이중 결합 요소들을 찾기 위한 알고리즘을 제시하였는데, 그것만으로 시작을 하기에는 다소 엉성한 스케치였습니다. 하지만 실제로 그 알고리즘의 성격은 깊이 우선 검색이었지요. 난 그것에 대해 생각해 본 뒤 그의 알고리즘에서 진행되는 사항의 원칙을 보다 엄밀하게 만들기 위한 시도를 하였습니다. |
깊이 우선 검색은 인공 지능의 문제들에 대한 해법을 찾는 데 널리 사용되고 있었다. 그 분야에서는 이를 '역행 (backtracking)' 이라 불렀다. 역행은 문제를 해결하는 데 있어 어떤 한 가지 접근 방식을 반복하지 않으면서 상이한 접근 방식들을 검토한다. AI 분야에서는 이것이 게임에서 일련의 운동과 반대 운동들 사이에 체계적인 검색을 실행하는 데 사용되었다. 타잔과 홉크로프트는 깊이 우선 검색을 그래프 연구의 방법으로 사용하였다. [깊이 우선 검색에서 단일의 접근 방식은 다른 접근 방식이 시도되기 전에 그 결론이 따라 나온다. '너비 우선 (breadth-first)' 이라고 하는 또 하나의 전략에서는 어떤 문제를 해결하는 데 대한 수많은 접근 방식들이 동시에 작용한다. 어떤 접근 방식이 사용되는가는 문제에 따라 달라진다.]
깊이 우선 검색은 그래프의 노드 n 에서 시작하여, n 을 기점으로 그어진 간선을 선택한다. 간선 운행 (traverse) 은 새로운 노드에 이르게 한다. 일반적으로 프로그램은 가장 최근에 방문한 노드에서 출발하는 아직 검사되지 않은 간선을 선택하여 운행한다. 깊이 우선 검색은 어떠한 간선도 한 번 이상 운행되지 않도록 보장한다.
홉크로프트와 타잔은 깊이 우선 검색을 사용하여, 1961 년 오슬랜더 (L. Auslander) 와 파터 (S. V. Parter) 가 개척해 1963 년 골드스타인 (A. J. Goldstein) 이 수정한 전략을 실행하였다. 오슬랜더, 파터, 골드스타인 세 사람이 제안한 알고리즘은 쿠라토프스키의 비평면 검사와는 직접적인 토대로 삼고 있다. 그 기본 단계들은 다음과 같다.
1. 그래프가 가지고 있는 간선의 수가 오일러의 조건이 허용하는 것보다 많지 않은지를 검사한다 (만일 그렇다면 그것은 평면이 아님).
2. 그래프를 이중 결합 요소들로 나눈다. 그래프의 '이중 결합 요소 (biconnected component)' 란 두 노드 사이에 경로가 존재한다는 속성을 지닌 노드들의 집합으로서, 그 집합 내에서는 어떤 단일 노드가 제거되더라도 여전히 경로가 존재하게 된다. 이것이 너무 추상적으로 들린다면 이런 식으로 생각해 보라. 즉, 만일 당신이 살고 있는 도시에서 도로 공사를 시행하여 어떤 단일한 교차로에서 당신의 단골 재즈 클럽으로 갈 수 없도록 만드는 것이 불가능하다면, 그 도시는 이중 결합 상태라 할 수 있다.
3. 깊이 우선 검색을 사용해 그래프에서 순환을 찾는다. '순환 (cycle)' 이란 그래프상의 한 노드에서 출발해 다시 그 동일한 노드로 돌아와서 끝나는 경로를 말한다.
4. 순환을 제거하면 그래프는 '다리 (bridge)' 라고 하는 연결된 부분들로 나뉘게 된다. 개별적인 다리들에 대해 그 다리와 순환이 함께 평면 그래프를 형성하는지 여부를 검사한다. 이 검사는 각각의 다리에 이 동일한 알고리즘을 적용함으로써 수행될 수 있다. [다리는 원래의 그래프보다 작기 때문에, 이 알고리즘은 이러한 '재귀적 순환 (recursion)' 에서 무한한 회귀를 피할 수 있다.
5. 순환이 평면상에 그려질 경우, 각각의 다리는 완전히 내부로 들어 가거나 아니면 완전히 원 바깥쪽에 있어야 한다.
특정한 다리의 쌍들은 서로 충돌하기 때문에 각각 원의 반대편에 지정되어야 한다.
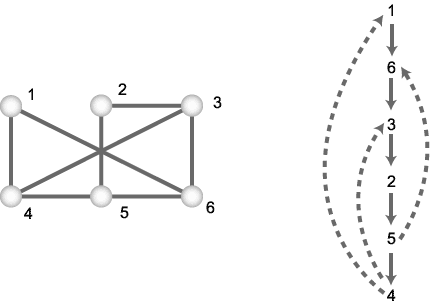
이 알고리즘을 효율적인 것으로 만드는 열쇠는 포함된 그래프들 (정식 용어는 부분 그래프) 의 평면 검사를 비롯해 전체 계산을 단일한 깊이 우선 검색만으로 수행하는 것이다. 구체적인 사항들은 기술적인 문제이며, 그들의 논문 '효율적인 평면 검사 (Efficient Planarity Testing)' 는 아주 밀도 있는 『계산 기계 협회 저널 Journal of the Association for Computing Machinery』에서도 20 페이지에 달하는 분량으로 다루어졌다. 하지만 그 기본 구조는 그림 3 에서 볼 수 있다. 거기에서는 그림 1 의 그래프 A 를 약간 단순하게 변형시킨 한 평면 그래프의 깊이 우선 검색을 보여 준다. 실선 화살표는 그래프의 노드들을 검사하는 한 가지 가능한 접근 방법을 나타내며, 점선 화살표들은 실선 화살표로 설명되지 않은 그래프의 간선들을 나타낸다. 예를 들어, 4 에서 1 로 향하는 간선이나 5 에서 6 으로 향하는 간선은 그래프상에는 나타나지만 트리에서는 직접 표현되지 않는다. 그래서 점선으로 표시된 것이다. '역 간선 (back edge)' 이라 부르는 이 추가의 간선들이 트리에서 조상을 가리킨다는 사실은 타잔과 홉크로프트가 깊이 우선 검색에 대해 발견한 많은 훌륭한 특성들 가운데 하나이다.
|
그림 3 깊이 우선 검색 평면 검사 왼쪽 그래프의 깊이 우선 검색은 많은 상이한 트리들을 만들어 낼 수 있다. 오른쪽의 다이어그램에서 실선 간선으로 표시된 트리는 그 중 한 가지 가능성이다. 점선으로 그려진 왼쪽 그래프상에는 나타나 있지만, 이 특정한 트리 표현에는 포함되지 않는 간선들에 해당된다. |
그림 3 에 제시된 그래프의 경우 알고리즘의 두 번째 단계에서 발견되는 순환은 1 → 6 → 3 → 2 → 5 → 4 → 1 이 될 것이다. 위에서 언급한 다섯 번째 (검사) 단계는 나머지 두 개의 점선 간선, 즉 4 ⇒ 3 과 5 ⇒ 6 이 평면상에서 하나는 원의 내부에, 하나는 원의 외부에 임베딩 (embedding) 될 수 있다는 것을 관찰하는 데 있다. 이것은 그 그래프가 평면임을 의미한다.
타잔과 홉크로프트의 전략은 깊이 우선 검색 트리에 역 간선들을 더한 것이 평면인지 여부를 판별하는 것으로, 평면 문제의 범위를 좁혀 준다. 이것은 아주 효율적으로 수행될 수 있다.
이 문제에 대한 이전의 모든 접근 방식들과 달리, 홉크로프트-타잔 알고리즘은 선형 시간 (즉, 그래프의 크기에 비례하는 시간) 내에 실행된다. 이는 문제의 크기를 두 배로 늘일 때 그것을 해결하는 데 드는 시간도 단지 두 배로만 늘어난다는 것을 의미한다. 반면에, 쿠라토프스키의 기준을 사용할 때 문제의 크기를 두 배로 확대하면 시간은 60 보다 큰 비율로 늘어날 수 있다.
|
평면 문제에 대해서는 모든 사람이 정말 어려운 문제이므로 시간을 많이 잡아먹을 것이라 생각했기 때문에 큰 논란을 불러 일으켰습니다. 하지만 내가 우리의 평면 검사 알고리즘을 실행시켰을 때 그것은 아주 바르게 진행되었습니다. 복잡한 알고리즘을 사용해서 특정한 문제들을 훨씬 더 빨리 해결할 수 있다는 사실이 명백해진 것이지요. |
1970 년대 초에는 이것이 소수파의 견해에 불과했다. 계산을 수행하는 데 드는 시간의 수학적 연구를 시작한 지 불과 10 여년밖에 되지 않은 시점이었던 것이다. 그와 같은 연구는 1959 년 마이클 라빈으로부터 시작되어 도널드 쿠누스, 쥬리스 하트마니스 (Juris Hartmanis), 스티브 쿡, 레오니드 레빈 등이 그 뒤를 이었다. 하지만 어떤 방법에 드는 비용이 그 방법으로 문제를 해결하는 데 필요한 연산의 수에 따라 달라진다는 발상은 아직까지 실무 프로그래머들의 의식 속에 파고 들지 못하고 있었다.
대신 실무자들과 많은 학자들은 직접 자신들의 컴퓨터에서 그들의 알고리즘을 실행하여, 이전의 컴퓨터들에서 공식적으로 발표된 알고리즘들을 사용하는 경우와 시간을 비교해 보았다. 이것은 고속의 컴퓨터에서 질이 낮은 알고리즘을 수행하는 것이 저속의 컴퓨터에서 우수한 알고리즘을 수행하는 것보다 나은 것으로 보일 것이라는 결과를 낳았다!
홉크로프트와 타잔은 평면 문제를 다룬 논문에서 학문적 야만성을 보이는 현대의 관행에 대해 다음과 같은 태도를 밝혔다. "하지만 지금까지 알고리즘 실행 시간의 엄밀한 분석을 위해 행해진 연구는 놀랄만큼 미미한 수준에 지나지 않으며, 알고리즘들은 계속해서 이전에 공식화된 알고리즘들에 비해 명백히 열등한 것으로 나타나고 있습니다."
홉크로프트와 타잔은 그 대신 가산, 비교, 간선 운행 등과 같이 알고리즘에 요구되는 기본 연산의 수를 토대로 알고리즘의 속도를 측정할 것을 주창하였다. 평면 알고리즘의 실질적인 성공에 따라, 이 접근 방식은 곧 컴퓨터 과학의 이론뿐 아니라 실행의 측면에서도 소중한 것으로 받아들여지게 되었다. 또한, 벨 연구소 (Bell Labs) 의 알 아호 (Al Aho) 와 홉크로프트, 그리고 프린스턴 대학의 제프 울먼 (Jeff Ullman) 등이 1974 년 알고리즘에 대해 널리 사용된 교재를 집필하는 데에도 틀림없이 도움을 주었을 것이다. 그 책에서는 바로 이 방법을 사용해 알고리즘의 속도를 측정하였다.
효율적인 평면 검사를 통해 얻게 된 또 하나의 부수적 효과는 깊이 우선 검색 자체가 널리 응용된다는 사실을 인식하게 된 것이었다. 홉크로프트와 타잔이 튜링상을 수상한 자리에서 그 해의 최고 컴퓨터 체스 프로그램으로 선정되었던 사람은 자신의 프로그램이 체스 게임을 하는 동안 깊이 우선 검색을 4 천만 번 이상 사용하였다고 밝혔다.
타잔은 1971 년 박사 학위를 받은 후, 코넬의 조교수로 갔다. 그곳에서도 알고리즘의 효율성에 대한 그의 관심은 사그라들지 않았다.
코넬에 도착한 후 타잔은 곧 '합집합 찾기 (union-find)' 라고 하는 기만적으로 단순한 문제에 대한 연구에 착수하였다. 그 작업이 효율적으로 실행되면 아주 다양한 범위의 다른 문제들을 보다 빨리 해결할 수 있도록 만들어 줄 것이었다.
많은 그래프 알고리즘에서 노드는 '분할 (partition)' 이라고 하는 상이한 집합들로 구분되어야 한다. 알고리즘이 진행되는 과정에서 그 상이한 분할들은 합병되어 보다 큰 분할을 이룰 것이다.
예를 들어, 어떤 문제가 단일 분할 내의 모든 노드는 연결되어 있어야 한다고 지정한다는 가정을 해 보자. 그 분할 내에는 각각의 모든 노드에서 그 밖의 모든 노드로 연결되는 하나의 경로가 존재할 것이다.
그 문제를 해결하는 알고리즘의 한 단계에서 분할 A 에 들어 있는 어떤 노드와 분할 B 의 어떤 노드가 간선으로 연결되어 있음을 발견한다고 가정해 보자. 그럴 경우, 그 두 개의 분할은 반드시 하나로 합병되어 그 안의 모든 멤버가 분할 A 의 원소와 분할 B 의 원소들의 합집합이 되도록 해야 한다.
그림 4 는 그 한 예를 보여 준다. 처음에는 각각의 요소들이 단독으로 고립된 하나의 집합을 이루고 있다 (그림 4 의 a 부분 참조). 이 예에서 분할 A 는 집합 {1, 2, 4} 이고 분할 B 는 집합 {3, 6} 이며, 결과적으로 만들어지는 분할은 {1, 2, 4, 3, 6} 의 원소들을 가진다.
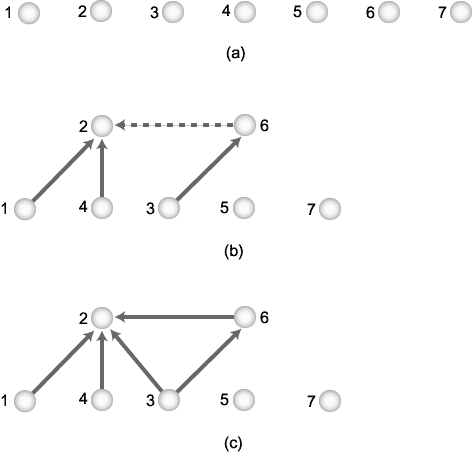
그림 4 합집합 찾기
두 개의 집합이 하나로 합병될 때마다 하나의 '정규 노드' 에서 다른 하나의 정규 노드로 화살표가 그려지며, 그 화살표는 대체로 작은 집합에서 큰 쪽을 향한다 (그림 4 의 b 부분에서, 6 에서 2 를 향해 점선으로 그려진 간선). 어떤 집합의 '정규 노드 (canonical node)' 란 그것을 기점으로 출발하는 간선이 하나도 없는 노드를 말한다. 이것이 바로 합집합 찾기 알고리즘의 합집합 연산이다.
각 분할의 원소 구성은 시간에 따라 달라지기 때문에, 훌륭한 자료 구조라면 그 알고리즘이 특정한 시점에 어떤 두 개의 노드가 동일한 분할에 속해 있는지 여부를 쉽게 알아낼 수 있도록 해 주어야 한다.
그림 4 의 b 부분에서 보여지는 구조는 '상향 트리 (up-tree)' 의 한 예이다. 상향 트리라는 용어는 1964 년 갤러 (B. A. Galler) 와 피셔 (M. J. Fischer) 가 분할 내에서 연결된 간선이 하나도 없는 노드가 바로 분할 식별자가 되는 구조를 나타내기 위해 제안한 개념이다. 두 노드는 분할 식별자를 향해 곧장 위로 그려진 간선들을 다라감으로써, 자신들이 동일한 분할에 속해 있는지 여부를 알아낼 수 있다. 다시 말해, 두 노드가 동일한 집합에 속해 있는지를 확인할 때에는 단지 그들이 동일한 정규 노드를 가지고 있는지만 알아 보면 되는 것이다. 이것이 합집합 찾기 알고리즘의 '찾기 (find)' 연산이다. 따라서, 찾기 (3) = 2 이고 찾기 (1) = 2 이므로 그들은 동일한 집합에 속하는 반면, 찾기 (5) = 5 (거기서 출발하는 간선이 하나도 없기 때문에) 이므로 5 는 6 이나 3 과 다른 집합에 속해 있음을 알 수 있다.
각각의 찾기 연산은 분할 식별자로 연결되는 경로를 가능한 한 많이 단축시킨다. '경로 압축 (path compression)' 이라고 부르는 이 추가 작업을 행해 이후의 합집합 연산이나 찾기 연산의 속도를 높여주는 것이다. 그림 4 의 c 부분은 홉크로프트-울먼 알고리즘이 3 에서 2 로 가는 경로를 단축하기 위해 어떻게 경로 압축을 사용하고 있는지를 보여 준다. 이런 식으로 하면 앞으로는 3 에서 찾기를 실행할 때 오직 한 단계만을 필요로하게 될 것이다.
많은 알고리즘에서 합집합 찾기가 하는 역할은 마치 마천루에서 엘리베이터의 역할과 같다. 빠른 엘리베이터 없이도 건물을 세울 수는 있지만, 사람들을 만족시킬 수는 없을 것이다. 그러한 이유에서 가능한 한 가장 빠른 합집합 찾기 알고리즘을 찾아 내는 것은 필수적이었다. 그렇게 하는 데에는 아주 주의 깊은 타이밍 분석이 요구된다. 타잔이 크게 기여한 바는 바로 이같은 분석을 수행한 것이었다.
그에 앞서 홉크로프트와 울먼은 필시 선형 시간의 상한을 증명하였을 것이다. 선형 시간의 상한은 평면 문제에서 처럼 문제의 크기를 두 배로 확대하면 시간이 배가 걸린다는 것을 의미한다. 1973 년 알고리즘을 주제로 열린 IBM 의 한 워크숍에서 예일대의 마이크 피셔는 홉크로프트-울먼의 증명이 지닌 한 가지 결함을 지적하였다. 타잔은 그 문제에 대해 생각하기 시작했다. 그는 시간 제한이 사실상 초선형적 (superlinear) 이라는 것, 즉 크기가 두 배로 커진 문제에 두 배가 넘는 시간이 요구될 것이라는 걸 보여 주는 어떤 좋지 않은 구성의 사례들이 있었는지를 의심하였다. 타잔은 실제로 선형이 될 수 있는 알고리즘은 하나도 없다는 것을 암시하면서, 역 애커만 함수 (inverse Ackermann's function) 를 제공하는 이중 재귀적 구성 (doubly recursive construction) 을 그 문제에 대한 하한으로 제시하였다. 나중에 그는 이만큼의 시간이 걸리는 알고리즘을 실제로 보여줌으로써 그 하한이 또한 하나의 상한임을 증명하였다.
|
따라서, 다소 난해한 이 함수는 이처럼 아주 단순한 자료 구조의 분석에서 고유한 양식으로 나타납니다. 바로 그 점이 이 문제와 관련하여 놀라운 사실이었지요. 그것을 예측할 수 있는 방법은 전혀 없었습니다. 대부분의 사람들이 알고리즘의 실행 시간은 선형이라고 믿었지요. |
이러한 믿음은 사실상 진실에 가까웠다. 애커만 함수는 원래 순환 이론이라고 알려져 있는 수학의 발전된 부문에서 하나의 예로 고안된 것이었다. 그 함수는 아주 급속하게 증가한다. 이는 다시 역 애커만 함수는 어떠한 원격 실행 응용 프로그램에 대해서도 결코 5 이상이 될 수 없을 만큼 아주 느리게 증가한다는 것을 의미한다.
그러나 평면 문제에서처럼 그 결과는 놀라운 것이었다. 누구도 애커만 함수가 실생활에서 응용될 것이라고는 생각하지 못했었기 때문이다. 이로 인해 연구자들은 타잔이 고안하였던 새로운 분석 시법을 검토하게 되었다.
합집합 찾기의 분석은 어렵다. 찾기 연산은 일단 경로가 압축되기만 하면 (그림 4 의 c 부분) 포인터 운행을 단 한 번만 요구하게 되지만, 경로가 압축되지 않았을 경우 긴 운행을 필요로하게 될 것이기 때문이다.
단일한 찾기 연산은 많은 연산들을 취할 수 있다. 그 당시까지 존재한 분석 기법들 (홉크로프트와 타잔이 평면 문제에 대해 사용한 것들까지 포함하여) 을 살펴 보면, 연구자들은 최악의 경우 연산의 수와 단일 연산에 드는 시간을 곱하는 방식으로 알고리즘의 난이도를 측정하였다. 널리 인정되는 바와 같이 이 보수적인 방법은 대체로 유용하였다. 하지만 타잔은 그 표준적인 분석 기법이 이 문제에 적절치 못하게 많은 시간을 부여한다는 것을 인식하였다.
어떤 단일한 찾기 연산에는 긴 시간이 걸리는 반면, 그 길을 따라 경로 압축을 수행함으로써 앞으로의 찾기 연산들에 드는 시간은 줄일 수가 있다. 즉, 몇 년 후 타잔과 그의 제자 대니 슬리터 (Danny Sleator) 가 회계 분야에서 빌어 온 용어를 사용하면, 찾기 연산 하나를 추가하는 작업은 그것으로 혜택을 받는 많은 찾기 연산들에서 '상각 (amortized)' 되는 것이다.
|
요점은 어떤 자료 구조상에서 길게 이어지는 일련의 연산들을 갖게 된다는 것입니다. 개별 연산들에는 상관 없이, 그 순서 전반에 걸친 연산의 평균 시간에 관심을 가져야 합니다. |
마치 깊이 우선 검색이 표준적인 알고리즘 기법이 되었던 것처럼, 상각은 표준적인 분석 기법으로 자리잡게 되었다. 그 결과 하나의 연산이 그 동료 연산들에 대해 이타적으로 행동하는 수많은 알고리즘이 만들어지게 되었다.
1973 년 이사카에서 두 번째로 맞이한 혹독한 겨울은 타잔으로 하여금 버클리에서 보내온 제안을 받아들이게 만들었다. 그는 그곳으로 가서 2 년을 보낸 후, 1975 년 다시 스탠퍼드로 돌아갔다. 거기서 그가 가르친 대학원생들 중 하나가 바로 대니 슬리터였다. 상각되는 시간에 대한 발상은 타잔과 슬리터가 네트워크의 최대 유량이라는 문제에 대한 연구를 진행하면서 다시 부각되었다.
|
당신에게 간선이 용적을 가지는 유향 그래프 (directed graph) 와 함께 원시 (source) 와 종착 (sink) 이 주어졌습니다. 그 간선들은 파이프를 나타내며, 당신은 그 파이프들을 통해 무언가를 펌프로 퍼올리고 있다고 가정해 봅시다. 당신은 원시에서 종착까지 그 내용물의 최대량을 가져오고 싶어합니다. |
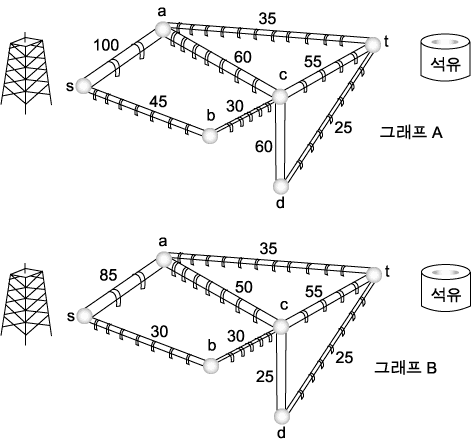
그림 5 네트워크의 최대 유량
그림 5 의 그래프 A 는 석유 수송망을 표현한 그래프이다. 여기서 각각의 파이프 (간선) 는 용량 (숫자로 표시된) 을 가지고 있으며, 그것은 그 파이프 (간선) 를 통해 이동할 수 있는 최대 유량을 나타낸다. 그래프 B 는 그 용량들과 s 에서 t 까지의 총유량 115 가 주어졌을 때 그 수송망 전체의 최대 유량을 보여 준다. 네트워크 유량의 문제는 주어진 네트워크 전체의 최대량을 발견하는 것으로 구성된다.
1956 년 포드 (L. R. Ford) 와 풀커슨 (D. R. Fulkerson) 은 그 문제를 풀어 낼 첫 번째 알고리즘을 정식으로 발표하였다.
1. 0 의 유량에서 시작하며 그것을 현재 유량이라 부른다. 이는 명백하게 용량을 존중한다 (다시 말해, 과포화된 간선은 하나도 없다).
2. 하나의 경로, 즉 모든 간선이 어느 정도 추가의 용량을 가지고 원시에서 목적지까지 연결되는 '증가 경로 (augmenting path)' 를 찾는 시도를 한다. 어떠한 간선도 과포화 상태로 만들진 않으면서 가능한 한 많은 유량이 그 경로를 통과하도록 강요한다. 증가 경로의 유량을 현재 유량에 더한다. 더 이상 증가 경로가 발견될 수 없을 때까지 단계 2 를 반복한다.
포드와 풀커슨 두 사람이 스스로 지적했던 바와 같이, 그 알고리즘은 특정한 사례에 대해서는 비효율적이었다. 더욱 문제가 되는 것은 용량이 불합리할 경우 정확한 답에 이를 수 없다는 것이었다. 10 여 년이 지난 1969 년 에드먼즈 (J. Edmonds) 와 카프 (R. M. Karp) 는 그 문제를 푸는 알고리즘을 새롭게 다듬어 훨씬 더 효율적으로 만들 것을 제안하였다. 그 안은 간선의 수가 가장 적은 증가 경로를 선택한다는 것이었다. 이 방법은 실행 시간이 노드으 수에 간선의 수의 제곱을 곱한 값에 비례하는 알고리즘을 제공하였다.
1970 년에는 독자적으로 연구 활동을 하고 있던 소비에트의 수학자 디닉 (E. A. Dinic) 이 에드먼즈와 카프가 제시했던 것과 똑같은 발견을 하였다. 하지만 디닉은 동일한 숫자를 가진 모든 증가 경로들을 한 번에 배치하는 방법을 찾아냄으로써 한 걸음 더 나아간 결과를 보여 주었다. 뒤이어 인도, 이스라엘, 소비에트, 미국 등지의 연구자들이 제안한 알고리즘은 모두 이 아이디어를 기초로 하였다. 타잔과 슬리터의 알고리즘은 새로운 자료 구조의 고안을 통해 보다 빠른 알고리즘을 얻어낸 것이다.
|
그 문제에서 가장 중요한 점은 하나의 문제를 해결하기 위한 효율적인 자료 구조를 얻어 내는 것 (간선들을 포화 상태로 밀어 부치면서) 이었음이 입증되었지요. 동적 트리 (dynamic tree) 라고 알려져 있는 자료 구조가 슬리터의 박사 학위 논문의 기초가 되었습니다. |
1980 년 타잔과 슬리터는 뉴저지 주 머레이 힐에 있는 벨 연구소로 갔다. 그들은 다시 동적 트리에 대한 연구를 시작하였다.
|
우리는 마침내 최악의 경우에 초점을 두지 않고 그저 이런 식의 시간 평균값 구하기 (상각) 에만 매달린다면, 실제로 이 자료 구조를 단순화할 수 있을 것이라는 사실을 깨달았습니다. 우리는 상각의 개념에 관해 보다 체계적인 방식으로 생각하기 시작했습니다. 그리고는 자체 조절 (self-adjusting) 자료 구조의 발상을 내놓았습니다. 그것은 최악의 경우엔 효율적인 것이 될 수 있었습니다. 우리는 자체 조절 자료 구조를 만들어 '사선 트리 (splay tree)' 라는 이름을 붙였습니다. 그건 정말 멋진 속성들을 가지고 있지요. |
경로 압축과 마찬가지로 트리를 사선으로 만드는 것 역시 트리상에서 아직 처리되지 않은 연산들에 이익을 주기 위해 하나의 연산을 수행하는 작업이다. 하지만 사선화 자체에 많은 비용이 초래될 수 있기 때문에, 타잔과 슬리터는 거기서 얻어지는 이익이 비용을 들일 만한 가치가 있음을 보여 주기 위해 상각 기법을 사용해야 했다.
평면성과 네트워크 유량을 비롯해 타잔이 1980 년대 초반까지 검토해 온 여러 가지 문제들은 모두 명확하게 정의된 정확한 해답을 가지고 있었다. 그래프는 평면이거나 혹은 평면이 아니며, 유량은 최대이거나 혹은 최대가 아니다. 이와 대조적으로 특정한 문제들은 단지 장점의 비교 개념에만 관여할 뿐, 명백하게 옳거나 그릇된 답을 도출해 내지는 않는다.
한 가지 유사한 예를 살펴 보면 이해에 도움이 될 것이다. 우리는 어떤 투자 정보지의 필자가 좋은 주식을 제안할 경우 그가 훌륭하다고 믿는다. 여기서 질을 평가할 수 있는 한 가지 기준은 어떤 투자자가 미래를 완벽하게 내다 보는 천리안을 가진 사람의 충고에 따르는 것에 비해 그 필자의 충고를 따를 때 얼마나 효과적으로 투자를 할 수 있는가를 보는 것이다. 천리안을 지닌 조언자가 실재로 존재하는 것은 불가능할지라도, 좋은 비교 기준을 제공해 주는 것은 사실이다. 타잔과 슬리터는 버퍼 관리의 기본적인 문제에 대해 바로 이와 같은 비교 기준을 제시하였다.
컴퓨터는 램 (RAM), 즉 임의 접근 기억 장치 (random access memory) 라는 고속 메모리와 이보다 1000 배나 느린 '디스크 (disk)' 라는 또 한 가지 기억 장치를 가지고 있다. 램은 일반적으로 사용자가 관심을 가지는 모든 자료를 저장할 수가 없기 때문에, 버퍼 관리의 목표는 곧 사용될 것으로 보이는 자료만을 램 버퍼에 두는 것이다. 어떠한 알고리즘도 장래를 예측할 수는 없기 때문에, 실제 알고리즘은 기록을 토대로 한 추측에 의해 이 목표를 달성한다. 그와 같은 알고리즘으로 가장 인기가 있는 것은 소위 '최소 최근 사용 (least recently used)' 이라고 불리는 것이다.
|
각각의 페이지에 대해 가장 최근에 검토된 시간을 추적합니다. 그렇게 해서 가장 오래된 페이지가 버려지는 것이지요. |
최소 최근 사용의 토대를 이루는 것은 그 사용자의 프로그램이 가장 최근에 접촉한 페이지들이 바로 얼마 안 있어 다시 접촉될 것으로 예상된다는 가설이다. 과거는 미래의 거울인 것이다.
|
당신이 미래를 안다고 가정해 봅시다. 즉, 페이지가 요구되는 전체 순서를 알고 있다고 보는 것이지요. 그렇다면 어떤 식으로 가능한 최선의 페이지 전략을 세울 수 있을까요? 1960 년대에 IBM 의 벨레디 (L. A. Belady) 가 이 문제를 다루었습니다. 그 알고리즘은 다음 번에 사용될 시기가 가장 먼 페이지를 걷어차 버리는 것이었습니다. 하지만 우린 미래를 알지 못하기 때문에 이같은 오프라인식 (통찰력 있는) 전략은 실행에 옮길 수 없습니다. 여기서 제기되는 문제는 가능한 최적 오프라인식 전략에 비할 수 있는 단순한 온라인식 전략을 얼마나 훌륭하게 다룰 수 있는가하는 점입니다. 슬리터는 '경쟁적 (competitive)' 이라는 단어를 만들어 냈습니다. 온라인 알고리즘은 그 성능이 가능한 최적 오프라인 알고리즘의 상수 배 내에 있을 때 경쟁력을 가집니다. |
타잔과 슬리터는 이러한 기준에서 최소 최근 사용 알고리즘이 상당히 훌륭하게 제 몫을 할 것임을 보여 주었다. 크기 S 의 버퍼에 대한 최소 최근 사용은, 가령 어떤 통찰력 있는 알고리즘이 크기 S/2 의 버퍼를 가지고 있을 때 버리는 것에 비해 기껏해야 두 배에 해당되는 페이지를 차내 버릴 것이다. 이 작업은 그 자체만으로도 중요할 뿐 아니라, 스케줄링이나 자원 분배 및 관련된 문제들에 대한 온라인 알고리즘을 합리적인 기준으로 평가한다.
80 년대 초 벨 연구소에 적을 두고 있는 동안 타잔은 뉴욕 대학 (NYU) 에서 조교수로 학생들을 가르쳤다. 그는 NYU 의 대학원생 닐 사나크 (Neil Sarnak) 와 카네기 멜런의 학생 지미 드리스콜 (Jimmy Driscoll) 을 데리고 오랫동안 지속되는 자료 구조들을 검토하기 시작했다.
|
문제는 이전의 버전들도 최근의 버전만큼 제대로 추적할 수 있는 자료 구조를 만드는 것이었습니다. 또한, 전체 자료 구조를 복사하지 않으면서 그 일을 효율적으로 해내는 것도 관건이었지요. |
'자료 구조 (data structure)' 란 자료에 보다 빨리 접근할 수 있도록 컴퓨터의 메모리에 저장해 놓은 그래프 구조를 말한다. 일반적으로 자료 구조는 트리의 형태를 지녀, 프로그램들이 필요한 자료에 빨리 이르도록 해 준다. 예를 들어, 데이터 베이스 시스템에서 가장 널리 사용되는 자료 구조인 B-트리는 독일의 컴퓨터 과학자 루돌프 바이에르 (Rudolf Bayer) 와 미국의 맥크라이트 (E. M. McCreight) 가 970 년대 전반 보잉사 근무 시절에 고안해 낸 것으로서, 0.01 초 미만의 시간 내에 1 천억 가지의 사실들 중에서 요구되는 사실을 찾아낼 수가 있다. 이것은 각각의 사실들 중에서 요구되는 사실을 찾아낼 수가 있다. 이것은 각각의 사실을 한 번에 하나씩 검색해야 하는 경우와 비교할 때 대략 1 만 배 가량 빠른 속도이다. 타잔과 그의 동료들은 자신들이 개발한 장기적인 자료 구조를 '영속적 자료 구조 (persistent data structure)' 라 이름붙였다. 영속적 자료 구조들은 거의 현재의 자료에 대한 정규적인 자료 구조들 만큼이나 속도가 빠르다. 뿐만 아니라, 이 구조는 프로그램들이 (그리고, 따라서 사용자들도) 거의 추가 비용을 들이지 않으면서 과거의 자료 상태에까지 접근할 수 있도록 만들어 준다.
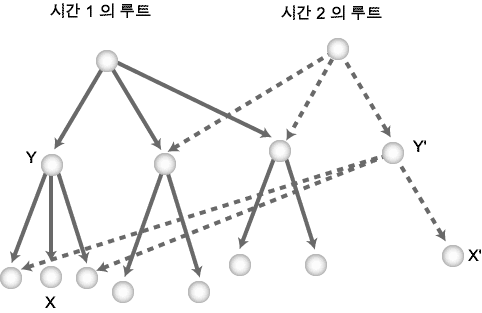
그림 6 타잔과 사나크의 영속적 자료 구조
그림 6 은 타잔과 사나크가 제시한 영속적 자료 구조의 한 예를 보여 준다. 그림에서 노드 X 로 표시된 자료를 갱신해야 할 경우, 그 갱신을 수행하는 가장 효율적인 방법은 X 를 새로운 값 X' 로 대체하는 것이다. 그 접근 방식의 문제는 더 이상 시간 1 에서의 데이터 베이스 상태를 재현 (recall) 하는 것이 불가능하다는 점이다. 타잔-사나크 방법을 사용하면 프로그램이 시간 1 의 루트에서 시작하여 시간 1 에서의 상태를 얻고, 시간 2 의 루트에서 시작하여 시간 2 에서의 상태를 획득할 수 있다.
대부분의 자료가 시간 1 과 시간 2 사이에서 변경되지 않았기 때문에, 시간 2 의 자료 구조는 그 차이만 적용시킨다. 즉, X 를 X' 로 대체하면서 기록을 잃어 버리는 대신, 프로그램이 X' 를 수용할 새로운 노드를 만들고 이어서 X' 의 모든 조상들에 대해서도 새로운 노드를 구성하는 것이다. 대부분의 구조에서는 이 방법을 사용한다고 해서 X 의 위치를 찾아 X' 로 대체하는 방법에 비해 훨씬 많은 작업이 요구되지는 않는다.
이러한 아이디어는 계산 기하학과 병렬 프로세싱 분야에서 응용되어 왔지만, 그것의 주요한 장기 (long-term) 응용 프로그램은 소위 '이력 데이터 베이스 (temporal database)' 라 부르는 것이다. 그것은 과거의 스냅숏들을 빠르고 효율적으로 재생하기 위해 고안된 데이터 베이스들이다.
타잔은 자신이 선택해 온 수많은 알고리즘의 문제에서 어떤 패턴을 본다.
|
싸움의 절반은 해법을 제시하는 과정이 아니라 문제를 선택하는 과정에서 이루어집니다. 당신이 만일 적절한 문제를 얻고 적절한 질문을 한다면 그 해법에 이르는 긴 여정에 들어 선 것이지요. 응용 분야들 가운데에서 부상하는 문제들을 찾으십시오. 여기서 위험한 것은 자체 주입식 (self-feeding) 이 되어 버리는 이론의 어떤 아주 작은 가지에 매달려 실제 세계에 기반을 두지 않는 것입니다. 난 항상 어느 정도 실제적인 중요성을 가지는 문제들, 즉 실용적으로 사용되는 알고리즘을 얻을 수 있으리라고 생각되는 문제들을 연구하려고 노력하였습니다. (한편), 어떤 고립된 영역에서 생성된 어떤 아이디어가 무언가 다른 것에 연관된 것으로 판명되는 시기를 알 수는 없습니다. 수학과 이론적 컴퓨터 과학의 마술은 모든 예측되지 않는 연결 관계들입니다. 여러분은 일반적인 원칙들을 찾기 시작하면 불가사의한 연결 관계들이 나타납니다. 누구도 그 원인을 말할 수 있는 사람은 없지요. |
타잔은 자신의 성공에 대한 사회적 패턴도 이해하고 있다.
|
상호 작용은 매우 중요하며 협력의 정신을 가지고 있습니다. 교수가 됨으로써 얻어지는 가장 큰 기쁨 가운데 하나는 대학원생들을 갖게 된다는 것입니다. 연구를 실행하는 데 있어 엄청난 활동력을 확보할 수 있을 뿐 아니라, 신선하고 개방적인 사고와 배움에 대한 열의를 가진 사람들과 함께 하면서 아주 큰 동기 부여를 받을 수도 있기 때문입니다. |
하지만 결국 연구는 거의가 개인적인 노력이다. 타잔의 경우라 해도 진전없이 많은 날들을 허비해 버릴 수 있다.
|
성공을 위해 필요한 것은 무엇일까요? 물론 두뇌가 있어야 하겠지만, 끈기도 필요합니다. 어떤 해법에 대해 수많은 시도가 실패로 끝나 버릴 수 있지만, 그러다가 마지막 시도에서 어떤 마술 같은 일이 일어날 수 있기 때문입니다. |