과학적 지식의 성장
인공지능의 철학 : 이초식, 고려대 출판부, 1993, Page 159~182
과학적 지식의 구조에 관한 철학적 논의가 주로
그 정당성에 치중하지만, 과학적 지식의 성장을 문제삼게 될 때 발견의 맥락을 해명할
필요를 느끼게 된다. 지식의 성장은 단순한 변화가 아니다. 쇠퇴가 아니고 성장이라고
하려면 특정한 기준에 의거한 평가가 있어야 한다. 가령, 지식이 양적으로 성장했다면
현재 갖고 있다고 생각되는 바를 기준으로 하여 그보다 양적으로 증대되었다는 것으로
풀이될 것이다. 그리고 그것이 질적 성장이라면 상정된 어떤 진리개념을 평가기준으로
삼고 그를 향해 좀더 진전되었다든가, 한층 더 세련된 규칙이나 법칙을 발견하든가,
보다 포괄적인 이론을 발견하였음을 논해야 할 것이다. 인식의 주체가 개인이면 그의
배경적 지식을 기준으로 하여 지식의 성장이 논의되어야 할 것이다. 만약 그 주체가
과학자 사회라면 그 사회가 이미 공유했던 바가 무엇인지부터 살펴야 할 것이다.
그림
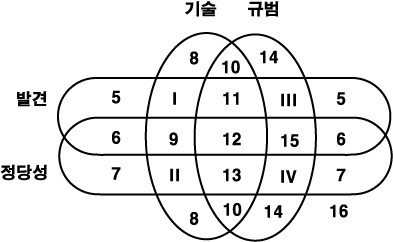
1 에 의거해 본다면 발견의 사실들을 기술하기만 하는 구역 I 과 발견의 규범을
논하는 구역 II 그리고 이 양자가 결부되는 구역 11 이 우선 논의의 초점이 된다.
뿐만 아니라 발견이 정당성의 영역과 연결되는 구역으로 9, 12, 15 도 아울러 논의되어야
할 것이다.
그림 1
지식의 성장은 이미 알려진 것을 기반으로 하여
알려지지 않았던 것을 알아냄으로써 성립된다고 하겠다. 따라서 지식이 성장하기
위해서는 때로는 기지 (旣知) 로부터 미지 (未知) 에로의 귀납적 비약을 감행하여야
하고, 때로는 현실세계로부터 가능의 세계를 향한 모험을 단행해야 한다. 지식의
성장이 단순한 양적 증대를 넘어 질적 비약으로 이어지면 지금까지와는 전혀 다른
시각에서 기존의 지식을 새롭게 할 수도 있다. 이를 형이상학적 차원으로 높이면
인간의 유한성을 초월하고 가치갈등적인 한계상황을 초극하려는 시도로도 이어질
수 있다. 이러한 비약이나 초월 및 초극에 의한 발견은 정당성의 고려나 평가규법의
구속 없이 직관적 통찰이나 느낌에 호소하게 된다. 물론, 직관이나 느낌이 빗나가기
일쑤이지만, 특히 전문가의 느낌은 대체로 정확하므로, 지식의 성장을 위해서 때로는
그러한 느낌을 가질 수 있도록 하는 훈련이 필요하다.
그러나, 앞장에서도 살펴보았듯이,
직관적 통찰은 과학적 발견의 가장 초기 단계에 불과하며 이를 과학적인 것으로 만들기
위해서는 해당 규범들에 의해 그 정당성이 검토되어야 했다. 개별과학 분야에서 새로운
지식을 얻기 위한 특수한 전략적 방법론들이 전문학자들에 의해 개발되고 있으며
이에 대한 철학적 음미도 필요하다. 그러나 우리는 여기서 지식의 성장 일반의 방법론적
특색을 주로 검토하겠다.
그러기 위해서 발견의 맥락 전반에 바탕되는 귀납추리의
특성부터 좀더 명확히 규정하자. 오늘날 귀납추리의 특성은 연역추리와 대비하여
비논증적 (non-demonstrative) 추리, 확장적 (ampliative) 추리, 비가법적 (non-additive,
非加法的) 추리로 규정되고 있다. 다음의 예들은 이러한 귀납추리의 특성들을 이해하는
데 도움이 될 것이다.
|
<추리 1> |
|
3. 그러므로, 그 교실 학생 모두는 안경을 쓰고 있다. |
|
<추리 2> |
|
3. 그러므로, 그 교실 학생 8명이 안경을 쓰고 있다. |
주지하듯이, <추리 1> 이 연역추리임에 비해,
<추리 2> 는 귀납추리의 전형이다. 연역추리는 전제들이 참이면 결론이 필연적으로
참인 추리, 즉 존증적 추리 (demonstrative inference) 이다. 그것은 전제들이 참이고
결론이 거짓일 수 없는 추리이기에 전제가 결론을 필연적으로 함축한다 (entail)
고 한다. 이에 반해 <추리 2> 는 비록 전제들이 참이고 결론이 거짓일 수 있는
비논증적 추리 (non-demonstrative inference) 이다. 따라서 귀납추리는 연역적으로
평가하면 부당한 (invalid) 추리이며 비논증적 추리이다. 그럼에도 불구하고 우리가
<추리 2> 와 같은 것을 근거 없는 추리라고 배척하지 않는 까닭은 그 전제들이
결론을 어느 정도 지원해 준다고 믿기 때문이다. 귀납추리는 이처럼 결론이 참이
될 개연성 (probability) 을 전제가 지원하는 확률추리라고도 하며, 전제가 결론을
부분적으로 함축한다 (partially imply) 고 규정하기도 한다.
귀납추리의 둘째
특성은 전제의 진리치의 영역 안에 없던 것을 결론에서 새로이 주장하는 것이라 하여
진리확장적 추리 (ampliative inference) 라고 한다. 그러나 연역추리는 전제의 진리치를
결론으로 옮겨놓은 데 불과하므로, 진리보존적 또는 진리이행적이라고 할 수 있는
비확장적추리 (non-ampliative inference) 이다. <추리 1> 을 유심히 보면
전제에 이미 있던 지식내용을 결론에서 좀 달리 표현한 것에 불과하다. 그러므로,
그 같은 연역추리는 아무런 새 정보를 제시하지 못한다. 하지만, <추리 2>
와 같은 귀납추리의 결론은 비록 틀릴 위험성은 있다고 해도, 새로운 지식내용을
제공하고 있다. 이렇게 귀납추리는 새로운 정보내용을 지니므로 지식확장적 추리이기도
하다. 그리고 분석성 논쟁에서도 보여진 바와 같이 타당한 연역추리에서는 전제를
인정하고 결론을 부정하면 논리적 모순에 빠지지만, 올바른 귀납추리에서는 그 전제들을
인정하고 결론을 부정해도 모순이라고는 할 수 없으며 다만 불합리하다고 평가할
수 있을 뿐이다. 그러므로 귀납추리는 타당한 연역추리를 근거로 한 합리성보다도
그 합리성의 개념을 확장하였다고 하겠다. 그러므로 귀납추리는 진리확장과 지식확장뿐
아니라 합리성 확장의 추리로도 볼 수 있다.
귀납추리가 비논증적이며 진리확장적
추리라는 것은 이미 널리 알려져 있다. 그러나 그것이 '비가법적' (non-additive)
추리의 성질을 가졌다는 것은 비교적 최근에 논의된 것이므로 생소한 감이 있다.
이 추리 방식을 이해하기 위해서는 그 명칭의 자구 (字句) 풀이만으로는 부족하다.
그 명칭은 기존의 전제에다 새로운 어떤 전제를 추가해도 결론이 여전히 진리일 수
있는 가법 (加法, additive inference) 으로부터 유해되었다. 예컨대, 명제 p 로부터
명제 p∨q 를 도출하는 추리는 가법적이다. 명제 q 가 참이든 거짓이든 상관없이
결론이 참이기 때문에 어떤 명제든지 추가할 수 있다는 의미로 가법적이다. 그러나
p 로부터 p∧q 를 추가하면 거짓이 될 수도 있기 때문에 이런 추리는 비가법적이라고
한다. 즉, q 의 진리치가 거짓이면 이에 따라 결론의 진리치도 거짓이 되므로 자유롭게
전제를 추가할 수 없다.
앞의 두 추리에다 '2-1 : 그 교실 학생들의 시력검사
결과가 모두 시력 1.2 로 나타났다' 를 새 전제로 추가했다고 하자. <추리 1>
의 경우는 그 새 정보의 추가가 결론의 진리치에 아무런 영향을 주지 못한다. 그러나
<추리 2> 와 같은 귀납추리에서는 새 정보에 민감하여 그 교실학생 10명 중
8명이 안경을 쓰고 있다는 결론을 크게 수정해야 한다. 대체로 학생들이 안경을 쓰는
경우는 근시인 경우이며 시력이 1.2 정도면 안경을 안 쓰는 것이 통례라는 배경적
지식과 결부되므로, 결론은 급전하여 그 교실 학생 대부분이 안경을 안 쓰고 있는
것이 합리적일 것이다. 그러므로 우리는 귀납추리의 '비가법적' 인 성질을, 새 정보를
첨부하면 결론의 진리치가 변화될 수 있다고 '정보가변적' 이라고 생각하면 의미가
분명해질 것이다.
지식의 성장이 특히 비가법적 귀납추리에 의해 수행되므로 단조롭지
않고 역동적으로 전개된다. 이런 관계로 연역추리와 같은 것을 단조적추리 (monotonic
reasoning) 라고 하는 데 반해 비가법적 귀납추리는 비단조적 추리 (non-monotonic
reasoning) 라고도 한다. 특히 이 논리는 오늘날 상식추리를 가능하게 하는 인공지능
개발과 더불어 다각적으로 연구되고 있다.
우리가 이처럼 귀납추리의 기본성질을
비존증적ㆍ확장적ㆍ비가법적인 것으로 규정한다면, 지금까지 귀납추리로 간주되어
오던 것들 중에서 그런 성질을 갖지 않은 것이 있음을 발견하게 될 것이다. 귀납논리는
아리스토텔레스 이래로 개체들로부터 일반원리를 이끌어내는 추리, 또는 특수에서
보편을 도출하는 추리로 간주되어 왔다. 아리스토텔레스가 들고 있는 예를 생각해
보자.
|
<추리 3> |
|
3. 그러므로, 담즙이 없는 동물은 오래 산다. |
이 추리는 특수에서 보편을 추리한 것이며 비논증적ㆍ확장적ㆍ비가법적이라고 할 수 있으므로, 그 전제들의 참거짓을 논하기 이전에 귀납추리의 성질을 지닌다고 하겠다. 그러나 이런 추리형식의 예를 근거로 삼아, 특수 표본 (sample) 으로부터 보편 모집단 (population) 에로의 추리를 모두 귀납추리라고 한다면 반증사례가 나타난다.
|
<추리 4> |
|
그러므로, 이 열차 안 모든 사람은 차표를 갖고 있다. |
이와 같은 완전매거에 의한 귀납법은 분명히 개별적
표본으로부터 그 모집단을 추리한 것이지만 논증적이고 비확장적이며 가법적이기
때문에 오히려 연역추리로 보아야 할 것이다. 우리가 '수학적 귀납법' 이라고 지칭해
온 것들도 실은 연역법임을 알 수 있다. 예컨대, 1 + 3 + 5 + … + (2n - 1) = n2
이 성립되는 것을 수학적 귀납법에 의해 증명하는 경우는 다음과 같다.
|
1. n = 1 이면 1 = 12 이므로 성립한다. |
|
4. 따라서 1 + 3 + 5 + … + (2k - 1) + (2k + 1) = k2 + 2k + 1 이 성립한다. |
|
5. 그러므로 1 + 3 + 5 + … + (2n - 1) = n2 은 성립한다. |
이 수학적 귀납법에서는 1, 2, 3 의 전제가 참이면
결론이 필연적으로 참이므로 논증추리이고 비확장적이기 때문에 수학적 귀납법은
연역법이라고 하겠다. 다른 한편, 퍼스의 상정논법 (abduction) 을 한슨은 연역법도
아니고 귀납법도 아닌 제 3 의 논리, 즉 발견의 논리라고 하지만, 위의 귀납법 규정에
비추어 보면 그것은 확장추리이며 비논증적ㆍ비가법적이기 때문에 귀납추리의 일종이라고
하겠다.
그런데 발견의 맥락을 주도하는 귀납추리는 우리가 그렇게 실제로 추리한다는
기술적 의미의 것과 우리가 마땅히 그렇게 추리해야 한다는 규범적 의미의 것으로
구분된다. 전자는 우리가 현실세계에서 여러 가지를 지각하며 추리해 가는 '지각추리'
(perceptual inference) 에서 나타난다. 갓난애가 어머니의 젖을 빨면ㅅ 어머니를
익혀가는 데서 비롯되는 경험학습으로부터, 역사에서 교훈을 얻는 등의 고등추리에
이르기까지 귀납추리를 하여온 흔적은 수없이 많다. 이들을 '자연적 귀납법' 또는
'자생적 귀납법' 이라고 하겠다. 이들은 논리법칙에 의해서가 아니라 인과관계와
같은 자연법칙에 의해 지배된다. 발견의 영역에서 기술의 영역과 교집합인 구역들
(I, 9, 11, 12) 은 모두가 인과적 자연법칙에 의해 설명될 수 있는 영역이다. 이에
반해 발견의 규범은 심리적 기대나 습관적 의미의 귀납추리가 아니고 귀납논리를
말하게 된다. 우리가 지식의 성장을 논하기 위해서는 인과적 지각추리와 논리적 규범
추리, 이 두 가지 측면을 모두 검토해야 할 것이다.
플라톤 이래로 철학자들이 학습에 관심을 둔 까닭은 인간의 학습활동 안에서 지식의 본질이 밝혀지고 지식이 어떻게 성장하는지를 이해할 수 있을 것이라는 인식론적 기대 때문이었다. 앞서 논한 귀납추리를 비롯한 각종 발견의 맥락도 결국 지식을 증대하는 학습의 맥락 속에 포섭된다. 만약 누가 우리에게 인간의 지적 활동을 꼽아보라고 한다면, 우리는 새로운 지식을 취득하고 기존의 지식들을 조직할 수 있는 기술과 방법을 습득하는 학습활동을 빼놓을 수 없을 것이다. 다시 말하면, 학습활동을 할 수 있다는 것은 인간이 참다운 지성을 갖기 위한 필요조건이다. 그리하여 컴퓨터로 하여금 인간의 지적 활동을 수행하게 하려는 AI 분야에서도 이 학습의 문제는 일찍부터 관심의 초점이 되어 왔다.
학습의 문제는 1950년대 중반 AI 초기부터 논의되었으나 당시는 수치표기에만 한정했고 기호적 표현이나 휴리스틱 (huristic) 방법까지는 이르지 못했다. 사람들에게는 환경에 적응하기 위해 자신을 수정하고 조직화하는 시스템이 매력적이었다. 하지만 사태가 너무 복잡해서 그런 매력적인 시스템을 산출하려는 낙천적 기대는 실패하였다. 1960년대 중반부터는 특정한 제약조건 아래서 탐색하는 데에 지식이 어떤 역할을 하는지 이해하려고는 하였으나, 학습문제는 AI 의 고유과제로부터 떠나는 듯하였다. 그러나 1970년 후반에는 개념학습과 언어습득에 관한 연구가 다시 계속되었다. P. H. Winston 등은 높은 수준의 개념들을 파악하는 학습은 아무런 지식 없이 출발해서 성취될 수 있는 것이 아니라고 생각했다. 그리하여 그는 개념학습을 중시하였으며 대량의 지식영역과 학습시스템을 연결하려는 시도를 했다. 이 단계까지는 학습자에게 새 지식을 주입하고 학습자는 사태에 대한 아무 가설없이 받아들이는 '암기식 학습' (rote learning) 과 여러 예제들로부터 보다 일반적 규칙들을 가정하는 '예제로부터의 학습' (learning from examples : LFE) 이 주류를 이루었다.
그러나 최근 전문가 시스템에서는 학습자에게 주어지는 고위수준의 추상적 충고를 그가 직면한 특수상황에로 해석할 때, 생략된 세부사항들을 채우는 가설을 설정하면서 배우는 이른 바 '충고수용식 학습' (learning by being told) 을 연구하고 있다. 뿐만 아니라 사태들 사이의 유비성 을 발견해서, 이를 당면한 과제수행을 위해 유비규칙에로 이행하는 가정설정을 통해 배우는 '유비에 의한 학습' (learning by analogy) 등도 학습 유형에 포함되고 있다.
1980년대 이후 기계학습 (machine learning) 의 연구가 활기있게 전개된 까닭은 우선 네 가지로 풀이될 수 있다. 첫째는 학습절차를 잘 이해하면 전문가 시스템 구성의 자동화를 촉진시킬 수 있고, 그 결과로 AI 을 급속도로 발전시킬 수 있으리라고 기대하기 때문이다. 둘째는 이론적 요구 때문이라고도 한다. 전문가 시스템들은 과학을 할 때 필수적으로 요구되는 이론의 일반성을 결여하고 있으므로 이를 보완하기 위한 것이었다. AI 가 문제해결이나 탐색분야에서 발견한 일반원리와 유사한 일반성을 기계학습의 영역에서도 취하고자 한 것이다. 셋째는 인간의 학습절차를 모델화하려는 것이다. 이것은 인간의 정보처리 시스템의 다양한 특색을 설명할 수 있는 한 방도가 될 것이다. 인간의 학습절차를 깊이 이해하면 우리의 교육 개선에도 크게 공헌할 것이다. 기계학습과 인간학습의 비교연구는 이런 점에서도 우리의 지대한 관심사가 아닐 수 없다. 넷째로 기계학습의 문제는 지식표현과 추리의 경우에서처럼 인식론적인 철학문제들에만 아니라, 문제해결, 정리증명, 유추추리, 비단조추리, 자연언어처리, 화법인지, 비전, 로봇, 기획, 게임 실행, 패턴 인지, 전문가 시스템 등 AI 의 모든 분야에 관련되어 있다. 그리하여 오늘날 기계학습은 AI 전반에 관련된 핵심문제로서 연구되고 있다.
구체적인 기계학습들에서 서로 다른 프로그램들은 각기 다른 철학적 근거와 연관되어 있다. 그 중에서 우선 우리의 관심사가 되는 것은 경험주의 철학의 귀납추리를 바탕으로 하는 '예제로부터의 학습' 과 합리주의 철학의 연역적 방법을 활용하는 이른 바 '설명기반의 학습' (explanation-based learning : EBL) 이다. 그리고 최근 새로운 전산기술과도 긴밀히 연관하여 개발되는 학습의 연결주의 모델 (connectionist models) 도 중요한 연구분야로 간주된다.
경험주의 철학을 근거로 하는 '사례들로부터의 개념학습' (learning concepts from examples) 은 Learning from Example (LFE) 의 기계학습으로 널리 연구되었다. LFE 는 어떤 개념의 긍정적 사례와 부정적 사례들로부터 그 개념의 내포적 정의를 산출하는 학습이다. 이것은 인간이 일련의 관찰사례들로부터 귀납추리에 의해 그 관찰사례들을 조직화할 개념을 취득하는 과정과 흡사하다. 이렇게 얻은 개념을 사용하여 우리는 미래 경험들을 분류할 수 있다.
LFE 의 한 가지 방법으로서 특수로부터
일반을 탐색하는 예를 검토해 보자. 아래 그림 2 는 특정한 질병에 걸린 세포와 건강한
세포의 그림이라고 가정한다. 그 병의 양성반응을 보이는 세포는 P1,
P2, P3
이고 음성반응을 보이는 세포는 N1 과 N2
이다. 각 세포는 두 개의 몸을 가졌으며 색깔은 밝은 것과 어두운 것으로 되어 있다.
이 특수 사례들로부터 그 병의 양성반응을 보이는 세포의 일반성을 탐색해 내는 학습이
어떻게 가능할 것인가?
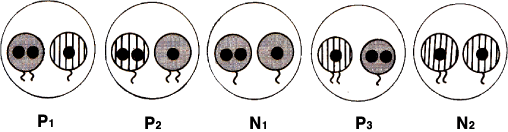
그림 2
물론 이 사례들로부터 일반성을 추구하는 방법은 많으나, 쉽게 이해할 수 있도록 단순화하여 특수에서 일반에로의 방법에서부터 시작한다. 위 그림의 사례들이 학습자에게 증분식 (incremental fashion) 으로 제시되었다고 하자. 개별적으로 사례들을 제시하고 그 다음에는 그에 작동하는 가설들이 음미되는 순서로 진행된다. 여기서 증분적이라 함은, 학습자가 그 사례들을 한 번에 하나씩 제공받을 뿐만 아니라 새 사례를 편입할 때에는 그 전에 다룬 사례들을 다시 처리하지 않음을 의미한다. 이 방법을 좀더 일반화하면, 각 사례가 배움의 단계로 인도된다는 경험주의적 발상이다.
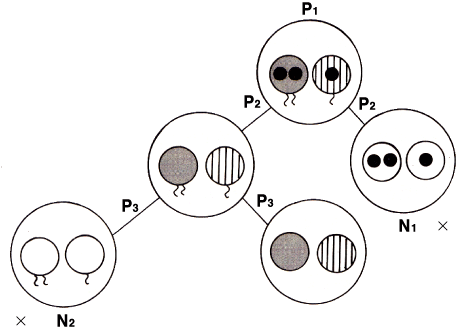
그림 3
최초의 가설은 첫 번째 양성반응의 사례 P1 으로부터 출발한다. 위의 그림으로부터 P1 을 관찰하고 나서 그림 3 과 같은 가설 H1 을 설정한다.
H1 : 양성반응세포는 '핵 두 개 검은 색 꼬리 두 개짜리 몸체 하나'와 '핵 하나 회색 꼬리 하나짜리 몸체 하나', 이렇게 두 개의 몸체로 구성되어 있다.
이 기술은 너무 특수하기 때문에 오직 하나의 사례만을 포함한다. 두 번째 사례 P2 에 직면하면 가설 H1 이 맞지 않으므로 P1 과 P2 를 포괄하는 보다 일반적 가설로 대치해야겠다는 암시를 받게 된다. 여기서 두 가지 가설을 설정하게 된다. 하나는 핵의 수를 무시한 가설 (H2) 이고 다른 하나는 색깔과 꼬리를 무시한 가설 (H3) 이다.
H2 : 양성반응세포는
'검은 색 꼬리 두 개의 몸체 하나' 와 '회색 꼬리 하나의 몸체 하나', 이렇게 두
개의 몸체로 구성되어 있다.
H3 : 양성반응세포는
'핵 두 개의 몸체' 와 '핵 하나의 몸체' 로 구성되어 있다.
이렇게 되면 H3 는 P1 와 P2 라는 양성반응세포간의 공통성이 된다. 그러나 H3 는 음성반응의 사례 N1 과도 일치하므로 폐기되어야 한다. 그리고 남은 가설 H2 를 계속 검토하기로 한다. 가설 H2 는 다시금 세포 몸체의 꼬리만을 지적하는 가설 H4 와 그 색깔만을 고려하는 가설 H5 로 분리된다.
H4 : 양성반응세포는
'꼬리 두 개의 몸체 하나' 와 '꼬리 한 개의 몸체 하나', 이렇게 두 개의 몸체로
구성되어 있다.
H5 : 양성반응세포는
'검은 색 몸체 하나' 와 '회색 몸체 하나' 로 구성되어 있다.
그러면 H4 는
음성반응세포 N2 와도 일치하므로 폐기하여야
한다. 이런 검토를 하고 나면 남는 것은 가설 H5 이다.
이것은 양성반응세포 P3 와 일치하여 모든
양성반응세포에 공통되는 일반성이며 음성반응세포에는 없는 성질이므로 채택된다.
이리하여 '어떤 세포가 그 두 몸체 색깔이 다르면 그 세포는 그 병의 양성반응세포다'
라는 가설이 가장 일반적 원리라는 개념을 형성한다.
개별사례들로부터 일반원리를
추구해 가는 이러한 기계적 방식은 존재표와 부재표를 작성하여 인과관계를 구명하려던
베이컨의 제거에 의한 귀납법 (induction by elimination)을 적용한 것이다. 특히
폰 브리히트가 밀의 귀납법 중에서 일치법과 차이법을 베이컨의 제거적 방식으로
재해석한 것과 비교된다. 이 귀납방법에 의하면 1) 결과 E 가 나타났을 때 없었던
성질은 E 의 필요조건이 될 수 없고 2) 결과 E 가 나타나지 않았을 때 있었던 성질은
E 의 충분조건이 될 수 없다. 이러한 방법론적 원리에 의거하여 위의 예를 검토해
보자. 여기서 알고자 하는 질병의 원인으로부터 결과된 것, 긍정적 사례의 존재표는
양성반응세포들로 이루어지고 그렇지 않은 부정적 사례의 부재표는 음성반응세포들을
모은 것이다. H3 와
H4 가 제거된 절차는 결과가 나타나지 않았을
때 (음성반응의 사례들에서) 있었던 성질이므로, 2)에 의거하여 충분조건이 될 수
없다는 이유로 제기되었다고 풀이된다. 그리고 H5 가
채택된 것은 밀의 일치법에 의거한 것이라고 할 수 있다. 즉, 탐구하려는 현상의
두 개이상의 사례들 가운데서 어느 한 가지만을 공통으로 지닌다는 일치법에 의거하면,
두 몸체 중 하나는 검고 하나는 회색이라는 것이 모든 양성반응을 보인 세포에서
일치하기 때문이다.
특수사례에서 일반개념을 형성한 것과 유사한 방법으로 일반에서
특수에로 진행하며 개념형성을 할 수도 있다. 특수 → 일반 방법에서는 새 사례들이
새 가설에로 이끌기도 하고 때로는 기존 기술들을 제거하기도 하였다. 그러나 일반
→ 특수의 접근방법에서는 긍정사례와 부정사례의 역할이 역으로 수행된다. 간략하게
설명하기 위해, 색깔은 모두 같다고 하고 그림 4 와 같은 두 개의 양성반응세포와
두 개의 음성반응세포가 주어졌다고 하자.
그림 5 에서 제시되듯이, 이 접근방식은
가설 1 과 같이 가능한한 가장 일반적 가설에서 출발한다.
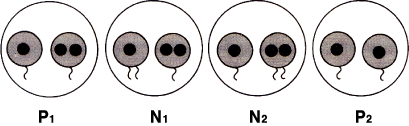
그림 4
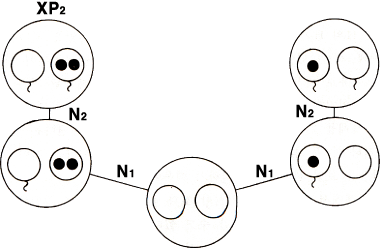
그림 5
가설 1 양성반응세포는 '두 개의 몸체' 로 구성되어 있다.
이렇게 아무런 특성도 부여하지 않게 되면 모든 세포가 포함되며 따라서 양성반응세포 1 도 그림 맨 아래에 표시했듯이 가설 1 에 속한다. 이 단계에서는 배우는 바가 없으나 양성반응 사례로부터 시작하면 성공적으로 탐색할 수 있다.
가설
2 양성반응세포는 '꼬리가 하나인 한 몸체' 와 '핵이 두 개인 다른
한 몸체' 로 구성되어 있다.
가설
3 양성반응세포는 '핵 하나와 꼬리가 하나인 몸체' 로 구성되어 있다.
음성반응 사례 N1 을 피하기 위해 가설 2 와 3 을 설정했다. 즉, 꼬리가 둘이라는 성질은 양성반응에 없었던 것이므로 제거원리 1)에 의해 필요조건이 될 수 없고 음성반응에 있으므로 제거원리 2)에 의해 충분조건이 될 수 없기 때문에 제거된다. 그런데 아직 분명한 개념에 이르지 못했으므로 다시금 음성반응 사례 N2 를 피하기 위해 가설 4 와 5 를 다음과 같이 설정한다.
가설 4 양성반응세포는 '꼬리 하나인 몸체' 와
'핵 두 개고 꼬리 하나인 몸체' 로 구성되어 있다.
가설 5 양성반응세포는 '핵
하나와 꼬리 하나인 몸체' 와 '꼬리 하나인 몸체' 로 구성되어 있다.
이렇게 가정하고 나면 가설 4 는 양성반응 사례
P2 에 없었던 성질이므로 필요조건이 될 수 없어서 폐기된다. 그러나
가설 5 는 앞으로 새 사례의 발견으로 수정될 수 있을지라도 현단계에서는 가장 유력한
가설로 남게 된다.
이같은 개념형성 학습에서는, 대체로 주어진 모든 사례들이
파악하려는 목표 개념과 관련하여 보건대, 그 긍정적 검증사례들과 부정적 반증사례들로
명확히 구분된다는 것이 가정되어 있다. 이러한 초기 학자들의 가정은 정선된 자료들을
제공하는 교사가 없는 실제 세계에서는 적용되기 어렵기 때문에, 그 적용범위가 너무나
제한되게 마련이다. 뿐만 아니라 위에 작용하고 있는 일치법도 확장추리이므로 그
질병의 원인이 여러 현상의 복합으로 이루어질 경우는 인과관계가 잘못될 수 있는
위험을 물론 지니게 된다. 그리고 제거원리에 작용하는 차이법도 '검토되는 요인을
제외하고 나머지는 모두 똑같다' 는 가정을 해야 하는데, 실제로 사례 추출에서는
그런 통제가 불가능할 경우도 많다. 그리하여 새로운 학습 시스템을 구성하기 위해서
우리는 사례들이 규정되지 않았거나 부분적으로 규정된 것 또는 불확실하게 규정된
경우에도 탐구를 계속할 것이다. LFE 모형에 작용하는 귀납추리가 지닌 확률적 성질의
의미와 증거사례들의 적절성의 문제는 IV 장 5 절에서 좀더 상세히 다루고자 한다.
또한
학습체계에 따라 추구하는 개념유형이 서로 다른 경우가 있을 수 있다. 그 대표적
유형으로는 식별개념 (discriminant concepts) 과 특성개념 (characteristic concepts)을
꼽을 수 있다. 식별개념이란 그 개념기술이 그에 속하는 모든 사례들을 그 체계 안의
다른 개념들의 사례들과 식별해 낼 수 있는 검사방법들을 기술한 것이다. 이에 반해
특성개념은 그 개념기술이 간결하고 세련되어 의사소통에 유용하도록 그 개념의 특성만을
서술한 것이다. 예를 들어, 프레임과 같은 특성개념은 정확성이 결여될 수 있으므로
엄밀한 식별기준에 부응하지 못할 경우가 있다.
다음에는 분석적 방법을 기반으로 하여 지식성장을
꾀하는 학습으로서 '설명기반의 학습' 을 살펴보자. 최근 널리 연구되는 EBL 은 LFE
에서처럼 많은 사례가 없어도 소수의 예제만으로, 때로는 단 하나의 사례를 갖고도
학습할 수 있다는 장점이 있다. 그대신 이런 학습을 하기 위해서는 논의 영역에 관한
풍부한 이론 (domain theory) 과 이전의 문제 해결의 성패나 개념형성 등에 관한
배경 지식 (background knowledge) 이 있어야 한다. 그리하여 우리가 LFE 를 자료집약적
(data intensive) 이라고 한다면 EBL 는 지식집약적 (knowledge intensive) 이라고
하겠다. EBL 의 사상적 배경은 '한 영역에서 풍부한 지식을 갖게 되면 그 영역에
관한 추가 지식을 용이하게 취득할 수 있다' 는 관념이다.
설명기반의 학습절차는,
1) 주어진 사례가 목표개념의 한 실례가 되는 까닭을 설명할 수 있도록 구성함으로써
학습하게 되고, 2) 그 설명을 목표개념에 도달하도록 일반화함으로써 목표개념은
단 하나의 사례에 의해서도 형성될 수 있다.
다음의 두 이야기는 디죵 (DeJong)
과 그의 제자 무니 (Mooney) 가 자연언어처리에서 학습도식 (schemata) 을 얻게 되는
설명기반의 학습을 보이고자 제시한 한 예이다.
<이야기 1>
Fred 는 Mary 의 아버지이고
백만장자이다. John 이 Mary 에게 접근해 그녀에게 총을 겨누고 그의 차에 타라고
말했다. John 은 그녀를 그의 호텔방에 데리고가 감금하고 Fred 에게 전화하여 그가
그녀를 잡아놓고 있다고 말했다. Fred 가 Treno 에서 25만불을 그에게 주면 Mary
를 놓아주겠다고 말했다. Fred 는 John 에게 그 돈을 주었으며 John 은 Mary 를 풀어주었다.
<이야기 2>
Ted 는 Alice 의 남편이다.
그는 복권에 당첨되어 10만불을 얻었다. Bob 은 Alice 를 그의 지하실에 감금하였다.
Bob 은 Ted 로부터 7만 5천불을 받고 Alice 를 풀어주었다.
가령 <이야기 1> 로부터 우리가 설명기반의
학습을 한다면 특정한 인물의 이름과 같은 세부적인 것을 설명에서 우연적인 것으로
간주해서 제거하고 일반화해야 한다. 여기에서 결과된 도식은 그 설명의 인과적 구조를
보존하는 데 필요한 제약조건들 (constraints) 이 되며 그것은 '납치' 를 이해하는
일반 도식으로서 기여하게 된다. 그리고 이렇게 배운 도식을 이용하여 <이야기
2> 와 같은 약식 이야기도 납치로서 이해하게 된다. 따라서 하나의 개념은 명제들의
집합에만 국한되는 것이 아니라 하나의 데이터 구조 (data structure) 이다. 이 점은
우리의 인식구조를 이해하는 데 매우 중요한 착상이기도 하다. 데이터 구조는 명제들의
체계에서는 일어나지 않는 절차들을 대량 정보의 결합을 통해 가능하게 한다고 보기
때문이다.
EBL 에 대한 비교적 통일된 접근방식은 미첼 (Mitchell) 과 케다-카벨리
(Kedar-Cabelli) 가 기술한 설명기반의 일반화 (EBG) 이다. 여기서 설명은 증명과
동일시된다. 입력되는 것은 목표개념 (target concept, goal concept), 설명 구성의
이론, 사례, 기술한 바를 유용하게 정의하도록 하는 조작가능성의 기준 (operationality
criterion) 등이다. 여기서 개념은 사례들에 대한 술어로 간주되며 사례들의 집합을
지칭한다. 미첼 등이 목표개념으로 하는 SAFE-TO-STACK(x, y) 의 실례를 갖고 그
기본사상을 검토해 보면, 다음의 네 가지가 주어져 있다는 데서 출발한다.
1) 목표개념정의 (target concept definition)
배워야
할 개념은 기술하는 개념정의이며 여기서 이 개념정의는 조작가능성의 기준을 만족시키지
못하는 것으로 다음과 같이 정의한다.
SAFE-TO-STACK(x, y) iff NOT(FRAGILE(y) or LIGHTER(x, y)
2) 훈련 실례 (training example)
목표개념의
실례로서 다음이 지적된다.
ON(OBJ1, OBJ2)
ISA(OBJ1, BOX)
ISA(OBJ2,
ENDTABLE)
COLOR(OBJ1, RED)
COLOR(OBJ2, BLUE)
VOLUME(OBJ1, 1)
DENSITY(OBJ1,
0.1)
3) 영역이론 (domain theory)
훈련 실례가 어떻게
목표개념의 실례가 되는지를 설명하는 데 사용되는 규칙들과 사실들의 집합을 영역이론이라고
하며 다음과 같다.
VOLUME(p1, v1) and DENSITY(p1, d1) → WEIGHT(p1,
v1,* d1)
WEIGHT(p1, w1) and WEIGHT(p2, w2) and LESS(w1, w2)
→ LIGHTER(p1, p2)
ISA(p1, ENDTABLE) → WEIGHT(p1, 5) [default]
LESS(1,
5)
4) 조작가능성 기준 (operationality criterion)
개념정의들에
대한 술어로서, 학습된 개념정의가 표현되어야 할 형식을 규정한다. 실례를 기술하는
데 사용되는 술어는 VOLUME, COLOR, DENSITY 등이며 영역이론으로부터 선발된 다른
술어는 LESS 와 같은 것이다.
위의 네 가지가 입력되어 주어졌을 때 목표개념에 대한 충분한 개념 기술과 조작성 기준을 만족시키는 훈련 실례를 일반화한다. EBL, 특히 문제해결 일반을 밝히는 구조설계는 그림 6 과 같이 종합해 볼 수 있다.
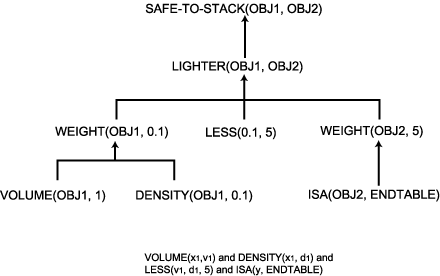
그림 6
여러 가지 유형으로 제시되는 EBL 은 연역적 방법을 활용한다. 그러나 지식의
성장에서 연역법이 과연 어떤 도움을 줄 수 있는가 하는 의문이 제기될 법하다. 왜냐하면
연역법은 전제에 있던 것을 결론으로 이끌어내야 하는 것, 다시 말하면, 전제의 참을
결론으로 이행시키는 진리이행의 추리이므로 새로운 지식을 추가하지 못하는 것으로
간주되기 때문이다. 이러한 반론은 연역추리이므로 새로운 지식을 추가하지 못하는
것으로 간주되기 때문이다. 이러한 반론은 연역추리의 타당성 개념을 근거로 한 것이다.
물론 그것이 지식내용의 비확장적 추리라는 점만을 보면 정당하다고 하겠다.
그러나
오늘날 AI 에서 지식의 성장을 논할 때 지식의 개념은 앞에서도 지적되었듯이 '정당화된
참된 믿음' 이라는 전통적 의미의 지식이 아니라 문제해결의 도구라는 특성으로 풀이되었다.
우리가 알려진 바를 토대로 하여 알려지지 않았던 것을 알아내기 위해서는, 이미
알았던 것을 조직화하고 그것들로부터 필연적으로 도출되는 바가 무엇들인지를 확인할
필요가 있다. 어떤 개인이나 집단에서 문제해결에 활용될 수 있는 지식과 그럴 수
없는 지식의 구분은 그들의 정보내용에만 의존하는 것이 아니다. 동일한 내용물의
지식일지라도 산만한 상태에서는 문제해결에 쓸모없던 것이, 조직화ㆍ체계화되면
유용해질 수 있다. 그리고 그 내용의 구조체계만으로는 해결할 수 없었던 문제가
그 체계로부터 도출되는 바를 보여줌으로써 많은 문제들을 해결할 수도 있다. 그러므로
문제해결을 지식평가의 기준으로 삼는다면, 비록 지식내용이 동일한 것으로 평가될지라도,
지식이 되는 것도 있고 지식이라고 할 수 없는 것도 있게 마련이다. 이른 바 '산지식'
이란 쓸모있는 지식, 문제를 해결할 수 있는 지식이다. 그러므로, 비록 연역법이
진리확장을 못한다고 하더라도, 산지식을 증대하는 데 크게 기여할 수 있다. EBL
은 바로 그러한 문제해결의 지식을 증대하는 것을 목표로 삼는다.
끝으로 연결주의의 학습모델을 살펴보자. 연결주의자들은
뇌가 시냅스들에 의해 서로 연결된 뉴런으로 구성된 점을 모방하여 신경망조직 (neural
networks) 에 의해 학습하는 프로그램을 구성하고자 한다. 연결주의에서 기본이 되는
전산적 요솔는 단위들 (units) 이다. 단일 단위나 단위들의 작은 그룹은 하나의 기호나
특성 또는 개념과 같은 지식의 부분들을 표현한다. 단위들은 내부의 잠정적 수준이나
활동적 수준을 유지한다. 단위들은 다른 단위들과 연결되어 메시지를 주고받게 된다.
가령 '흰', '노란', '구두', '모자' 라는 개념이 어느 한 시스템에 주어졌다고 하자.
첫째는 '흰' 과 '구두' 를 연결하고 '노란' 과 '모자' 를 연결한다. 이 과제를 '엮는
문제' (binding problem) 라고 한다. 다음에는 '혼선이야기 문제' (cross-talk) 라는
것이다. 이것은 '흰' 과 '모자' 를, 그리고, '노란' 과 '구두' 를 연결하지 못하도록
방해하는 것을 말한다. 이같이 작용하는 망조직 내에서 개개의 연결링크들은 연결단위들의
연결강도를 표현하는 비중 (weight) 을 갖게 된다. 연결주의의 학습은 그 비중을
바꾸어 조정하거나 연결관계를 추가 또는 제거하여 그 망조직의 전반적 실행을 개선하는
것을 의미한다. 따라서 전형적인 AI 프로그램에서처럼 개념들은 확인할 수 있는 데이터
구조가 아니고 다중의 단위들에서 활동하는 패턴들이다.
다음의 3층의 망조직
(3-layer network) 은 지극히 단순하고 추상적인 사례이지만 연결주의의 기본사상을
이해하는 데 도움이 될 것이다.
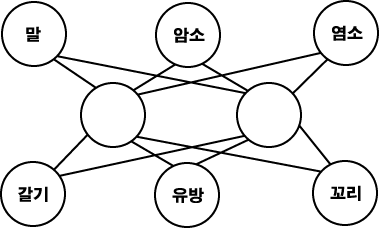
그림 7
그림 7 에서 이 망조직의 목적은 말, 염소, 암소를
식별하는 것이다. 이 표본 동물들의 특성은 갈기머리털, 유방, 꼬리를 가진 것이라는
입력단위를 작동함으로써 그 망조직이 활동하게 된다. 이 망조직의 결정된 바를 나타내는
최상의 출력층은 단위들의 작동 여부로 그 중의 어느 한 동물을 확인하는 방식으로
풀이된다. 이 망조직은 특성 표본들을 입력단위에 제시하여 바른 출력 단위들이 이루어졌는지를
비판적으로 탐색하도록 훈련받게 된다. 가령, 그림 7 에서 갈기머리 털과 꼬리 단위들에
작용한다면 말이라는 단위가 작동해야 할 것이다. 그러나 만약 잘못되었다면 후향전파기제
(back propagation algorithm) 가 사용된다. 입력층과 은닉 단위들 (hidden units)
사이의 연결선의 비중들, 그리고 출력층과 숨은 단위들 사이의 연결선의 비중들이
조작된다. 여기서 우리가 주목할 점은 정보들이 특정한 규칙에 의해 저장되는 것이
아니라 그 망조직에 일어나는 활동패턴들 (activation patterns) 과 연결들에로 분배된다는
것이다.
연결주의 학습모델은 분명히 학습에 관한 새로운 사고의 길을 제공했으며
병렬처리 (parallel distributed processing, 약칭 PDP) 방식의 하드웨어로 프로그램을
수행하는 새로운 방법을 제공하였다. 그러나 아직은 제한된 분야의 학습에서만 성공했을
뿐이고 연결주의가 기계학습의 주류를 이룬 것은 아니다. 옳은 경우와 그른 경우에
관한 명확한 피드백을 할 수 있는 때에 한정하여 본다면, 연결주의는 사례들로부터의
학습 (learning from examples) 과 같은 것을 다루는 데 성공했다고 하겠다. 그러나
지도감독이 없는 상태에서의 발견 (unsupervised discovery) 이나 앞서도 논의되었던
설명기반의 학습의 경우에서는 연결주의가 전통적 AI 프로그램의 성공을 따라가지
못하였다.
PDP 를 기반으로 한 연결주의 사상의 뿌리를 내린 사람은 신경과학자
잭슨 (Jackson) 과 루리아 (Luria) 이다. 잭슨은 19세기말 신경과학이 단순국지주의적
신조 (the simplistic localizationist doctrines) 에 기운 것을 비판하고 처리절차의
다층배분사상을 표명하였으며, 루리아는 동적 기능체계의 개념을 제창한 바 있다.
이러한 신경과학의 사상을 철학적 논리사상과 연결하여 1943년 발표한 맥쿨로크 (W.
S. McCulloch) 와 피츠 (W. Pits) 의 논문 "A Logical Calculus of the Idea
Immanent in Nervous Activity" 에 이르러 신경망의 사상은 한층 더 구체화되었다.
이 논문은 우리가 III-6 에서 검토한 카르납의 인공언어II 를 전적으로 활용하고
있다. 특히 카르납은 사이먼 (H. Simon) 과 피츠라는 두 제자를 통해 현대 인공지능의
양대진영에 다 같이 영향을 주고 있다고 글리머가 지적한 것도 이러한 관계를 포함해서
하는 말일 것이다.