Clustering
Pattern Recognition and Image Analysis : Earl Gose. Richard Johnsonbaugh. Steve Jost 저서, Prentice Hall, 1996, Page 199~219
구분하려고 하는 각 class에 대한 아무런 지식이 없는 상태에서 classify하는 것이므로 unsupervised learning에 해당한다. 즉 sample들에 대한 지식없이 similarity (유사도) 에 근거하여 cluster 들을 구분한다. 패턴 공간에 주어진 유한 개의 패턴들이 서로 가깝게 모여서 무리를 이루고 있는 패턴 집합을 cluster (군집) 이라하고 무리지워 나가는 처리 과정을 clustering 이라 한다.
cluster 간의 유사도를 평가하기 위해 여러 가지의 거리 측정 함수를 사용하는데 예를들면 Euclidean distance, Mahalanobis distance, Lance-Williams distance, Hamming distance 등이 사용된다.
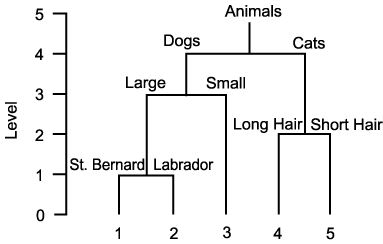
hierarchy 는 다음 그림과 같이 tree 구조로 표현될 수 있다. 동물 병원에서 환자들은 크게 개와 고양이로 구성되며 각자 subgroup 으로 나눠지며 그것은 다시 subgroup 으로 나눠진다. 각개의 동물은 1 ~ 5 로 구분되며 가장 아래에 위치한다. hierarchical clustering 은 data를 많은 작은 그룹으로 구성되는 큰 그룹을 구성하는 과정을 의미한다. 흔히 tree 나 dendrogram 으로 그려서 표현하며 가장 미세한 그룹은 가장 아래에 위치하며 각 sample 은 하나의 cluster를 형성한다. 가장 큰 그룹이 제일 위에 위치하며 각 sample 들은 하나의 cluster 그룹에 속한다.
위의 그림에서 level 에 따라 다음의 sample 들로 구성되는 cluster 로 구성된다.
level 0 : {1}, {2}, {3}, {4}, {5},
level 1 : {1, 2}, {3}, {4}, {5}.
level 2 : {1, 2}, {3}, {4, 5}.
level 3 : {1, 2, 3}, {4, 5}.
level 4 : {1, 2, 3, 4, 5} : 하나의 cluster 로 구성된다.
hierarchical clustering 에서는 어떤 level 에 하나의 cluster 에 속하는 두 sample 이 있다면 그것은 상위 level 에서는 같은 cluster 에 속한다. 즉 위의 그림에서 level 2 에서의 4 와 5 는 같은 cluster 에 속하며 그것은 level 3 과 4 에서도 같은 cluster 에 속한다.
hierarchical clustering algorithm 은 계층구조를 bottom up 방식으로 만들 경우 agglomerative (병합식) 이라고 하고, top down 방식이면 divisive (분할식) 이라고 한다.
cluster 간의 유사도를 측정하는 다른 방법들을 사용하여 다른 hierarchical clustering algorithm을 구할 수 있다. 그 유사도를 측정하는 하나의 방법이 cluster 간 거리를 측정하는 함수를 정의하는 것이다. 거리 함수는 sample 의 쌍들간 거리를 측정하는 잠재 함수에 의해 유도된다. nearest neighbor 의 경우처럼 cluster 방법에서도 가장 일반적인 거리 측정은 Eucledian distance 와 city block distance 방법이다.
일반적인 agglomerative clustering algorithm 은 묘사하기가 수월하다. sample 의 전체 수를 n 이라고 할 경우 다음과 같은 과정을 거친다.
1. n 개의 cluster 로 시작한다. 각각은 하나의 sample을 포함한다.
2. step 3을 n - 1 번 반복한다.
3. 가장 유사한 cluster  와
 을 찾아서 하나의 cluster 로 병합한다. 만일 같은 값이 있으면 먼저 발견된
쌍을 병합한다.
다른 이름으로는 minimum method 와 nearest neighbor method 로도 불리운다. 후자의 이름은 nearest neighbor classification 과 밀접한 관계를 보여준다. 각 cluster에 하나씩의 점이 있을 때 두 점 간의 가장 가까운 거리를 두 cluster 간의 거리로서 정의하는 알고리즘이다.
두 cluster  와
 가 있을 때 그들 사이의 거리는 다음과 같이 정의된다. 여기서
 는 sample
 와
 사이의 거리를 의미한다.
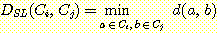
Example 5.1 single-linkage algorithm을 사용한 Hierarchical clustering
5 개의 sample 과 2 개의 feature  와
 를 가지는 경우를 보자. 5 개의 sample은 다음 그림과 같이 분포해 있다고 하자. sample
간의 거리 측정을 위해 Euclidean distance를 사용하라
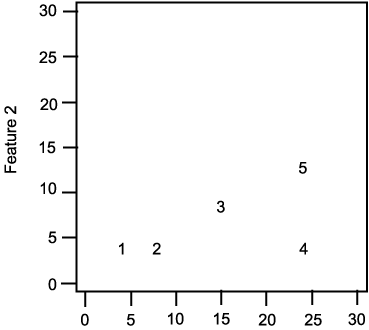
다음 표는 각 sample 의 feature 값과 sample 쌍들
간의 거리  를 보여준다.
|
|
|
|
|
|
1 |
2 |
3 |
4 |
5 |
|
1 2 3 4 5 |
4 8 15 24 24 |
4 4 8 4 12 |
|
1 2 3 4 5 |
- 4.0 11.7 20.0 21.5 |
4.0 - 8.1 16.0 17.9 |
11.7 8.1 - 9.8 9.8 |
20.0 16.0 9.8 - 8.0 |
21.5 17.9 9.8 8.0 - |
하나의 sample을 가지는 cluster  와
 가 있고 그들간의 거리는
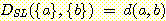 이다.
알고리즘은 각자 하나의 sample을 가지는 5 개의 cluster 로 시작한다. 그리고 나서 2 개의 가장 가까운 cluster 가 병합된다. 위의 표에서 가장 작은 수는 4 이고 sample 1 과 2 사이의 거리이다. 따라서 cluster {1} 과 {2} 가 병합된다. 이때는 다음의 4 개의 cluster 가 된다.
{1, 2}, {3}, {4}, {5}
다음에는 4 개의 cluster 간의 거리가 다음 행렬과 같이 주어진다.
|
|
{1, 2} |
3 |
4 |
5 |
|
{1, 2} 3 4 5 |
- 8.1 16.0 17.9 |
8.1 - 9.8 9.8 |
16.0 9.8 - 8.0 |
17.9 9.8 8.0 - |
행 {1, 2} 과 열 3 위치에 있는 값 8.1 은 cluster
{1, 2} 과 {3} 사이의 거리이며 다음과 같이 계산된다. 위의 첫 번째 표에서 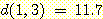 이며
 을 보여준다. single cluster algorithm 에서는 두 값중에서 최소값 8.1을 cluster
간의 거리로 선택한다. 첫째 행의 다른 값들도 같은 방법으로 계산된다. 첫째 행과
열 이외의 다른 값들은 그 대로 승계한다. 다음으로 행렬표에서의 최소값이 8 이기
때문에 cluster {4} 와 {5} 가 병합된다. 따라서 3 개의 cluster 가 된다.
{1, 2}, {3}, {4, 5}
3 개의 cluster 간의 거리는 다음 행렬표와 같다.
|
|
{1, 2} |
3 |
{4, 5} |
|
{1, 2} 3 {4, 5} |
- 8.1 16.0 |
8.1 - 9.8 |
16.0 9.8 - |
위 표에서의 최소값은 8.1 이기 때문에 cluster {1, 2} 와 {3} 이 병합되어 2 개의 cluster 로 된다.
{1, 2, 3}, {4, 5}
다음으로 거리 9.8에서 남아있는 cluster 두 개를 병합한다. 이래서 hierarchical clustering 이 완성되며 그 tree 은 다음과 같다.
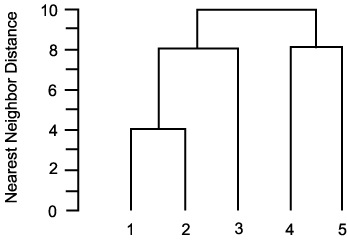
병합하는 cluster 간의 거리  은 vertical 축에서 볼 수 있다.
다른 이름으로는 maximum method
또는 farthest neighbor method 라고도 불린다. 서로 다른 cluster
에 위치하는 sample 들 간에 가장 큰 거리를 두 cluster 간의 거리로 정의하여
구하여진다. 두 cluster  와
 사이의 거리는 다음과 같이 정의된다.
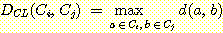
Example 5.2 complete linkage algorithm을 사용한 hierarchical clustering
다음 그림과 같이 data 가 분포한다고 하자. sample 간의 거리 측정을 위해 Euclidean distance를 사용하라
다음 표는 각 sample 의 feature 값과 sample 쌍들
간의 거리  를 보여준다.
|
|
|
|
|
|
1 |
2 |
3 |
4 |
5 |
|
1 2 3 4 5 |
4 8 15 24 24 |
4 4 8 4 12 |
|
1 2 3 4 5 |
- 4.0 11.7 20.0 21.5 |
4.0 - 8.1 16.0 17.9 |
11.7 8.1 - 9.8 9.8 |
20.0 16.0 9.8 - 8.0 |
21.5 17.9 9.8 8.0 - |
하나의 sample을 포함하는 다섯 개의 cluster 로 시작한다. 가장 가까이 있는 cluster {1} 와 {2} 는 병합되어 새로운 cluster를 만든다.
{1, 2}, {3}, {4}, {5}
이 cluster 간의 거리를 구한 행렬이 다음과 같다.
|
|
{1, 2} |
3 |
4 |
5 |
|
{1, 2} 3 4 5 |
- 11.7 20.0 21.5 |
11.7 - 9.8 9.8 |
20.0 9.8 - 8.0 |
21.5 9.8 8.0 - |
행 {1, 2} 과 열 3 위치의 값은 11.7 이며 이것은 cluster {1, 2} 와 {3} 사이의 거리를 의미하며 그것은 다음과 같이 구해진다.
원래 주어진 data에서 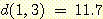 와
 의 값이 주어지며 complete linkage 알고리즘에서는 최대값인
11.7을 cluster 간의 거리를 선택한다. 첫 번째 행의 다른 값들도 같은 방법으로
구해진다. 첫째 행과 첮째 열 이외의 값은 그래도 승계한다. 그 때 행렬에서의 최소값은
8 이며 따라서 cluster {4} 와 {5} 가 병합한다. 이때의 cluster 는 다음과 같다.
{1, 2}, {3}, {4, 5}
이 cluster 간의 거리는 다음 행렬과 같이 구해진다.
|
|
{1, 2} |
3 |
{4, 5} |
|
{1, 2} 3 {4, 5} |
- 11.7 21.5 |
11.7 - 9.8 |
21.5 9.8 - |
위 행렬의 최소값은 9.8 이기 때문에 cluster {3} 과 {4, 5} 가 병합되어 cluster는 다음과 같다.
{1, 2}, {3, 4, 5}
위의 cluster 는 single linkage algorithm 의 동등한 위치에서의 구해진 cluster 와는 다른 것을 알 수 있다. 다음 과정으로 남아있는 cluster 들이 병합되어 hierarchical clustering 이 완성되며 그 tree 은 다음과 같다.
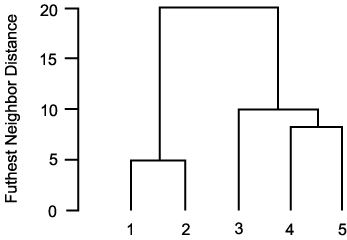
single linkage algorithm 은 tree 상에서 cluster 들이 길고 가는(long and thin) 모양을 보일 수 있다. complete linkage algorithm 에서는 보다 compact 한 모양을 보인다. 두 clustering 방법 모두 비정상적인 관찰에 민감하여 변형될 수 있다. 두 알고리즘의 극단을 절충하기 위한 방법이 average linkage algorithm 이다.
average linkage algorithm 은 다른 이름으로는
unweighted pair group method using arithmetic average (UPGMA) 라고도 불리우며
가장 널리 사용되는 hierarchical clustering algorithm 중 하나이다. 서로
다른 cluster 에 속한 두 점 사이의 평균 거리를 두 cluster 간의 거리로 정의 함으로써
average linkage algorithm 이 수행된다. 만일 cluster  가
 개의 멤버가 있고, cluster
 가
 개의 멤버를 가질 경우 두 cluster 간의 거리는 다음과 같다.
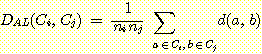
Example 5.3 average linkage algorithm을 사용한 hierarchical clustering
다음 그림과 같이 data 가 분포한다고 하자. sample 간의 거리 측정을 위해 Euclidean distance를 사용하라
다음 표는 각 sample 의 feature 값과 sample 쌍들
간의 거리  를 보여준다.
|
|
|
|
|
|
1 |
2 |
3 |
4 |
5 |
|
1 2 3 4 5 |
4 8 15 24 24 |
4 4 8 4 12 |
|
1 2 3 4 5 |
- 4.0 11.7 20.0 21.5 |
4.0 - 8.1 16.0 17.9 |
11.7 8.1 - 9.8 9.8 |
20.0 16.0 9.8 - 8.0 |
21.5 17.9 9.8 8.0 - |
하나의 sample을 포함하는 다섯 개의 cluster 로 시작한다. 가장 가까이 있는 cluster {1} 와 {2} 는 병합되어 새로운 cluster를 만든다.
{1, 2}, {3}, {4}, {5}
이 cluster 간의 거리를 구한 행렬이 다음과 같다.
|
|
{1, 2} |
3 |
4 |
5 |
|
{1, 2} 3 4 5 |
- 9.9 18 19.7 |
9.9 - 9.8 9.8 |
18.0 9.8 - 8.0 |
19.7 9.8 8.0 - |
행 {1, 2} 과 열 3 위치의 값은 9.9 이며 이것은 cluster {1, 2} 와 {3} 사이의 거리를 의미하며 그것은 다음과 같이 구해진다.
원래 주어진 data에서 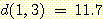 와
 의 값이 주어지며 average linkage 알고리즘에서는 평균값인
9.9를 cluster 간의 거리로 선택한다. 첫 번째 행의 다른 값들도 같은 방법으로
구해진다. 첫째 행과 첮째 열 이외의 값은 그래도 승계한다. 그 때 행렬에서의 최소값은
8 이며 따라서 cluster {4} 와 {5} 가 병합한다. 이때의 cluster 는 다음과 같다.
{1, 2}, {3}, {4, 5}
이 cluster 간의 거리는 다음 행렬과 같이 구해진다.
|
|
{1, 2} |
3 |
{4, 5} |
|
{1, 2} 3 {4, 5} |
- 9.9 18.9 |
9.9 - 9.8 |
18.9 9.8 - |
위 행렬의 최소값은 9.8 이기 때문에 cluster {3} 과 {4, 5} 가 병합되어 cluster는 다음과 같다.
{1, 2}, {3, 4, 5}
다음 과정으로 남아있는 cluster 들이 병합되어 hierarchical clustering 이 완성된다.
다른 이름으로는 minimum variance method 라고도 한다. 다른 알고리즘 처럼 각 sample을 위한 하나의 cluster 로써 시작한다. 모든 cluster 쌍 사이에서 반복을 통해 가장 작은 squared error를 가지는 쌍을 병합하여 새로운 cluster를 만든다. 각 cluster를 위한 squared error는 다음과 같이 정의된다.
하나의 cluster 가  개의 sample (
 , 여기서
 는 feature vector
 ) 을 포함한다면, sample
 의 squared error (평균에서의 squared Euclidean distance)는 다음과 같다.

여기서  는 cluster에서 sample들을 위한 feature
 의 평균값이다.
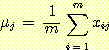
전체 cluster 에 대한 squared error  는 sample 들의 squared error 들의 합이다.
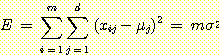
각 feature 의 평균값으로 구성된 vector 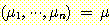 은 그 cluster 의 mean vector 또는 centroid 라고 불리운다. 하나의 cluster를
위한 squared error 는 각 feature에서 cluster 멤버로부터 그들의 평균값까지의
squared distance 의 합이다. squared error는 cluster 의 total variance
 에다가 cluster 의 sample의 수
 을 곱한 것과 같다. 여기서 total variance는 각 feature 의 variance 의 합으로써
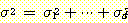 로 정의된다. 일련의 cluster들을 위한 squared error 는 각 cluster들을 위한
squared error 들의 합으로 정의된다.
Example 5.4 Ward's method를 사용한 hierarchical clustering
다음 그림과 같이 data 가 분포한다고 하자.
다음 표는 각 sample 의 feature 값과 sample 쌍들
간의 거리  를 보여준다.
|
|
|
|
|
|
1 |
2 |
3 |
4 |
5 |
|
1 2 3 4 5 |
4 8 15 24 24 |
4 4 8 4 12 |
|
1 2 3 4 5 |
- 4.0 11.7 20.0 21.5 |
4.0 - 8.1 16.0 17.9 |
11.7 8.1 - 9.8 9.8 |
20.0 16.0 9.8 - 8.0 |
21.5 17.9 9.8 8.0 - |
이때 squared error 는 zero 이다. cluster 쌍을 병합하는 방법은 10 가지가 있다. cluster {1} 과 {2} 병합, {1} 과 {3} 병합등등.
다음 표는 가능한 방법의 squared error를 보여준다. 예를들면 cluster {1} 와 {2}를 병합한다고 하자. sample 1 의 feature vector 는 (4,4) 이고 sample 2 는 (8,4) 이며 따라서 feature 평균은 6 과 4 이다. cluster {1, 2}를 위한 squared error 는 다음과 같이 구해진다.
(4 - 6)2 + (8 - 6)2 + (4 - 4)2 + (4 - 4)2 = 8
다른 각각의 cluster {3}, {4}, {5} 의 squared error 는 0 이다. 따라서 cluster {1, 2}, {3}, {4}, {5} 의 total squared error 는 다음과 같다.
8 + 0 + 0 + 0 = 8
다음 표에서 가장 작은 squared error 는 8 이기 때문에 cluster {1} 와 {2} 는 병합되어 4 개의 cluster {1, 2}, {3}, {4}, {5}를 만든다.
|
Clusters |
Squared |
|
{1, 2}, {3}, {4}, {5} {1, 3}, {2}, {4}, {5} {1, 4}, {2}, {3}, {5} {1, 5}, {2}, {3}, {4} {2, 3}, {1}, {4}, {5} {2, 4}, {1}, {3}, {5} {2, 5}, {1}, {3}, {5} {3, 4}, {1}, {2}, {5} {3, 5}, {1}, {2}, {4} {4, 5}, {1}, {2}, {3} |
8.0 68.5 200.0 232.0 32.5 128.0 160.0 48.5 48.5 32.0 |
4 개의 cluster를 만들 경우의 각각의 squared error
다음 표에서는 {1, 2}, {3}, {4}, {5} 중에서 2 개를 병합하는 가능한 경우의 squared error를 보여준다. 다음표에서 가장 작은 squared error 는 40 이기 때문에 cluster {4} 와 {5} 가 병합되어 3 개의 cluster를 만든다.
{1, 2}, {3}, {4, 5}
|
Clusters |
Squared |
|
{1, 2, 3}, {4}, {5} {1, 2, 4}, {3}, {5} {1, 2, 5}, {3}, {4} {1, 2}, {3, 4}, {5} {1, 2}, {3, 5}, {4} {1, 2}, {4, 5}, {3} |
72.7 224.0 266.7 56.5 56.5 40.0 |
3 개의 cluster를 만들 경우의 각각의 squared error
다음 표에서는 {1, 2}, {3}, {4, 5} 중에서 2 개를 병합하는 가능한 경우의 squared error를 보여준다. 다음표에서 가장 작은 squared error 는 94 이기 때문에 cluster {3} 과 {4, 5} 가 병합되어 2 개의 cluster를 만든다.
{1, 2}, {3, 4, 5}
|
Clusters |
Squared |
|
{1, 2, 3}, {4, 5} {1, 2, 4, 5}, {3} {1, 2}, {3, 4, 5} |
104.7 380.0 94.0 |
2 개의 cluster를 만들 경우의 각각의 squared error
다음으로 남은 2 개의 cluster 가 병합되어 hierarchical clustering 이 완성된다. 다음 그림은 완성된 tree를 보여준다.
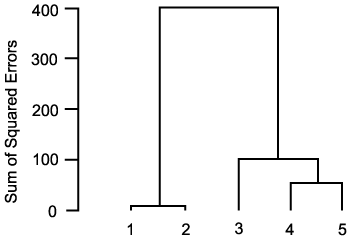
Ward's 방법에 의한 트리
cluster 의 계층을 고려하지 않고 평면적으로 clustering 하는 방법으로 일반적으로 미리 몇 개의 cluster 로 나누어 질 것이라고 예상하고 cluster 의 개수를 정하는 것이다.
가장 간단한 partitional clustering algorithm
중의 하나가 Forgy's algorithm 이다. data 이외에 cluster 의 수  를 input 으로 하며 이때
 를 seed point 라고 한다. seed point 는 임의로 선택되며 바람직한 cluster
구조에 관한 어떤 지식들이 seed point를 선택하는데에 사용될 수 있다. 그 과정은
다음과 같다.
1. 임의의 갯수의 seed point를 cluster centroid 로서 초기화 한다.
2. 각 sample 에 대해 가장 가까이 있는 cluster centroid를 찾아서 해당 cluster 에 sample을 배정한다.
3. 만일 step 2에서 sample 이 cluster를 변화시키지 못하면 종료한다.
4. 변화된 cluster 들에 대한 centroid를 다시 계산해서 다시 step 2 로 간다.
Example 5.5 Forgy's algorithm을 사용한 partitional clustering
다음 그림과 같이 data 가 분포한다고 하자.
다음 표는 각 sample 의 feature  ,
 값과 sample 쌍들
간의 거리
 를 보여준다.
|
|
|
|
|
|
1 |
2 |
3 |
4 |
5 |
|
1 2 3 4 5 |
4 8 15 24 24 |
4 4 8 4 12 |
|
1 2 3 4 5 |
- 4.0 11.7 20.0 21.5 |
4.0 - 8.1 16.0 17.9 |
11.7 8.1 - 9.8 9.8 |
20.0 16.0 9.8 - 8.0 |
21.5 17.9 9.8 8.0 - |
step 1, 처음에 2 개의 cluster를  로 두고 seed point 로서 각 cluster 는 최초의 두 sample (4,4), (8,4)를 사용한다.
Forgy's algorithm에서는 계산에서의 편의를 위해 sample들의 수보다는 feature vector
로서 sample 들을 표기한다.
step 2, 각 sample에서 가장 가까이 있는 cluster centroid를 찾는다. 다음 표에서는 그 결과를 보여준다. cluster 2 개 {(4, 4)} 와 {(8, 4), (15, 8), (24, 4), (24, 12)} 가 만들어 졌다.
step 4, cluster 들을 위한 centroid를 계산한다. 첫 번째 cluster 의 centroid 는 (4,4) 이며 두 번째는 (17.75, 7) 이며 그것은 다음과 같이 계산되었다.
(8 + 15 + 24 + 24) / 4 = 17.75
(4 + 8 + 4 + 12) / 4 = 7
sample들이 cluster 들을 변화시켰기 (처음에는 cluster 가 없었으니까) 때문에 step 2 로 돌아간다.
|
Sample |
Nearest |
|
(4, 4) (8, 4) (15, 8) (24, 4) (24, 12) |
(4, 4) (8, 4) (8, 4) (8, 4) (8, 4) |
Forgy's algorithm 의 첫 번째 반복
다음 표에서는 각 sample 들에 가장 가까운 cluster centroid를 찾는다. cluster {(4, 4), (8, 4)} 와 {(15, 8), (24, 4), (24, 12)} 이 만들어 졌다.
step 4, cluster 의 centroid (6, 4) 와 (21, 8) 이 계산된다. sample (8, 4) 가 cluster 들을 변화시켰고 따라서 step 2 로 간다.
|
Sample |
Nearest |
|
(4, 4) (8, 4) (15, 8) (24, 4) (24, 12) |
(4, 4) (4, 4) (17.75, 7) (17.75, 7) (17.75, 7) |
Forgy's algorithm 의 두 번째 반복
다음 표에서는 각 sample 들에 가장 가까운 cluster centroid를 찾는다. cluster {(4, 4), (8, 4)} 와 {(15, 8), (24, 4), (24, 12)} 이 만들어 졌다.
step 4, cluster 의 centroid (6, 4) 와 (21, 8) 이 계산된다. 어떤 sample 도 cluster 들을 변화시키지 않았기 때문에 알고리즘은 종료된다.
|
Sample |
Nearest |
|
(4, 4) (8, 4) (15, 8) (24, 4) (24, 12) |
(6, 4) (6, 4) (21, 8) (21, 8) (21, 8) |
Forgy's algorithm 의 세 번째 반복
위 예제에서는 seed point를 처음의
두 sample들로 임의로 선택되었다. 그러나 다른 가능성이 제안될 수 있다. 하나의
가능성은 hierarchical clustering algorithm 중의 하나로 만들어진  cluster 로 시작하여 최초의 seed point 로서 그 centroid를 사용하는 것이다.
Forgy's algorithm 과 유사한 방법이다. data 이외에 cluster 의 수  를 input 으로 하며 이때
 를 seed point 라고 한다. Forgy' algorithm 과 다른점은 하나의
sample 이 하나의 cluster 에 합류하자마자 곧 cluster 의 centroid 가 다시 계산된다는
것이다. 또한 Forgy' algorithm 이 반복적(iterative) 한 반면에
 -means algorithm 은 data set에서 단지 두 번만의 pass 가 이루어진다. 그 과정은
다음과 같다.
1. 처음에  cluster 로서 시작한다. 남아있는
 sample들에 대해서는 가장 가까이 있는 centroid를 찾는다. 이것에 가장
가까이 있는 centroid를 가지는 것이 확인된 cluster 에 sample을 포함시킨다. 각각의
sample 들이 할당된 후에 할당된 cluster 의 centroid 가 다시 계산된다.
2. 그 data를 두 번 처리한다. 각 sample에 대하여 가장 가까이 있는 centroid를 찾는다. 가장 가까이 있는 centroid를 가진 것으로 확인된 cluster 에 sample을 위치시킨다. (이 step 에서는 어떤 centroid 도 다시 계산하지 않는다.)
Example 5.6
 -means algorithm을 사용한 partitional clustering
다음 그림과 같이 data 가 분포한다고 하자.
다음 표는 각 sample 의 feature  ,
 값과 sample 쌍들
간의 거리
 를 보여준다.
|
|
|
|
|
|
1 |
2 |
3 |
4 |
5 |
|
1 2 3 4 5 |
4 8 15 24 24 |
4 4 8 4 12 |
|
1 2 3 4 5 |
- 4.0 11.7 20.0 21.5 |
4.0 - 8.1 16.0 17.9 |
11.7 8.1 - 9.8 9.8 |
20.0 16.0 9.8 - 8.0 |
21.5 17.9 9.8 8.0 - |
처음에 2 개의 cluster를  로 두고 처음의 두 sample 들은 (8,4) 와 (24,4) 로 한다.
step 1
두 개의 cluster {(8, 4} 와 {(24, 4)} 로 시작하며 그것은 (8, 4) 와 (24, 4) 에 centroid를 갖는다. 나머지 3 개의 sample 각각에 대해서는 가장 가까이 있는 centroid를 찾고 그 cluster 에 sample을 두고 cluster 의 centroid를 다시 계산한다.
다음 sample (15, 8) 은 centroid (8, 4) 에 가장 가깝고 따라서 cluster {(8, 4)} 에 합류한다. 이때에 cluster 들은 {(8, 4), (15, 8)} 와 {(24, 4)} 이다. 첫 번째 cluster 의 centroid 는 (11.5, 6) 로 바뀌는데 그것은 다음과 같이 계산된 것이다.
(8 + 15) / 2 = 11.5, (4 + 8) / 2 = 6
다음 sample (4, 4) 은 centroid (11.5, 6) 에 가장 가깝고 따라서 cluster {(8, 4), (15, 8)} 에 합류한다. 이때에 cluster 들은 {(8, 4), (15, 8), (4, 4)} 와 {(24, 4)} 이다. 첫 번째 cluster 의 centroid 는 (9, 5.3) 로 바뀐다.
다음 sample (24, 12) 은 centroid (24, 4) 에 가장 가깝고 따라서 cluster {(24, 4)} 에 합류한다. 이때에 cluster 들은 {(8, 4), (15, 8), (4, 4)} 와 {(24, 12), (24, 4)} 이다. 이때 두 번째 cluster 의 centroid 는 (24, 8) 로 바뀐다. 이때에 알고리즘의 step 1 은 완성된다.
step 2
sample들을 하나씩 검사하고 가장 가까이 있는 centroid를 가지는 것으로 확인된 cluster 에 각 sample을 위치시킨다. 다음 표에서 보여지는 것처럼 sample 들이 cluster 들을 변화시키지 못할 경우에 최종적으로 다음의 cluster 들로 분류된다.
{(8, 4), (15, 8), (4, 4)} 와 {(24, 12), (24, 4)}
|
Sample |
Distance to |
Distance to |
|
(8, 4) (24, 4) (15, 8) (4, 4) (24, 12) |
1.6 15.1 6.6 6.6 16.4 |
16.5 4.0 9.0 40.4 4.0 |
 -means algorithm 의 step 2에서 사용하기 위한 distance
 -means algorithm
 (8, (24, 12)
{(4, 4), (8, 4), (15, 8)}, {(24, 4), (24, 12)}
Isodata Algorithm 은 Forgy's algorithm 과  -means algorithm 을 보강한 방법으로 생각할 수 있다. 같은 점은 가장 가까이
있는 centroid 에 sample들을 할당하여 squared error를 최소화 시킨다는 것이다.
다른점은 고정된 수의 cluster 들을 처리하는 것이 아니라, 사용자에
의해 요구되는 cluster 의 수를 포함하는 범위까지 허용되는
 개의 cluster를 다룬다는 것이다. 만일 cluster 들의 수가 너무 많아지거나
cluster 들이 너무 가까이 있게 되면 cluster 는 병합된다.
만일 cluster 들의 수가 너무 적거나 cluster 가 아주 다른 종류의 sample 들을 포함하고
있다면 cluster 는 분리된다. 자세한 것은 다음에 서술한다.
isodata algorithm 의 경우 data 와 seed point 이외에 다음의 parameter 들이 필요하다.
no_clusters : cluster 의 바람직한 수로서 seed point 의 수와 같다.
min_elements : 각 cluster 마다 허용되는 sample 들의 최소 갯수.
min_dist : 병합이 일어나지 않는, cluster centroid 사이에 허용되는 최소 거리
split_size : cluster 의 분리를 조절하는 parameter
iter_start : 알고리즘의 first part에서 반복(iteration) 의 최대수
max_merge : 각 반복(iteration) 에서의 cluster 병합의 최대수
iter_body : 알고리즘의 main part 내에서 반복의 최대수
이러한 parameter 들은 알고리즘 과정에서 자세히 설명된다.
Isodata Algorithm 의 과정은 다음과 같다.
1. 임의의 갯수의 seed point를 cluster centroid 로서 초기화 한다.(step 1에서 4 까지는 Forgy's algorithm 과 같다)
2. 각 sample 에 대해 가장 가까이 있는 cluster centroid를 찾아서 해당 cluster 에 sample을 배정한다.
3. 변화된 cluster 의 centroid를 계산한다..
4. 만일 적어도 하나의 sample 이 cluster를 변화시키고 반복되는 수가 iter_start 보다 작다면, step 2 로 간다.
5. min_elements 보다 적은수의 sample을 가진 cluster 는 폐기한다. 또한 포함된 sample 들도 폐기한다.
6. 만일 cluster 의 수가 2 * no_clusters 보다 크거나 같고, 또는 반복되는 수가 짝수(even)이라면 step 7 (병합 동작)을 실행하고 그렇지 않으면 step 8 로 간다.
7. 만일 두 centroid 간의 거리가 min_dist 보다 작다면 두 cluster를 병합하고 centroid를 변화시킨다. 그렇지 않으면 step 7 로 간다. 이러한 step을 max_merge 번을 반복하고 step 8 로 간다.
8. 만일 cluster 의 수가 no_clusters / 2 보다 작거나 같고, 또는 반복의 수가 홀수(odd) 라면 step 9 (분리 동작)을 수행하고 그렇지 않으면 step 10 으로 간다.
9. split_size *  를 초과하는 표준편차를 가지는 cluster를 찾는다 (여기서
 는 어떤 변수이고
 는 원래의 sample 집합에서
 의 표준편차이다). 만일 없으면 step 10 으로 간다. cluster 내에서
 의 평균을 계산한다. 이 cluster 에 있는 sample 들을 두 집합으로 나눈다(
 가 평균보다 크거나 같은 집합과
 가 평균보다 작은 집합). 이러한 두 cluster 의 centroid를 계산한다. 만일 이러한
centroid 사이의 거리가 1.1 * min_dist 보다 크거나 같으면 원래의 cluster를 이러한
두 개의 cluster 로 바꾸고, 그렇지 않으면 cluster를 분리하지 않는다.
10. 만일 step 10 이 iter_body 횟수만큼 수행되거나, 마지막 step 10 이 수행된 이후 cluster 에 아무런 변화도 발생하지 않으면 중단한다. 그렇지 않으면 새로운 seed point 로서 cluster 의 centroid를 취하고 step 2 로 간다.
Example 5.7 isodata algorithm을 사용한 partitional clustering
다음과 같은 data 와 parameter 들이 있을 경우 data를 cluster 하기위해 isodata algorithm을 사용해 보자.
|
Number |
x |
y |
Number |
x |
y |
|
1 2 3 4 5 6 7 |
0.0 0.0 0.0 0.5 0.5 1.0 1.0 |
0.0 1.0 3.0 0.5 3.5 1.0 3.0 |
8 9 10 11 12 13 14 |
6.0 6.0 6.0 6.0 6.2 6.2 8.0 |
0.75 1.00 2.00 2.10 0.80 2.05 12.0 |
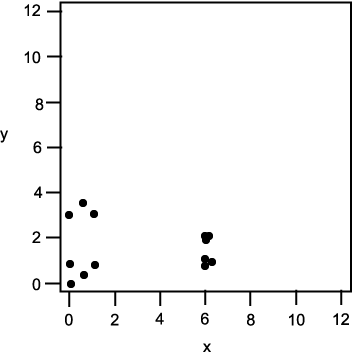
|
no_clusters = |
3 |
seed point 는 sample 1, 3, 13 이며, 처음의 반복 횟수는 0 이다.
알고리즘의 Forgy part (step 1 ~4) 의 수렴을 위해 data 의 한번의 수행이 필요하다. 이때에는 다음과 같이 3 개의 cluster 가 존재한다.
{1, 2, 4, 6}, {3, 5, 7}, {8, 9, 10, 12, 13, 14}
step 5, 어떤 cluster 도 min_elements 보다 멤버수가 작지 않기 때문에 폐기되는 cluster 는 없다.
step 6, cluster 의 수가 2 * no_clusters 보다 크거나 같지 않고, 또는 반복되는 수 (0) 가 짝수(even)이므로, step 7 (병합 동작)을 실행한다. 하고 그렇지 않으면 step 8 로 간다.
cluster {1, 2, 4, 6} 와 {3, 5, 7} 의 centroid 간의 거리가 min_dist 보다 작기 때문에 두 cluster를 병합하고 centroid를 변화시킨다. 이때에 2 개의 cluster 가 다음과 같이 된다.
{1, 2, 3, 4, 5, 6, 7}, {8, 9, 10, 11, 12, 13, 14}
병합 step 이 반복되지 않으므로 (max_merge = 1 이기 때문) step 8 로 나아간다. ( 이 경우 남아있는 cluster 들은 병합될 수 없다. 왜냐하면 centroid 간의 거리가 min_dist 보다 크기 때문이다)
step 8, cluster 의 수 (2) 가 no_clusters / 2 (1.5) 보다 크기 때문에, 또한 반복의 수가 홀수(odd) 가 아니기 때문에 step 10 으로 간다.
step 10, 반복의 횟수가 요구되는 수 (5) 보다 자고 cluster 들은 변화되었다. 따라서 step 2 로 나아간다.
이때에 알고리즘의 Forgy part (step 1~4) 는 cluster를 변화시키지 않는다.
step 5, 어떤 cluster 도 min_elements 보다 멤버수가 작지 않기 때문에 폐기되는 cluster 는 없다.
step 6, cluster 의 수가 2 * no_clusters 보다 크거나 같지 않고, 또는 반복되는 수 (1) 가 홀수(odd)이므로, step 8 로 간다.
step 8, cluster 의 수 (2) 가 no_clusters / 2 보다 크기 때문에, 또한 반복의 수가 홀수(odd) 이므로, 분리 동작 (step 9) 가 수행된다.
step 9, split_size *  를 초과하는 (변수
 를 위한) 표준편차를 가지는 cluster {8, 9, 10, 11, 12, 13, 14} 가 있다. sample
들은 cluster 에서의
 의 평균보다 작거나 큰
 값을 가지는 두 집합으로 나뉜다.
{8, 9, 10, 11, 12, 13}, {14}
그들의 centroid 사이의 거리가 1.1 * mid_dist 보다 크거나 같기 때문에, cluster 는 분리상태를 유지한다. 이때에는 3 개의 cluster 가 존재한다.
{1, 2, 3, 4, 5, 6, 7}, {8, 9, 10, 11, 12, 13}, {14}
step 10, 반복 횟수가 요구되는 수보다 작고 cluster 가 변화되었으므로 step 2 로 간다.
다시 이때에 알고리즘의 Forgy part (step 1~4) 는 cluster를 변화시키지 않는다.
step 5, cluster {14} 는 min_elements 멤버수보다 작기 때문에 폐기된다. 이때에는 두 개의 cluster 가 된다.
{1, 2, 3, 4, 5, 6, 7}, {8, 9, 10, 11, 12, 13}
step 6, cluster 의 수가 2 * no_clusters 보다 작고 반복횟수 (2) 가 짝수이기 때문에, 병합동작 (step 7) 이 수행된다.
cluster {1, 2, 3, 4, 5, 6, 7} 과 {8, 9, 10, 11, 12, 13} 의 centroid 사이의 거리가 min_dist 보다 작기 때문에, 이 cluster 들은 병합되지 않는다. step 8 로 나아간다.
step 8, cluster 의 수 (2) 가 no_clusters / 2 보다 크고 반복 횟수가 짝수이기 때문에 step 10 으로 간다.
step 10, 반복 횟수가 요구되는 수보다 작고 cluster 들이 변화되었기 때문에 step 2 로 간다.
다시 이때에 알고리즘의 Forgy part (step 1~4) 는 cluster를 변화시키지 않는다.
step 5, 어떤 cluster 도 min_elements 보다 멤버수가 작지 않기 때문에 폐기되는 cluster 는 없다.
step 6, cluster 의 수가 2 * no_clusters 보다 작고 반복횟수 (3) 가 홀수이기 때문에 step 8 로 나아간다.
step 8, cluster 의 수 (2) 가 no_clusters / 2 보다 크고 반복횟수가 홀수이기 때문에, 분리 동작 (step 9) 이 수행된다.
step 9, 어떤 cluster 도 표준편차가 split_size *  를 초과하는 변수를 가지고 있지 않기 때문에 step 10 으로 나아간다.
step 10, 반복 횟수가 요구되는 수보다 작다, 그러나 어떤 cluster 도 변화되지 않았다. 따라서 알고리즘은 종료된다.


