신경망 이론과 응용(1) : 김대수, 하이테크 정보, 1992, Page 169~188
3. 경쟁 학습(Competitive Learning)
4. Kohonen 학습 규칙(Learning Rule)
5. 자기조직화 형상지도(Self-organizing Feature Maps) 알고리즘
6. 자기조직화 형상지도(Self-organizing Feature Maps)
태어난 지 얼마되지 않은 아기가 눈의 초점 맞추기를 배우는 과정을 생각해 보자. 이 기능은 신생아들에게는 주어지지 않았지만 그들은 태어난지 얼마되지 않아서 점차로 그러한 능력을 갖게 된다. 이 세상에서 아무리 훌륭하고 헌신적인 부모라 해도 갓 태어난 시각적인 자극을 보고 이해하기 위하여 어떻게 해야하는지 가르쳐줄 수는 없다. 그러나 며칠 후 아기는 눈에 보이는 자극과 물체 및 모양들을 서로 연관시키는 것을 자연스럽게 배우게 된다. 이것은 주목할 만한 점이다. 그러나 아기뿐만 아니라 갓 태어난 강아지나 고양이들도 이러한 기능을 외부의 도움없이도 자연스럽게 배운다. 어떻게 이런 일이 일어나는가? 이에 대한 설명중 하나가 핀란드의 헬싱키 공과대학 (Helsinki Technology University) 의 튜보 코호넨 (Teuvo Kohonen) 에 의해 제안되었다. 그의 연구 업적은 유럽에서만큼 미국에서는 크게 알려지지 않았으나 자율적인 (unsupervised) 신경망 모델에서는 미국의 그로스버그 (S. Grossberg) 와 더불어 가장 유명하다. 그의 신경망의 '자기조직화 (self-organizing)' 란 주어진 입력패턴에 대하여 정확한 해답을 미리 주지 않고 자기 스스로 학습할 수 있는 능력을 말한다. 일반적으로 이러한 네트워크들은 신경 생리학적인 시스템을 본따서 모델링한 것이다. 이러한 모델들을 연구하는 사람들은 두뇌가 어떻게 실제로 작용하는지를 이해하고자 노력하며, 이를 신경망으로 구현할 때 얼마나 유용할 것인가를 규명하기 위하여 노력한다.
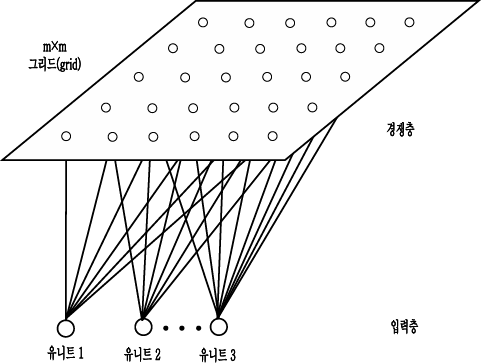
Kohonen 의 자기조직화 network 는 첫눈에도 매우 간단해 보인다. backpropagation network 와는 달리 일반적으로 계층적인(hierarachical) 시스템이 아니며 <그림 1> 에서 보는 바와 같이 2개의 층으로 이루어져 있다. 이 network 의 첫 번째 층은 입력층 (input layer) 이고 두 번째 층은 경쟁층 (competive layer) 인데 2차원의 격자 (grid) 로 되어있다. 모든 연결들은 첫 번째 층에서 두 번째 층의 방향으로 되어 있으니 두 번째 층은 완전 연결 (fully connected) 되어 있다. 이 뉴런들은 경쟁층에서 고밀도로 연결되어 있다.
<그림 1> 코호넨 네트워크
Kohonen network 를 만들 때 다른 신경망들에서는 일반적으로 필요하지 않는 두 가지 일을 해야 한다. 하나는 층내의 뉴런의 연결강도 백터가 임의값을 가지면서 적합하게 초기화되어야 한다. 다른 하나는 연결강도 백터와 입력백터가 통상 0 에서 1 사이의 정규화된 (normalized) 값을 사용한다. 이런 두 가지 요인은 Kohonen network 에 있어서 매우 중요하다.

Kohonen 의 학습에서 각 뉴런은 연결강도 백터와 입력백터가 얼마나 가까운가를 계산한다. 그리고 각 뉴런들은 학습할 수 있는 특권을 부여받으려고 서로 경쟁하려는데 거리가 가장 가까운 뉴런이 승리하게 된다. 이 승자 뉴런이 출력신호를 보낼 수 있는 유일한 뉴런이다. 또한 이 뉴런과 이와 인접한 이웃 뉴런들만이 제시된 입력백터에 대하여 학습이 허용된다. 이것은 학습에 있어서 전혀 새로운 접근 방식이다. 이 모델이 있기 이전에는 network 에 있는 모든 뉴런들이 반복되는 훈련 과정에서 연결강도를 조정한다.
Kohonen network 의 학습 철학은 '승자 독점 (winner take all)' 이다. 승자만이 출력을 낼 수 있으며, 승자와 그의 이웃들만이 그들의 연결강도를 조정할 수 있다.
생물학적 모델로 디자인된 Kohonen 의 시스템은 충 (layer) 내에서 경쟁하는 복잡한 스킴 (scheme) 인 '측면제어 (lateral ingibition)' 를 사용한다. 전체적인 측면제어 효과는 <그림 2> 에서 보는 바와 같이 멕시칸 모자 (sombrero) 와 유사하다.
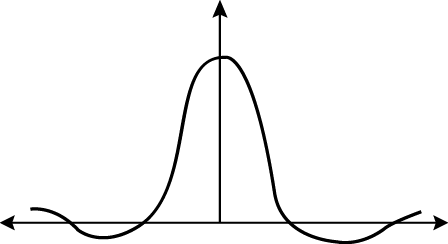
<그림 2> 측면제어
이웃 반경의 정확한 크기는 바로 인접한 뉴런들에게만 해당되도록 제한될 필요는 없다. 이웃 반경의 크기는 학습하는 도중에도 변할 수 있다. <그림 3> 에서 보는 바와 같이 처음에는 층내의 모든 뉴런들을 포함하다가 점차로 줄어들어 승자와 바로 인접한 뉴런들만이 포함된다.
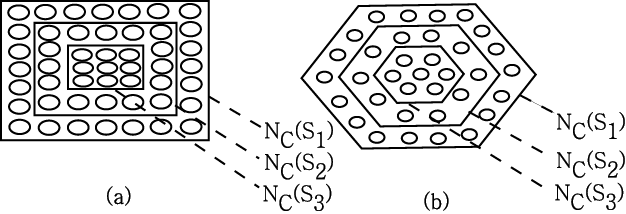
<그림 3> 이웃 반경의 크기 조정
승자 뉴런의 연결강도 백터는 입력백터의 가장 가까운 것이다 (그렇지 않다면 경쟁에서 승자가 될 수 없었을 테니까). 이 뉴런과 그의 이웃 반경 안의 뉴런들은 연결강도를 조정해가면서 학습을 한다. 이러한 측면 제어의 개념은 생물학적인 모델에서 매우 중요하다.
승자 뉴런을 결정하고 난 후에는 Kohonen 의 학습 규칙에 따라 뉴런의 연결강도를 조정해야 한다. 이 규칙은 다음 식으로 표현된다.
Wnew = Wold + α(X-Wold) (식 1)
여기서 Wold 는 조정되기 이전의 연결강도 백터이며, Wnew 는 조정된 후의 새로운 연결강도 백터이고, X 는 입력패턴 백터이며, α 는 학습상수이다.
앞에서 기술한 바와 같이 승자 연결강도 백터는 기하학적으로 입력패턴에 가장 가깝다. Kohonen 의 학습은 단순히 연결강도 백터와 입력패턴 백터의 차이를 구한 다음 그것의 일정한 비율을 원래의 연결강도 백터에 더하는 것이다. 이 때 승자 뉴런만이 그것과 관련된 백터를 조정하는 것이 아니라 그의 이웃 반경안에 드는 모든 뉴런들도 유사한 조정을 하게 된다. 승자 뉴런은 +1 을 출력으로 내며, 승자 뉴런과 그것의 이웃 뉴런들은 각자의 연결강도 백터를 입력백터에 다소나마 가까이 접근하게 된다.
일반적으로 Kohonen network 에서는 <그림 3> 에서 보는 바와 같이 Nc(S3)에서 Nc(S2), Nc(s1) 으로 승자 뉴런의 이웃 반경은 서서히 줄어든다. 학습의 거의 모든 뉴런들이 학습을 하게 된다. 훈련이 진행됨에 따라 이웃 반경은 서서히 줄어들어서 점점 적은 갯수의 뉴런들이 학습을 하게 된다. 최종적으로는 단지 승자 뉴런만이 그것의 연결강도를 조정하게된다. 이러한 과정이 끝나면 또 다른 입력백터가 들어오게 되고 위에서 기술한 과정을 되풀이한다. 즉 새로운 승자 뉴런이 선택되고, 출력 신호를 내고, 승자 뉴런과 그 이웃 반경의 뉴런들의 연결강도 백터는 입력백터에 다가가게 된다. 이러한 과정은 모든 훈련이 끝날 때까지 계속 반복된다.
Kohonen 의 학습 규칙에 대한 역사는 복잡하다. 이 학습 규칙 자체는 1962 년이나 그 이전에 생겨났으며, 1965 년 닐슨 (Nils Nilsson) 의 "Learning Machine" 이란 책 [NIL65] 에도 나타나 있다. 이 책에서 닐슨은 이 학습 방법이 1962 년 스타크 (L.M.Stark), 오카지마 (M, Okajima), 그리고 위플 (G.H.Whipple) 등에 의해 발명되었다고 주장하고 있다. 실제로는 "unsupervised clustering" 이란 논제와 더불어 훨씬 이전부터 있었을 것이다.
Kohonen network 에 있어서 강조되어야 할 실제적인 이슈들은 다음과 같다. 첫째, 연결강도 백터와 입력백터의 정규화 (normalization) 이다. 둘째, Kohonen network 는 network 크기 (size) 가 큰 경우에 잘 작동한다. network 의 크기가 작으면 통계적인 모델의 정확도는 떨어지므로 완전한 결과를 기대할 수 없다.
|
[단계 1] 연결강도를 초기화한다. [단계 2] 새로운 입력백터를 제시한다. [단계 3] 입력백터와 모든 뉴런들간의 거리를 계산한다. 입력과 출력 뉴런 j사이의 거리 dj는 (식 2)와 같이 계산한다.
여기서 xi(t) 는 시각 t 에서의 i 번째 입력백터이고 wij(t) 는 시각 t 에서의 i 번째 입력백터와 j 번째 출력 뉴런 사이의 연결강도이다. [단계 4] 최소 거리에 있는 출력 뉴런을
선택한다. [단계 5] 뉴련 j*
와 그 이웃들의 연결강도를
재조정한다. wij(t+1)=wij(t)+α(xi(t)-wji(t)) (식 3) 여기에서 j 는 j* 의 이웃 반경내의 뉴런이고 i 는 0 에서 N-1 까지의 정수값이다. α 는 0 과 1 사이의 값을 가지는 이득항 (gain term) 인데 시간이 경과함에 따라 점차 작아진다. [단계 6] 단계 2 로 가서 반복한다. |
자기조직화 형상지도 신경망은 1979 년에서 1982 년 사이에 Kohonen 에 의해 개발되었다 [KOH82]. 자기조직화 형상지도를 개발한 Kohonen 과 상당히 밀접한 연구를 한 윌쇼우 (Willshow). 그리고 스테픈 그로스버그 (S. Grossberg) 등은 자기조직화 형상지도 연구의 선구적인 말스버그 (von der Malsburg) [MAL73] 의 영향을 많이 받았다. 역사적으로 볼 때, 자기조직화 지도는 1980 년대 중반부터 불기 시작한 신경망의 새로운 봄이 시작되기 전에 연구된 매우 중요한 신경망 중의 하나이다.
입력패턴의 분포를 반영하는 2 차원의 지도가 자기조직화라는 예를 살펴보자. 훈련패턴들은 2차원의 백터들인데 각 엔트리 (entry) 는 0 에서 1 까지의 숫자이며 균등 분포 (uniform distribution) 에서 선택된다.
network 의 초기 연결강도는 0.4 에서 0.6 사이의 임의값을 사용하였다. <그림 4> [DAY90] 의 (a) 는 초기의 연결강도를 나타내고 <그림 4> 의 (b) 는 경쟁층에서 두 개의 인접한 유니트의 연결을 보여준다.
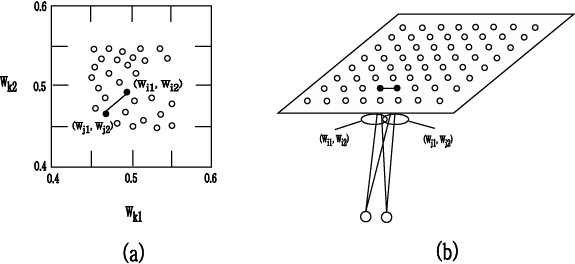
<그림 4> (a) 네트워크의 초기 연결강도 (b) 경쟁층에서 인접한 유니트의 연결
Kohonen network 는 <그림 5> [DAY90] 의 (a) 에 나타난 것처럼 처음의 상태에서 점차로 조직화된다. 중앙에 위치한 하나의 클러스터는 초기의 주어진 범위내의 임의값을 가진 연결강도의 값이다. <그림 5> 의 (b) 는 1,000 번의 반복수행 (iteration) 을 거친 결과인데 경쟁층에서 유니트간의 자연스런 순서관계 (ordering) 가 형성되기 시작한다. <그림 5>의 (c)는 6,000 번의 반복 수행을 거친 중간 단계를 보여주며, 20,000 번이 수행된 최종 결과는 <그림 5> 의 (d) 에 나타나 있다. 여기에서 학습계수 α 의 값은 0.2 를 사용하였다. 마지막으로 <그림 5> 의 (e) 는 주어진 입력패턴에 대해 훈련 network 의 반응을 보여준다. 입력패턴이 주어졌을 때 가장 가까운 유니트가 경쟁층에서 승리하게 된다. 승리 유니트는 동그라미로 표시되었으며 두 개의 입력패턴들은 점들로 표시되었다.
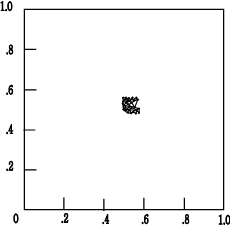
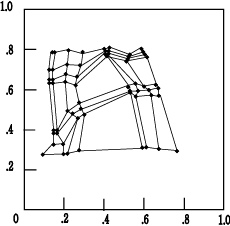
(a) 네트워크의 처음의 연결강도 벡터 (b) 1,000번의 훈련을 거친 연결강도
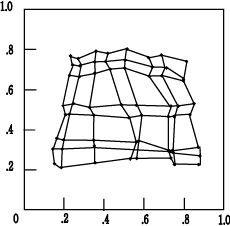
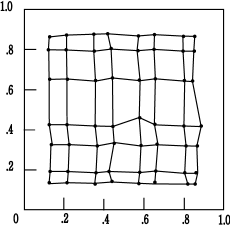
(c) 6,000번의 훈련을 거친 연결강도 (d) 20,000번의 훈련을 거친 최종의 연결강도
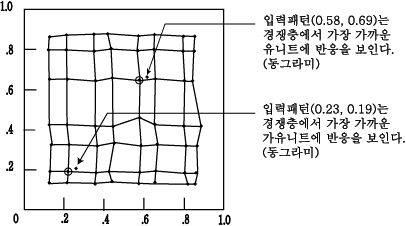
<그림 5> (e) 주어지는 입력패턴에 대한 훈련 네트워크의 반응
Kohonen 의 형상지도는 2 차원의 패턴 공간을 1 차원의 체인같은 유니트들로 조직화할 수 있다. 이러한 예는 Kohonen network 에서 매우 중요한데 고차원의 표현을 1 차원으로 표현할 수 있는 장점이 있다. <그림 6> [DAY90] 의 (a) 는 2 개의 입력 유니트와 40 개의 경쟁 출력 유니트가 일직선으로 나열된 것이다. 두 개의 입력 유니트들은 2 차원의 패턴들을 입력시킬 수 있으며, 이 network 는 이러한 패턴을 1 차원의 출력 체인으로 매칭이 가능하다. 훈련패턴들은 앞의 예와 마찬가지로 0과 1사이의 균등 분포에서 임의적으로 선택되었다.
<그림 6> 의 (b) 는 임의값 연결강도를 가진 초기의 상태이고 (c) 는 6,000 번의 반복 수행을 거친 중간 단계이며, 5 만번의 반복 수행을 거친 최종적인 결과는 <그림 6> 의 (d) 에 나타내었다. 여기서의 학습계수 α 는 0.2 이다.
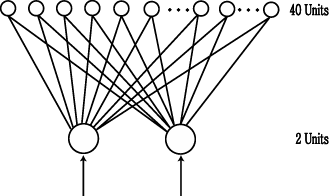
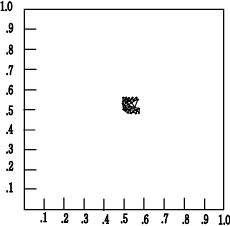
(a) 2차원의 입력벡터와 40개의 선형적인 경쟁 유니트 (b) 임의값 연결강도를 가진 초기의 상태
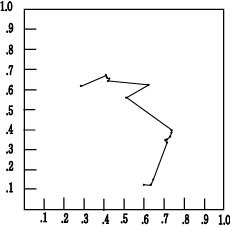
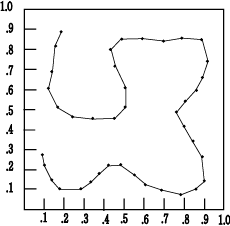
(c) 6,000번의 반복 수행을 거친 중간 단계의 상태 (d) 60,000번의 수행후의 최종 상태
<그림 6>
Kohonen network 는 여러 가지 장점들을 가지고 있다. 첫째, 이 network 는 구조상 수행이 상당히 빠른 모델이다. 이것은 훈련 단계에서도 그러하다. 이 network 는 backpropagation 모델과는 달리 여러 단계의 피드백이 아닌 단 하나의 전방 패스 (feedforward flow) 를 사용한다. 그러므로 Kohonen 시스템은 잠재적으로 실시간 학습 처리를 할 수 있는 모델이다. 둘째, 이 network는 연속적인 학습이 가능하다. 그러므로 만약 입력 데이터의 통계적 분포가 시간에 따라 변하면 Kohonen network 는 자동적으로 이러한 변화에 적응하게 된다. 셋째, Kohonen network 는 자기조직화를 통한 정확한 통계적 모델이다.
Kohonen network 를 실세계 문제에 적용하기는 그리 쉽지가 않다. 그러나 이 모델이 우리의 두뇌의 작용을 고찰하기엔 매우 유용한 모델이라 할 수 있다.
인간과 같은 지능적인 기계장치에 대한 연구는
오래전부터 계속되고 있으며, 그 중 인간의 말을 인식하고 이해할 수 있는 기계장치의
개발은 컴퓨터 과학자들에게는 오랜 소망이었다. 자연이 처리 기술에 있어서도 서로
다른 언어간의 기계번역 시스템의 실용화도 점차 현실화되고 있는 실정이다.
음성인식에 대한 지금까지의 상당한 연구 개발에도
불구하고 현재의 상업적인 제품은 여전히 한정된 어휘와 말을 훈련시킨 사람이 어휘에만
특별히 잘 반응하는 화자종속등의 문제로 말미암아 극히 제한되어 있다.
신경망 음성타자기는 컴퓨터가 화자종속으로 음성인식을 할 수 있는 잠재력을 보여주며, 또한 신경망 기술이 어떻게 전통적인 신호처리 기술 및 인공지능 테크닉과 융합될 수 있는지를 보여준다. 이 장치는 말이 글자로 실시간내에 변환될 수 있으며, Kohonen 의 실험에 의하면 92 % 에서 97 % 정도의 정확성이 있다고 한다. 그렇다고 이 신경망 음성타자기가 말을이해하는 것은 전혀 아니다.
<그림 7> [FRE91] 은 phonotopic map 을 나타낸다. 뉴런은 원으로 표시되며 그 안에 반응할 음소 (phoneme) 가 나타나 있다.

<그림 7> Phonotopic maps
이 장치에서는 2 차원의 뉴런들이 9.8m/sec 마다 샘플되는 음성의 15개 스팩트럼을 분석한다. 이러한 입력백터들은 노이즈 제거와 푸리에 변환 (Fourier Transform) 등의 전처리 과정을 거치게 된다. 현재 적용되고 있는 언어는 핀란드말과 일본말이며 비디오를 통해서 본 필자의 경험으로는 실시간에 상당히 잘 작동되었다. <그림 8> [FRE91] 은 핀란드 말 'humppila' 에 대한 phonotopic map 의 반응을 나타낸 것이다.
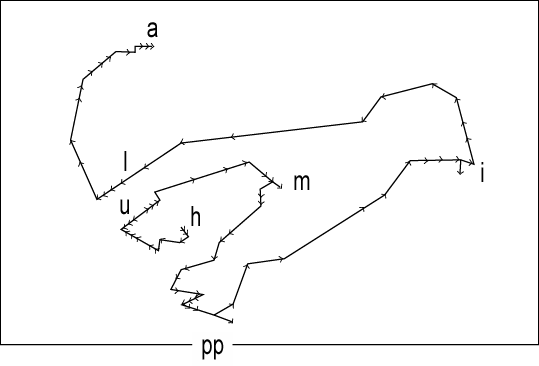
<그림 8> Phonotopic map의 반응 열(sequence)
연상 기억이란 '키 (key)' 패턴이 메모리로 입력되었을 때 그 '키'와 연관된 '정보' 를 출력하는 것인데, 저장장치와 연관된 신호의 피드백과 순환적인 연산을 통하여 일어난다.
Kohonen network 를 이용한 자동연상 기억의 예가 <그림 9> [KOH89, HIN89] 에 나타나 있다. 그림의 (a) 에서 (d) 까지의 사진은 100 개의 영상 데이터에서 선택된 것인데, (e) 나 (g) 와 같이 불완전하거나 노이즈가 첨가된 '키' 패턴이 주어졌을 때 (f) 와 (h) 같이 각각 최적의 자동연산이 되는 것을 볼 수 있다.

<그림 9> 자동연상 기억을 통한 회상 (Autoassociative recall)
이 장에서는 자율학습 모델인 코호넨 네트워크를
살펴 보았다. 코호넨 네트워크는 단지 2 개의 층으로 이루어져 있으며, 자기조직화를
통하여 비교적 단순하면서도 매력적인 결과를 도출해낸다. 코호넨의 자기조직화 형상지도는
생물들에서 일어나는 매우 중요한 현상을 보여주며, 복잡한 패턴인식 시스템에서
매우 중요한 부분을 차지한다.
이 모델은 신경 생리학적 시스템을 본따서 모델링했기
때문에 백프로퍼게이션 모델과 같은 지도학습 모델보다는 인간의 두뇌에 가깝다고
볼 수 있다.
1 절에서는 코호넨
네트워크에 대한 머리말을, 2 절에서는 코호넨
네트워크의 기본적인 구조를 고찰하였다. 3 절에서는
하나의 승리 뉴런이 선택되는 경쟁학습과 멕시칸 모자를 닮은 측면제어 및 이웃 반경에
관하여 기술하였다.
4 절에서는 코호넨의 학습
규칙에 따른 연결강도 벡터의 조정과 이웃 반경이 서서히 줄어드는 단계에 대하여
기술하였으며, 코호넨의 학습 규칙에 대한 역사적인 배경을 살펴 보았다. 또한 코호넨
네트워크에서 강조되어야 할 두가지 이슈를 지적하였다.
5
절에서는 자기조직화 형상지도 알고리즘을 단계적으로 기술하였으며, 자기 조직화
형상지도의 단계적인 변화를 그림으로 살펴 보았다. 6
절에서는 코호넨 네트워크의 장점들을 살펴 보았고, 7
절에서는 빠른 실행 속도와 연속적인 학습기능 등 코호넨 네트워크의 장점들을 살펴
보았다. 자기조직화 형상지도의 신경망 음성타자기를 통한 응용의 예는 8
절에서 소개하였으며, 자동연상 기억의 예는 9
절에 나타내었다.
 (식
2)