1. 신경망 모델에서 활성화 함수(Activation Function)의 정의와 기능 상세
📌 1) 활성화 함수의 정의 (Definition)
활성화 함수(Activation Function)는 인공신경망의 각 뉴런(노드)에서 입력값들의 가중합(Weighted Sum)에 편향(Bias)을 더한 총합 NET($\sum w_i x_i + b$)을 받아, 다음 계층(Layer)이나 최종 출력으로 내보낼 신호의 강도를 결정하는 수학적 변환 함수입니다.
이는 생물학적 뇌의 신경세포가 수상돌기를 통해 들어온 전기적 자극이 일정한 역치(Threshold)를 초과할 때 축삭돌기를 통해 다음 뉴런으로 신호를 '발화(Firing)'하는 기작을 인공지능 알고리즘으로 수학화한 것입니다.
⚙️ 2) 활성화 함수의 4대 핵심 기능 (Key Functions & Purposes)
1. 비선형성(Non-Linearity) 도입
가장 필수적인 역할입니다. 활성화 함수가 없다면 아무리 층을 깊게 쌓아도 선형 변환의 합성에 불과하여 단층 선형 모델과 동일해집니다. 비선형 활성화 함수를 통해 복잡한 비선형 데이터(이미지, 음성, 자연어)를 학습하는 '보편 근사 능력(Universal Approximation)'을 획득합니다.
2. 출력 범위 제어 및 수치 안정화
가중합 계산값이 계층을 통과할 때마다 무한히 발산하거나 폭주하지 않도록, 특정 범위(예: 0~1, -1~1, 0 이상)로 값을 압축(Squashing)하여 연산의 수치적 안정성을 보장합니다.
3. 역전파(Backpropagation) 기울기 전달
신경망은 경사 하강법(Gradient Descent)으로 가중치를 업데이트합니다. 활성화 함수는 수학적으로 '미분 가능(Differentiable)'해야 오차의 기울기(Gradient)를 역방향으로 전달하여 역전파 학습이 정상 동작합니다.
4. 신호 선별 및 희소성(Sparsity) 부여
중요하지 않은 잡음 신호는 0으로 억제하고, 유의미한 주요 특징 신호만 통과시키는 게이트키퍼 역할을 하여 신경망의 효율성과 표현력을 극대화합니다.
📊 3) 대표적인 활성화 함수 종류 및 비교
| 활성화 함수 |
수학적 정의 |
출력 범위 |
주요 특징 및 대표적 활용 |
계단 함수
(Step Function) |
f(x) = 1 (x ≥ 0) else 0 |
{0, 1} |
초기 퍼셉트론에 사용됨. 미분값이 0이어서 현대 역전파(오차역전파) 학습에는 사용 불가. |
시그모이드
(Sigmoid / Logistic) |
f(x) = 1 / (1 + e⁻ˣ) |
(0, 1) |
부드러운 S자 곡선. 양 끝단에서 기울기가 0에 수렴하는 '기울기 소실(Vanishing Gradient)' 발생. 주로 이진 분류 출력층에 사용. |
하이퍼볼릭 탄젠트
(Tanh) |
f(x) = tanh(x) |
(-1, 1) |
원점 대칭(Zero-centered) 구조로 시그모이드보다 은닉층 학습 성능이 우수하나 기울기 소실 문제는 잔존. |
ReLU
(Rectified Linear Unit) |
f(x) = max(0, x) |
[0, ∞) |
연산이 단순하고 양수 영역에서 기울기 소실이 전혀 없어 현대 딥러닝 은닉층의 사실상 표준(Default)으로 가장 널리 사용. |
| Leaky ReLU / GELU / Swish |
변형 활성화 함수군 |
(-∞, ∞) |
음수 영역에서 뉴런이 죽는 Dying ReLU 문제를 보완. 트랜스포머(BERT, GPT 등) 최신 LLM 및 딥러닝 모델에 핵심 채택. |
소프트맥스
(Softmax) |
f(xᵢ) = eˣⁱ / Σeˣᵏ |
(0, 1), 총합 = 1 |
모든 노드의 출력 합을 1로 정규화하여 각 클래스별 발생 확률을 계산하는 다중 클래스 분류(Multi-class Classification) 출력층 전용. |
2. 활성화 함수의 기본 개념 및 노드 구조
신경망에서 쓰이는 계산요소 또는 노드는 비선형적이며 대개 아날로그인데 현재의 디지틀 회로에 비하여 속도면에서 매우 느리다.
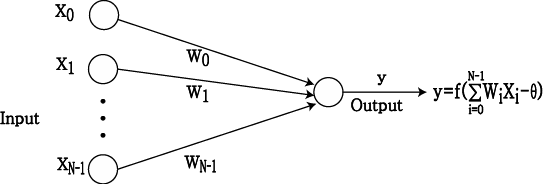
가장 간단한 노드는 아래그림에서 보는 바와 같이 N개의 입력을 받아 N개의 연결강도의 백터들과 곱해져서 특정한 출력함수 (activation function, transfer function) 를 거쳐 출력을 내게 된다.
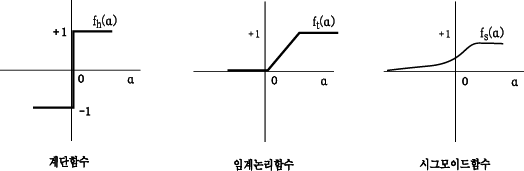
노드는 내부적인 임계값이나 오프셋 θ, 그리고 비선형 함수의 형태에 따라 특정지워진다. 신경망에서 많이 사용되는 대표적인 비선형 함수로는 계단함수(hard limiter), 임계논리(threshold logic), 그리고 S자 형태와 시그모이드(sigmoid)형 등이 있다.
그 중에서 가장 많이 쓰이는 것은 시그모이드 함수이다. 이들보다 더욱 복잡한 노드의 형태는 시간적인 총합 (temporal integration) 또는 시간에 종속적인 것들, 그리고 단순한 합이 아닌 복잡한 수학적 연산을 포함하는 것들이다.
3. 학술 연구 및 이론적 관점
인공 신경망 모델에서 뉴런의 주요 기능은 입력과 연결 강도의 가중합 NET 를 구한 다음 활성화 함수에 의해 출력을 내보내는 것이다. 따라서, 어떤 활성화 함수를 선택하느냐에 따라 뉴런의 출력이 달라질 수도 있다 .......
할머니를 쳐다보고 있다고 가정하자. 할머니를 쳐다보는 것은 할머니를 부호화하는 마디 (node) 를 활성화시킨다. 할머니가 다른 곳으로 가버린다면, 마디의 활성화가 차단된다. 그렇기는 하지만 마디가 가지고 있던 활성화를 할머니가 가져가버리지는 않는다.
우리는 이웃하는 마디의 뒤이은 활성화가 할머니 마디를 외측으로 억제할 것이라고 생각할 수도 있다 ...... 할머니가 사라지고 난 한참 후에도 할머니 망령으로 인해서 괴로움을 당하지 않도록 하기 위하여 소멸요인을 집어넣기로 하자. 그렇게 되면 우리에게는 어느 누구도 놀라지 않을 등식 하나가 남는다 :
✦ 활성화 = 흥분 - 억제 - 소멸
그러나 이 등식은 너무나 일반적인 것이어서 우리에게 알려주는 것이 많지가 않다. 먼저 흥분을 고려해보자.
활성화는 흥분의 단조함수임에 틀림없다 : 흥분이 증가함에 따라서 활성화도 증가한다. 그렇기는 하지만 우리는 이 두 가지가 완전히 직선적 방식으로 관련되어 있다고 생각하지 않는다. 왜냐하면 마디 또는 신경세포가 활성화될 수 있는 정도에는 한계가 있기 때문이다. 활성화가 흥분과 함께 끝없이 증가할 수는 없다
......Grossberg (1980) 는 다음과 같은 방식으로 흥분이 활성화에 공헌한다고 제안한다 :
✦ 활성화의 증가 = (최대 활성화 - 현재 활성화) = 흥분
이 등식은 단지 마디가 최대 활성화에 가까울수록 흥분성 입력에 덜 의존한다는 것을 의미한다. 이 개념을 보다 명확하게 이해하기 위해서 활성화와 흥분을 일단 접어두고, 돈을 가지고 생각해보자. 가난한 사람에게는 100,000 원이 큰돈을 의미한다. 자신의 재산을 상당히 증가시키기 때문이다. 동일한 액수라도 억만장자에게는 거의 아무 것도 의미하지 않는다. 이미 가지고 있는 것에 비하면 무시할만한 액수만을 더해주기 때문이다 ....... 활성화는 신경회로망의 돈, 즉 통용화이다 ........ 이와 유사한 생각을 억제에 적용할 수 있다 ........
........ 만일 출력함수가 S 자 형태 또는 시그모이드 형태를 취하면 시스템은 우리가 원하는 대로 작동한다. 시그모이드 출력함수를 갖는 마디는 억누름 역치 (quenching threshold) 를 갖는다. 억누름 역치란 특정한 수준 이상의 활성화는 증폭되고 수준 이하의 활성화는 억눌린다는 것을 의미한다. 실제 신경세포도 시그모이드 출력함수를 갖는 것으로 보인다 .......