기계 번역
인공지능 입문 - 그림으로 풀어본 : 도우치 준이치 지음, 최기선 옮김, 미래사, 1992, Page 129~141
기계번역의 번역방식은 크게 나누어 직접변환 방식, 피벗 방식, 간접변환 방식의 세가지가 있다.
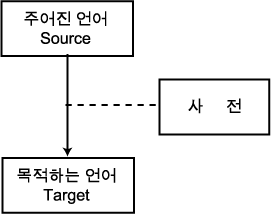
기계번역의 방식으로서 가장 단순한 것은, 주어진 언어의 단어를 번역하고자 목적하는 언어의 단어로 치환한 다음, 그 단어의 나열 순서를 목적하는 언어에 맞게끔 바꾸는 방식이다. 이러한 번역방식을 직접번역 (Direct Translation) 방식이라 부른다. 사람이 번역을 할 때 보통 이 방식을 쓴다고 생각되어, 수작업에 의한 번역과 비슷하다고 할 수 있다. 이 방식에서는, 단어 변환시 대응하는 단어를 찾아야 하는 번거로움 외에도 단어를 바꿔쓰는 규칙의 수도 많기 때문에 현실성이 적다. 그러나 단어와 어순의 차이가 거의 없는 한국어와 일어간의 기계번역에는 적용이 가능하다.
그림 1 직접변환 방식
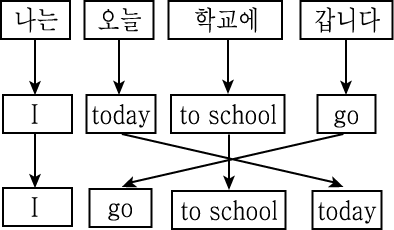
그림 2 직접변환방식에 의한 번역
이 방식은,
주어진 언어를 언어의 종류에 관계없는 중간표현으로 변환하여 이 중간표현으로부터
번역하고자 목적하는 언어를 만들어내는 방식이다. 이와 같이 하나의 중간표현을
매개로 하는 방식을 피벗 (pivot) 방식이라고 부른다.
이 방식에서는, ① 주어진 언어를 중간표현으로 변환하는 해석 단계 ② 중간표현에서 목적하는 언어로 변환하는 생성 단계의 두 단계로 크게 나눌 수 있다. 여기서 중간표현이라 함은, 모든 언어의 의미를 모두 표현할 수 있는 일종의 인공적 형식논리언어이다. 모든 언어의 중간에 위치하여 언어의 의미를 표현할 수 있다 하여 중간표현이라고 부른다. 이러한 중간표현을 피벗(혹은 축)으로 삼아 언어간의 번역을 한다 하여, 이러한 번역 방식을 피벗 방식이라고 하는 것이다.
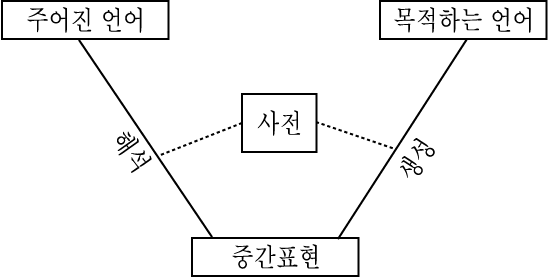
그림 3 피벗 방식
이러한 중간표현을 통하면, 영어와 한국어간뿐만 아니라 모든 언어간의 번역이 쉽게 이루어질 수 있다. 그러나 이러한 모든 언어의 의미를 표현해낼 수 있는 중간표현을 찾아내는 것이 어렵기 때문에, 실제로는 다음에 서술되는 간접변환 방식이 많이 사용된다.
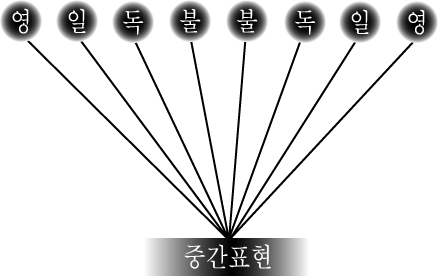
그림 4 다언어간 번역
간접변환
(transfer) 방식이란, 언어별로 그 언어에 알맞은 내부표현을 정의한다. 따라서 한국어와 영어간의
번역을 한다면, 한국어의 구조에 맞는 내부표현과 영어의 구조에 맞는 내부표현을
각기 정의한다.
번역 방식은, 한국어에서 영어로 번역을 한다고 하면,
① 한국어 문장을 한국어 내부표현으로 변환하는 단계 ② 한국어 내부표현에서 영어의
내부표현으로 변환하는 단계 ③ 영어의 내부표현에서 영어 문장을 생성하는 단계의
삼 단계로 나눈다.
피벗 방식의 번역하고자 하는 언어를 중간표현인 피벗을 해석하여, 그로부터 직접 목적하는 다른 언어로 생성하는 것과 비교해 보자. 피벗 방식에는 모든 언어의 공통인 중간표현을 사용하는데 반하여, 간접변환 방식에서는 각 언어별로 내부표현을 정의하여 각 언어의 내부표현간의 변환 단계가 중간표현을 대신한다. 이러한 방식은 각 언어 고유의 내부표현을 경유함으로써 간접적으로 변환한다 하여 간접변환 방식이라 부른다. 현재 개발되어 있는 기계번역 시스템의 대부분이 이 방식을 쓰고 있다. 단지 내부표현의 수준이 직접변환에 근사한 것에서부터 피벗 방식에 가까운 것까지 다양하다.
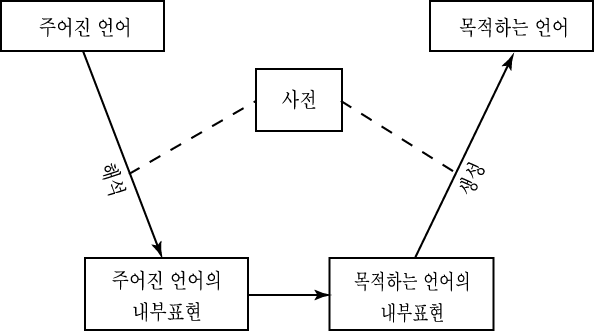
그림 5 간접변환 방식
이들 번역 시스템은 아주 효율적이어서 통역이나 번역자가 더 이상 필요없는 것일까? 그렇지는 않다. 유용하기는 하지만 번역자가 불필요한 정도는 아니라는 것이 지금까지의 수준이다 ......
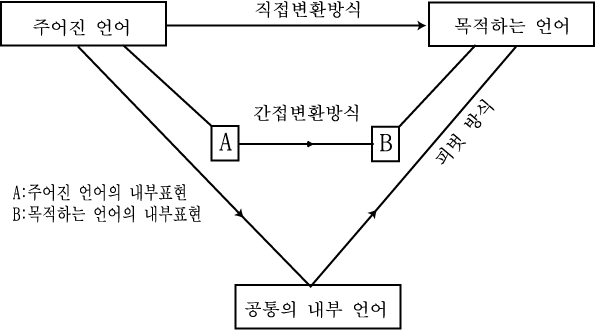
그림 6 3개의 변환방식
한국어에서 영어로의 번역에서는 대개 간접변환 방식을 사용한다. 해석 방법으로는, 한국어에는 격문법이, 영어에는 확장천이문법이 많이 쓰인다. 그림 7 은 간접변환 방식에 의한 한국어에서 영어로의 번역에 대한 개념을 보여주고 있다.
한국어에서는 구문해석과 의미해석을 통해 그 의미를 표현하는 내부표현을 얻는다. 다음, 한국어의 내부표현을 영어의 내부표현으로 변환하고, 최종적으로 영어의 내부표현에서 영문을 생성한다. 이 예에서는 내부표현으로 격구조를 사용하고 있다. 이 외에도 해석트리를 내부표현으로 하는 것도 있다. 또한 변환방법으로 생성규칙 (production rule) 을 많이 사용한다.
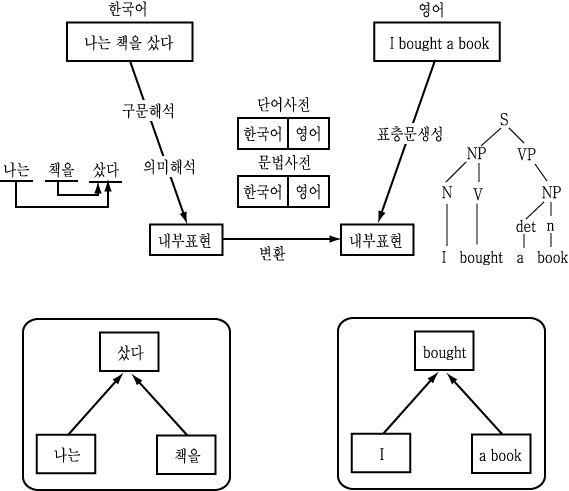
그림 7 간접변환방식에 의한 번역
유럽과 미국에서는 기계번역 시스템에 의한 번역이 비교적 오래되었다. EC 에서는 1982년에 이미 라메테크사가 개발한 SYSTRAN 이라는 기계번역시스템을 도입하여 각종 언어간 (영어, 불어 등) 의 번역에 사용하고 있다.
한편 한국어와 외국어간의 기계번역은 언어구조의 차이 등을 이유로 개발이 지연되어 왔다. 그러던 것이 1985년 한국과학기술연구원 시스템공학연구소에서 일본 후지츠와의 국제 공동연구로 일-한 기계번역 시스템을 완성하여 1990년도부터 상용화하였다. 한-일 기계번역 시스템도 아울러 시스템공학연구소에서 연구하고 있다.
영-한 기계번역 시스템은 과학기술처 국책연구로서, 1988년부터 한국과학기술연구원 시스템공학연구소와 한국과학기술원 인공지능연구센터와의 공동연구로 개발중이다. 이 시스템은 MATES/EK로 불린다. MATES/EK는 Machine-Aided Translation Environment for English-to-Korean의 약자이다. 이 연구개발 과제는, 국내 기업체와의 산학연 공동연구로서, 완성된 소프트웨어는 국내 자체 기술로서, 영어의 해석은 물론 한국어 부분까지 외국의 기술도입 없이 완성한 대규모 소프트웨어로 국내 최초를 기록할 것이다. 이 시스템은 1992년 중에 완성된다. 기계번역 방식으로는 간접변환 방식을 채용하였다.
한편, 한국과학기술원 전산학과에서는 일본 NEC와의 국제공동연구로 영-한 및 일-한 기계번역 시스템을 1991년에 완성하였다. 피벗 방식을 채용한 상용화된 영-일 기계번역 시스템을 영-한 기계번역으로 적용한 것으로서, 한국어 생성만을 한국과학기술원에서 개발하였다. 이 시스템은 피벗 방식이므로, 영어 해석과 일어 해석이 NEC에서 개발되어, 영-한, 일-한은 물론, 중국어, 타이어 등의 다른 언어에도 적용이 가능하다.
또, 서울대학교 컴퓨터공학과에서는 IBM과의 국제 공동연구로 영-한 기계번역 시스템의 시제품을 1991년 완성하였다. 영어 해석 부분은 미국 IBM연구소에서 개발하였으며, 한국어 생성 부분은 서울대학교에서 개발하였다 이 시스템은 기계번역 방식 중에서 간접변환 방식을 채용하였다.
그러면 기계번역의 수준은 어느 정도일까? 한국어 문장을 영어로 옮기고, 이 영문을 다시 한국어로 바꾼 재미있는 예를 보아주기 바란다.
..............
기계번역을 가장 필요로 하는 곳은 국제연합 (UN) 과 EC 등 국제기관이다. EC에는 영국, 프랑스, 서독, 이탈리아, 네덜란드, 벨기에, 룩셈부르크, 덴마크, 그리스, 아일랜드, 터키, 스페인의 12개국이 가맹되어 있으며 9가지 언어를 공식어로 사용하고 있다. 따라서 조합하면 81개의 번역작업이 필요하게 된다. EUROTRA 라고 부르는 9개 언어간, 81방향의 번역을 행하는 언어자동번역 시스템 개발에 착수하였다.
다언어번역으로 서독에서는 영어, 불어, 러시아어, 독어, 에스페란토어의 5언어간의 상호번역을 목표로 한 SUSY라는 시스템이 1974년부터 개발되고 있다.
프랑스에서도 1960년부터 ARIANE 78이라는 영어, 불어, 독어, 러시아어, 일어간의 번역 시스템 개발에 착수하여, 이미 시제품이 나와 실제로 가동되고 있다.
미국에서는 영어를 베트남어와 러시아어로 번역하는 시스템 LOGOS, 중국어를 영어로 번역하는 POLA 등을 개발하고 있다.
캐나다에서도 영어를 불어로 번역하는 시스템 TAUM 을 개발하여 일기예보와 항공기보수 설명서 (manual) 에 사용하고 있다.
기계번역의 연구개발이 가장 왕성한 곳은 일본이다. 1984년 브라비스 인터내셔널이 일-영 번역시스템 PAK-II를 개발한 이래, 후지츠(富士通), 히타치(日立), NEC(일본전기) 등이 계속하여 같은 종류의 기계번역 시스템을 개발했다. 이중에서 중요한 것을 뽑아 정리하였다 (표 4-1). * 로 표시된 시스템은 PC 에서 사용할수 있는 것이다.
제 2 절에서 살펴본 대로 여러가지 번역 시스템이 개발되어 왔다. 그런데 이들 번역 시스템은 아주 효율적이어서 통역이나 번역자가 더 이상 필요없는 것일까? 유용하기는 하지만 번역자가 불필요할 정도는 아니라는 것이 지금까지의 수준이다.
현재 기계번역 시스템의 번역대상은 거의 과학기술 분야에 한정되어 있다. 그 이유는, 구문이 명확하고 사용되는 단어의 수가 한정되어 있으며 각 단위의 의미가 하나로 모아지기 쉽기 때문이다. 현재의 번역 시스템으로 문학작품을 번역하기에는 상당한 어려움이 있다. 특히 시나 한시 같은 예술적인 문학을 번역하는 데는 거의 무력하다 할수있다. 이런 이유로 상당히 한정된 번역 대상만을 위한 시스템이 만들어지게 된것이라 생각된다.
또한 기계번역상의 커다란 문제점의 하나는, 원문의 의미가 애매한 경우에 생긴다. 애매한 문장의 의미를 해석하기란 인간에게도 어려운 일이다. 그러므로 컴퓨터에게 이것을 시킨다는 것은 현재의 기술로는 불가능한 일임에 틀림없다. 따라서 원문을 컴퓨터에 입력하기 전에, 컴퓨터가 이해할 수 있도록 문장을 손보지 않으면 안된다. 이러한 작업을 전(前) 편집 (pre-edit) 이라 한다.
결국 기계번역 시스템을 사용할 때, 원문을 입력하는 외에 전편집과 후(後) 편집 (post-edit) 을 반드시 해야만 하는 상황이다. 따라서 앞으로의 번역 시스템은 될 수 있는 한 이런 작업을 줄일 수 있는 방향으로 나아가야 할 것이다.