문자와 음성의 인식
인공지능 입문 - 그림으로 풀어본 : 도우치 준이치 지음, 최기선 옮김, 미래사, 1992, Page 161~172
1991년, 한국과학기술원 인공지능연구센터에서는 노트패드 컴퓨터 개발과제를 시작하였다. 정부 및 10개 기업체와 공동개발의 형태를 취한 것으로서, 그 중심 과제는 필기체는 문자입력장치이다.
일본에서는 1983년 이후, 필기문자 입력장치가 급속히 보급되었다. 1984년에는 마쓰시다(松下)전기에서 손으로 쓰는 워드프로세서가 발매되어 화제를 불러일으켰고, 자판(키보드)을 싫어하는 사람들에게 인기가 있었다. 그 외에도 NEC, OKI, NTT, 후지츠, 전자총합연구소 등 대기업과 국립연구소 등에서 계속하여 개발되고 있다.
필기문자 입력장치는 입력판(tablet) 위에 전용펜을 사용하여 문자를 쓰면, 2, 3초 이내에 인식되어 디스플레이상에 문자가 표시된다. 필기문자는 '해서(楷書 : 글자체의 하나)체로 또박또박하게'라는 조건이 붙는 것이 거의 대부분이긴 하지만, 인식률은 98%, 99%라는 높은 수준에 달하는 것이 많다.
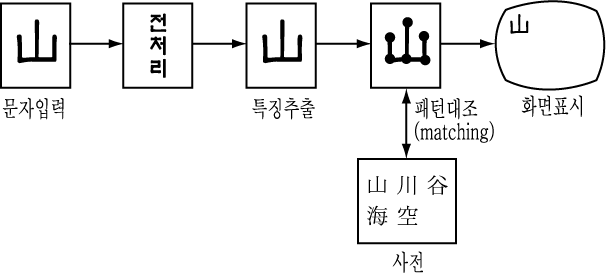
필기문자의 인식은 일반적으로 다음의 방법으로 행해진다.
① 우선, 입력판 위에 씌어지는 문자의 펜이 위치하고 있는 좌표, 획, 획수, 필순 등의 데이터를 1문자분의 기억장치에 저장한다.
② 다음은, 이 데이터에 대해 손의 진동에 의한 잡음과 여분의 정보 등을 제거하는 전(前)처리를 행한다.
③ 전처리를 행한 데이터에서 특징을 추출한다.
④ 추출된 특징 데이터와 사전 내에 이미 등록되어 있는 표준문자의 특징데이터를 패턴매칭(pattern matching)한다. 여기에서 패턴이 일치하는 것을 입력문자라고 판정하는 것이다.
그림 1 문자인식 방법
필기문자의 기본적인 인식방법은 앞에서 말한 대로인데, 여기에서 가장 중요한 것이 특징추출 작업이다. 인간은 한눈에 이것이 무슨 글자인지 판단하는데 비해 컴퓨터가 판단하기 위해서는 수치로 그 특징을 표현하지 않으면 안된다. 그러면, 특징추출 방법에는 어떤 것이 있는지 알아보자.
D.P법
NEC에서는 DP(Dynamic Programming)법이라는 방법을 사용하였다. 이것은, 문자의 한 획에서 몇 개의 점을 추출하여 이것을 연결하는 직선의 방향과 길이를 표준문자의 그것과 비교하여 판정하는 것이다. 예를 들면, 한자의 '一'과 일본어 히라가나의 'へ'의 구별은 이 방법으로 가능하다. 또한 '人'과 같은 2획의 문자는, 사전에 있는 2획짜리 문자 전체와 대조하여 가장 근사치를 선택한다.
NTT와 NHK
NTT에서는 입력문자에 대해 한 획의 시점, 중간점, 종점의 3점과 표준문자의 같은 3점과의 거리를 계산하여, 이 차이가 가장 짧은 문자를 같은 문자로 인식하는 방법을 사용하고 있다.
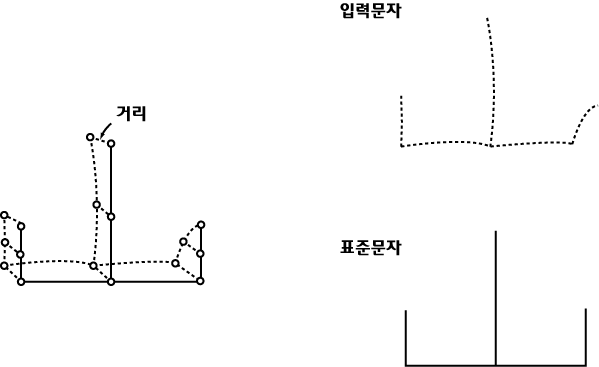
그림 2 NTT의 문자인식
NHK 시청과학연구소에서는 뇌의 기능을 모방하여 문자를 인식하는 시스템을 개발하고 있다. 이 시스템은 밖에서의 자극을 단순형세포가 받아들여 반응하고, 또한 복잡형세포가 이 자극을 선택하여 부분자극을 커다란 특징으로 통합하는 구조로 되어 있다. 최종적으로 10개 세포에 자극이 집약됨으로써, 문자(현재는 숫자만)를 식별한다.
셀특징 인식방법
전자총합연구소에서는 문자를 등분하여 하나하나의 구획(cell)으로 보고, 어떤 길이의 직선과 곡선이 있는가를 판단하여 인식하는 '셀특징 인식방법'을 채용하고 있다.
이것을 응용한 것이 삼양전기(三洋電機)의 '탁상형 필기문자 독해장치'이다. 이것은, 특수한 용지에 씌어진 문자원고를 복사기와 같은 요령으로 세트하면, A4판 원고용지 1매분(17×22문자)을 약 3분에, A5판(20×12문자)을 약 2분에 판독한다.
장점
인간과
기계가 음성으로 대화한다는 것은 인류의 꿈으로, 오래 전부터 연구되어 온 주제이다.
음성으로 기계와 대화할 때의 장점은, 다음과 같다.
문제점
한편, 음성인식에 관해서는 다음과 같은 문제가 있다.
이상과 같은 문제점이 있기 때문에, 예를 들어 '노고지리'라고 발음해도 '노고리비'로 듣는다거나, '아빠'라 한 것이 '아파' '업어' '앞발'이라고 해석되는 등의 사태가 일어난다. 이것이 음성인식의 어려움이다.
발음하는 방식
음성인식은 발음하는 방식에 의해 ① 단어음성인식 ② 연속음성인식의 두 갈래로 나뉜다. 단어음성인식이란 단어와 단어 사이를 구별하여 발음하는 문장을 인식하는 것으로, 최근의 상용 시스템은 거의 여기에 속한다. 한편, 연속음성인식은 단어와 단어 사이를 구별하지 않고 연속하여 발음하는 문장을 이해하는 것으로, 단어음성인식에 비해 어렵다.
말하는 사람
또 말하는 사람에 관해서는 ① 특정화자 방식 ② 불특정화자 방식의 두 가지 방식이 있다. 특정화자 방식이란 미리 말하는 사람의 음성을 등록하여 두는 방식이다. 이에 비해, 이용자를 한정하지 않고 불특정다수의 음성을 인식하려는 것이 불특정화자 방식이다. 더욱이 동시에 여러 사람이 말해도 각각을 나누어 듣는 연구도 진행되고 있다.
한국어의 입력방식
한국어의 입력방식에는 ① 단음절입력 ② 어절단위입력의 두가지가 주류이다. 단음절입력이란 '아' '이' '우' '에' '오'와 같이 한 음절씩 구별하여 입력하는 것이다. 한국어는 10,000여 자의 음절이 가능하므로 실상 매우 어려운 작업이 된다(이에 비해 일본어는 101개의 음절이기 때문에, 101개의 음절이 인식될 수 있으면 모든 일본어의 인식이 가능하다). 한편, 어절단위입력은 '나는' '오늘' '학교에' '간다'와 같이 어절로 나누어 입력하는 것이다.
단지 한마디 한마디를 정확히 인식하는 것만이 아니라, 발음되는 문장 전체의 의미를 이해하려는 시도를 음성이해라 부른다. 음성이해는 기본적으로는 '음성인식+자연언어 이해'인데, 음성인식기술이 아직 미숙하기 때문에 이 이해는 단순한 자연언어 이해에 비해 수준이 떨어진다.
음성이해는 보통 다음과 같은 순서로 행해진다.
① 입력된 음성신호를 일정
길이(매초 10~20m)의 단구간으로 구분한다.
② 각각의 단구간을
음향분석하여 특징파라미터(주파수 스펙트럼과 음성파워 등)를 추출한다.
③
음소단위로 분할(segmentation)하고 각 분할단위(segment)의 음소인식을 행한다.
여기에서 음소계열이 만들어진다.
④ 단어사전과 비교하여 단어를
예측한다.
⑤ 구문해석을 하여 예측단어가 정확한가를 검증한다.
⑥ 의미적으로 타당한가를 조사한다. 정확하지 않으면 구문해석을 다시
한다.
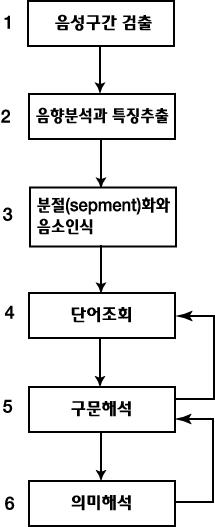
그림 3 음성이해의 과정
ARPA계획
음성이해에 대한 연구는, 미국방성의 ARPA의 지원을 받은 1971년부터의 5개년계획 프로젝트가 최초이다. 이 프로젝트에서 최초로 개발된 것이 카네기메론 대학의 HEARSAY 1이다. 이것은 체스를 음성으로 입력할 수 있는 것으로, 체스용어 31개를 인식하며 이해도는 79%였다. HEARSAY 1은 이해능력이 점점 강화되어 뉴스정보의 음성검색이 가능한 HEARSAY II로 발전하고 있다. 이 시스템은 1,011개의 단어를 인식하며 이해도는 90%에 달하고 있다.
또한 카네기메론대학에서는 HEARSAY 1과 별도로 DRAGON이라는 체스용 음성이해 시스템도 개발하고 있다. 이것은 194개의 단어를 90%의 이해도로 인식할 수 있다. DRAGON과 HEARSAY 1이 발전한 것이 HARPY라는 정보검색 시스템이다. 이것은 1,011단어를 인식하며 이해도는 95%로 높다.
또 HEARSAY II의 등록화자가 한 명인데 비해 HARPY에서는 5명으로 증가했다.
1976년에는 HWIM이라는 여비상담·관리에 관한 음성이해 시스템이 실제로 가동되었다. 이것은 1,097단어를 인식하는데, 이해도는 44%로 상당히 낮다. 등록화자수는 3명이다.
같은 해에 SDC사(System Development Company)가 잠수함 정보검색 시스템을 개발하였다. 이것은 1,000단어를 인식하는데 이해도는 24%에 그치고 있다. 등록화자수도 1명이다.
일본의 연구
일본에서도 미국보다 조금 늦게 연구가 진행되고 있다. NTT에서는 말로 신칸센(新幹線) 열차의 좌석을 예약하는 시스템 VOICEQA를 개발했다. 이것은 예를 들면, "7일자 메아리 2호로 도쿄에서 오사카까지의 지정권을 두 장 부탁합니다."라고 어절에 따라 구별하여 발음하는 것이다. 112단어를 인식하며, 9명의 화자에 대해 96%의 이해율을 가지고 있다.
교토(京都)대학에서도 LITHAN이라고 불리는, 컴퓨터 이용상태에 관해 문의하는 시스템을 개발하였다. 이것은 101단어를 식별하며, 10명의 화자의 200개 질문에 대해 66%를 이해한다.
오사카(大阪)대학
산업연구소에는 1984년부터 5년계획으로, 어휘수 3,000의 불특정화자용 음성이해
시스템을 개발하고 있다. 처리는 음운식별, 단어후보의 추출, 언어처리, 응답처리의
순으로 진행되는데, 단어후보 추출시 지식베이스에 있는 주제와 단어의 의미정보를
참조하는 것, 구문. 의미해석을 통해 최종적으로 입력 또는 이해하는 것이 특징이다.
표 1 중요한 음성이해 시스템
|
시스템명 |
기 능 |
어휘수 |
이해도 |
화자수 |
개 발 |
|
HWIN |
여객관리 |
1097 |
44 |
3 |
미 BBN사 |
|
HARPY |
뉴스정보의 검색 |
1011 |
95 |
5 |
카네기메론 |
|
HEARSAY II |
뉴스정보의 검색 |
1011 |
90 |
1 |
카네기메론 |
|
VCDMS |
잠수함의 정보검색 |
1000 |
24 |
1 |
미 SDC사 |
|
CSAP |
레저 특허문 |
1000 |
91.1 |
- |
IBM |
|
KEAL |
전화번호안내 |
60 |
91 |
- |
CNET(불) |
|
LITHAN |
컴퓨터 이용상황에 |
101 |
66 |
10 |
교토대 |
|
VOICE QA |
좌석예약 |
112 |
96.5 |
9 |
NTT |
|
- |
동화 |
165 |
72.7 |
- |
山梨大 |