자연어 처리
인공지능의 원리와 실무사례 : 이광형. 홍유식. 김인택. 진현수. 민준영. 주영훈 공저, 동영출판사, 1998, page 97~124
|
|
지능을 가진 Robot 가 우리인간의 말을 어떻게 이해하고 구문 해석하여 우리가 내린 명령에 대답을 하고 행동하는데 가장 기본이 되는 Turbo Prolog 의 List 구조를 이해하고 간단한 문장 변환 프로그램과 ELIZA 정신병환자 프로그램에 관해서 알아본다.
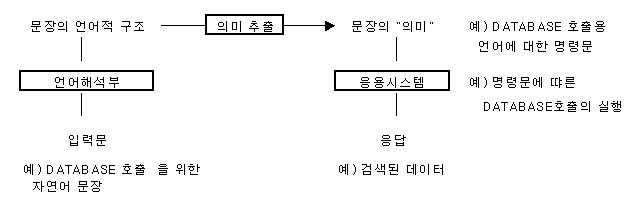
어떠한 것을 이해한다는 것은 이를 한 표현으로부터 다른 표현으로 변환시키는 것을 뜻한다. COMPUTER 가 언어를 이해할 수 있다는 것은 입력문 (자연어) 을 응용시스템이 조작 가능한 표현형 (의미표현) 으로 컴퓨터가 변환할 수 있음을 말한다. 이러한 자연어이해는 [그림 1] 로 설명된다.
[그림 1] 자연어 해석 시스템의 일반적 구성
자연어 이해 과정에서 다음에 설명되는 5 가지의 자연어 처리기술로 분류할 수 있다.
(1) 형태소 해석
자연어 처리를 위한 단어의 최소단위인 형태소로 분리하는 형태소 해석에서는 입력된 문장을 구성하는 단어를 문장의 ELEMENT 로 분석하는 것인데 형태소 사전이 준비되는 것으로서 문제가 없어지는 것이 아니고 많은 경우에서는 한국어나 일본어의 어형변화 및 첨가에서 발생하는 어절분리가 애매모호한 부분이라든가 영어에 있어서의 시제변화 동사의 활용 등에서 규칙변화가 아닌 한에는 사전의 ENTRYWORD 로서는 해결되지 않는다. 따라서 입력된 문장을 형태소 해석하는 것이 불가능해지는데 이러한 어형 변화 규칙은 비교적 단순하여 COMPUTER 가 해석하는 것은 그리 어렵지는 않다. 다만 한국어의 경우에는 띄어 쓰기가 확립되어 있다 하더라도 작문자의 판단이 정확하지 못한 철자법이 발생할 수 있으므로 유의할 필요가 있다. 현재는 형태소 해석이 불가능한 경우에 대해서 구문해석 기법을 병행 처리함으로써 형태소 해석의 정도(精度)를 향상시키는 연구가 진행중이다.
(2) 구문해석
형태소 해석 결과는 구문해석에 의해 문법적으로 타당한 단어의 나열인가가 분석된다. 구문해석에 사용되는 문법규칙이 CONTEXT FREE GRAMMER 규칙인 경우는 고속의 구문해석 ALGORITHM 이 개발되어 있는데 구문해석에서 중요한 문제는 구문해석에 사용하는 대규모적인 문법규칙이 작성되어 있지 않고 있다는 것이다. 문법 규칙의 작성에는 언어학자들의 협력을 필요로 하며 작성된 문법규칙을 사용하여 기계 상에서 실제의 문장을 입력하여 반복적으로 실험해야 한다. 그렇게 하지 않으면 문법규칙에 불필요한 애매함이 부가되기 때문에 바람직하지 못한 구문해석의 결과가 다수 발생하여 이후의 처리에 어려움으로 남게 되는 경우가 때때로 생긴다. 또한 구문 적인 다중성 (ambiguity) 이나 불확실성 (Vagueness) 의 문제를 해결하기 위해서 현재 의미해석의 기술을 병행하는 연구도 진행되고 있다.
(3) 의미해석
의미해석의 자연어 처리기술은 현재 미해결된 문제가 매우 많다. 특히 COMPUTER 내부에서 의미를 어떤 형식으로 표현하여 어떻게 조작하는가에 대한 문제가 많이 남아 있는데 비록 의미의 형식을 정했다 하더라도 구문해석 결과에서 어떻게 그 형식의 의미를 추출해야 하는가가 문제이다. 또한 구문해석에서 발생한 문제를 제한시키기 위하여 의미해석 기술이 사용되기도 한다. 예를 보자.
[문장1] 소년은 냇가에서 수영하고 있는 소녀를 보았다.
[문장2] 소년은 다리 위에서 수영하고 잇는 소녀를 보았다.
위의 문장에서 '냇가에서' 와 '다리 위에서' 가 어떠한 구문구조로 해석되어야 할 것인가는 구문 적으로는 해결이 되지 못하고 의미관계를 분석하는 의미해석 단계에서 비로소 결정될 수 있음을 알 수 있다. 이외에 동음이의어 및 문법적 다기능 어가 있는데 의미해석 기술에서도 현재 해결이 어려운 경우가 많이 발생한다. 따라서 현재의 처리기술로서는 문맥 해석 기술로 처리하거나 대상에 밀착된 표현을 사용함으로써 인간이 오히려 문제를 줄이는 방법을 사용하고 있다.
(4) 문맥해석
이 문맥해석을 위해서는 주어진 문장을 이해하거나 상황을 인식할 수 있는 기능을 컴퓨터가 보유하고서 대화의 흐름을 파악하도록 지식의 상호관계를 모듈화 해 줄 수 있어야 한다.
(5) 언어생성
문장의 구조와 의미표현의 대응이 "이해"의 중심과제
이와 같이 자연어 이해의 문제는 문장이라는 표면상의 표현형식과 의미표현 사이의 대응관계를 취하는 문제로 된다.
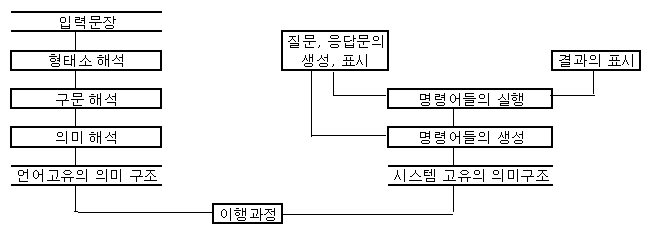
[그림 2] 자연어 이해의 과정
(1) 일 대 일 변환
각각 문장이 그에 관련된 유일한 목적 표현으로 변환된다. 예로써 많은 프로그래밍 언어들에서 존재하는 산술적 표현 언어들을 생각해
보자. 다음과 같은 변환이 일어날 수 있다.
:= |
(2) 다수 대 일 변환
풍부한 어휘력을 가진 언어로부터 작고 단순한 목적 표현으로 변환된다. 다수 대 일변환은 이해 시스템이 목적 표현이 근원 언어에서 표현되어질 수 있는 여러 방법들에 대해 알아야 된다는 것을 필요로 한다. 예를 들면 다음과 같이 핵심 단어 색출 시스템에 대한 영어 문장에서 일어날 수 있는 다수 대 일 변환을 발견할 수 있다.
Tell me all about the last. I'd like to see all the stories (SEARCH KEYWORDS I am interested in the last |
(3) 일 대 다수 변환
생각되어질 수 있는 여러 복적 표현들 중에서 정확한 선택을 하기 위해 많은 양의 비언어 지식을 요구한다.
자연어 구문해석의 목적도 인공언어의 경우와 마찬가지로 부분 표현끼리의 상호관계를 나타내는 구조를 만들어 내는 것이다. 인공언어의 경우는 언어설계자가 처리 상황에 알맞은 문법을 자유로이 설정할 수 있는데 반해 자연어의 경우는 처리해아 할 문장의 집합이 우선 앞서 존재한다. 그때 존재하는 문장의 집합을 규정하는 문법을 설정하는 것이지 구문해석의 상황에 알맞은 문법을 가진 언어를 설계하는 것은 아니기 때문에 자연어의 구문해석은 그 만큼 어려워지는 것이다.
(1) 자연어 구문해석의 어려움
1) 자연어에는 많은 애매모호성이 있다. 즉 입력문 중의 동일 개소에 적용 가능한 규칙이 복수개 존재하는 수가 많고 어떤 규칙 적용이 최종적으로 올바른 결과에 이를 것인지가 규칙적용 시점에서는 판단 불가능하다. 따라서 구문해석 기법은 무언가의 형태로 이 비결정성을 일일이 살펴야 한다.
2) 자연어의 문법규칙은 명사나 동사와 같은 품사의 레벨만으로는 제한이 불충분하며 많은 애매모호성이 생겨 버린다. 이러한
애매모호성을 피하기 위해서는 동사의 활용성 명사의 수(단수, 복수)와 같은 단어의 형태적인 정보 의미적 정보 등을 필요에 따라
참조해야 한다.
3) 자연어의 문법이란 것이 객관적으로 존재하는 것은 아니다. 단순히 우리가 언어현상을 관찰하여 그것을 일반화시켜 놓은 데 지나지
않는다. 따라서 현존하는 문법체계가 언어현상 모두를 설명할 수 있을 것이라는 보장은 없고 설명할 수 없는 언어현상이 발견되면 이미
만들어진 문법규칙을 그에 맞추어 변경해야 한다. (계속되는 한글의 개정)
4) 자연어에는 예외적인 표현이 꽤 빈번히 나타나기 때문에 그들 모두를 처리할 문법의 규모는 매우 큰 것으로 된다. 극단적인 경우
하나의 단어를 위한 규칙만도 만들어야 한다. 이러한 대규모 문법을 자주 수정해야 하므로 문법 규칙의 표현이 간단하면서 알기 쉬울 것
또 규칙의 추가 수정이 용이하게 이루어지도록 모듈 구조로 되어 있을 것 등이 중요하게 된다.
(1) 문맥자유형 문법( Context Free Grammer : CFG )
형식언어의 문법에 적당한 표현력을 갖추고 있고 구문해석 알고리즘의 효율도 좋은 문법.
이 형식으로 문법을 표현할 경우에는 어떠한 성질을 가진 부분 표현이 모여서 보다 넓은 범위의 모임이 될 것인지를 다음과 같은 되쓰기 (rewrite) 규칙의 집합으로 나타낸다.
1. S → NP . VP . PP
2. VP → V . NP
3. NP → DET . N
4. NP → N
5. PP → PREP . NP
6. N → boy, letter, pen
7. DET → a, the
8. V → write, writes
9. PREP → with
단순한 CFG 로는 자연어가 갖고 있는 규칙성의 전부를 자연적인 형태로 다루기에는 어려움이 있다 .예를 들면 위의 문법을 정밀히 하여 영어에서의 <주어와 술어의 수의 일치>를 조사하도록 변경하기 위해서는 명사구 동사구를 나타내는 기호 NP, VP를 단수 복수의 구별을 지우기 위해 각각 NPS (단수 명사구), NPP (복수 명사구), VPS, VPP 와 같이 세분화하여 규칙1 이 나뉘어 지고 다른 규칙들도 그에 따라 세분화 시켜야 한다. 규칙을 정밀화함에 따라 필요 기호 수와 규칙이 조합적으로 증대하고 자연어와 같은 복잡한 문법을 쓰는 것은 거의 불가능에 가까워 진다.
리스트 구조
리스트 구조는 일반적인 구조의 일종인데 먼저 리스트 구조를 살펴본다면I LOVE Prolog 이것을 리스트로 나타내는 한가지 방법은 ['I'
'Love' 'Plorog'] 가 된다. 이 문장을 영문법에 따라서 분석하면 다음과 같은데 이것을 구문 분석이라고 한다. 이것을 리스트로 나타내면
[Subject('I'), verb('love'), object('Prolog')] 이다. 이것을 일반적인 구조로 나타내면 sentence (subject(noun('I')),
verb-phrase(verb(love), object(noun('Prolog')))) 이다.
리스트 구조의 정의
리스트 구조는 [요소1…..요소n]의 모양을 하고 있다. 여기서 요소 i는 상수, 변수, 구조
(리스트 구조도 포함) 중 어떤 것이라도 상관
없다. 특히 n = 0 일 때는 [ ] 로 나타내는데 이것을 공백 리스트라고도 한다. 이 정의에 의하면 다음은 모두 리스트 구조가 된다.
[ ]
[a], [A], [ __ ]
[a, b], [A, B], ,a, A, __ ] [[X, a], [Y, b], [Z, c]]
(a) [ H | T ] (b) [ H, I | T ] (c) [ H, I, J | T ] H H I H I J (d) [ [H] | T] (e) [ H | R ]| T ] (f) [[H | X], I | T] |
|
<리스트 1> |
<리스트 2> |
<실례화> |
[X, Y, Z]
[cat]
[X, Y|Z]
[ [the, Y]| Z]
[white | Q]
|
[john, likes, fish]
[X/Y]
[mary, likes, wine]
[[X, hare], [is, here]]
[P | horse]
|
X = john Y = likes Z=fish
X=cat Y=[ ]
X=mary Y=likes Z=[wine]
X=the Y=hare Z=[[is, here]]
P=white Q=horse |
이러한 리스트 구조로부터 어떤 요소 i 를 꺼내거나 새로운 요소를 삽입하기 위해서 패턴일치를 사용하는데 여기서는 이에 대하여
알아보기로 한다.
우선 리스트 구조를 그림으로 나타내는 방법을 알아보기로 하자.
(i) [a], [A], [pair (a, A)]
(ii) [a, b], [A, B], [pair (a, A), pair (b, B)]
(iii) [a, b, c], [A, B, C], [pair(a, A), pair(b, B), pair(c, C)]
이것을 그림으로 나타내면 다음과 같다.
(I) ㅡ [ ] ㅡ [ ] ㅡ [ ] |
그러면 이제 리스트 구조의 일치에 대해서 알아보자.
(a) [ a ] ≒ [ a ]
(b) [ a, b ] ≒ [ a, b ]
(c) [ A, a] ≒ [ c, D ], 이때 A=c, D=a 가 된다.
(d) [ A, [a, B], d ] ≒ [ p, [a, q], d] 이때 A=p, B=q 가 된다.
(e) [ a1, a2, ......a999] ≒ [A1, A2, ......A999] 이때 Ai=ai 가 된다.
우리가 한 영어 문장을 입력했을 때, 입력된 문장을 변환하여 다른 문장으로 응답하는 PROLOG 프로그램을 생각해 보자. 입력된 말에 대해 프로그래머에게 다시 이야기해 주는 이 프로그램은 다음과 같은 대화를 만들 수 있다.
프로그래머 : you are a computer
PROLOG 시스템 : I am not a computer
프로그래머 : do you speak french
PROLOG 시스템 : no I speak german
이 대화는 어느 정도 무리한 면이 있지만 양식을 갖춘 대화처럼 보인다. 다음의 단계를 따라가면 이 대화 부분을 생성하는 컴퓨터프로그램을 쉽게 작성할 수 있다.
1. 사용자가 타이핑한 문장을 입력한다.
2. 문장 내의 각 you를 I로 바꾼다.
3. 마찬가지로, 각 are을 am mot 으로 바꾼다.
4. french를 german으로 바꾼다.
5. do를 no로 바꾼다.
앞의 대화에서 처럼 주의 깊게 선택한 문장들에 이 방법을 적용하면 이 방법은 문장을 변환하여 어느 정도 양식을 갖춘 문장을 생성할 수 있다. 그러나 다음의 예처럼 모든 문장에 이 방법을 적용할 수는 없다.
프로그래머 : I do like you
PROLOG 시스템 : I no like
하지만 우선 단순한 문장에 대한 변환 프로그램을 작성하고 난 후 예처럼 서투른 출력을 내보내는 문장을 다루기 위해 나중에 프로그램을 수정할 수 있다. 한 문장을 다른 문장으로 변환하는 PROLOG 프로그램은 앞에서 설명한 방법을 이용하여 다음과 같이 작성할 수 있다. 첫째 우리는 원래의 문장과 변환된 문장 사이의 관계를 알아야 한다. 이 관계를 나타내기 위해 alter 라는 PROLOG 술어를 정의하여 alter(X, Y) 는 문장 X 를 변환하여 문장 Y 로 만드는 것을 의미하도록 한다. X 와 Y 는 문장의 각 단어들을 원소로 갖는 리스트로 생각하는 것이 편리하다. 이렇게 하면 문장을 [this, is, a, scntrnce] 처럼 표시할 수 있다. alter를 정의한 후 우리는 PROLOG 시스템에 다음과 같은 형태의 질문을 할 수 있다.
⇒ ?ㅡalter([do, you, know, french], X).
그러면 이 질문에 PROLOG 시스템은 다음과 같이 응답할 것이다.
⇒ X=[no, I, know, german]
여기서 입력 문장과 출력 문장을 일상적인 문장 표현 방식으로 나타내는 것에 대해 아직은 생각하지 말자. 이 교재의 뒤에서 우리는 구조를 판독하기 쉬운 형태로 입력하거나 인쇄하는 방법들에 대해 다룰 것이다. 현재는 단지 한 리스트를 다른 리스트로 변환하는 것만 생각하기로 한다. alter가 리스트를 취급하고 있으므로 alter 술어의 첫 번째 사실은 술어의 인수가 빈 리스트인 경우를 표현하여야 한다.
Alter([ ], [ ]).
즉, alter 술어는 위의 사실에 의해 빈 리스트를 빈 리스트로 변환할 것이다. 이처럼 alter 술어가 빈 리스트를 위급해야 하는 이유는 뒤에 설명하겠다. 다음으로 alter 술어의 주작업을 알아보면 다음과 같다.
1. 입력 리스트의 머리를 다른 단어로 변환하고 출력 리스트의 머리가 변환된 단어를 나타내도록 한다.
2. 입력 리스트의 꼬리를 alter를 적용하여 변환하고 변환된 꼬리를 출력 리스트의 꼬리로 한다.
3. 만일 입력 리스트의 마지막에 도달하면 더 이상 출력할 것이 없으므로 빈 리스트 ([ ])로 출력 리스트를 끝낸다.
이것을 PROLOG 언어와 유사한 언어로 바꾸면 아래와 같다.
머리 H
와 꼬리 T 를 가진 리스트를 변환하면 머리 X 와 꼬리 Y 를 가진 리스트를 생성하는데 여기서 X
는 단어 H 를 변환한 것이고 리스트
Y 는 리스트 T 를 변환한 것이다.
이제 우리는 한 단어를 다른 단어로 변환하는 것이 무엇을 의미하는가를 말해야 한다. 이것은 단어 X
를 단어 Y 로 변환하는 것을
표현하는 change(X, Y) 사실들을 저장하고 있는 데이터베이스를 유지하면 된다. 데이터베이스의 마지막에는 한 단어를 다른 단어로
변환할 수 없을 경우 그 자신으로 변환하는 사실을 나타내는 잡낭 (catch_all) 사실이 필요하다. 잡낭 사실을 두는 이유는 프로그램이
어떻게 동작하는가를 알고 난 후에는 명확해질 거이다. 잡낭 사실은 change(X, Y)
로 단어 X 가 그 자신으로 변환된다는 것을 의미한다. 위에서 열거한 단어들의 변환을 다루는 데이터베이스는 다음과 같다.
change(you, I)
change(are, [am, not]).
change(french, german).
change(do, no).
change(X, X). /* 잡낭 사실 */
여기서 "am not" 구를 change 사실의 한 인수만을 차지하도록 리스트로 취급했음을 주의하라.
이제 머리 A 와 꼬리 B 를 가진 리스트를 [A|B] 로 표현하는 것을 염두에 두고 위에서 기술한 alter 술어를 다음과 같이 PROLOG 언어로
작성할 수 있다.
alter([ ], [ ]).
alter([H|T], [X|Y] : - change(H, X), alter(T, Y).
이 프로시쥬어의 첫 번째 논리 절은 입력 리스트가 빈 리스트인가를 검사하는 것은 물론 입력 리스트의 끝에 도달했는지의 여부도 검사한다. 그 이유를 다음의 예로 알아보자.
?- alter([you, are, a, computer], Z).
이 질문은 alter 의 두 번째 논리 절과 부합되어 변수 H 는 you 를 나타내고 T 는 리스트 [are, a, compute] 를 나타낸다. 다음 changeP(you, 수행은 변수 X 가 단어 'I' 를 나타내도록 만든다. 따라서 변수 X 가 alter 고울의 출력 리스트의 첫 번째 단어는 'I' 가 된다. 다음 alter([are, a, computer], Y) 고울이 같은 규칙을 사용하여 단어 are 를 리스트 [am, not] 으로 바꾸고 alter([a, computer], Y) 고울을 생성한다. 이 고울을 수행하면 change(a, X) 와 부합이 되는 사실들을 데이터 베이스에서 찾기만 'a' 로 바뀐다. 다음 고울은 alter([computer], Y) 로 다시 두 번째 논리 절과 부합되어 change(computer, X) 고울을 수행한다. 이 고울은 전과 마찬가지로 잡낭 사실과 부합되어 computer는 그 자신으로 변환된다. 마침내 여기서 alter([ ], Y) 고울을 수행하면 첫번째 논리 절과 부합되어 출력 리스트로 내보낼 문장이 끝났음을 알린다. 따라서 PROLOG 시스템은 원래 질문에 다음과 같이 응답할 것이다.
Z=[I, [am, not], a, computer]
여기서 [am, not] 구는 리스트에 삽입된 대로 나타나는 것에 주의하라.
alter([ ], [ ]) 사실과 잡낭 사실 change(X, X) 를 첨가하는 이유가 이제는 명확해질 것이다. 보통 경계 조건을 검사해야 할 필요가 있을
때 이와 같은 사실들을 프로그램에 첨가한다. 위의 설명에서 입력리스트가 빈 리스트가 되거나 CHANGE 사실들을 모두 찾아보았을 때
경계 조건이 발생한다는 것이 분명하다. 이 두 가지 경계 조건이 발생했을 때 어떤 행동을 수행할 수 있다. 예에서 입력 리스트가 끝나게
하고 CHANGE 사실들을 모두 찾고 난 후 어떤 단어가 다른 단어로 변환되지 않으면 단어를 그 자신으로 변환한다.
내장된 표준 술어는 Turbo PROLOG system 자체에 내장되어 있는 술어들이다. 일반적으로 이들 표준 술어는 통상의 Turbo
PROLOG 의 절로 표현할 수 없는 함수들로 구성된다. 그리고 이들은 ture 나 false
를 답하는 대신 keyboard 입력이나 화면 표시를 위해
사용되는 경우가 흔히 있다.
이 프로그램은 정신병환자가 의사가 없이도 COMPUTER CRT 를 이용해서 서로 간단한 대화를 주고받을 수 있는 프로그램이다. 컴퓨터에서 HOW ARE YOU THIS BEAUTIFUL DAY? 의 내용을 의사가 물어 보듯이 프로그램에서 언어가 자동 생성되고 환자가 이 내용에 해당하는 대답 : I DON'T KNOW, I FEEL BAD.을 COMPUTER KEYBOARD 로 TYPING 하면 프로그램에서 TRANSE 와 FRONT TOKEN 의 기능으로 다음과 같은 언어가 자동 생성되어 CRT에 DISPLAY 될 것이다. HOW DO YOU KNOW THAT? 그러면 이와 같은 기능이 어떻게 되는지를 알아보자. 우선 우리가 사용하는 언어도 알고 보면 DO YOU HAVE A BOOK? 의 대답으로는 YES, I HAVE A BOOK. ARE YOU A BOY? 의 대답으로는 YES, I AM A BOY. 와 같이 될 것이다. 즉 우리는 의문문의 주어와 동사는 긍정문으로 대답될 때에 YOU 를 I 로 바꾸고 동사 ARE 를 AM 으로 바꾼다. 이러한 것은 TRANS 의 기능을 이용해서 적절한 단어에 대응하게끔 바꿀 수 있다.
char *trans[ ] = {
"you", "Let's not talk about me.",
"think", "Why do you think that?",
"hate", "So you hate something - tell me more.",
그리고 목적어는 그대로 반복되어 긍정문으로 사용된다. 이런 원리를 컴푸터에 이용하기 위해서 한 문장을 HEAD
와 TAIL 로 나눈 후에
int head=0;/* head of topics queue*/ int tail=0;
/* tail of topics queue */ 프로그램은 환자가 입력한 응답을 단순히 RETURN
을 치거나 길이가 VERYSHORT 개의 #define SHORT 10
#define VERYSHORT 3 문자보다 짧은 반응을 넣으면 RESPOND( ) 의 호출함으로써 이전의 주제로 돌아가려고 한다.
if (strlen(s)<VERYSHORT && strcmp(s, "bye")) {
else{
if (!*response[res]) res=0;/* start over again */
printf("%s\n", response[res++]);
}
return;
}
TOPICS 큐에 주제가 있으면 FIND_TOPIC( ) 는 참을 리턴하고 주제를 배열 T에 넣을 것이다. 만약 이전의 주제가 없으면 RESPOND( ) 는 RESPONSE 데이터베이스로부터 전에 있던 반응 (STOCK RESPONSE) 을 선택한다. 환자가 SHORT 문자수보다 더 긴 반응을 넣으면 RESPOND( ) 는 대답을 TOPICS 큐에 놓는다.
if (strlen(s)<VERYSHORT && strcmp(s, "bye")) {
if (find_topic(t)) {
printf("You just said : ");
printf("%s \n", t);
printf("tell me more.\n");
}
이 체크는 의사가 매우 짧은 대답을 주제로 잘못하는 것을 막기 위해서 필요하며 RESPOND( ) 는 TRANS 데이터베이스에 있는 어떤 단어에 대해서도 환자의 반응을 자세히 조사한 후에 RESPOND( ) 가 하나를 발견하면 적당한 반응을 만들고 문장의 끝에서 어떤 단어도 데이터베이스에 있는 것과 일치하지 않으면 의사는 단순히 TELL ME MORE 라고 말한다. 함수 respond( ) 는 "my" 를 "you" 하는 것처럼 몇 단어의 내용을 바꾸기 위해서 trans 데이터베이스를 사용한다. 프로그램이 trans 데이터베이스에서 단어를 찾지 못하면 현재의 단어를 단순히 다시 프린트한다. 환자가 return 을 치면 respond( ) 는 반응 데이터베이스로부터 이미 있는 반응 (stock response) 을 사용할 것이다. 프로그램은 get_token( ) 함수의 약간 변형된 버전을 사용하여 환자의 반응을 분석한다.
get_token( );
loc=lookup(token);
if (loc!=-1) {
printf("%s\n", trans[loc+1]);
return;
}
} while(*token);
즉 환자의 반응을 저장할 큐를 만들고 TRANS 데이터베이스는 키워드와 반응을 간직할 것이다. 즉 프로그램이 키워드를 인식할 때마다
적당한 반응을 나타낼 것이다. 2차원 문자배열 TOPICS 는 환자의 반응에 대한 환형큐를 유지하고 프로그램은 TOPICS
를 인덱스로 하고
큐를 만들기 위해서 HEAD 와 TAIL 변수들을 사용한다. MAX 는 큐를 설정한 임의의 값이며 프로그램은 환자가 답을 넣으면 나중에
행위의 어떤 과정이 취해질 것인지를 결정하기 위해서 SHORT 와 VERYSHORT 를 사용한다. 프로그램은 환자가 입력한 응답을 단순히
RETURN 을 치거나 길이가 VERYSHORT 개의 문자보다 짧은 반응을 넣으면 REPOND( )
의 호출함으로써 이전의 주제로 돌아가려고
한다. TOPICS 큐에 주제가 있으면 FIND_TOPIC( ) 는 참을 리턴하고 주제를 배열 T
에 넣을 것이다. 만약 이전의 주제가 없으면
RESPOND( ) 는 RESPONSE 데이터베이스로부터 전에 있던 반응(STOCK RESPONSE) 을 선택한다.
환자가 SHORT 문자수보다 더 긴 반응을 넣으면 RESPOND( ) 는 대답을 TOPICS 큐에 놓는다. 이 체크는 의사가 매우 짧은 대답을
주제로 잘못하는 것을 막기 위해서 필요하며, RESPOND( ) 는 TRANS 데이터베이스에 있는 어떤 단어에 대해서도 환자의 반응을 자세히
조사한 후에 RESPOND( ) 가 하나를 발견하면 적당한 반응을 만들고 문장의 끝에서 어떤 단어도 데이터베이스에 있는 것과 일치하지
않으면 의사는 단순히 TELL ME MORE 라고 말한다. 함수 respond( ) 는 "my"
를 "your" 하는 것처럼 몇 단어의 내용을 바꾸기 위해서
trans 데이터베이스를 사용한다.
프로그램이 trans 데이터베이스에서 단어를 찾지 못하면 현재의 단어를 단순히 다시 프린트 한다. 환자가 return
을 치면 respond( )는
반응 데이터베이스로부터 이미 있는 반응 (stock response) 을 사용할 것이다. 프로그램은 get_token( )
함수의 약간 변형된 버전을
사용하여 환자의 반응을 분석한다. 즉 환자의 반응을 저장할 큐를 만들고, TRANS 데이터베이스는 키워드와 반응을 간직할 것이다. 즉
프로그램이 키워드를 인식할 때마다 적당한 반응을 나타낼 것이다. 2차원 문자배열 TOPICS
는 환자의 반응에 대한 환형큐를 유지하고
프로그램은 TOPICS 를 인덱스로 하고 큐를 만들기 위해서 HEAD 와 TAIL 변수들을 사용한다. MAX
는 큐를 설정한 임의의 값이며
프로그램은 환자가 답을 넣으면 나중에 행위의 어떤 과정이 취해질 것인지를 결정하기 위해서 SHORT
와 VERYSHORT 를 사용한다.
실행결과
컴퓨터 스크린 : HOW ARE YOU THIS BEAUTIFUL DAY?
사용자 : I DON'T KNOW. I FEEL BAD
컴퓨터 스크린 : HOW DO YOU KNOW THAT?
사용자 : I FEEL LIKE I COULD KILL.
컴퓨터 스크린 : IT IS WRONG TO KILL
사용자 : I NEVER SEEM TO WIN
인공지능언어를 사용한 경우
환자가 RESPONSE한 내용 MY, YOUR 로 하기 위해서 TRANSLATE
를 사용한다.
ASSERT(translate("UNHAPPY", "WHY ARE YOU UNHAPPY?")),
ASSERT(translate("THINK", "WHY DO YOU THINK THAT?")),
ASSERT(translate("YOU", "LET'S NOT TALK ABOUT ME."))
만일 RESPOND 가 TRANSE 데이터베이스에서 단어를 발견하지 못하면 DOCTOR 는 RESPONSE 데이터베이스에 저장된 응답을 이용하여 환자가 입력한 응답에 ASSERT 의 기능을 이용하여 데이터베이스의 앞이나 뒤에 절을 추가시킨다.
PATIENT(S) :-
ASSERT(patresponses(S)),
ASSERT(temp(S)),
PURGE :-
RETRACT(translate(_, _)),
FAIL.
ASSERTA(X) 와 ASSERTZ(X) 는 똑같이 데이터베이스에 절을 추가하지만 ASSERTA(X)..... 데이터베이스의 제일 앞에 절을 추가하고 ASSERTZ(X)...... 데이터베이스의 제일 뒤에 절을 추가하고 RETRACT(X)..... 데이터베이스에서 불필요한 절들을 추가한다. 또 프로그램은 DOCTOR 가 환자의 응답을 처리할 수 있을 때까지 TEMP 데이터베이스에 저장한다.
TEMP(S),
S=quit,
PURGE.
환자가 단지 RETURN 키를 친다면 DOCTOR 의 첫 번째 라인은 앞의 주제에 관한 내용으로 돌아가려고 한다. TOPICS 데이터베이스에 앞의 주제에 관한 내용이 없다면 프로그램은 RESPONSES 데이터베이스에 저장된 응답 중에서 적합한 것을 환자가 한 문장을 선택하면 RESPOND 가 실행되며 실행에 성공하기 위해서는 환자가 입력한 문장에서 키워드를 발견해야 한다. 키워드를 발견하면 프로그램은 키워드와 연결된 응답을 하고 발견하지 못하면 DOCTOR 의 세 번째 절을 이용해서 문장에서 다음 키워드를 찾으려고 한다.
PARETRACT(topics(R)),
R<>"", WRITE("YOU JUST SAID", ""),
WRITE(R, ""), NL,
WRITE("TELL ME MORE..."), NL.
RESPOND("") :=FAIL.
RESPOND(S) :-
FRONTTOKEN(S, T, _),
TRANSLATE(T, T2),
WRITE(T2, " ").
RESPOND(S) :-
FRONTTOKEN(S, _, S2),
RESPOND(S2).TIENT(S) :-
문장 끝에 도달하고도 키워드를 찾지 못하면 술어전체는 실행에 실패한다. 이때에는 DOCTOR 의 마지막 절이 수행되며 마지막 절은 첫 번째 절과 동일하다.
/* ELIZA 정신병환자 진료 프로그램 */
/* 비인공지능언어 TURBO C를 사용한 예 */
/* Doctor #3 - optimistic and easily annoyed. */
#define MAX 100
#define SHORT 10
#define VERYSHORT 3
char *response[] = {
"How are you this beautiful day?",
"Did you have a happy childhood?",
"Did you hate your father?",
"I'm not sure I understand.",
""
};
char *trans[] = {
"you", "Let's not talk about me.",
"think", "Why do you think that?",
"hate", "So you hate something - tell me more.",
:what", "Why do you ask?",
"want", "Why do you want that?",
"need", "We all need many things - is this special?",
"why", "Remember, therapy is good for you.",
"know", "How do you know that?",
"bye", "Your bill will be mailed to you.",
"murder", "I don't like killing.",
"kill", "It is wrong to kill.",
"jerk", "Don't ever call me a jerk!",
"can't", "Don't be negative - be positive.",
"failure", "Strive for success.",
"never", "Don't be negative - be positive.",
"unhappy", "Why are you unhappy?",
""
};
char topics[MAX][80];/* holds old topics */
char token[80];
char *p_pos;
int res=0;/* index into response array */
int head=0;/* head of topics queue */
int tail=0;/* tail of topics queue */
main()
{
char s[80];
printf("%s\n", response[res++]);
do {
printf(" : ");
p_pos=s;
gets(s);
respond(s);
} while(strcmp(s, "bye"));
}
/* create the doctor's responses */
respond(s)
char *s;
{
char t[80];
int loc;
if (strlen(s) < VERYSHORT && strcmp(s, "bye")) {
if (find_topic(t)) {
printf("You just said :");
printf("%s \n", t);
printf("tell me more.\n");
}
else {
if (!*response[res]) res=0;/* start over again */
printf("%s\n", response[res++]);
}
return;
}
if (in_topics(s)) {
printf("Stop repeating yourself!\n");
return;
}
if (strlen(s) > SHORT) assert_topic(s);
do {
get_token();
loc=lookup(token);
if (loc!=-1) {
printf("%s\n", trans[loc+1]);
return;
}
} while(*token);
/* comment of last resort */
printf("Tell me more..., \n");
}
/* lookup a keyword in translation table */
lookup(token)
char *token;
{
int t;
t=0;
while(*trans[t]) {
if (!strcmp(trans[t], token)) return t;
t++;
}
return -1;
}
/* place a topic into the topics database */
assert_topic(t)
char *t;
{
if (head==MAX) head=0; /* wrap around */
strcpy(topics[head], t);
head++;
}
/* retrieve a topic */
find_topic(t)
char *t;
{
if (tail!=head) {
strcpy(t, topics[tail]);
tail++;
/* wrap around if necessary */
if (tail==MAX) tail=0;
return 1;
}
return 0;
}
/* see if in topics queue */
in_topics(s)
char *s;
{
int t;
for (t=0; t<MAX; t++)
if (!strcmp(s, topics[t])) return 1;
return 0;
}
/* return a token from the input stream */
get_token()
{
char *p;
p=token;
/* skip spaces */
while (*p_pos==' ') p_pos++;
if (*p_pos=='\0') { /* is end of input */
*p++='\0';
return;
}
if (is_in(*p_pos, ".!?")) {
*p=*p_pos;
p++, p_pos++;
*p='\0';
return;
}
/* read word until */
while(*p_pos!=' ' && !is_in(*p_pos, "., ;?!") && *p_pos) {
*p=tolower(*p_pos++);
p++;
}
*p='\0';
}
is_in(c, s)
char c, *s;
{
while(*s) {
if(c==*s) return 1;
s++;
}
return 0;
}
/* ELIZA 정신병 혼자 진료 프로그램 */
/* 인공지능언어 TURBO PROLOG를 사용한 예 */
/* AN IMPROVED DOCTOR PROGRAM */
diagnostics
domains
list = symbol*
number = integer
database
RESPONSES(STRING)
TEMP(STRING)
TRANSLATE(SYMBOL, SYMBOL)
TOPICS(STRING)
PATRESPONSES(STRING)
PREDICATES
CONVERSE
PATIENT(STRING)
DOCTOR(STRING)
RESPOND(STRING)
purge
GOAL
makewindow(1, 7, 4, " ", 0, 0, 25, 80),
makewindow(2, 32, 7, " SPIDER", 0, 5, 10, 60),
makewindow(4, 16, 6, " S E P", 11, 0, 14, 40),
makewindow(5, 96, 1, " N C", 11, 41, 14, 38),
ASSERT(responses("HOW ARE YOU?")),
ASSERT(responses("CAN I HELP YOU?")),
ASSERT(responses("DO YOU HAVE SOME PROBLEMS?")),
ASSERT(responses("GO ON")),
ASSERT(responses("WHAT KIND OF PROBLEM DO YOU HAVE?")),
ASSERT(temp("")),
ASSERT(translate("UNHAPPY", "WHY ARE YOU UNHAPY?")),
ASSERT(translate("THINK", "WHY DO YOU THINK THAT?")),
ASSERT(translate("YOU", "LET'S NOT TALK ABOUT ME.")),
ASSERT(translate("IMPORTANT", "PLEASE TELL ME MORE.")),
ASSERT(translate("WHAT", "WHY DO YOU ASK?")),
ASSERT(translate("WANT", "WHAT WOULD YOU DO WITH IT?")),
ASSERT(translate("NEED", "OK TELL ME MORE.")),
ASSERT(translate("WHY", "REMEMBER, THIS IS THE ONLY ONE POLICY TO WIN THE WAR.")),
ASSERT(translate("KNOW", "YOU HAVE TO OBEY THE COMMANDER'S RULE")),
ASSERT(translate("ENEMY", "YOU ARE A GOOD COMMANDER.")),
ASSERT(translate("KILL", "THAT IS GOOD YOU HAVE TO KILL ENEMIES")),
ASSERT(translate("HURRY", "YOU HAVE TO HURRY!")),
ASSERT(translate("NEVER", "DON'T WORRY; GOD HELP US ALWAYS!")),
ASSERT(translate("FAILURE", "MAKE IT A SUCCESS")),
CONVERSE.
CLAUSES
CONVERSE :-
TEMP(S),
S=quip,
PURGE.
Converse :-
retract(temp(S)),
DOCTOR(S),
write(":"),
readln(P),
PATIENT(P),
converse.
DOCTOR("") :-
/** NO RESPONSE FROM PATIENT
CHECK PATIENT RESPONSE FILE **/
RETRACT(topics(R)),
R<>"",
WRITE("You Just Said", ""),
WRITE(R, ""), NL,
WRITE("TELL ME MORE .."), NL.
DOCTOR("") : -
/*NO RESPONSE FROM PATIENT */
RETRACT(responses(R)),
ASSERT(responses(R)),
WRITE(R), NL.
DOCTOR(S) :-
RESPOND(S),
ASSERT(topics(S)),
NL.
DOCTOR(_) :-
/* NO RESPONSE FROM PATIENT
CHECK PATIENT RESPONSE FILE */
RETRACT(topics(R)),
R<>"", WRITE("YOU JUST SAID", ""),
WRITE(R, ""), NL,
WRITE("TELL ME MORE..."), NL.
RESPOND("") :-FAIL.
RESPOND(S) :-
FRONTTOKEN(S, T, _),
TRANSLATE(T, T2),
WRITE(T2, " ").
RESPOND(S) :-
FRONTTOKEN(S, _, S2),
RESPOND(S2).
PATIENT(S) :-
PATRESPONSES(S),
WRITE("YOU ARE REPEATING YOURSELF."),
NL,
WRITE(":"),
readln(S2),
PATIENT(S2),
PATIENT(S) :-
PATRESPONSES(S),
WRITE("YOU ARE REPEATING YOURSELF."),
NL,
WRITE(":"),
readln(S2),
PATIENT(S2).
PATIENT(S) :-
ASSERT(patresponses(S)),
ASSERT(temp(S)).
PURGE :-
RETRACT(translate(_,_)),
FAIL.
PURGE :-
RETRACT(temp(_)), FAIL.
PURGE :-
retract(responses(_)), fail.
PURGE :-
RETRACT(topics(_)), FAIL.
PURGE :-
RETRACT(patresponses(_)), FAIL.
PURGE.
********************
PROGRAM OUTPUT
********************
HOW ARE YOU THIS BEAUTIFUL DAY?
: I DON'T KNOW, I FEEL BAD.
HOW DO YOU KNOW THAT?
: I FEEL LIKE I COULD KILL
IT IS WRONG TO KILL
: I NEVER SEEM TO WIN
DON'T BE NEGATIVE; THINK POSITIVE!
:WHY
REMEMBER, IT IS GOOD FOR YOU.
:WHY
YOU ARE REPEATING YOURSELF.
:HEY, WHO CARES JERK
DON'T YOU EVER CALL ME A JERK!
:I'LL CALL YOU A JERK ANY TIME I WANT TO
LET'S NOT TALK ABOUT ME.
:I AM UNHAPPY
WHY ARE YOU UNHAPPY?