한국어의 특징과 해석법
한국어 문장은 어절의 나열로
이루어진다. 각 어절은 하나 이상의 단어가 복잡한 법칙에 따라 붙여쓰기를 한다.
따라서 한국어 해석에 있어 또 하나 중요한 점은, 한 어절 안의 붙여쓴 단어들을
단어별로 나누는 문제이다. 영문에서는 각 단어 뒤에 띄어쓰기를 해서 단어를 잘라주기
때문에, 한국어에서와 같은 문제가 발생하지 않는다. 그러나 한국어에서는 어절 별로
띄어쓰기를 하여, 기계가 어절 안의 단어를 식별하지 않으면 안된다. 이러한 어절
안에서 나누어 주어야 할 단어를 좀더 전문적인 용어로 morpheme(형태소)라고 부른다.
따라서 위와 같은 해석의 가정을 형태소 해석이라고 하는데, 구문해석 전에 반드시
이 과정을 거쳐야 한다.
그러면, '나는 오늘 컴퓨터 책을 샀다.'라는 문장에
대한 형태소 해석의 예를 보자. 아래에서 []로 묶은 것은 한 어절을 뜻한다.
|
나 |
는 |
오늘 |
컴퓨터 |
책 |
을 |
샀다 |
|
[명사 |
조사] |
[부사] |
[명사] |
[명사 |
조사] |
[동사(완료형)] |
영문은 구(phrase)의 집합이라고
볼 수 있기 때문에, 영문의 해석은 문장을 구성하는 구를 분석하는데 주안점이 있다.
그러나 한국어 문장의 경우는 좀 다르다.
한국어 문장의 경우는 다음과
같이 낱말 사이의 수식관계가 문장 구조의 기본을 이룬다.
나는 오늘 컴퓨터 책을 샀다.
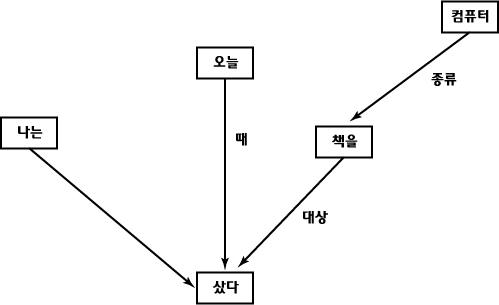
'나는' '오늘' '책을'이 모두 '샀다'에 걸리고, '컴퓨터'가 '책을'에 걸린다.
한국어가 영문과 다른 또 한 가지는 어순이 비교적 자유롭다는 것이다. 예를 들어, 앞의 문장은 다음과 같이 바꿔써도 뜻이 완전히 같다.
오늘 컴퓨터 책을 나는 샀다.
이러한 특징을 가진 한국어의
의미해석에는, 동사를 중심으로 하는 Case Grammar
이 가장 바람직하다. 예를 들면, 앞의
두 문장은 동일하게 다음 그림과 같은 구조로 표현될 수 있다.
영문의 격을
결정하는 데에는 어순이 큰 영향을 미치지만, 한국어 문장의 격은 조사가 결정적인
역할을 한다.
논리식으로의 변환과정