정보 검색 시스템 개요
한국어 형태소 분석과 정보검색 : 강승식, 홍릉과학출판사, 2002, Page 441~448
|
(1) 데이터 검색 시스템 (data-retrieval system) (2) 참조 정보 검색 시스템 (reference-retrieval system) (3) 본문 검색 시스템 (text-retrieval system) |
정보화 사회에서 인간은 원활한 업무 수행을 위하여 업무에 필요한 다양한 정보를 수집, 분석, 가공, 축적하여 의사 결정에 사용한다. 정보 검색은 사용자에게 필요한 자료나 정보를 신속하고 정확하게 전달하는 일련의 과정인데 정보의 폭발적인 증가로 인하여 필요한 정보만을 선별하여 찾기가 쉽지가 않다. 따라서 사용자들은 의사 결정에 필요한 다양한 정보를 어디서, 어떻게 찾아야 하는지에 대한 관심이 높아지고 있다.
정보 검색의 대상이 되는 정보는 수치 정보, 사실 정보, 문서 정보, 서지 정보, 그림 정보, 음성 정보와 복합 정보 등 다양한 형태를 갖는다. 최근에는 전자 매체의 발달로 인해 정보 검색의 대상이 본문 검색 (text retrieval), 화상 (image), 음성 (sound), 화학식의 구조 등으로 확대되고 있다.
|
정보의 유형 |
|
|
수치 정보 (numeric data) |
|
|
|
||
|
|
|
사실 정보 (factual data) |
|
|
|
|
||
|
|
|
문서 정보 (textual data) |
|
|
|
|
||
|
|
|
서지 정보 (bibliographic data) |
|
|
|
|
||
|
|
|
그림 정보 (graphic data) |
|
|
|
|
||
|
|
|
음성 정보 (sound data) |
|
|
|
|
||
|
|
|
복합 정보 (multimedia data) |
|
|
|
|
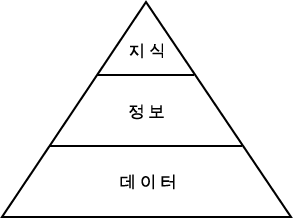
정보 검색은 데이터베이스 관리 시스템 (DBMS) 을 이용한 단순한 데이터 검색시스템에서 시작하여 정보 검색, 지식 기반 검색으로 발전되고 있다. 데이터 (data) 란 실험이나 관찰로부터 얻은 평가되지 않은 사실로서 숫자 또는 문자들의 집합이고, 정보 (information) 는 명확하게 정의하기 어려우나 일반적으로 특정 목적을 위해 이용될 수 있도록 가공된 데이터라 할 수 있으며 지식 (knowledge) 은 특정 응용 분야의 구체적인 문제 해결에 이용되는 조직적이고 체계화된 정보를 말한다. 그러나 데이터와 정보, 지식은 실제로 사용될 때 혼용되고 있으며 이들의 관계는 그림 1 과 같다.
그림 1 데이터, 정보, 지식의 관계
정보 검색 시스템 (information retrieval system) 은 정보 이용자가 필요로 하는 정보를 수집하여 검색하기 쉬운 형태로 조직하여 두었다가 정보에 대한 요구가 발생했을 때 적합한 정보를 검색하여 제공하는 시스템이다. 정보 검색 시스템의 유형은 검색 대상이 되는 정보의 형태 및 검색 방법에 따라 데이터 검색, 참조 정보 검색, 본문 검색, 질의 응답 등으로 분류된다. 구체적인 정보 검색 과정은 정보의 유형이나 크기, 이용자의 수 등에 따라 차이가 있지만, 일반적으로 정보 검색 시스템은 그림 2 와 같이 색인, 저장, 검색의 세 부분으로 이루어진다.
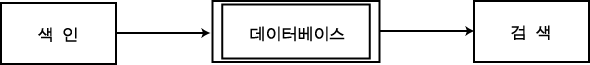
그림 2 정보 검색 시스템
색인 (indexing) 이란 정보 검색의 대상이 되는 단어인 색인어 (index term) 를 추출하는 작업이다. 색인의 대상인 되는 색인어에는 정보의 내용을 대표하는 주제어 외에도 인명, 기관명, 문서 작성일자 등과 같은 비주제어가 사용되기도 한다. 색인 과정은 색인 작업을 행하는 주체에 따라 수동 색인과 자동 색인, 색인어의 유형에 따라 주제어 색인과 비주제어 색인, 색인어의 통제 여부에 따라 자연어 색인과 통제어 색인 등으로 구분된다.
수집된 정보를 저장하는 방식은 정보의 유형에 따라 달라질 수 있다. 즉, 저장의 대상이 정형화된 데이터인 경우에는 일반적으로 많이 사용하는 상용 데이터 베이스를 사용하기도 하지만 화상이나 음성이 포함된 멀티미디어 데이터인 경우에는 비정형 데이터베이스에 저장하는 방식을 취하기도 한다. 검색부는 정보 이용자가 입력한 질의어를 분석하여 적합한 탐색어와 탐색 논리를 추출한 후에 정보가 저장되어 있는 데이터베이스에서 질문의 내용에 적합한 정보를 찾아내는 과정이다.
정보 검색 시스템은 검색 대상이 되는 정보의 유형과 데이터베이스를 구축하는 방법, 검색 방식 등에 따라 다음과 같이 분류된다.
데이터 검색 시스템은 정보 검색의 가장 단순한 형태로 단어나 수치로 표현된 정형화된 형태의 데이터 항목을 ORACLE, INGRES, dBase, Foxbase 와 같은 상용 DBMS 를 이용하여 저장 및 검색하는 시스템이다. 주로 기업체나 은행, 정부 기관 등에서 조직체의 업무와 관련된 데이터를 저장하여 통계치를 구하거나 의사 결정에 사용되고 있다. 데이터 검색 시스템은 데이터의 용도에 따라 조직체에서 업무와 관련된 데이터를 컴퓨터에 저장해 두었다가 필요할 때 검색하는 업무 데이터 검색 시스템과 정부 기관이나 전문 분야의 통계 데이터 및 과학 기술 데이터를 검색하는 통계 데이터 검색 시스템으로 나눌 수 있다. 이 때 사용되는 데이터는 인명이나 전화번호 등과 같이 문자열로 표현되기도 하고 원가, 재고량 등과 같이 수치로 표현되기도 한다.
실제로 가동되고 있는 시스템의 유형으로는 은행에서 예금 정보를 처리하는 온라인 시스템과 증권회사의 증권 정보 시스템, 항공사의 좌석 예약 시스템 등과 같이 대량의 데이터를 취급하는 기관에서 사용되는 업무 데이터 처리 시스템 (business data processing system) 이 있고, 이 시스템의 발전된 형태로 조직체의 정책 결정이나 장기 계획 수립과 관련된 정보를 제공하여 의사 결정에 도움을 주는 경영 정보 시스템 (management information system : MIS), 대량의 통계 데이터를 수록하고 있는 데이터 뱅크 (data bank) 등이 있다.
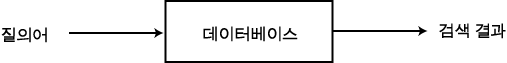
그림 3 데이터 검색 시스템
참조 정보 검색 시스템은 데이터 검색 시스템이 단순히 저장된 데이터를 단순하게 제공만 하는 가장 초보적인 수준에서 조금 발전하여 사용자가 필요로 하는 자료만을 선별해서 검색할 수 있도록 한 것으로 주로 자연 과학, 공학 등 전문분야의 참고 문헌에 대한 데이터베이스를 구축하여 온라인으로 검색할 수 있게 한 것이다. 참조 정보에 사용되는 데이터베이스의 유형에는 단행본, 논문, 보고서 등에 대한 서지 정보 (주제어, 저자, 발행 기관, 발행 일자 등) 를 수록한 서지 정보 데이터베이스와 연구 프로젝트나 특정 전문 분야의 기관 및 활동, 전문가 등 비도서 정보원에 대한 안내 정보를 수록한 안내 정보 데이터베이스 등이 있다.
|
참조 정보 데이터베이스 |
|
|
서지 정보 데이터베이스 |
|
|
|
||
|
|
|
안내 정보 데이터베이스 |
|
|
|
|
서지 정보 데이터베이스는 대개 논문의 초록을 포함하게 되는데 현재 거의 모든 분야별로 데이터베이스가 구축되고 있다. 서지 정보 검색 시스템이 제공하는 서비스는 크게 소급 탐색 (retrospective search : RS) 과 선별 정보 제공 (selective dissemination of information : SDI) 서비스의 두 가지 유형으로 나눌 수 있다. 전자는 특정 주제와 관련된 정보 자료 (예를 들어, '정보 검색' 에 관한 논문의 리스트) 를 소급하여 탐색하는 것으로 데이터베이스에 수록되어 있는 관련 정보 자료를 모두 탐색하거나 특정 연도 이후에 출판된 정보만을 탐색하도록 할 수 있다. 후자는 사용자의 정보 요구를 프로파일 (profile) 에 기록해 두었다가 최신 정보를 수록한 데이터베이스를 입수했거나 새로 구축한 경우에 사용자가 원하는 정보를 검색하여 그 결과를 사용자에게 제공하는 최신 정보 제공 시스템이다.
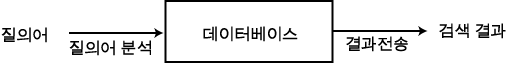
그림 4 참조 정보 검색 시스템
참조 정보 검색 시스템은 데이터 뱅크로 구축된 서지 정보나 안내 정보 등을 IBM 컴퓨터용 STAIRS, STAIRS 의 한국어판인 HAIRS, CDC 컴퓨터용으로 BASIS 등 상용화되어 있는 일반적인 정보 검색 시스템을 이용하여 구축할 수 있다. 데이터 검색 시스템은 이용자의 수가 많지 않으므로 독립된 시스템 (stand-alone) 으로 구축하는 경우가 많다. 그러나 참조 정보 검색 시스템을 비롯한 일반적인 정보 검색 시스템은 이용자의 수가 많은 것을 전제로 하고 있으므로 여러 개의 단말기를 설치하거나 client-server 환경으로 구축하기도 하고 네트워크를 통해서 서비스하기도 한다.
본문 검색 시스템은 참조 정보 검색 시스템보다 한 단계 더 발전하여 일반화된 정보 검색 시스템이다. 참조 정보 검색 시스템이 문헌에 대한 참조 정보만을 제공하는데 비해 본문 검색 시스템은 문헌의 본문 데이터베이스에 대한 정보 검색 시스템이다. 이 때 탐색어와 관련된 문장이나 문단을 검색하는 경우에는 문장 검색 시스템 (sentence retrieval system) 이라 하고 본문 전체를 출력하는 경우에는 전문 검색 시스템 (full-text retrieval system) 이라 한다.
|
본문 검색 시스템 |
|
|
문장 검색 시스템 |
|
|
|
||
|
|
|
전문 검색 시스템 |
|
|
|
|
문장 검색 시스템은 검색어가 포함된 문장을 직접 검색한다는 점에서 질의 응답 시스템과 유사하다. 그러나, 자연 언어 (natural language) 로 된 질의어 (query) 를 입력하는 대신 인공적인 검색문을 작성하여 입력한다는 점에서는 참조 정보 검색 시스템과 유사하다. 따라서 문장 검색 시스템은 참조 정보 검색 시스템과 질의 응답 시스템의 중간 형태가 되는 검색 시스템이라고 할 수 있다. 문장 검색 시스템에서는 본문에 나타난 단어가 그대로 색인어로 사용되는데, 이것이 실제 검색문으로부터 추출해 낸 검색어와 일치하지 않는 경우가 발생할 수도 있다. 따라서 검색어의 이 형태나 동의어 관계에 있는 다른 단어 및 기타 관련 단어들을 모두 포함하는 검색어 리스트를 작성하여 이를 이용하여 데이터베이스를 탐색하는 것이 일반적인 방법이다.
본문 검색 시스템은 상용화된 정보 검색 시스템을 이용하여 구축하기도 하지만, 하드웨어 환경이나 정보의 유형에 따라 상용 DBMS 를 이용하여 사용자의 요구에 적합한 시스템을 구축하는 경우가 많다. 본문 검색 시스템은 참조 정보 검색 시스템에서 문헌의 내용을 대표하는 소수의 단어를 색인하여 특정 주제어와 관련된 문헌을 검색하는 검색 범위를 문헌의 본문으로 확장한 것이다. 그런데 문헌의 본문에서 주제어를 추출하여 색인하는 일은 수작업으로 하기가 거의 불가능하므로 일반적으로 자연어 처리 기법 중의 하나인 자동 색인과 통제 어휘집을 이용한 후처리 기법에 의하여 처리하고 있다.
질의 응답 시스템은 1950 년대 후반부터 기계 번역 시스템을 비롯한 자연 언어 처리에 관한 연구가 진행되면서 시작되었는데 사용자가 자연어 문장으로 질문을 하면 그 해답을 자연어 문장으로 출력해 주는 시스템이다. 질의 응답 시스템은 그림 5 와 같이 질의어 분석, 적합한 정보 추출, 문장형 해답 생성이라는 세 단계로 구성된다.
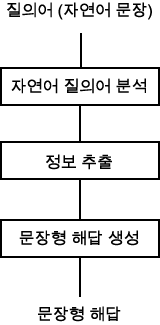
그림 5 질의 응답 시스템의 구조
질의어 분석에서는 자연어 문장으로 입력된 질의어를 분석하여 데이터베이스 탐색어를 추출한다. 질의어로부터 탐색어의 추출은 자연어 문장의 분석을 기반으로 하기 때문에 자연어 처리에서 사용되는 여러 가지 이론이나 기법을 사용하여 구현된다. 즉, 자연어로 입력된 질의어는 자연어 분석 과정인 형태소 분석과 구문 분석, 의미 분석을 거쳐 데이터베이스 탐색에 적합한 형태의 질의어로 변환한다. 이 과정은 원시 문장에 대한 자연어 분석 과정을 거쳐 목표 문장을 생성하는 기계 번역 과정과 흡사하지만 목표 문장이 자연어가 아니라 인위적으로 설정된 질의어라는 점이 다르다.
질의어에 대한 적합한 정보의 추출은 데이터베이스나 지식베이스에 구축되어 있는 정보로부터 질의어와 일치되거나 추론 과정을 거쳐 적합한 자료 혹은 정보를 검색하는 과정이다. 가장 적합한 정보를 추출하기 위한 최상의 시스템을 구축하려면 정보를 지식베이스로 구축하여 추론을 할 수 있는 자연어 이해 시스템이 선행되어야 한다. 추출된 정보는 다시 문장 형태로 생성되어 사용자에게 출력되는데, 문장형 해답 생성은 자연어 생성 과정과 유사하게 처리된다. 따라서 시스템과 마찬가지로 어휘 사전, 문법 규칙 등을 갖추고 있다.
질의 응답 시스템에는 데이터베이스로 구축되어 있는 정보로부터 자연어 질의만 허용하는 방식과 지식베이스로 구축하여 일치하는 해답이 없을 경우에 이를 추론하여 유사하거나 표현이 다른 해답을 제시해 주는 두 가지 방법이 있다. 질의어만 자연어 문장으로 입력하는 방식은 데이터 검색 시스템이나 참조 정보 검색 시스템에서 사용자 인터페이스를 인공적인 데이터베이스 질의어 대신에 자연언어 인터페이스 (natural language interface) 로 처리하는 것에 불과하다. 따라서 질의어가 인위적으로 정의된 질의어 형태로 변환되고 나면 그 이후의 처리 과정은 다른 정보 검색 시스템에서의 처리 과정과 거의 유사하다.
추론을 허용하는 질의 응답 시스템은 해답을 추론할 수 있도록 하기 위해서 데이터나 본문을 분석하여 의미망이나 프레임과 같은 지식베이스 형태로 저장해야 할 뿐만 아니라 추론 기계가 있어야 하므로 사용화되기에는 아직 기술적인 어려움이 많다.
지능형 정보 검색 시스템은 인공 지능에 관한 연구 결과를 바탕으로 하여 인간의 사고 과정과 논리적인 문제 해결 과정을 정보 검색 시스템에 활용한 것이다. 이러한 시스템으로는 전문가 시스템 (expert system) 과 하이퍼텍스트 (hypertext) 시스템이 있으며, 자연어 문장으로 질문을 하고 지식베이스를 구축하여 추론에 의해 해답을 찾는 질의 응답 시스템도 지능형 정보 시스템이라 할 수 있다.
지능형 정보 검색의 특징은 이용자가 시스템의 사용법을 익히지 않아도 자연어 문장으로 쉽게 사용할 수 있으며, 정보 검색 과정에서도 인간의 지식을 이용하여 검색하는 것과 같은 검색 효과를 얻을 수 있다. 이를 구현하기 위하여 질의어를 자연어 문장으로 입력할 수 있도록 하고 정보 검색시에도 지식베이스를 이용하여 논리적인 추론을 하거나 기존의 검색 정보를 효과적으로 이용하여 정보 이용자에게 최상의 정보를 제공한다.
전문가 시스템은 특정 분야의 전문가 (domain expert) 에 의하여 제공된 전문 지식을 지식 기술자 (knowledge engineer) 가 체계적인 지식 표현 방식에 의하여 지식베이스를 구축한다. 질문에 대한 해답을 찾는 과정은 지식베이스와 추론 기계를 이용하며 해답뿐만 아니라 해답을 찾는 과정가지도 사용자에게 설명해 준다. 잘 알려진 전문가 시스템으로는 화학 물질의 구조를 보여 주는 DENDRAL, 의학 분야의 MYCIN 과 전문가 시스템 작성 도구인 EMYCIN, 광물 자원 탐사를 위해 사용되는 PROSPECTOR, 자동차 고장 진단 시스템 등이 있다.
하이퍼텍스트는 명확하게 정의하기가 어려우나 일반적으로 '종이 위에 간편하게 기록할 수 없을 정도로 복잡하게 상호 연결된 문서나 그림의 집합' 혹은 '비직선적이고 비연속적인 문서' 라고 정의된다. 하이퍼텍스트 시스템은 관련이 있는 문서 혹은 문서의 내용들 사이의 관련 정보를 체계적으로 조직하여 검색할 수 있게 한 것이다. 하이퍼텍스트의 구조는 문서를 저장하는 노드와 노드들을 서로 연결하는 링크로 구성된다. 노드에는 기본적으로 문서 정보가 저장되지만 문서뿐만 아니라 화상 정보, 음성 정보 등 다양한 매체 정보가 포함될 수 있으며 이 경우에는 하이퍼미디어라고 한다. 노드들을 연결하는 링크는 노드간의 계층적 관계, 노드 내용 사이의 유사성, 그림, 도표, 참고문헌, 각주 등 다양한 연관 관계를 표현한다.