
자동학습
(Machine Learning)
전문가 시스템 원리와 개발 : 이재규, 최형림, 김현수, 서민수, 주석진, 지원철 공저, 법영사, 1996, Page 370~404
전문가시스템에서 사용되는 지식은 지식획득에서 살펴본 바와 같이 대부분의 경우 전문가나 지식공학자들에 의해 수작업으로 만들어지고 입력도 된다. 이러한 과정에는 매우 많은 노력과 시간이 소요되어서, 지식의 유지보수까지를 고려할 때 지식의 정확성과 현재성을 유지하기가 매우 어려울 수 있다. 이러한 상황에서 지식입력이나 생성이 자동화된다면 많은 도움이 될 것이다. 이러한 지식입력의 오류와 능률을 제고하는 동기에서 자동학습이란 주제에 대한 연구가 진행되어 왔다. 아울러 궁극적으로 시스템이 인간의 고유한 기능인 학습능력을 모방하여 스스로 지식을 확장시켜 나가게 하는 것이 인공지능 시스템의 최종목표라고 할 때 자동학습에 대한 연구는 인공지능에 있어 중요한 주제라 아니할 수 없다. 본 장에서는 자동학습의 의미와 구조, 그리고 형태별 분류에 대해 알아보며 대표적인 자동학습방법론을 살펴보겠다.
인간은 학습할 수 있기 때문에 자신의 지식을 계속적으로 확장시켜 나갈 수 있다. 이러한 지적능력은 인간을 다른 생물과 구별시키는 아주 중요한 요소들 중의 하나이다. 자동학습 (Machine Learning) 은 궁극적으로 인간의 이러한 학습능력을 구현하고자 하는 시도이다. 인간에 의해 수행되는 학습과정의 형태는 다양하다. 첫째, 인간의 학습형태는 "러시아의 수도는 모스크바이다" 와 같은 선언적 지식의 습득일 수 있다. 둘째, 계속적인 반복과 훈련에 의한 인지적ㆍ신체적 기술의 습득일 수 있다 (자전거 타기, 병아리 감별하기). 셋째, 새로이 지식을 재조직하여 보다 일반적이고 효과적인 지식으로 만드는 것이다 (현대문명의 흐름에 관한 이해, 조망과 같은 사고 활동). 넷째, 실험과 관찰을 통한 새로운 사실이나 이론의 발견일 수 있다 (새로운 항암제의 개발, AIDS 백신의 개발 등). 따라서 어떻게 이러한 학습과정을 모델링할 것인가 하는 것이 자동학습분야의 주요 주제가 된다. 이러한 다양한 학습형태 그리고 그것을 구현하는 모델링의 다양성 때문에 자동학습분야는 자연히 광범위하고, 또한 테크닉 위주라고 느껴질 만큼 새로운 기술의 개발에 따라 그 내용이 달라지는 유동적인 속성을 지닌 분야이다.
그럼 이제 자동학습의 정의에 대해서 알아보자. 컴퓨터시스템에서 기존의 프로그램을 재수정하지 않고도 시간이 흐를수록 주어진 과제수행에 점점 성과를 올릴 때 이를 보고 학습이 이루어졌다고 말할 수 있다. 즉, 자동학습을 간단하게 "자동적 성과의 향상" 으로 정의 내릴 수 있다. 그렇다면 "성과의 향상" 이란 무엇이고 그리고 그것을 어떻게 측정하는가에 관해 정의되어야만 과연 학습이 일어났는지를 알 수 있을 것이다. 실제로 다음과 같은 것들을 성과의 발생이라 볼 수 있다.
① 더 정확히 문제의 해를 구할 경우
② 더 넓은 범위의 문제를 다루게 되는 경우
③ 보다 효율적으로 문제의 해를 구할 경우
④ 보다 간단한 지식의 입력으로도 같은 문제를 해결하는 경우
따라서 성과란 문제를 보다 많이, 정확히, 빠르게 해결하고 문제를 풀기 위한 지식의 양을 보다 적게 하는 것을 성과라 볼 수 있다. 그러면 이러한 자동학습의 개념을 구조적으로 살펴보도록 하자.
그림 1 자동학습의 틀
그림 1 은 자동학습의 틀을 묘사하고 있다. 자동학습의 요소로는 수행자 (Performer), 지식 (Knowledge), 학습자 (Learner), 평가 (Critic) 가 있다. 외부로부터 입력이 들어오면 수행자가 이 입력 (Input) 을 토대로 결과 (해) 를 제시한다. 자동학습시스템에서 나온 이 결과와 환경에서 실제로 나온 결과 또는 훈련자가 제공하는 정확한 해와의 평가를 통해 그 차이를 보정하는 방향으로 학습이 일어나며 이것이 지식으로 축적된다. 이를 토대로 수행자는 다음 번 입력에 대해 해를 제시하게 된다.
이외에도 자동학습에서 고려할 사항은 '기술언어' 와 '훈련 집합' 이다. 기술 언어는 시스템의 지식을 어떻게 표현하는가에 대한 기호법 (Notation) 과 표현형식을 말한다. 기술언어가 다루어야 할 표현대상은 첫째가 지식이고, 두 번째는 입력양식이다. 지식의 표현은 표현능력 (Expressive Power) 과 인간의 이해가능성, 그리고 학습기능수행의 효율성 등을 고려하여 고안되어야 한다. 입력양식의 표현 또한 학습의 수행알고리즘과 밀접한 연관이 있다.
다음으로 자동학습에서 고려할 사항은 훈련집합인데 이는 자동학습시스템이 지식을 평가하거나 지식을 새로이 구축할 때 사용되는 예제 (Example) 들이다. 훈련집합을 주어진 어떤 상황과 그 상황에 대한 정확한 해와의 조합으로 구성된다.
이상에서 살펴본 자동학습시스템을 구축하기 위해서는 다음과 같은 것들이 고려되어야 할 것이다.
① 기술언어로는 어떠한 것을 채택할 것인가?
② 자동학습의 수행결과를 어떻게 평가할 것인가?
③ 수행자 (Performer) 는 지식을 어떻게 이용하여 해를 제시하도록 할 것인가?
④ 학습알고리즘은 어떻게 고안할 것인가?
이러한 고려사항들을 어떻게 설계하고 구축하느냐에 따라 다양한 종류의 자동학습형태가 있을 수 있다. 이제 이러한 자동학습의 여러 가지 형태에 대해 살펴보겠다.
자동학습의 형태는 사람의 학습방법의 형태가 다양하듯 다음과 같은 여러 차원에서 분류될 수 있다.
① 학습전략에 따른 분류, 즉 학습기 (Learner) 가 수행하는 추론의 과다에 따른 분류
② 획득된 지식의 표현 방법에 따른 분류
③ 자동학습의 적용영역 (Domain) 따른 분류
또한 신경회로망이나 decision_theoretic 접근법처럼 학습방법이나 결과로서 획득된 지식이 블랙박스와 같은 방법과, 학습과정이나 결과가 사람이 이해할 수 있는 심볼과 개념위주로 표현되고 진행되는 방법으로 나눌 수도 있다.
이 분류는 학습에 필요한 학습기의 역할의 정도에 따라 분류하는 것이다. 극단적인 경우 학습기가 전혀 필요없는 방법이 있을 수 있고, 또 다른 극단은 상당한 양의 추론을 학습기가 감당하여야 하는 학습방법이 있을 수 있다. 학습기가 전혀 필요없는 경우는 사람이 직접 지식을 코딩하여 입력하는 것을 말하는데 이 경우에는 지식의 증대가 발생하지만 추론은 전혀 필요치 않게 된다. 이 경우 모든 노력은 코딩을 담당하는 프로그래머가 하는 것이다. 반대로 사람의 도움이 전혀 없이 스스로 새로운 개념이나 이론을 발견하려면 실험이나 관찰을 통한 상당한 양의 추론을 학습기가 수행해야 할 것이다. 중간정도의 경우는, 어떻게 문제를 푸는지를 누군가 보여 주면 유사한 문제는 시스템 스스로 풀 수 있도록 학습이 일어나는 경우이다. 이러한 경우 가르쳐 주지 않은 새로운 발견은 할 수 없으나 가르침을 받은 범위 내에서의 문제해결은 가능하다. 시스템 스스로 학습하는 추론기능이 클수록 인간이나 외부의 간섭은 줄어들 수 있으나 학습기능에 대한 설계의 부담은 커진다.
다음은 이러한 기준에 의한 학습기 (Learner) 의 역할과 훈련자 (Teacher) 의 역할의 비중에 따라 구분한 것이다.
(1) 주입학습 (Rote Learning)
과 지식의 직접입력
학습기가 필요없고 따라서 학습을 위한 추론도 없다.
직접 프로그래머가 시스템이 이해할 수 있는 형태로 코딩한다.
(2) 교육 (Instruction)
에 의한 학습 (Learning from Instruction, or Learning by Being Told)
학습기는
단지 훈련자 또는 다른 지식의 원천으로부터 입력받은 지식을 시스템이 이해할
수 있는 표현형태로 변형하여 저장한다. 지식을 조직화하고 마련하는 것은 훈련자의
임무이다. 이것은 선생은 가르치고 학생들은 그것을 듣고 자기 지식화하는 일반적인
교육기관에서의 학습형태와 유사하다.
(3) 유추에 의한 학습 (Learning
by Analogy)
현재 가지고 있는 지식이 적용되었던 상황과 유사한 상황이 발생했을
때, 현재의 지식을 활용하여 새로운 상황에 대처하여 해를 도출하는 과정에 의한
학습방법이다. 새로운 상황에 대처하여 해를 도출하는 과정에 의한 학습방법이다.
새로운 상황에 대처하기 위하여 현재의 지식이 다시 조직되거나 변형될 수 있다.
인간의 경우를 예로 들면, 승용차만 운전하던 사람이 처음 소형트럭에 탔을 때
그가 갖고 있던 승용차운전에 관한 기술을 트럭운전을 위해 적절히 변화, 적용시킬
수 있다. 이와 같이 현재 새로운 문제를 풀기 위해 비슷한 문제를 풀었을 때
필요했던 지식들이 도출되고, 이것들이 새로운 문제에 적용되기 위해 재조직
또는 변형되어야 한다. 그리고 이렇게 하여 새로운 문제에 적용되어 성공적으로
그 문제를 해결했을 경우 그 상황은 다음의 문제해결을 위해 저장된다.
(4) 사례에 의한 학습 (Learning
from Examples)
귀납적 학습의 한 형태로써 가장 일반적으로 사용하는 학습전략이라
하겠다. 특정한 개념에 대한 예 (Positive Example) 와 반례 (Counter Example)
가 주어질 때, 이로부터 학습기는 예와 반례를 구분할 수 있는 일반개념을 도출
(Induce) 해내는 것이다.
사례에 의한 학습은 또한 다음과 같이 구분할
수 있다.
① 예 (Positive Example) 만 주는 경우
이러한 경우는
주어진 예들을 기술하는 개념이 매우 일반적이 될 수 있으므로, 주어진 개념을
기술하되 최소한으로 일반화된 개념을 찾아낸다.
② 예와 반례가 모두
주어지는 경우
이것은 사례에 의한 학습형태 중 전형적인 것으로서 예는
발견되는 개념의 일반화를 촉진하고, 반례는 과도한 일반화를 방지하는 역할을
한다. 예를 들어, 몇 대의 검은 자동차가 모두 관공서 차라는 것을 보고 검은
자동차는 관용차이다라는 개념으로 일반화했을 때 검은 자동차이면서도 관용차가
아닌 것이 있으므로 이러한 결론은 너무 과도한 일반화라는 것이 밝혀지고, 어떠한
차가 관용차인가에 대해 보다 상세한 단서들을 요구하는 방향으로 진행된다.
또
다른 구분은 다음과 같다.
① 학습의 진행이 한번 (One-trial) 에 완성되는
방법
모든 예와 반례를 한번에 처리하여 지식을 생성하는 경우이다. 이때는
필요한 모든 예 (반례) 들이 준비되어 있어야 한다. 따라서 점진적 학습방법과는
달리 초기 예가 어떠하냐에 민감하게 반응하지 않는다.
② 점진적으로
학습되는 방법
현재 주어진 예와 반례로부터 지식을 생성하고, 계속 새로운
예와 반례가 생길 때마다 점진적으로 현재의 지식을 수정하는 방향으로 진행되는
학습방법이다. 이것은 사람의 학습과정과 유사하다. 그러나 예와 반례가 주어지는
순서에 영향을 받을 수 있고, 지식의 생성과정이 올바른 방향인지를 점검해야
한다.
(5) 관찰과 발견에 의한
학습 (Learning from Observation and Discovery)
외부로부터 주어지는 가르침이나
예도 없이 새로운 이론을 개발하고 사물을 분류하는 기준을 만드는 것으로, 환경의
다양한 현상을 관찰하여 어떠한 구분을 만들거나 또는 적극적으로 실험을 실시하여
환경의 반응에 따라 설정된 가설을 확증하기도 하고 부정하기도 함으로써 학습이
이루어진다.
생성된 지식의 표현 방법에 따라서는 다음과 같이 분류할 수 있다.
① 대수적 표현의 파라메터
(Parameter)
수치적 표현의 파라메타나 함수 등이 포함된 대수식의 계수로써
학습의 결과가 나타난다. 전형적인 예가 퍼셉트론 (Perceptron) 으로 2 차원
공간에서의 패턴인식에 관해 학습할 때 각 조정된 가중치 (Weight) 로써 학습된
결과가 표현된다.
② 의사결정트리 (Decision
Tree)
객체들을 분류하기 위해 사용된다. 각 노드는 객체의 특성 (Attribute)
이고 가지 (Branch) 는 해당 특성이 취할 수 있는 값 (Value) 이다. 단말노드
(Terminal Node) 는 근 (Root) 으로부터 해당 단말노드까지의 특성에 대한 값을
갖는 객체가 속한 클래스 (Class) 가 된다.
③ 형식문법 (Formal Grammars)
형식언어이론에서 사용되는 것으로 하나의 문장은 주어와 술어로 나뉘고
다시 명사구, 부사구 등의 구와 동사, 명사로 분류되어 그들간의 규칙으로 문법이
형성되듯이 심볼간의 생성규칙과 관계 등을 정의하여 문장 (Sentence) 으로 표현함으로써
우리가 원하는 지식을 표현할 수 있다.
④ 규칙 (Production Rules)
If
A THEN B 와 같은 형태로 조건부분과 결론부분으로 나뉜다. 규칙의 조건이 완화됨으로
인해 규칙의 적용범위가 확장되기도 하고 조건에 새로운 조건을 추가함으로써
결론이 인정되기가 더 어려워질 수 있다. 전자를 일반화 (Generalization) 라
하고 후자를 특수화 (Specialization) 라 한다.
⑤ 형식논리
생성되는
지식을 명제논리 (Propositional Logic) 나 술어논리 (Predicate Logic) 에서
사용하는 표현방식을 이용한다.
⑥ 그래프와 네트워크
많은
경우에 있어 그래프와 네트워크는 간편한 지식 표현 방법이 될 수 있다. 노드와
호로써 개념간의 관계를 표현할 수 있다. 이는 형식논리 등의 표현보다 쉽게
이해될 수 있다.
⑦ 프레임과 스키마
프레임과
스키마는 여러 개의 엔티티들의 집합이라고 볼 수 있다. 각 엔티티는 슬롯으로
표현되며 각 슬롯은 전체표현에서 한 부분 또는 부분적 역할을 갖는다. 이것은
매우 유용한 지식 표현기법으로 인정받고 있다.
⑧ 컴퓨터 프로그램과 절차적
코딩
어떤 경우 내부구조나 논리적 기술, 개념과 개념의 관계로 표현되는
것과는 달리 오직 절차적 순서가 중요시 되는 대상이 있다. 예를 들어, 공정과정이나
로봇의 제어순서와 같이 외부적으로 드러나는 과정의 순서들을 효율적으로 배치하는
것에 관심이 있을 때 이들의 절차적 순서들을 코딩이나 프로그램형식으로 표현할
수 있다.
⑨ 분 류
관찰에
의한 학습을 통하여 대상을 분류하는 경우가 있다. 복잡한 대상을 어떤 분류기준의
발견으로 구조화, 계층화시켜 대상의 의미를 보다 잘 파악하게 한다.
⑩ 복합표현
이상의 표현
방법 중 다수의 방법을 혼합하여 표현하기도 한다. 대부분 하나의 표현법보다는
복합표현이 보다 정확하고 넓은 표현력을 가질 수 있다.
응용영역이 어떠한 영역이냐에 따라 분류할 수도 있는데, 사실상 대상 영역이란 광범위하므로 일일이 나열할 수는 없으나 대표적으로 다음과 같은 것이 있다.
① 전문가시스템
② 게임
③ 패턴인식
④
수학
⑤ 화학
⑥ 지질학
⑦ 로봇공학
⑧ 음성인식
⑨ 자연언어처리
⑩ 의학진단
⑪ 문제해결 (Problem solving)
신경회로망이나 Decision-Theoretic 학습방법은 인간이 개념적으로 이해할 수 있는 형태의 표현 방법이나 학습방법을 사용하는 것이 아니라, 입력 (Input) 과 출력 (Output) 간의 관련을 대수적 표현에서의 계수나 파라메터, 판별함수 등을 이용하는 것으로 패턴인식, 음성인식 등에 주로 사용된다.
이에 반해 개념위주의 학습방법은 사람이 이해할 수 있는 표현 방법으로 (규칙, 프레임, 논리, 네트워크 등) 사물이나 개념을 표현하고 이들 개념들의 결합이나 관계의 설정으로 학습해 나간다.
이들 두 가지 접근방법은 자동학습에 있어 두 개의 패러다임이라 할 수 있다. 이제부터는 학습전략에 따른 분류순서에 따라 제반 학습방법론과 그 적용예에 대해 살펴보기로 한다.
어려운 문제를 풀거나 처음하는 운동을 할 때 잘 아는 사람으로부터 지도나 자문을 받으면 훨씬 효과적으로 배울 수 있듯이 외부로부터 자문을 받아 이를 효과적인 지식으로 전환하는 학습방법을 자문청취에 의한 학습 (Learning by Taking Advice) 이라 한다. Hayes-Roth, Klahr, and Mostow[80, 81] 자문청취에 의한 학습이 이루어지기 위한 과정의 개요를 다음과 같이 마련하였다.
이상의 단계를 보다 상세하게 살펴보면 다음과 같다.
① 자문요청 (Request)
현재
있는 지식으로서는 문제를 효과적으로 해결하기에는 부족하거나 결함이 있는
부분에 대해서 전문가에게 자문을 요청한다.
② 자문해석 (Interpret)
전문가의
자문형태를 시스템 내부의 표현구조로 전환시킨다. 이때 자문의 내용이 변질되거나
정보의 손실이 발생해서는 안된다.
③ 조작화 (Operationalization)
자문을
받아 이를 해석하여 시스템이 이해할 수 있는 내부표현구조로 변형하였다 하더라도
이를 바로 이용하기는 거의 힘들다. 이를 이용하기 위해서는 조작화라는 과정을
거쳐 추상적이고 일반적인 자문의 내용을 구체적인 상황에 적용하여 시스템의
수행기관에서 작동할 수 있는 형태로 만들어져야 한다. 예를 들어, "위험을
피하라" 라는 자문을 받아 이를 내부적으로 표현했다 하더라도 구체적으로
무엇이 위험이며 또한 위험한 경우에 이를 피하는 방법이 무엇인지를 알지 못하면
이것은 아직 유용한 형태로 볼 수 없는 것이다. 이러한 추상적이고 높은 수준의
자문의 내용을 구체적이며 실행가능한 내용으로 바꾸어 준다는 것이 자문청취에
의한 학습의 핵심적인 부분이 된다. 이는 마치 컴파일러처럼 고급언어를 컴퓨터가
수행가능한 기계어로 바꾸는 것에 비유될 수도 있지만 이와 다른 점은 조작화의
결과가 항상 정확하지는 않을 수 있다는 것이다. 조작화를 하기 위해서는 이미
알고 있는 지식과 연관시키거나 때로는 가정을 하거나 근사를 하여야 할 필요도
있다. 이러한 여러 가지 방법에 의해 조작화가 된 결과지식은 반드시 그의 유용성과
성과를 검증하고 오류를 제거한 후에 최종적으로 채택되어야 한다.
④ 통합 (Integrate)
새로이
습득된 지식을 기존의 지식베이스에 통합시킬 때 주의하여야 할 것은 기존의
지식과 중복되거나 상충되어서는 안된다는 것이다. 만약 중복되는 지식이 있다면
기존의 지식과 새로운 지식의 조건부분을 보다 상세화하여 서로 적용되는 상황을
다르게 하거나 메타 지식을 이용하여 적용되는 상황이나 우선순위가 결정되도록
해야 한다.
⑤ 평가 (Evaluate)
앞서의
과정을 거쳐 생성된 지식은 아직은 임시적인 지식이다. 실제 이를 적용하여 시스템이
적절히 작동하는지와 그에 대한 성과를 평가하고 검사해 보아야 한다. 이를 위해서는
적절한 평가기준이 있어야 한다. 이러한 과정에서 지식의 결함이 발견되고 나아가
추가적으로 요청할 자문의 내용도 결과적으로 정리될 수 있다.
이와 같은 단계를 거쳐 이루어지는 자문청취에 의한 학습은 그 전과정을 궁극적으로 자동화하는 것을 목표로 하고 있다. 그러나 또 하나의 다른 접근법은 위의 과정에 인간이 적극적으로 개입하게 하여 자문의 해석, 조작화, 통합, 평가 등을 총괄케 하는 것이다. 이를 위해서 시스템은 뭔가 스스로 수행하여 학습한다기 보다 인간의 개입을 적극적으로 도와 주는 입장만을 가지게 된다. 이는 지식의 생성, 수정, 검증에 필요한 보조적 도구역할을 하게 되어 독자적인 학습시스템이라기보다 지식생성도구라고 불리게 된다. 그러나 이것은 자문청취학습을 완전자동화하는 어려움으로 인해 나타난 대안이다.
지금까지 자문청취에 의한 학습을 구현한 연구는 최초로 Mostow 의 FOO 이다 [Mostow 81]. Mostow 는 그의 프로그램 FOO (First Operational Operationalizer)에서 Game of Hearts 란 card game 에서 일반적인 가이드를 보다 구체적으로 조작화시켰다. Game of Hearts 란 각 판에서 리더가 내놓는 카드와 같은 무늬를 내놓아야 하는데 이 중 가장 높은 카드를 낸 사람이 다음 판의 리더가 된다. 만약 같은 무늬가 없으면 다른 무늬를 내도 되나 이는 가장 낮은 순위가 된다. 그런데 이 중 Heart 무늬카드는 포인트로 가산되며 Heart 무늬가 있는 판에서 가장 높은 카드를 낸 자는 이들 Heart 무늬의 카드만큼 포인트가 가산되는데 마지막 판까지 계산하여 가장 포인트가 낮은 사람이 게임을 이긴 것으로 한다. 여기서 "포인트를 얻지 마라" 라는 게임에 대한 자문은 실지로 가장 핵심적이지만 적용하기에는 너무 포괄적인 것이므로, 이를 보다 구체적인, 즉 "Heart 카드가 나왔을 경우 낮은 순위의 카드를 내라" 와 같이 구체적으로 게임에서 이용할 수 있는 형태로 조작화하여야 한다. FOO 는 이러한 목적을 위해 일반적인 자문인 "포인트를 얻지 마라" 를 (avoid (take-points me) (trick)) 와 같이 컴퓨터에서 표현하는 양식으로 해석되어 받아들인 후 최종적으로
(achieve (⇒ [and (in-suit-led (card-of
me))
[possible
(trick-has-points)]]
[low
(card-of me)]))
와 같이 치환한다. 이를 해석하면 "포인트를 얻을 가능성이 있는 카드 무늬라면 낮은 카드를 내라" 이다. 이를 위해 FOO 는 추상적 수준의 용어를 보다 구체적 수준의 용어로 바꾸거나, 상황의 여러 가지 경우를 가정하거나, 표현을 잘 게 나눈다거나, 기존지식에 위배되는 부분의 삭제 등 여러 가지 탐색적 접근법으로 이를 조작화 한다. 그러나 FOO 의 프로그램의 조작화과정이 완전자동으로 되는 것이 아니며 또한 Game of Hearts 와 같은 문제 유형에만 적용된다는 것이다. 그러나 전체적인 흐름은 학습기관이 문제를 조작화하는 여러 가지 탐색적 방법을 알고 있으며, 인간이 적극 개입되어 이 중에서 선택ㆍ표현함으로써 자문을 하는 과정을 거친다. 결국 자문청취에 의한 학습은 컴퓨터에 도움을 얻어 인간이 막연히 가지고 있는 지식을 보다 구체화하는 방법론이라 간주될 수도 있다. 따라서 인간과 컴퓨터간의 밀접한 대화기능, 추적기능, 지능적 편집기능과 같은 것이 매우 필수적이라 하겠다.
일반화와 개념형성을 인간이 지니고 있는 학습능력의 대표적인 형태로 볼 수 있다. 이러한 능력으로 인해 인간은 한번 어떤 차로 운전을 배우면 다른 차도 운전할 수 있고, 하나의 의지를 분별할 수 있으면 다른 의자들도 분별할 수 있게 되는 것이다. 사례에 의한 학습이란 이와 같이 한정된 사례로부터 일반적인 개념을 형성시킴으로써 학습하는 것을 말한다. 예를 들어, 장기판에 각 경우에 대하여 가장 좋은 수를 알려 주면 이로부터 일반적인 장기의 게임전략을 안다든지, 또는 여러 동물들을 소개하고 그 중 진돗개란 동물이 어떤 것인지를 알면, 이로부터 진돗개를 구변해 낼 수 있는 일반규칙을 알아 내는 것 등이다. Simon 과 Lea [74] 는 사례에 의한 학습과정을 훈련을 위한 사례의 이용, 가능한 사례의 선택, 이들 사례로부터 일반적인 규칙을 탐색해 내는 방법 등을 찾아 내는 문제로 보고 있다. 이들은 사례공간 (Instance Space) 과 규칙공간 (Rule Space) 이란 모델을 제시하였는데 그림 2에서 보는 바와 같이 사례공간에서 사례를 해석함으로써 설정가능한 규칙공간을 형성하는데 이들 규칙이 제대로 형성되었는지, 또는 그렇지 못한지를 다시 확인해 보기 위해 필요한 사례를 추가로 선택한다.
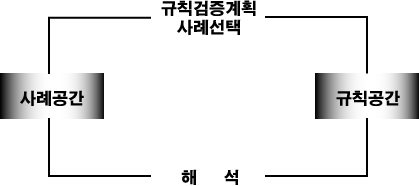
그림 2 사례에 의한 학습의 2 공간 모델
예를 들어, 몇몇 개에 해당하는 동물들의 사례로부터 개는 다리가 넷이라는 사실을 알았을 때 과연 개는 모두 다리가 넷인지, 다리가 넷이 아닌 동물중에 개인 동물이 있는지를 다시 사례공간에서 확인해 보는 것이다. 이렇게 사례공간과 규칙공간 사이를 움직이면서 학습시스템은 바람직한 규칙으로 수렴될 때까지 학습과정을 진행하게 된다. 여기서 규칙공간이라는 이름을 사용했지만 규칙공간에는 반드시 규칙형태의 지식만 존재하는 것이 아니라 나중에 수행기관에서 필요한 지식의 형태 모두 - 고급의 추상적 개념기술과 같은 것도 모두 포함되는 - 를 포함하는 공간을 말한다.
위의 2 공간 모델의 예로서 포커게임에서 플러쉬 (Flush) 란 개념을 학습시키는 예를 들어보자. 사례공간은 다섯 장의 카드가 구성할 수 있는 모든 경우를 말할 것이다. 여기서 하나의 사례는 다음과 같이 표현할 수 있다.
{(2, clubs), (3, clubs), (5, clubs), (jack, clubs), (king, clubs)}
위의 예에서 집합을 구성하는 원소는 하나의 순서쌍인데 카드의 계급과 무늬를 말한다. 여기서 규칙공간은 RANK 와 SUIT 란 술어를 갖는 모든 술어 해석적 표현으로, 다섯 장의 카드를 각각 나타내는 변수 c1, c2, c3, c4, c5 와 기타 필요한 기타변수, 상수인 clubs, diamonds, hearts, spades, ace, 2, 3, 4, 5, 6, 7, 8, 9, 10, jack, queen, king 등을 포함한다. 규칙공간은 "같은 계급을 적어도 세 장 가짐" 과 같은 개념을 가질 수 있다.
∃c1, c2, c3 : RANK (c1, x) ∧ RANK (c2, x) ∧ RANK (c3, x)
그리고 우리가 목표하는 플러쉬란 개념은 다음과 같은 형태로 표현될 수 있다.
∃c1, c2, c3, c4 , c5 : SUIT (c1, x) ∧ SUIT (c2, x) ∧ SUIT (c3, x) ∧ SUIT (c4, x) ∧ SUIT (c5, x)
이러한 개념들은 구체적인 훈련사례 (Training Instance) 로부터 추론되는데 대표적인 추론 방법은 일반화 (Generalization) 이다. 일반화를 하는 방법은 다음과 같은 것들이 있다.
① 상수를 변수로 바꾸는
것이다.
예를 들어, 플러쉬란 개념을 발견하도록 하기 위해 다음과 같은 훈련사례를
주었다고 하자.
사례 1. SUIT (c1, clubs) ∧ SUIT (c2,
clubs) ∧ SUIT (c3, clubs)
∧
SUIT (c4, clubs) ∧ SUIT (c5, clubs) ⇒ FLUSH (c1,
c2, c3, c4, c5)
사례
2. SUIT (c1, spades) ∧ SUIT (c2, spades) ∧ SUIT
(c3, spades)
∧
SUIT (c4, spades) ∧ SUIT (c5, spades) ⇒ FLUSH (c1,
c2, c3, c4, c5)
여기서
clubs 과 spades 라는 상수대신 이를 변수 x 로 치환하면,
규칙 1. SUIT
(c1, x) ∧ SUIT (c2, x) ∧ SUIT (c3, x)
∧ SUIT (c4, x) ∧ SUIT (c5, x)
⇒
FLUSH (c1, c2, c3, c4, c5)
을
얻을 수 있다.
② 조건부분을 제거한다.
앞의
훈련사례보다 더 자세한 다음과 같은 훈련사례가 주어졌다고 하자.
사례
1. SUIT (c1, clubs) ∧ RANK (c1, 3)
SUIT
(c2, clubs) ∧ RANK (c2, 5)
SUIT
(c3, clubs) ∧ RANK (c3, 7)
SUIT
(c4, clubs) ∧ RANK (c4, 10)
SUIT
(c5, clubs) ∧ RANK (c5, king)
⇒
FLUSH (c1, c2, c3, c4, c5)
여기서 무늬에 대한 것뿐만 아니라 순위에 대한 정보까지도 포함되어 조건부분에서 교집합결합 (Conjunction) 으로 결합되어 있다. 이러한 교집합결합은 사례에 대한 제약조건을 형성하게 된다. 위의 사례에서는 무늬만 같으면 되지 순위가 반드시 3, 5, 7, 10, king 이어야 하는 것은 아니다. 따라서 이 사례에서 교집합 결합으로 연결된 RANK 술어들을 떨어뜨림으로써 일반화를 이룰 수 있다.
Mitchell [77, 79] 은 사례로부터 단일개념을 학습하는 하나의 틀을 제공하였다. 그는 먼저 개념의 표현에서 그것의 일반화된 정도에 따라 순서를 매길 수 있다고 보았다. 예를 들어, 다섯 장의 카드에 대해서 ∃c1 : RED(c1) 은 다섯장 중 적어도 한 장은 빨간색이다라는 것이며, 이는 적어도 두 장이 빨간색이다라는 뜻인 ∃c1, c1 : RED(c1) ∧ RED(c2) 보다는 일반적이다. 왜냐하면 적어도 두 장의 빨간색 카드를 가지는 모든 다섯 장의 카드의 조합이 빨간색 한 장만 가지는 경우에 포함되기 때문이다. 이렇게 일반화의 정도에 따라 규칙공간의 모든 개념들의 순서를 매길 수 있다. 훈련사례만 주어진 초기 상태에서 가장 구체적인 개념은 훈련사례 그 자체가 될 것이고, 가장 일반적인 개념은 널 (Null) 진술로서 모든 것을 다 포괄하는 개념 - 즉, 모든 제약과 조건이 떨어진 사례 전체를 일컫는 진술 - 이 될 것이다.
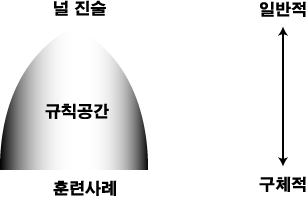
그림 3 규칙공간의 도해
이러한 규칙공간에서 선택가능한 가설집합 H 를 상정할 때 H 중 가장 일반적인 것들을 G 집합이라 하고, 가장 구체적인 집합을 S 라 하자. 그러면 H 는 G 와 S 로 경계지어지는 집합이 될 것이다. Mitchell 은 이러한 가설집합 H 를 사례에 아직 저촉되지 않은 가설집합이라 하고 이를 버전공간 (Version Space) 라 불렀다. 따라서 버전공간 H 는 현재까지 제시된 모든 사례를 수용하는 규칙공간이 된다.
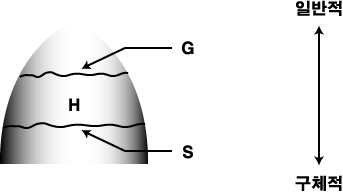
그림 4 규칙공간에서 G 와 S 집합을 경계로 하는 부분공간
Mitchell 은 이러한 버전공간 중 필요한 개념을 생성하는 학습과정을 대안제거 학습알고리즘 (Candidate-elimination Learning Algorithm) 이라 하였다. 이는 처음에 집합 H 는 모든 표현가능한 개념으로서 구성되지만 훈련사례가 주어지게 되면서 그것에 저촉되는 대안개념 (Candidate Concept) 들이 버전공간에서 제거되게 된다. 이러한 제거과정에서 마지막까지 남는 대안개념이 찾고자 하는 개념이 되는 것이다. 긍정사례 (Positive Instance) 가 주어지면 이를 포함하는 개념이 제거되며 따라서 구체화로 진행된다. 그런데 이러한 진행과정은 최소한의 일반화 및 구체화과정만을 허락하고 필요 이상은 진행하지 않는다. 즉, 긍정사례가 주어졌을 때 해당 사례를 포함할 수 있는 최소한의 일반화, 다시 말하면 해당 사례를 포함하는 것 중 최대의 구체화만을 수행한다는 것이다. 이런식으로 집합 H 는 차츰 좁혀지며 결국 우리가 원하는 개념만이 남게 된다. 이제 이와 같은 과정의 진행을 포커게임에서 플러쉬 (Flush) 란 개념을 학습하는데 적용시킨 예를 보겠다. 만약 다음과 같은 긍정사례가 이미 주어졌다고 하자.
{(2, clubs), (5, clubs), (7, clubs), (jack, clubs), (queen, clubs)} ⇒ FLUSH
즉, 다섯 장의 카드가 주어졌는데 모두 무늬가 clubs 이며 2, 5, 7, jack, queen 카드일 경우 이에 대한 가장 구체적인 플러쉬에 대한 대안 가설집합 S 는
S = { SUIT (c1, clubs) ∧ RANK (c1, 2)
∧
SUIT
(c2, clubs) ∧ RANK (c2, 5) ∧
SUIT
(c3, clubs) ∧ RANK (c3, 7) ∧
SUIT
(c4, clubs) ∧ RANK (c4, jack) ∧
SUIT
(c5, clubs) ∧ RANK (c5, queen)}
이 될 것이다. 이는 너무 과도히 구체화된 것으로 이에 따른다면 플러쉬를 이루는 카드는 오직 위와 같은 형태의 하나의 카드집합만 되는 것이다. 또한 이때 가장 일반적인 가설집합 G 는 널 (Null) 진술로서 모든 다섯 장의 카드가 플러쉬를 말한다는 것이다. 따라서 초기의 집합 H 는 이러한 극단적인 가설집합 S 와 G 사이의 임의의 개념진술이 될 것이다.
이제 또 다음과 같은 긍정사례가 주어졌다고 하자.
{(3, clubs), (8, clubs), (10, clubs), (king, clubs), (ace, clubs)} ⇒ FLUSH
이 사례로 말미암아 현재의 가설집합 S 는 너무 구체적인 것이 드러났다고 - 두 번째 사례를 포함하지 못하므로 - 따라서 집합 S 를 보다 일반화하게 된다. 일반화의 방법 중 하나가 조건부분을 떨어뜨리는 것이므로 S 는 다음과 같이 변할 수 있다.
S = { SUIT (c1, clubs), SUIT (c2, clubs), SUIT (c3, clubs), SUIT (c4, clubs), SUIT (c5, clubs) }
그러나 집합 G 는 변하지 않는다. 그런데 이제 다음과 같은 반대사례가 주어졌다고 하자.
{(3, spades), (8, spades), (10, spades), (king, clubs), (ace, clubs)} ⇒ ¬FLUSH
이로써 모든 5 장의 카드가 모두 플러쉬라는 집합 G 는 틀린 개념임을 알 수 있다. 따라서 G 는 위의 반대사례를 포함시키지 않도록 구체화되어야 한다. 요약하면 대안제거 학습알고리즘은 다음과 같이 수행된다.
단계 1. 초기의 버전공간 H 는 모든 가능한 규칙공간이며, G 는 널 진술이 되고, S 는 처음에 주어진 긍정사례와 동일한 개념이 된다.
단계 2. 새로운 하나의 사례를 받아들여 그것이 긍정사례일 경우 G 로부터 이 긍정사례를 포함하지 못하는 개념을 제거하고 S 집합을 일반화하되 이 사례를 포함하는 정도의 최소한의 일반화를 한다. 만약 그것이 반대사례이면 S 로부터 이 사례를 포함시키는 모든 개념들을 제거하고 G 집합을 구체화하되 이 사례를 포함시키지 않을 정도의 최소한의 구체화를 한다.
단계 3. 단계 2 를 G = S 가 될 때까지 반복한다.
단계 4. H 를 출력한다.
단계 4 에서 출력되는 것은 단일개념이 된다.
Winston [70] 이 제기한 사례로부터의 학습방법론은 선구적 위치를 점하고 있다. 사례는 하나씩 주어지는 조건에서 주어진 사례에 대한 개념설명을 의미망 형태로 구성한다. 사례가 들어올 때마다 지금까지 작성한 개념기술이 제대로 이루어지고 있는지가 검토되며, 긍정사례라면 이 사례를 포함시키도록 개념기술이 보다 일반화되고 부정사례라면 이 부정사례를 포함시키지 않도록 개념기술에 조건들이 붙게 된다. 이러한 학습방법론은 집짓기 블록을 적용되었는데 "아치" 의 개념설명을 학습하는 예를 들어보겠다. 먼저 "아치" 를 구성하고 있는 사례에 대해 이를 선으로 그린 그림이 컴퓨터에 주어지면 해석기관에서는 이를 의미망 형태로 변형시켜 저장하게 된다. 그림 5 는 "아치" 의 예의 선 그림과 이의 의미망이다.
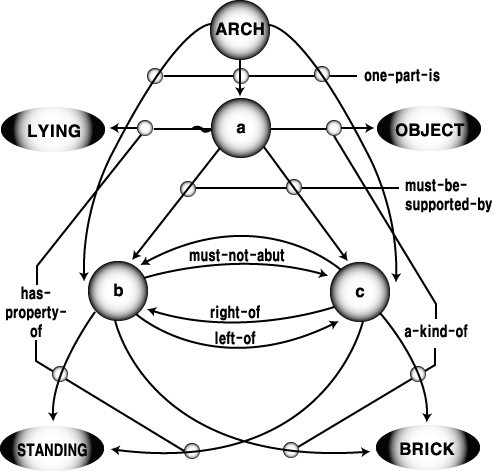
그림 5 아치에 관한 의미망
이 의미망의 내용의 이해를 위해 다음과 같은 술어해석의 표현으로 옮겨 볼 수 있다.
ONE-PART-IS(arch, a) ∧ ONE-PART-IS(arch,
b) ∧
ONE-PART-IS(arch, c) ∧ HAS-PROPERTY-OF(a, lying) ∧
A-KIND-OR(a,
object) ∧MUST-BE-SUPPORT-OF(a, lying) ∧
MUST-BE-SUPPORTED-BY(a, c)
∧ MUST-NOT-ABUT(b, c) ∧
MUST-NOT-ABUT(c, b) ∧ LEFT-OF(b, c) ∧ RIGHT-OF(c,
b) ∧
HAS-PROPERTY-OF(b, standing) ∧ HAS-PROPERTY-OF(c, standing) ∧
A-KIND-OF(b,
brick) ∧ A-KIND-OF(c, brick)
Winston 의 학습알고리즘은 다음과 같이 진행된다.
단계 1. 첫 번째 사례로부터 선 그림과 의미망 변형을 통해 초기 개념설명 H 를 작성한다.
단계 2. 새로운 사례에 대한 의미망과 기존의 H 와의 공통부분을 찾고 서로 공통되지 않는 부분에 대해서 표시를 한다.
단계 3. 이 표시된 부분이 어떻게 수정되어야 할지를 결정한다. 만약 새로운 사례가 긍정사례라면 이 사례를 H 가 포함시킬 수 있도록 H 를 가능한한 일반화시킨다. 일반화의 방법은 링크나 노드를 떨어뜨리거나, 노드를 보다 일반적인 개념노드로 대체한다. 여러 가지 방법 중 가장 적게 일반화시키는 방법을 선택하고 다른 방법들을 나중에 의해 저장한다. 만약 새로운 사례가 반대사례라면 필요조건을 H 에 추가한다. 만약 이러한 조건이 여러 개라면 이 중 한 개를 선택하고 나머지는 무시한다.
단계 2 와 3 을 훈련자가 중단할 때까지 지속한다.
단계 3 에서 적절치 못한 필요조건을 선택할 수도 있다. 예를 들어 그림 6 과 같은 아치의 반대사례가 있을 때 이 원인을 두 개의 기둥이 서로 붙어 있다는 것에 두지 않고 삼각형의 지붕을 하고 있다고 했다면 그림 7 이 긍정사례로 주어졌을 때 모순이 발생한다. 왜냐하면 그림 9 는 지붕이 삼각형임에도 아치이기 때문이다. 이러한 모순이 발견되면 다시 마지막 순서로 돌아가 다른 필요조건, 즉 "기둥이 서로 붙어 있지 말 것" 이라는 조건을 추가하게 될 것이다. Winston 은 이러한 학습알고리즘이 성공적으로 수행되기 위해서는 적절한 사례의 준비가 중요하다는 것을 강조하고 각각의 사례가 어느 한 점을 강조하도록 주어져야 하며, 반대사례는 너무 급격한 차이가 나는 반대사례가 아니라 거의 긍정사례와 같으나 약간의 차이로 인해 반대사례가 된 것들 (Nearmiss) 만을 제시하는 것으로 가정했다.
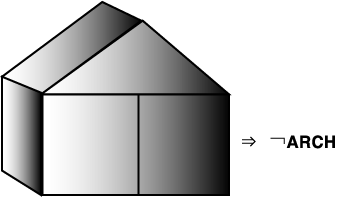
그림 6 아치에 대한 반대사례
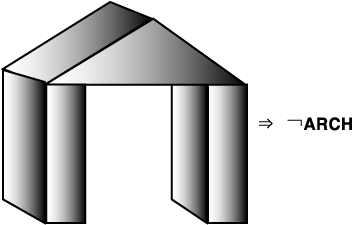
그림 7 아치에 대한 긍정사례
ID3 (Interactive Dichotomizer 3) 는 Quinlan 이 개발한 학습방법으로서 어떤 개념에 관한 예와 반례로써 훈련집합 (Training Set) 이 주어졌을 때 이로부터 개념을 구별할 수 있는 의사결정트리형태의 분류규칙을 생성시킨다. 여기서 분류하고자 하는 개념들을 클래스 (Class) 라 하고, 이 클래스에 관한 예는 해당 클래스를 한정된 수의 특성 (Property, Attribute) 으로써 묘사된다.
ID3 는 Hunt 의 CLS 에 그 배경을 두고 있다. 먼저 CLS 를 설명하면, CLS 는 두 개의 클래스를 묘사하는 객체들로부터 클래스를 분류하는 규칙을 생성시키는 상대적으로 간단한 알고리즘이다. 객체는 한정된 수의 특성 (Attribute) 으로 구성되어 있고, 각 특성은 취할 수 있는 값들을 가지고 있다. 예를 들어, '색깔' 이란 특성은 {빨강, 초록, 파랑} 의 값을 가질 수 있다. 규칙생성은 이들 객체의 집합 C 로부터 다음과 같이 생성된다. 만약 C 에 속한 객체들이 모두 하나의 클래스에 속한 것이 아니라면, 하나의 특성을 선택하여 그 특성이 취하는 값에 따라 객체집합 C 를 C1, C2, ... Cn 으로 나눈다. 여기서 Ci 는 해당 특성이 i 번째 특성값을 취하는 객체집합 C 의 부분집합이다. 이때 선택된 특성은 루트노드를 형성한다. 예를 들어 다음과 같은 집합 C 가 있다고 하자. 여기서 + 와 - 는 각 객체들이 속하는 클래스라고 하자. 모두 세 개의 특성 "키", "눈", "두발" 이 있고 각각은 {크다, 작다}, {작은 눈, 보통 눈, 큰 눈}, {길다, 짧다} 의 값을 가진다고 하자.
C = { (작다, 큰 눈, 길다 : +), (작다, 작은
눈, 길다 : -), (크다, 작은 눈, 짧다 : -),
(크다,
큰 눈, 짧다 : -), (크다, 작은 눈, 길다 : -), (작다, 큰 눈, 짧다 : -),
(크다, 보통 눈, 길다 : +),
(크다, 큰 눈, 길다 : +) }
만약 두 번째 특성인 눈을 선택하였다면 눈의 값에 따라 객체들이 나뉘어져 다음과 같은 트리가 형성된다.
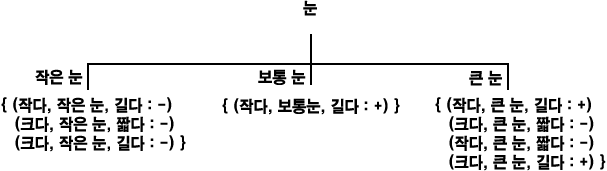
그림 8 ID3 의 트리생성 과정 (특성 '눈' 에 의한 객체집합분할)
각 객체의 하위부분집합은 각각 눈의 값이 작은 눈, 보통 눈, 큰 눈에 해당되는 집합이다. 여기서 작은 눈이나 보통 눈에 해당하는 집합에서는 모든 객체가 하나의 클래스에 속하므로 더 이상의 작업은 없다. 그러나 큰 눈에 해당하는 부분집합은 + 와 - 클래스를 구분하기 위해 또 다른 특성을 정할 필요가 있다. 만약 두발을 선택하였다면 다음 그림과 같은 형태가 된다.
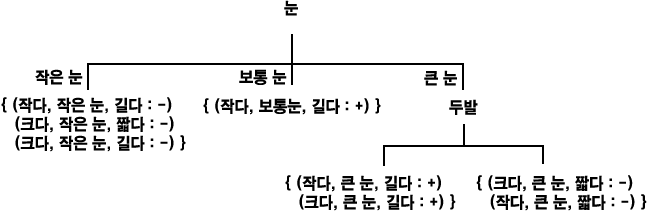
그림 9 ID3 의 트리생성 과정 (특성 '눈' 과 '두발' 에 의한 객체집합분할)
이제 모든 하위집합들의 클래스가 하나의 클래스에 속하므로 분류작업에 의한 의사결정트리의 생성이 끝나게 된다. 위의 의사결정트리를 해석하면 눈이 작은 경우 클래스 "-" 에 속하고, 눈이 크고 두 발이 길면 클래스 "+" 에 속한다는 것을 나타낸다. 이 의사결정트리는 다음과 같은 규칙으로 바로 정리될 수 있다.
IF 눈 = 작은 눈 THEN -
IF 눈 = 보통
눈 THEN +
IF 눈 = 큰 눈 AND 두발 = 길다 THEN +
IF 눈 = 큰 눈 AND 두발
= 짧다 THEN -
또는 OR 를 이용하여 같은 클래스의 결론을 나타내는 규칙은 OR 을 이용하여 1 개로 정리할 수도 있다.
IF 눈 = 작은 눈 OR (눈 = 큰 눈 AND 두발 = 짧다) THEN -
따라서 트리를 형성한다는 것은 바로 분류규칙은 생성한다는 것과 같은 의미로 사용될 수 있다.
위의 경우 "키" 라는 특성을 전혀 사용되지 않고 있다. 특성을 선택할 때 가급적 트리의 크기가 작아질 수 있도록, 즉 객체들의 분별력이 가장 큰 특성을 선택하는 것이 바람직하다. 각 특성들의 분별력의 정도를 측정하기 위해서 Quinlan 은 정보의 복잡성 및 단순성을 측정하는 Information theoretic 측정치 (Measure) 를 이용하였다. 두 개의 클래스가 있다고 가정하고 하나를 +, 비율을 P+, - 클래스가 속해 있는 비율을 P- 라고 한다면 이 객체집합이 C 가 가지고 있는 정보값 M(C) 를 .........................
M(C) = -P+ log2 P + -P- log2 P- ㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍ(식 1)
라고 나타낼 수 있다. 위의 값 M(C) 는 현재 객체들의 정보값으로 이 값이 높을수록 이 객체집합의 클래스는 서로 심히 섞여 있음을 나타낸다. 만약 0 값을 가진다면 이 집합의 객체들은 단일클래스에 속하고 있음을 나타낸다. 즉, 값이 작을수록 어떤 질서상태를 나타내고 클수록 무질서 상태 또는 정보력이 약한 상태이다. 다음 그래프는 P+ 값의 변화에 따른 M(C) 의 변화를 나타낸 것이다. P+ 가 0 이나 1 일 경우 M(C) 는 0 이 되고 P+ 가 1 인 경우는 객체집합 C 가 모두 클래스 + 에 속해 있고, 0 이라는 것은 모두 클래스 - 에 속해 있다는 것이다. 또한 이 값이 0.5 라는 것은 클래스 + 와 클래스 - 가 반반씩 섞여 있다는 것이므로 가장 복잡한 경우를 나타낸다.
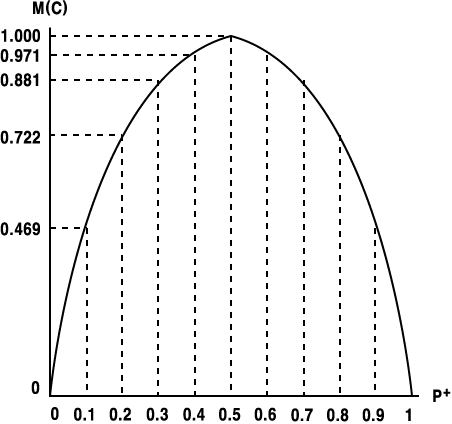
그림 10 P+ 값의 변화에 따른 M(C) 의 변화
만약 정보값 M(C) 를 가지고 있는 객체집합을 특성 A 를 선택하여 하위객체집합으로 나누었을 경우 각 하위집합의 정보값의 객체들의 개수에 따른 가중평균 B(C, A) 가 원래 M(C) 보다 작다면 특성 A 로 인해 정보값의 차이인 M(C) - B(C, A) 만큼 정보를 획득한 셈이 된다.
이를 앞의 예에 적용해 보면 M(C) 의 값은 클래스 + 에 속하는 객체가 세 개, - 에 속하는 객체가 다섯 개이므로,
M(C) = -3/8 log2 3/8 - 5/8 log2
5/8
= 0.954
가 된다. 만약 첫 번째 특성으로 "키" 를 선택하여 객체집합 C 를 나눈다면 다음 그림과 같이 된다.
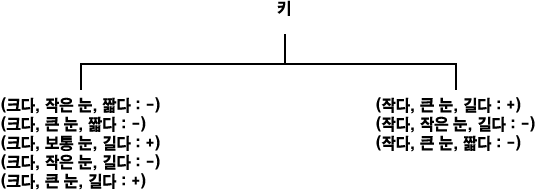
그림 11 ID3 의 트리 생성 (특성 = '키' 에 의한 객체집합의 분할)
크다 쪽 갈래 (Branch) 의 하위집합의 정보값은
-2/5 log2 2/5 - 3/5 log2 3/5 = 0.971
이고, 작다 쪽 갈래의 하위집합의 정보값은
-1/3 log2 1/3 - 2/3 log2 2/3 = 0.918
이다. 따라서
B(C, "키") = 5/8 * 0.971 + 3/8 * 0.918 = 0.003
이므로
M(C) - B(C, "키") = 0.954 - 0.951 =0.003
이 된다. 이 값은 매우 작으므로 특성 "키" 는 클래스 + 와 - 를 구별하는데 그리 큰 영향을 갖지 않는다.
이제 특성 "눈" 에 대해 B(C, "눈") 을 구해보면,
B(C, "눈") = 3.8 * 0 + 1/8 * 0 + 4/8 * 1 = 0.5
이므로 0.954 - 0.5 = 0.454 의 정보획득을 얻을 수 있다. 마찬가지로 계산하면 특성 "두발" 의 정보획득은 0.347 이다. 따라서 정보획득을 최대화한다는 원칙에 의해 ID3 는 "눈" 을 의사결정트리의 루트노드로써 선택한다. 즉, 눈이 가장 변별력 있는 변수 (Discriminatory Variable) 가 된다.
ID3 는 이와 같은 원리에 의해 수행되며 이때 객체는 사례 (Instance) 가 된다. 사례란 각 클래스를 주어진 특성으로 묘사하는 객체라고 할 수 있다. 예나 반례는 특정 클래스를 기준으로 구분되어진다. 즉, 어떤 사례가 클래스 C1 을 묘사하고 있으면 해당 사례는 C1 의 예요, 다른 클래스, 즉 C1c 를 묘사하면 C1 의 반례라고 할 수 있다. ID3 는 점진적 학습방법이 아니므로 미리 필요한 모든 훈련집합이 갖추어 있어야 한다. 그러나 훈련집합이 매우 클 경우 다음과 같은 절차로 ID3 를 수행할 수 있다.
① 훈련집합으로부터 부분집합 W (윈도우라 부름) 를 무작위로 선택한다.
② W 에서 의사결정트리를 생성한다.
③ 나머지 사례에서 생성된 규칙을 적용하여 예외적인 사례를 발견한다.
④ 만약 이러한 예외적인 사례가 있다면 이 예외적인 사례를 원래의 윈도우 W 에 포함시키고 다시 ②번 단계부터 시작한다.
ID3 는 점진적인 학습방법이 아니므로 각 사이클마다 먼저 있던 트리를 버리고 새로이 의사결정트리를 생성하게 된다.
M(C) 와 B(C, A) 를 보다 일반적인 경우에서 다시 정의하면 다음과 같다.
특성 Aj 의 집합이 있고, j = 1, ..., M
특성 Aj 는 |Aj| 개의 값을 가지고 클래스는 Ci, i = 1, ..., k 가 있다고 할 때, 사례객체의 집합 C 의 정보값 M(C) 는,
M(C) =  Pi log2 Pi ㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍ(식
2)
이고, 여기서 Pi 는 클래스 Ci 가 사례집합 C 에서 차지하는 비율이다. 또한 특성 Aj 를 사용하여 집합 C 를 나누었을 경우 정보값 B(C, Aj) 는 다음과 같다.
B(C, Aj) =  Wi * M(Si) ㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍ(식 3)
여기서 |Aj| 는 특성 Aj 가 취할 수 있는 값의 개수이다. 그리고 M(Si) 는 Aj 특성의 i 번째 값을 가지는 경우 하위사례집합 Si 의 정보값이고, Wi 는 가중값인데 다음과 같이 나타낼 수 있다.
|
Wi = |
Si 에서의 사례의 수 |
|
C 에서의 사례의 수 |
이와 같은 ID3 는 방법이 간단하여 널리 사용되는 학습방법이나 다음과 같은 단점을 가지고 있다.
① 생성된 규칙은 불확실성을 반영하지 않는 결정적인 규칙이다. 따라서 적용되는 영역이 불확실성을 내표하고 있거나 틀린 사례를 제공하는 경우에는 적합치 않다. 서양장기 등에 적용한 예는 매우 성공적인 결과를 보였다. 그러나 일기예보와 같은 분야는 주어진 훈련집합을 구분하는 의사결정트리가 매우 가지가 많은 큰 트리 (Bush Decision Tree) 로 표현되기 때문에 새로운 사례를 올바르게 구분을 해주지 못한다. 최악의 경우 훈련집합의 사례 하나하나에 대해 트리의 결정노드가 생성될 수 있다.
② 예외적인 사례를 인정하지 않는다. 이것은 ① 의 특성의 귀결이라 볼 수 있다. 예외적인 사례가 있다면 그것을 포괄하는 결정노드가 전체 의사결정트리에 새로이 첨가되어 가지를 뻗을 것이다.
③ 똑같은 사례일 경우 그 수가 아무리 많아도 최종적인 트리형성에 영향을 미치지 못한다.
④ 훈련집합의 내용이 약간 변하여도 이에 과민반응하여 전체 의사결정트리의 모양이 달라지게 된다.
이러한 단점 때문에 한 하위트리 내의 사례집합에서 예외가 모두 없어질 때까지 트리를 생성케 하지 않고 어떤 기준을 주어 중간에서 멈추게 하는 방법을 쓰기도 한다.
또한 특성값이 수치인 경우, 수치의 범위를 어떤 구간으로 나누어 유한 개의 그룹으로 묶을 수도 있다. 즉, 1에서 10 까지의 정수가 특성 A 가 취할 수 있는 값이라면 1 에서 5 를 그룹 1, 6 에서 10 을 그룹 2 로 나누어 그룹이름이 특성 A 가 취할 수 있는 값이 된다. 이렇게 하는 경우의 단점은 정보력이 감소된다는 것이다. 즉, 원래는 열 개의 값으로 특성의 상태를 세밀하게 묘사하였으나 두 개의 그룹으로 나누면 정보력이 그만큼 둔화된다. 또는 열 개의 수치값 각각을 별개의 특성값으로 보고 ID3 를 사용할 수 있다. 비록 수치값의 범위가 너무 클 경우 (예를 들면 1 과 2 사이의 임의의 실수) 비효율적이지만 다음과 같은 방법이 있을 수 있다. 훈련집합에서 동일한 특성하의 모든 수치값 Vi (i = 1, ...n) 의 집합 V 를 오름차순으로 정돈하고 (i < j 이면 Vi < Vj), 각 k (k = 1, ...n-1) 에 대해 V 를 두 개의 하위집합 {Vi, ... Vk} 와 {Vk+1, ... Vn} 으로 나눈다. 이렇게 나눈 두 개의 하위집합 중 가장 정보력의 획득이 커지도록 하는 k 를 선택하는 것이다. 즉, 특성 A 를 {V1, ... Vk} 과 {Vk+1, ... Vn} 으로 나누고 전자를 S1, 후자를 S2 라고 했을 때 다음 (식 4) 를 최소로 해주는 k 를 선택하는 것이다.
B(C, Aj) =  Wi * M(Si) ㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍㆍ(식 4)
ID3 는 자동학습알고리즘 중 상당히 많이 응용되고 상품화된 방법론이다. 현재 국내에서는 UNIK-INDUCE 가 개발되어 있다.
ID3 를 이용하여 경영문제에 적용된 몇 가지 대표적인 사례를 소개한다. 먼저 1988년 Management Science 에 발표된 Messier 와 Hansen [88] 의 논문에서는 ID3 를 기업의 대출불이행과 도산의 예측에 적용하여 통계적 방법론인 Multiple Discriminant Analysis (MDA) 보다 더 우수하고, 인간전문가 (Human Expert) 보다도 우수하다고 보고하고 있다. 또한 1987년 Decision Science 에 실린 Braun 과 Chandler [87] 의 논문에서는 ID3 를 주식시장에 적용하였는 바 시장예측력이 MDA 보다 낫다고 하였다. 국내에서도 국내 데이터를 이용하여 이건창 [93] 은 1993년 경영과학회지에서 ID3 가 MDA 보다 기업도산예측에 있어 더 우수하다고 한 바있다. 그러나 신경회로망보다는 예측력이 떨어지는 것으로 보고 되고 있다.
ID3 는 그 방법론의 유사성으로 인해 MDA 와 같은 통계적 방법론과 그동안 많은 비교 연구가 있어 왔다. MDA 와 같은 통계적 방법론도 주어진 데이터를 분석하여 가장 데이터를 잘 설명해 주는, 즉 가장 적합한 (Fitting) 모델 (설명력이 높은 결정변수의 선형함수 형태) 을 생성하므로 이러한 모델을 지식이라고 간주한다면 주어진 데이터로부터 지식을 생성하는 것이 된다. 그러므로 넓은 의미에서 보면 MDA 도 학습의 일종이라 볼 수 있다. 그러나 MDA 와 같은 통계적 방법론은 독립변수의 분포가 정규분포임을 가정하고 있다. 또한 MDA 는 독립변수와 종속변수간에 선형함수를 가정하고 있다. 이러한 제약으로 인해 이러한 가정을 충족시키지 못하는 경우 적용에 한계가 있을 수밖에 없다. 그러나 ID3 와 같은 귀납적 학습방법은 독립변수의 분포에 아무런 가정을 하지 않고 있다. 또한 MDA 에는 생성된 모형에 의한 추론 과정에서 설명이 불가능하다.
그 외에 ID3 와 유사한 통계적 방법론으로 로지트분석 (Logic Analysis), 프로비트분석 (Probit Analysis) 등과 같은 통계적 모형이 있다.
유추에 의한 추론 (Analogical Reasoning) 은 과거의 문제해결 (Problem Solving) 경험을 토대로 그와 유사한 문제를 해결하는데 매우 효과적으로 사용될 수 있다. 이것은 선생이 학생들에게 예제문제를 풀어주고 그와 유사한 문제를 학생들 스스로 풀 게 하는 경우를 생각해 보면 쉽게 이해할 수 있다. 학생들은 방금 선생이 사용하였던 해결과정을 유추하여 주어진 문제를 해결할 것이다. 이것은 간단히 다음 그림처럼 나타낼 수 있다.
그림 12 유추에 의한 문제해결과정
그림 12 에서는 새로운 문제에 봉착했을 때 현 문제와 가장 유사한 과거의 상황을 돌이켜 그 과거문제를 풀었던 방법과 해를 회상하여 현재의 문제에 맞게 변형한 후 현재의 문제를 해결하는 과정을 보이고 있다. 이러한 과정을 통해 새로운 문제가 성공적으로 해결되었을 경우 이 새로운 문제해결법이 하나의 지식으로 생성되며 이러한 지식축적과정이 바로 유추에 의한 학습 (Learning by Analogy) 이 된다.
앞 절에서 소개된 사례로부터의 귀납적 개념획득은 주로 비절차적 개념의 획득이었고 문제해결 (Problem Solving) 의 영역에는 잘 적용되지 않아왔다. 그러나 문제해결의 기술습득 또한 학습의 중요한 영역이라 볼 때 유추에 의한 학습은 이러한 영역을 위한 자동학습방법이 될 수 있다. 현재 이 영역은 방법론상 명확히 정립된 연구가 그렇게 많지 않은 편이다.
지금까지의 자동학습과정은 대부분 외부의 안내자 (Tutor) 가 단서를 주거나 또는 문제해결 방법을 추적하는 내부적인 과정에 의해 정보를 얻어 지식을 구축하는 형태이다. 그러나 오직 관찰과 실험을 통해 현상의 규칙성을 파악해야 하는 상황이 많이 발생한다. 이러한 것은 과학자들이 새로운 사실이나 이론을 발견하는데서 많이 찾아 볼 수 있는 방법이다. 새로운 분류법이 형성이나 관찰된 데이터의 규칙성을 통해 어떤 법칙을 발견하는 것이 바로 발견에 의한 학습 (Learning by Discovery) 의 주요 목표이다. 이에는 분류법형성과 개념적 집단화방법과 규칙의 발견방법 등이 포함된다.
우리는 무수히 주어지는 객체들을 어떤 기준으로 분류하지 않으면 학문의 발전이 이루어지기 힘든다는 것을 안다. 예를 들어, 생물에 대한 이해를 증진하기 위해 우리는 무수한 생명체를 크게 동물과 식물, 그리고 동물을 다시 포유류, 조류, 어류 등의 하위클래스로 나누게 된다. 우리에게 주어진 관찰대상이 그림 13 에 제시된 어떤 세포라고 하자. 각 세포는 핵과 꼬리의 두 개의 부분으로 구성되어 있으며, 각각은 핵을 한 개 혹은 두 개, 그리고 꼬리를 한 개 혹은 두 개를 가지고 있다. 이러한 세포들을 어떤 기준으로 분류할 것인가. 우리의 목표는 분류기준을 세우는 것이다. 그리고 나서 그 분류된 무리에 대해 어떤 이름을 부여할 것이다.
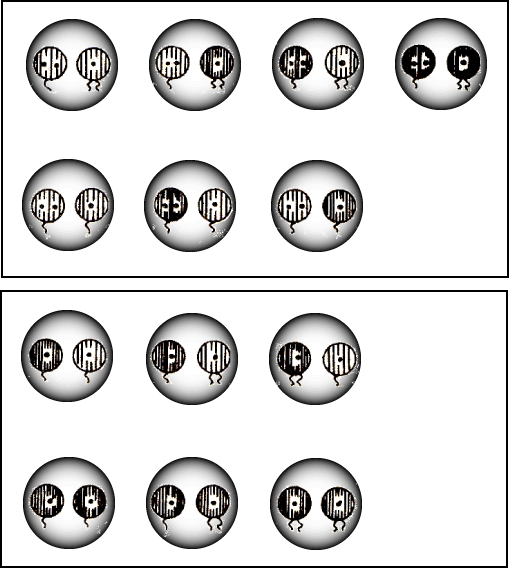
그림 13 분류법 형성문제
여러 가지 방법으로 분류할 수 있겠으나 그림 14 는 하나의 분류형태를 계층적으로 나타내고 있다.
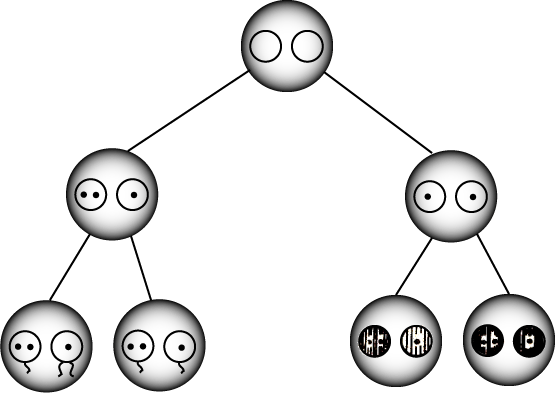
그림 14 분류계층
가장 위 분류는 주어진 세포들 전체로 구성되며 이는 크게 두 개의 부분으로 나눌 수 있다. 그리고 그 하위분류로써 핵이 두 개와 한 개로 되어 있는 세포와 각기 한 개의 핵을 가지는 세포로 분류된다. 그리고 전자는 꼬리개수의 조합에 따라 분류되고 후자는 색깔에 따라 분류되고 있다. 이러한 과정을 분류법의 형성 (Taxonomy Formation) 혹은 개념적 집단화 (Conceptual Clustering) 라 하는데 이를 위한 방법으로 여러 가지 연구가 진행되어 왔다. 여기서는 Fisher [85] 가 개발한 RUMMAGE 란 방법론을 소개한다. RUMMAGE 는 대상이 되는 객체를 특성 - 값 (Attribute-value) 의 조합으로 표현한다. 그리고 이들 특성값으로부터 분류에 필요한 정보를 얻는다. 다음은 RUMMAGE 가 취한 개념적 집단화의 과정이다.
① 분류계층의 가장 위 노드를 생성한다.
② 각 특성에 대해서 그 특성값에 따라 객체들을 정렬한다.
③ 특성의 각 값에 따라 해당값을 가지는 객체에 대한 개념을 기술한다.
④ 개념기술 중에 가장 "좋은", 즉 가장 간단하고 집단간에 유사성을 가장 작게하는 개념기술 (Concept Description) 을 선택하여 해당 특성을 선정한다.
⑤ 이 특성에 따라 객체들을 분류하여 가지를 형성하여 자식노드를 형성한다.
⑥ 이러한 과정을 반복하여 어떤 기준 이하로 분류의 가치가 떨어질 때 중단한다.
이러한 과정은 ID3 와 유사한 점이 많으나 ID3 와 다른 점은 ID3 는 객체를 나타낼 때 특성과 값 외에도 외부에서 미리 주어진 클래스가 부여되나 RUMMAGE 는 이러한 클래스에 관한 기술을 스스로 생성하고 있다는 것이다. 그러나 이 두 가지 모두 트리형태의 표현과 탑-다운 (Top-down) 형태의 전개과정을 사용하고 있다는 점에서는 같다. 그러나 RUMMAGE 는 각 브랜치 (Branch) 를 형성할 때 오직 하나의 특성만을 기준으로 하고 있기 때문에 표현상 한계를 지니고 있다.
새로운 수학적 법칙이나 화학반응의 법칙 등을 발견하는 과정은 어떤 규칙성의 관찰이나 흥미있는 현상의 탐구 속에서 이루어진다. 이러한 분야에 대한 연구는 그리 많지 않으나 여기서는 AM 과 BACON.4 에 대해서 소개한다.
Lenat [83] 의 AM 은 수 이론 (Number Theory) 을 대상 영역으로 한다. AM 은 미리 수백 개의 기본개념, 예를 들어 집합에 대한 소속의 개념 (Set membership), 합집합의 개념 (Set union) 등의 개념들이 미리 주어진 상태에서 출발한다. 또한 이 외에도 새로운 개념을 제시하고 추측하며, 데이터를 모으고, 무엇이 흥미있는 개념인지를 결정할 수 있는 수백 개의 휴리스틱이 주어진다. 예를 들어, 한 휴리스틱은 어떤 개념이 그 예가 불과 몇 개 안될 때 (그러나 한 개 보다는 많음) 이를 흥미있다고 판단한다. 만약에 어떤 개념에 대한 예가 너무 없을 경우에는 AM 은 그 개념을 좀더 일반화시키고, 너무 흔하다면 좀더 구체화시킨다. 또한 서로 다른 경로에 의해 도출된 것이 같은 개념이라고 할 때 이를 흥미있다고 하고 다음 새로운 개념을 도출하기 위한 재료로서 우선권을 부여한다. AM 은 수리적 개념공간을 흥미의 정도에 따라 탐색하게 된다. AM 은 이러한 기본개념과 휴리스틱을 바탕으로 여러 재미있는 개념들을 도출하였다. 예를 들어, 정수라든지 덧셈, 곱셈, 인수, 소수와 같은 것이다. 또한 AM 은 모든 정수는 소수의 곱으로 유일하게 표현될 수 있다는 것과, 모든 정수는 두 개의 소수의 합으로 나타낼 수 있다는 사실을 도출하였다.
또 다른 시스템으로서 BACON.4 (BACON 의 4 번째 버전) 는 계량적 법칙을 유도한다. 예를 들어, 변수와 그에 대한 측정치 등이 주어지면 (예를 들어 압력, 부피, 온도 등) 이 시스템은 이들 변수간의 관계에 대한 관측된 법칙을 유도한다 (예를 들어 PV/T = 8.32). BACON.4 는 물리학이나 화학의 역사에서 등장했던 여러 법칙들을 재발견하였다. BACON 은 이러한 법칙을 발견하기 위해 일련의 데이터 수집을 체계적으로 수행한다. BACON 은 어느 시점에 하나의 독립변수를 변형시키고 그에 따른 종속변수들의 변화를 검토한다. 그리고 이들 변화간의 관계가 일정비율로 일관적인 변화가 발견될 때까지 반복하여 이들 변수들로 위의 예 (PV/T) 와 같이 일정값을 갖게 되는 새로운 변수항을 만든다. 이렇게 발견된 변수항을 상수로 두고 다시 그 다음 차원의 발견을 위해 또 다른 독립변수를 변화시킨다. 이와 같은 BACON 의 발견기법은 아주 간단하며 다음과 같은 휴리스틱으로 표현할 수 있다.
① 만약 변수 (또는 변수항) X 가 상수에 가까운 값을 가질 때, X 를 포함하는 법칙을 생성한다.
② 그렇지 않은 경우, X 가 증가할 때 Y 도 증가한다면 비율 X/Y 를 새로운 변수로 보고 다시 ① 의 단계를 진행한다.
③ 그렇지 않은 경우, X 가 증가할 때 Y 는 감소한다면 곱 XY 를 새로운 변수로 보고 다시 ① 의 단계를 진행한다.