탐색 전략 (Search Strategy)
인공지능 원론 : 유석인, 교학사, 1988, Page 57~109
3. 정보를 제공받지 않은 (uninformed) 그래프 탐색방법
(5) 단조 제한 (monotone restriction)
(3) 가분해 (decomposable) 시스템과 가환 (commutative) 시스템
본 장에서는 앞서 논한 인공지능 생성 시스템에 대한 제어방법들을 살펴보고자 한다. 제어문제에서 가장 중요한 부분은 현재 수행과정에서 확장을 위해 적절한 규칙을 선택하는 것이며, 그외 보조적이지만 필요한 부분으로서 규칙 적용 가능성 검사, 수행 종결 검사, 지금까지 적용된 규칙들의 추적 등을 들 수 있다.
규칙들을 선택하기 위한 계산에서, 문제에 대한 정보 (information) 또는 지식 (knowledge) 을 얼마나 이용하였는가 하는 것은 올바른 제어전략에 큰 영향을 미친다. 만일 문제에 대한 정보를 고려하지 않으면 적용할 규칙들은 무작위 (random) 로 선택된다. 그러나 유용한 정보를 이용하는 경우 제어전략은 매 번 적절한 규칙을 선택하도록 유도하는데 도움을 주게 된다.
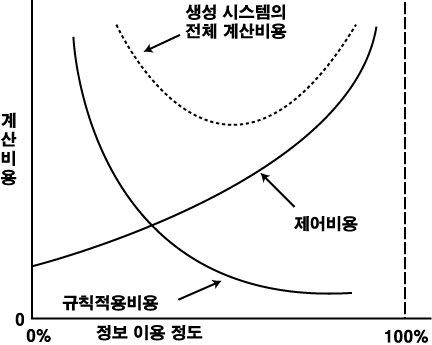
인공지능 생성시스템의 전체 계산비용 (또는 계산 효율성) 은 제어전략에서 문제의 유용한 정보를 얼마나 제공받았는가에 달려 있다. 생성 시스템의 계산비용은 대개 규칙적용비용과 제어비용 두 가지로 나누어진다. 아무런 정보도 이용하지 않는 시스템은 적용할 규칙들을 매 번 무작위로 선택하므로 제어비용은 적다. 그러나 문제의 해답을 이끌기 위해서는 많은 수의 규칙들의 적용이 필요하게 된다. 반대로 문제에 관한 유용한 정보를 완전히 이용하는 시스템은 이 정보들을 이용해서 적용할 규칙들을 선택하게 되므로 앞의 경우와 비교할 때 규칙을 선택하는데 있어 많은 양의 기억공간과 계산시간이 요구하게 되어 제어비용을 높이게 된다. 그러나 이 경우에는 적은 수의 규칙들을 적용하여 문제의 해답에 이를 수 있으므로 규칙적용비용은 낮아진다. 그림 1 은 이러한 사실을 잘 표현하고 있다.
그림 1 인공지능 생성 시스템의 계산비용
인공지능 생성 시스템의 전체 계산비용은 규칙적용비용과 제어비용을 합한 것이므로 효율적인 인공지능 시스템을 구현하기 위해서는 두 가지 비용이 조화를 이루어 전체적으로 최적의 비용이 되도록 하는데 있다. 이를 위한 중요한 측면은 과도한 제어비용을 허용하지 않고 많은 문제 정보를 이용하는 제어전략을 실현하는 기법이라 할 수 있다. 이 기법의 실현은 그림 1 의 제어비용곡선의 기울기를 낮추어 결과적으로 생성 시스템의 전체비용을 낮게 한다.
적용할 규칙을 선택하는 제어 시스템의 행위는 일종의 탐색과정 (search process) 이라 할 수 있다. 제 3 장에서 제어 시스템을 위한 탐색방법들이 소개되었다. 즉, 과정 회복 불가능한 (irrevocable) 규칙 선택으로 표면을 조사하여 극대값을 찾는 언덕오르기 (hill climbing) 방법, 과정 회복 가능한 (tentative) 규칙 선택의 처리과정을 이용한 역행 (backtracking) 과 그래프 탐색 (graph search) 방법 등이 언급되었다. 결정적 제어방법 (과정 회복이 불가능한 제어방법을 말함) 들이 중요한 응용분야들 (특히 가분해 생성 시스템) 에 이용될 수 있을지라도, 이 장에서는 과정 회복 가능한 제어 방법들에 대해 살펴본다 (물론 이 제어방법으로도 가분해 생성 시스템의 구현이 가능하다).
제 3 장에서 역행을 할 수 있는 일반적인 제어방법을 설명하고, 8-퍼즐에 이것을 적용하여 설명하였다. 단지 적은 양의 탐색만을 요구하는 문제에서는 역행을 할 수 있는 제어방법이 적합하다 하겠다. 그래프 탐색 제어방법과 비교할 때 역행 제어방법은 구현하기가 간단하고 보다 작은 기억공간을 필요로 한다. 역행가능한 제어하에서 생성 시스템 동작은 간단한 순환적 (recursive) 인 프로시쥬어로 잘 표현되어질 수 있다. BACKTRACK 이라 부를 이 프로시쥬어는 단 하나의 인수 DATA 를 가지는데, 이 DATA 는 초기에 생성 시스템의 전체 데이터베이스를 이룬다. 성공적으로 수행이 완료되면 이 프로시쥬어는 일련의 규칙을 내놓게 되는데, 이 규칙들이 만일 순서적으로 초기 데이터베이스에 적용이 되면 종결조건을 만족시키는 데이터베이스를 유도하게 된다. 그러나 만일 이러한 일련의 규칙을 구함이 없이 이 프로시쥬어가 멈추게 되면 FAIL 을 내놓는다. BACKTRACK 프로시쥬어는 다음과 같이 정의된다.
|
프로시쥬어 BACKTRACK (DATA) 1. if TERM (DATA), return NIL ; TERM 이란 이것의 인수 (여기서는 DATA) 가 생성 시스템의 종결 (termination) 조건을 만족하는지에 대한 서술식이다. 만일 성공적으로 종결되면 NIL (공백 리스트라고도 함) 을 내 보낸다. 2. if DEADEND (DATA), return FAIL ; DEADEND 란 이것의 인수가 해결점에 이르는 경로 상에 놓여 있지 않다는 것을 나타내는 서술식이다 (만일 경로상에 있으면 DEADEND 는 거짓을, 경로 상에 있지 않으면 참을 지님). 만일 DEADEND 가 참이면 이 프로시쥬어는 FAIL 을 내보낸다. 3. RULES ← APPRULES (DATA) ; APPRULES 는 이것의 인수에 적용될 규칙들을 구하고 유용할 수 있는 정도에 따라 이들의 순서를 정하는 (무작위이거나 정보를 이용하거나 간에) 함수이다. 4. LOOP : if NULL (RULES), return FAIL ; 만일 적용할 규칙이 더 이상 없으면, 프로시쥬어는 FAIL 을 내보낸다. 5. R ← FIRST (RULES) ; 최적의 규칙이 하나 선택된다. 6. RULES ← TAIL (RULES) ; 5 에서 선택된 규칙을 제외한 적용가능한 규칙들로 다시 RULES 을 수정한다. 7. RDATA ← R (DATA) ; 새로운 데이터베이스를 유도하기 위해 규칙 R 이 적용된다. 8. PATH ←BACKTRACK (RDATA) ; BACKTRACK 프로시쥬어가 새로운 데이터베이스를 가지고 다시 순환적으로 호출된다. 9. if PATH = FAIL, go to LOOP ; 만일 순환적 호출이 실패하면 또다른 규칙을 가지고 다시 시도해 본다. 10. return CONS (R, PATH) ; 그렇지 않으면 PATH 리스트 앞에 R 을 덧붙인 성공적인 일련의 규칙을 내보낸다. |
이 프로시쥬어를 살펴보자. 이 프로시쥬어가 성공적으로 종결되는 순간 (단계 1) 은 이 때의 데이터베이스가 종결조건을 만족하는 경우이다. 이러한 데이터베이스를 유도하기 위한 일련의 규칙은 단계 10 에서 구해진다. 성공적이지 못한 종결은 단계 2 와 단계 4 에서 일어날 수 있는데, 성공적이지 못한 종료가 순환적인 호출에서 발생했을 경우에 프로시쥬어의 제어는 한 단계 높은 (호출한 문장 다음의 위치) 곳으로 역행하게 된다. 단계 2 는 현재의 데이터베이스로부터 성공적인 해결책의 가능성이 없는지를 검사한다. 단계 4 에서는, 프로시쥬어가 모든 가능한 규칙들을 시도해 보았을 때 실패를 내보내게 된다..
프로시쥬어 BACKTRACK 의 수행이 결코 종결되지 않는 경우도 있을 수 있다. 즉 새로운 비종결 (nonterminal) 데이터베이스 (여기서 비종결 데이터베이스란 이 데이터베이스를 변화시킬 수 있는 규칙이 적어도 한 개 이상이 존재할 경우를 말함) 를 무한히 생성하거나, 또는 사이클 (cycle) 을 이루게 되는 경우를 말한다. 그러나 이러한 두 가지 경우는 순환적 호출의 깊이에 대한 한계 (depth bound) 를 설정함으로써 임의적으로 예방할 수 있다. 만일 순환적인 호출이 정해진 한계를 넘도록 호출되는 순간에는 실패를 의미한다. 사이클에 대해서도, 지금까지 유도된 데이터베이스들을 유지하면서 새로이 유도된 데이터베이스가 이미 과거의 한 데이터베이스와 일치하는지에 대한 검사를 통해 예방할 수 있다. 이러한 검사를 수행하는 보다 복잡한 프로시쥬어는 나중에 제시하기로 한다.
단계 3 에서는 데이터베이스에 적용될 규칙들에 대한 순서를 정하게 된다. 이를 위해서는 문제영역에 대한 유용한 정보를 이용하게 된다 (이러한 정보를 휴우리스틱 정보라 하며 4 절과 A*-알고리즘의 휴우리스틱 유도 방법에서 자세히 논함). 휴우리스틱 정보의 이용은 적절한 규칙을 먼저 데이터베이스에 적용함에 의해 이를 이용하지 않는 경우보다 적은 양의 역행제어 (또는 시행착오) 를 수행하게 만든다.
이제까지 프로시쥬어 BACKTRACK 을 가지고서 역행제어의 작동방법을 설명하였다. 그러나 여러 가지 실용적인 관심사들 (예로서 전체 데이터베이스가 다시 반복되는 경우를 피해야 할 필요) 로 인해 위에 소개한 프로시쥬어 BACKTRACK 보다 효율적인 역행방법의 구현을 요하게 된다.
역행을 이용한 제어방법이 간단한 문제에 대해 어떻게 적용되는지 추적해 보는 것은 유익하다 하겠다. 간단한 문제의 예로서 4 × 4 체스 (chess) 판에 퀸 (queen) 4 개가 서로 잡을 수 없도록 하는 배열을 살펴보자. 여기서 전체 데이터베이스는 퀸이 놓여진 위치 표시 (×) 가 된 판의 배열상태를 지니고 있다. 서술식 TERM 에 의해 표현되는 종결조건은 4 개의 퀸이 모두 놓여지고 이들이 서로 잡을 수 없는 위치에 있는 상태를 말한다.
위에서의 문제에 대한 규칙으로 다음과 같은 형식을 고안할 수 있다 :
i, j (1 ≤ i, j ≤ 4) 에 대해,
규칙  가 적용가능하기 위한 전제조건은
i = 1 : 배열에서
하나의 퀸도 놓여 있지 않다.
1 < i ≤ 4 :
배열의 (i - 1) 행에 퀸이 하나 놓여 있다.
전제 조건이 만족될 경우  가 적용된 후의 결과는 배열의 i 행과 j 열이 교차하는 곳에 × 로 표시하여
퀸이 놓여짐을 나타낸다.
그러므로 위의 정의된 규칙에 따르면 첫번째 퀸은 1 행에 놓이고 두번째 퀸은 2 행 등등으로 놓이게 된다.
BACKTRACK 프로시쥬어를
이용하여 4-퀸 문제를 풀기 위해서 먼저 DEADEND 와 적용가능한 규칙들의 순서를
정해야 한다. 여기서 가정하기를 j < k 이면 규칙  가 규칙
 에 앞선 순서가 되어 먼저 적용이 된다고 하자. DEADEND 는 어떤 ㄷ 개의 퀸이
서로 잡을 수 있는 위치에 놓이면 참이 되도록 할 수 있다 (실제적으로 DEADEND 에
대한 이러한 간단한 검사를 해봄으로써 역행하는 제어가 몇 번 일어나는지 계산해보라).
그러나 역행하는 수가
더 적은 보다 효율적인 알고리즘을 위해 더 많은 정보에 의한 규칙순서를 이용할
수 있다. 간단하지만 유용한 규칙적용순서로서 diag (i, j) 라는 함수를 정의한다.
diag (i, j) 란 배열의 (i, j) 위치를 통과할 수 있는 대각선의 길이 중 가장 긴
대각선 값으로 정의된다. 그래서 diag (i, j) < diag (m, n) 이면 규칙  는 규칙
 에 앞선 순서가 된다고 정한다 (같은 크기인 경우 전의 경우와 같은 순서를 따른다).
이러한 순서관계를 사용하면 초기 데이터베이스에 적용해 볼 규칙들에 대한 순서는
 가 된다. 이러한 순서에 의한 4-퀸 문제는 단지 2 번의 역행만 가지고 해결점에
도달하게 된다.
앞에서 언급했듯이 사이클을 피하기 위해서는 좀더 복잡한 알고리즘이 필요하다. 초기 데이터베이스에서 현재의 데이터베이스까지의 경로 상에 있는 모든 데이터베이스에 대해 매 번 이것들이 유도될 때마다 재차 유도된 것인지에 대한 검사가 필요하다.
순환적 프로시쥬어에 이러한 검사작업을 포함시키기 위해서는 일련의 유도된 데이터베이스들의 리스트를 인수로 집어 넣어야 한다. 그러나 실제적으로 인공지능의 역행할 수 있는 생성 시스템의 구현에는 여러 가지 기법을 이용하여 이러한 모든 데이터베이스들을 전체적으로 인수로 하는 것을 피하게 한다.
이제 사이클을 피하는 알고리즘을 BACKTRACK 1 이라 부르자. 인수로는 데이터베이스 리스트를 취한다 (처음에 호출될 때는 초기 데이터베이스가 인수임). 성공적인 종료가 이루어지면 BACKTRACK 1 은 일련의 규칙을 내놓게 되는데, 초기 데이터베이스에 이것을 적용시키면 최후에 종결조건을 만족시키는 데이터베이스가 유도된다. BACKTRACK 1 알고리즘은 다음과 같이 정의된다.
|
프로시쥬어 BACKTRACK 1 (DATALIST) 1. DATA ← FIRST (DATALIST) ; DATALIST 란 현재에서 초기상태로의 경로에 있는 모든 데이터베이스들의 리스트이며, DATA 란 이 중에서 가장 최근에 산출된 데이터베이스 (즉 현재 수행에서의 데이터베이스) 이다. 2. if MEMBER (DATA, TAIL (DATALIST)), return FAIL ; 현 데이터베이스가 이전에 산출된 데이터베이스 중의 하나와 중복되면 프로시쥬어는 FAIL 을 내보낸다. 3. if TERM (DATA), return NIL 4. if DEADEND (DATA), return FAIL 5. if LENGTH (DATALIST) > BOUND, return FAIL ; 적용된 규칙수의 양이 지정된 한계를 넘어서면 프로시쥬어는 FAIL 을 내보낸다. 6. RULES ← APPRULES (DATA) 7. LOOP : if NULL (RULES), return FAIL 8. R ← FIRST (RULES) 9. RULES ← TAIL (RULES) 10. RDATA ← R (DATA) ; 규칙 R 이 적용되어 새로운 데이터베이스를 유도한다. 11. RDATALIST ← CONS (RDATA, DATALIST) ; 새로운 데이터베이스를 여태까지 저장해온 데이터베이스 집합에 첨가시킨다. 12. PATH ← BACKTRACK 1 (RDATALIST) 13. if PATH = FAIL, go to LOOP 14. return CONS (R, PATH) |
제 3 장에서, 역행을 할 수 있는 8-퍼즐 예는 BOUND = 7 을 사용했으며, 타일이 판에 놓여진 배열형태가 전에 방문된 적이 있는지를 검사하였다. 순환적 알고리즘에서 전에 방문했던 모든 데이터베이스들을 기억할 필요는 없다. 즉 실패에 도달한 경로들에서의 유도된 모든 데이터베이스들은 기억할 필요가 없으며, 단지 초기상태에서 현재까지 이르는 경로 상에서의 모든 데이터베이스들만 기억하면 된다.
앞에서 논한 역행방법은, 현 단계에서 실패했을 경우 바로 전의 단계 (한 단계 앞을 말함) 로 제어가 옮겨진다. 다시 말해서, 만약 BACKTRACK 의 n 번째 단계의 순환적 호출이 실패하면 제어는 n - 1 번째 단계로 돌아가서 또다른 규칙을 적용시켜 보고자 하게 된다. 그러나 n 번째 단계에서의 실패에 대한 근본적인 이유 (또는 책임) 는 바로 앞 단계인 n - 1 번째 단계에서의 잘못된 규칙 선택에 있기 보다는 몇 단계 더 앞에 있는 단계에서의 잘못된 규칙 선택에 있을 경우가 많다. 이러한 경우에, 앞서 말한 바와 같이 n - 1 번째 단계에서 다시 다른 규칙을 선택하여 적용해보고자 하는 것은 무익하다 하겠다. 따라서 이 때에는 한 번 역행할 경우에 여러 단계를 올라가서 다시 규칙을 선택해서 적용해보는 것이 바람직하다 하겠다.
역행방법에서는, 실패에 이른 경로들에 대해서는 잊어 버리고 단지 현재 확장되고 있는 경로만이 확실히 기억되었다. 그러나 더욱 융통성을 지닌 제어방법은 확장 가능한 모든 경로들을 기억하여 어떠한 시행경로도 다음에 확장될 수 있도록 하는 것이다.
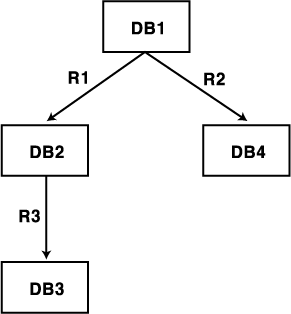
그림 2 데이터베이스들의 트리
예를 들어, 그림 2 에서 초기 데이터베이스 DB1 에는 규칙 R1 과 R2 를 적용할 수 있다. 제어 시스템이 먼저 규칙 R1 을 선택해 DB1 에 적용하여 새로운 데이터베이스 DB2 를 유도하고 이어서 다시 DB2 에 규칙 R3 가 적용되어 DB3 가 유도되었다 하자. 그리고 이 순간에 제어 시스템은 DB1 에서 DB3 까지 이른 경로가 적절하지 않다고 판단하여 앞으로 되돌아와서 규칙 R2 를 DB1 에 적용하여 데이터베이스 DB4 를 유도했다고 가정한다. 물론 이 순간에 역행제어방법을 사용한 경우에는 DB2 와 DB3 의 내용이 삭제된다. 그러나 만약 제어 시스템이 DB2 와 DB 3 의 내용을 유지했다면, 나중에 DB4 에 이른 경로가 무익하다고 판정이 나 버린 경우 다시 DB2 나 DB3 으로부터 탐색작업을 계속할 수 있을 것이다. 이러한 융통성을 가지기 위해서 제어 시스템은 규칙 적용에 의해 유도되어진 데이터베이스들을 나타내는 그래프를 기억하여야 한다. 이러한 방식으로 제어 시스템이 수행될 때 그래프 탐색 (graph-search) 방법을 사용한다고 말한다.
그래프 탐색방법에서, 규칙 적용에 의해 유도되는 데이터베이스는 그래프나 트리에서 노드 (node) 로 표현된다. 그러나 이 데이터베이스들은 일반적으로 매우 큰 구조이므로 이들 각각을 명확히 저장한다는 것은 실제적으로 많은 기억공간을 요구하게 된다. 그러므로 초기 데이터베이스에서 시작하여 일련의 규칙들이 적용되어 그때마다 유도되는 데이터베이스들의 내용을 모두 저장하지 않고 규칙이 적용되는 전후 데이터베이스에서의 변경된 내용만을 저장한다면 기억공간을 줄일 수 있으며, 더우기 어떤 특정 데이터베이스의 내용을 모두 알고자 할 경우 초기 데이터베이스에서 시작하여 이 데이터베이스까지 이르는 동안에 변경되어온 내용만을 계산함에 의해 쉽게 구할 수 있다.
그래프 탐색 제어방법이란 그래프에서 초기 데이터베이스를 나타내는 한 노드로부터 생성 시스템의 종결조건을 만족시키는 데이터베이스를 나타내는 노드에 이르는 경로를 구하는 방법이라 생각할 수 있다. 그러므로 그래프 탐색 알고리즘은 아주 흥미로운 것이라 하겠다. 이러한 알고리즘을 기술하기 전에 먼저 그래프 이론의 용어에 대해 살펴 보자.
그래프는 일련의 노드로
이루어진다 (노드의 수가 유한할 필요는 없다). 노드들의 어떤 쌍 (pair) 들은 아크
(arc) 들로 연결되어 지는데, 이 아크는 한 노드에서 쌍의 다른 노드를 가리키게
된다. 이러한 그래프를 방향성을 지닌 그래프 (directed graph) 라 한다. 여기서
다루는 그래프에서는, 노드는 데이터베이스로 지칭되며 아크는 규칙으로 지칭된다.
만약 한 아크가 노드  에서 노드
 를 가리킬 때, 노드
 를 노드
 의 후계 (successor) 노드라 하며, 노드
 를 노드
 의 부모 (parent) 노드라 한다. 본 시스템에서 한 노드는 단지 유한 개의 후계
노드를 가질 수 있다 (생성 시스템은 단지 유한 개의 적용가능한 규칙을 가짐). 한
쌍의 노드에서 두 노드가 서로 상대방에 대한 후계 노드일 수도 있는데, 이러한 경우에
쌍의 한쪽의 방향성을 지닌 아크는 양쪽의 방향을 가지는 아크로 된다. 이러한 아크를
에지 (edge) 라 한다.
그래프에서 각 노드가 하나의 부모 노드만을 갖는 특별한 경우를 트리 (tree) 라 한다. 트리에서 부모 노드를 가지고 있지 않는 노드를 루트 노드 (root node) 라 하며 후계 노드를 가지지 않는 노드를 끝단 노드 (tip node) 라 한다. 로트 노드의 깊이는 0 으로 정하고, 다른 노드의 깊이는 이 노드의 부모 노드 깊이에 1 을 더한 것으로 정한다.
노드들의 연속된 나열
( ) (여기서, j = 1, ..., k 에 대해 각
 은
 의 부모 노드이며, 각
 는
 의 후계 노드임) 을 노드
 에서 노드
 까지의 길이 k 인 경로 (path) 라 한다. 노드
 에서 노드
 에 어떤 경로가 존재할 때 노드
 는 노드
 로부터 접근가능하다 (accessible) 고 한다. 이러한 경우에 노드
 를 노드
 의 자손 (descendant) 노드라 하고 노드
 를 노드
 의 조상 (ancestor) 노드라 한다. 어떤 데이터베이스에서 다른 어떤 데이터베이스로의
전환을 위하여 연속되게 적용될 일련의 규칙을 찾는 문제는 그래프에서 경로를 찾는
문제와 동일하다고 하겠다.
해당 규칙의 적용에
필요한 비용을 나타내기 위해 아크에 비용을 배정하는 것이 편리한 경우가 있다.
노드  에서 노드
 로 이어진 아크에 대한 비용은
 로 표시한다. 나중에 언급하겠지만 이러한 비용들은 어떤 임의의 적은 양수 e
보다 크다고 가정하게 된다. 두 개 노드 간의 경로에 대한 비용이란 그 경로 상의
노드들을 연결하는 모든 아크들에 대한 비용들의 합이 된다. 어떤 문제에서는, 두
개 노드간의 가능한 경로들 중에서 최소비용을 지닌 경로를 찾고자 한다.
가장 간단한 유형의
문제로는 초기 데이터베이스를 나타내는 노드 s 와 다른 주어진 데이터베이스를 나타내는
노드 t 간의 경로 (아마도 최소비용경로) 를 구한다. 좀더 보편화된 문제 상황은
노드 s 에서 종결조건을 만족시키는 데이터베이스들을 나타내는 노드들의 집합  중에서 어느 한 노드와의 경로를 찾는 것이다. 이 경우에 집합
 를 목표집합 (goal set),
 내의 각 노드 t 를 목표 노드 (goal node) 라 한다.
그래프는 명백하게 나타낼 수도 있고 암시적으로 나타낼 수도 있다. 명백한 표현을 사용하는 경우에는, 노드들과 아크들 (연관되는 각 비용과 함께) 은 표의 형태로 명확히 주어진다. 이 표에는 그래프에 나타나는 모든 노드들과 이들의 후계 노드를 그리고 연관되어지는 아크들의 비용 등을 포함하게 된다. 그러나 방대한 크기의 그래프에서나 무한 개의 노드를 가지는 그래프에서의 이러한 표현방식은 실제적으로 불가능하다 하겠다.
여기서 응용하는 제어방법이란 암시적으로 표현된 전체 그래프에서 한 부분만을 명확히 유도하는 것이라 하겠다. 그래프의 암시적 표현이란 초기 데이터베이스를 나타내는 시작 노드 s 와 데이터베이스들을 변환시키는 규칙들로 주어진 것을 말한다. 여기서 후계 노드 연산자 (successor operator) 에 대한 개념을 소개한다. 후계 노드 연산자란 이것이 한 노드에 적용이 되면 그 노드로부터 생성되는 후계 노드 (연관된 아크 비용과 함께) 를 묘사한다. 어떤 노드에서 이러한 후계 노드 연산자를 적용하는 과정을 노드의 확장 (expanding) 이라 한다. 시작 노드 s 와 후계 노드 연산자로 정의되는 암시적인 그래프 표현은 시작 노드 s 에서 시작하여 계속적인 노드 확장을 행하면 결국에는 명확히 나타나는 그래프가 된다. 그러므로 그래프 탐색 제어방법이란 암시적인 그래프에서 목표 노드를 포함하는 한 부분을 노드 확장과정에 의해 명확히 나타내는 방법이라 하겠다.
암시적으로 정의된 그래프의 한 부분을 명확히 유도하는 과정은 다음과 같이 정의될 수 있다.
|
프로시쥬어 GRAPH SEARCH 1.
시작 노드 s 만을 지닌 그래프 G 를 생성한다. 2. CLOSED 라는 리스트를 생성하고 공백으로 초기화한다. 3. LOOP : OPEN 이 공백이면 실패로써 빠져나간다. 4. OPEN 에서 첫번째 노드를 선택하여, 이 노드를 OPEN 에서 제거하고 CLOSED 에 삽입한다 (이 선택된 노드를 n 이라 표기하겠음). 5. 만일 n 이 목표 노드이면, 그래프 G 내의 노드 n 에서 시작 노드 s 까지 포인터를 따라 경로를 추적하여 얻는 경로가 문제의 해결경로로 되면서 함께 성공적으로 빠져 나간다 (포인터는 단계 7 에서 설정됨). 6. 노드 n 을 확장시켜, n 의 조상이 아닌 후계 노드들의 집합 M 을 생성한다. 그래프 G 내에서 M 의 구성원들은 노드 n 의 후계노드들로 배치된다. 7. M 의 구성원들 중 현재 그래프 G 에 나타나지 않은 (즉 OPEN 이나 CLOSED 의 어느 쪽에도 속하지 않은) 구성원들은 각기 이들로부터 노드 n 으로 포인터가 설정된다. 그리고 이러한 구성원들은 OPEN 에 삽입된다. 그러나 M 의 구성원들 중 OPEN 이나 CLOSED 에 이미 속해진 구성원들 각각은 이것으로부터 노드 n 으로의 포인터 방향을 재조정해야 할지의 여부를 결정해야 한다 (이 결정방법은 나중에 설명됨). 더우기 M 의 구성원으로서 CLOSDE 에 이미 속해진 구성원에 대해서는 G 에 나타난 이것의 자손 노드들에 대해서도 포인터의 방향을 재조정해야 한다 (이 결정방법은 나중에 설명됨). 8. 리스트 OPEN 을 무작위거나 휴우리스틱 (정보를 이용한) 에 의해 순서를 재조정한다. 9. LOOP 로 간다. |
이 프로시쥬어는 매우 일반적이어서 여러 다양한 그래프 탐색 알고리즘들을 포함하고 있다. 이 프로시쥬어에 의하면 탐색 그래프라 부르는 G 와 이것의 한 부분인 T (탐색 트리라 부름) 를 유도하게 된다. G 에 있는 모든 노드는 또한 T 에 있으며 탐색트리 T 는 단계 7 의 포인터 설정에 따라 결정된다. G 에서 노드 s 를 제외한 모든 노드는 각자 부모 노드로의 포인터를 가지게 되는데, 이것이 T 에서는 단일의 부모노드를 정의하게 된다. G 에서의 어떤 노드도 이것의 조상들 중의 하나와 동일하도록 하지 않으므로 (단계 6 에서) 탐색 그래프는 부분적 순서 (partial ordering) 를 형성한다. 알고리즘에 의해 발견된 경로들은 G 에서 명시되어지며 어떤 노드에 이르는 유일한 경로는 T 에서 정의되어진다. 탐색과정에서 OPEN 에 들어 있는 노드는 탐색 트리에서 끝단 노드가 되고 CLOSED 에 들어 있는 노드는 끝단 노드가 아닌 노드이다. 좀더 구체적으로 말하면, OPEN 에 있는 노드들은 확장을 하기 위해 아직 선택이 안된 노드들을 말하고, CLOSED 에 들어있는 노드들은 확장을 이미 해 버려서 탐색 트리에서 끝단 노드가 아닌 노드들이거나, 현재 확장하기 위해 선택된 끝단 노드를 말한다.
단계 8 에서 OPEN 에 있는 노드들에 순서가 정해져 가장 유망한 (목표 노드에 이르기가 가장 빠르다고 추측되는) 노드가 단계 4 에서 선택되어 확장되도록 한다. 이와같이 순서를 정하는 근거는 여러 종류의 휴우리스틱 (나중에 설명됨) 들이나 다른 기준에 의해 주어진다. 확장하기 위해 선택된 노드가 목표 노드이면 탐색과정은 성공적으로 종결되며, 시작 노드에서 목표 노드까지의 경로는 목표 노드에서 포인터를 따라 거슬러 올라가서 최종적으로 시작 노드에 이르는 일련의 포인터들로 이루어진다. 그러나 만약에 확장하기 위해 선택할 끝단 노드가 하나도 없을 경우 (후계 노드를 생성할 수 없는 끝단 노드도 결국에는 OPEN 에서 제외된다), 탐색과정은 실패로 끝나게 된다. 이와 같이 실패로 탐색과정이 끝나는 경우에는 시작 노드에서부터 시작하여 목표 노드 (들) 에 접근이 불가능하게 된다.
단계 7 에 대해 추가적인 설명이 필요하다. 만일 탐색되고 있는 암시적 그래프가 트리의 형태라면, 단계 6 에서 생성된 어떠한 후계 노드도 과거에 이미 생성된 노드는 아니다 (즉, 새로운 노드들이다). 트리에서 루트를 제외한 모든 노드들은 각각 어느 한 노드의 후계 노드이므로 각각의 유일한 부모 노드의 확장에 의해 생성되게 된다. 그러므로 단계 6 과 7 에서의 M 의 구성원들은 OPEN 이나 CLOSED 의 어느 쪽에도 이미 속해 있지는 않다. 이 경우에 M 의 각 구성원들은 OPEN 에 삽입되고 탐색 트리에서 노드 n 의 후계 노드로 배치된다. 탐색 그래프는 알고리즘이 수행되는 동안 탐색 트리가 되며 T 에 있는 노드들에 대한 부모 노드를 변경시킬 필요는 없게 된다.
그러나 만일 암시적 그래프가 트리 형태가 아니라고 해보자. 이 경우에는 M 의 구성원들 중에는 과거에 이미 생성되어 OPEN 이나 CLOSED 에 속해 있는 노드와 동일한 것들이 있게 된다. 그러나 새로이 생성된 데이터베이스가 과거에 생성된 데이터베이스와 동일한 것인지를 검사해보는 것은 상당한 계산비용을 필요로 한다. 그러므로 어떤 탐색과정에서는 이러한 검사를 하는 대신에 탐색 트리에 동일한 여러 데이터베이스를 그대로 유지시키게 된다. 물론 이와 같은 노드 중복은 이것들의 모든 자손 노드들도 중복을 이루게 만든다. 그러므로 다음과 같은 두 가지 요소를 고려해보아야 한다 : 데이터베이스들을 비교해서 검사하는 계산비용과 보다 큰 탐색 트리 (동일한 데이터베이스에 의한 많은 중복된 노드들을 지닌) 를 생성하는 계산비용 프로시쥬어 GRAPHSEARCH 의 단계 6, 7 에서는 노드의 동일성을 검사해보는 것이 더 나은 것으로 가정한다.
탐색과정에서 과거에 생성된 노드와 동일한 노드가 생성되면, 탐색 트리에서 이미 유지되어온 경로와는 다른 새로운 경로를 구하게 된다. 우리가 바라는 것은 탐색 트리에서 각 노드들이 s 로부터 이 노드에 이르는 최소비용의 경로를 유지하고자 하는 것이다 (탐색 트리에서 s 으로부터 노드 n 까지의 경로비용이란 n 으로부터 s 까지 포인터를 따라 거슬러 올라가면서 나타나는 아크 비용들을 합계함으로써 구해진다. 아크에 비용이 주어지지 않는 문제에 대해서는 모든 아크가 일정한 단위 비용을 가진다고 가정한다). 만약에 새로이 구해진 경로가 과거의 경로보다 더 적은 비용을 갖는다면 재생성된 이 노드에서의 포인터를 최근의 부모 노드로 변경시켜 탐색 트리를 조정한다.
만일 CLOSED 에 있는 한 노드 n 이 탐색 트리 T (탐색그래프 G 와 T 의 구별은, G 는 단계 6 에서 확정되어가며 T 는 단계 7 에서 포인터를 조정하면서 확장되어 감) 에서 이 노드의 포인터가 변경되어지면 s 로부터 n 까지의 더 작은 비용의 경로가 생겨남을 말한다. 이러한 변화는 탐색 그래프 G 에서 n 의 후계 노드들 가운데 포인터를 재조정할 필요성을 지닌 후계 노드를 가지게 할지도 모른다. G 가 유한 개의 노드를 가진다고 가정했고 이 노드들 사이에는 부분적인 순서 (partial ordering) 가 있기 때문에 n 의 후계 노드들 각각에 대해 이에 이르는 더 적은 비용의 경로를 구하는 작업은 간단하며 유한하다.
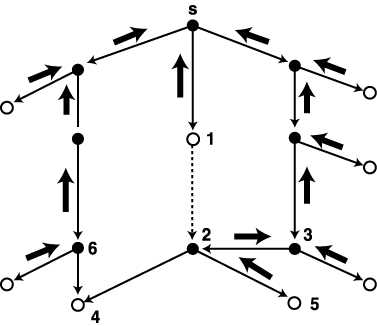
그림 3 노드 1 이 확장되기 전의 탐색 그래프와 탐색 트리
앞에서 설명한 트리 조정이 이루어지는 방법에 대한 간단한 예를 들어 본다. 탐색 과정에 의해 탐색 그래프와 탐색 트리가 그림 3 과 같은 상태로 주어져 있다 하자. 이 탐색 그래프에서 어떤 아크에 붙여진 굵은 화살표는 탐색 트리에서 부모 노드를 가리키는 포인터를 의미한다. 여기서 까맣게 칠해진 노드는 CLOSED 에 있는 노드이며 다른 노드는 OPEN 에 놓여 있다. 이 순간에 알고리즘은 노드 1 을 확장하려고 한다 (아크 비용은 단위비용으로 가정함). 노드 1 이 확장될 대 이것의 유일한 후계 노드 2 는 이미 탐색 트리에 존재해 있는 노드로써 CLOSED 에 속해 있다. 더우기 노드 2 는 노드 4 와 노드 5 를 후계 노드로 가지고 있으며 노드 4 의 포인터는 노드 6 을 가리키고 있다 (즉 s 에서 노드 4 까지의 최소비용경로는 노드 6 을 경유함을 뜻한다). 그러나 이제 알고리즘이 노드 1 을 경유해 노드 2 에 이르는 경로비용이 노드 3 을 경유해 노드 2 에 이르는 경로비용보다 적다는 것을 발견했음으로 탐색 트리에서 노드 2 의 부모 노드는 노드 3 이 아닌 노드 1 로 변경되게 된다 (포인터의 변경에 의해). 이렇게 되면 탐색 그래프에서 노드 2 의 후계 노드들에 대해서도 s 로부터 이들에 각각 이르는 경로를 재조정하게 된다. 즉 노드 4 의 부모 노드는 노드 2 로 변경되어 경로가 s → 1 → 2 → 4 로 되며, s 에서 노드 5 까지의 경로는 s → 1 → 2 → 5 가 된다. 이와 같이 조정된 탐색 트리는 그림 4 와 같이 된다.
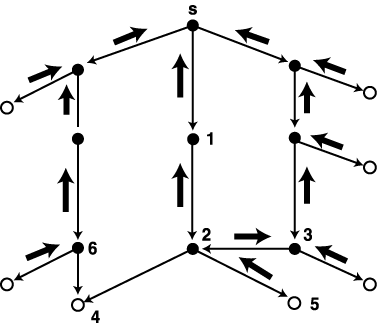
그림 4 노드 1 을 확장한 후의 탐색 그래프와 탐색 트리
이제까지 기술한 GRAPHSEARCH 알고리즘에서는 한 노드가 선택되어 후계 노드를 생성시킬 때는 한꺼번에 모두를 생성시키는 것으로 가정하였다 (확장이란 용어를 사용했음). 그러나 알고리즘을 수정하여 한 노드가 선택되어 단번에 모든 후계 노드들을 생성하지 않고 한 개씩 필요할 때마다 생성하도록 할 수 있다 (예로서, Michie and Ross (1970) 을 참고하기 바람). 이렇게 수정된 알고리즘에서는 선택된 노드의 모든 후계 노드들이 생성되어질 때까지 이 노드는 CLOSED 에 삽입되지 않는다. 데이터베이스에 규칙을 적용해 새로운 데이터베이스를 유도하는 과정은 일반적으로 많은 계산비용이 들기 때문에 수정된 알고리즘은 기술하기에 다소 어려움을 지니고 있으나 바람직하다 하겠다. 그래프 탐색방법의 몇 가지 일반적인 성질을 설명하는데 편리를 기하기 위해 여기서는 모든 후계 노드들이 한꺼번에 생성되도록 하는 알고리즘을 계속 사용하기로 한다.
문제영역으로부터의 어떠한 휴우리스틱 정보도 이용하지 않고 OPEN 에 있는 노드들에 대해 순서를 정하고자 할 때는 어떤 임의적인 방법이 사용되어야 하는데, 이러한 탐색과정을 정보를 제공받지 않은 (uninformed) 탐색과정이라 한다. 인공지능에서 정보를 제공받지 않은 탐색은 그렇게 중요한 관심사가 아닐지라도 나중에 설명될 탐색방법과의 비교를 위해서 여기서는 두 가지 종류 즉, 깊이-우선 탐색 (depth-first search) 과 나비-우선 탐색 (breadth-first search) 을 기술하기로 한다.
정보를 지니지 않는 그래프 탐색방법의 한 종류로 탐색 트리에서 OPEN 에 있는 노드들의 순서를 정할 때 노드의 깊이에 따라 정할 수 있다. 가장 깊은 노드는 리스트의 제일 앞에 놓이며, 같은 깊이의 노드들에 대해서는 무작위 순서가 된다. 이러한 순서를 가지고 탐색과정이 이루어지는 것을 깊이-우선 탐색과정이라 한다. 즉 탐색 트리에서 가장 깊은 끝단 노드가 확장을 위해 선택됨을 의미한다. 그러나 쓸데없이 계속해서 한 방향으로의 깊이에 대해 무익한 탐색을 피하기 위해 깊이 한계를 설정하게 된다.
깊이-우선 그래프 탐색방법에 의한 새로운 데이터베이스 생성과정은 정보를 제공받지 않는 역행제어방법 (2 절에서 논의됨) 의 그것과 유사하다. 만일 그래프 탐색에서 후계 노드가 동시에 생성되지 않고 필요에 따라 하나씩 생성되도록 수정할 경우에서의 깊이-우선 그래프 탐색은 역행제어방법과 동일한 방법이 된다. 그러나 깊이-우선 그래프 탐색보다 역행제어방법은 구현하기가 더 간단하여 작은 기억공간을 필요로 한다 (왜냐하면 역행방법은 목표 노드에 이를 수 있는 하나의 경로만 수행 과정에서 계속 유지하고 있어 깊이-우선 방법처럼 탐색의 전 노드들에 대한 기록을 유지하지 않기 때문이다).
그림 5 는 8-퍼즐 문제에서 깊이-우선 탐색방법에 의해 유도된 탐색 트리를 나타내고 있다. 각 노드는 자신에 해당되는 데이터베이스로 명명되어 있으며, 확장을 위해 선택되어온 순서가 노드마다 매겨져 있다. 깊이 한계는 5 라고 가정하며 굵은 선으로 표시된 경로는 해결경로를 나타내고 있다. 그림에서 알 수 있듯이 깊이 한계에 도달하지 않는 한 깊이-우선 탐색과정이 진행되며, 깊이 한계를 넘는 순간 제어는 그 다음으로 깊은 노드에 대해 수행이 된다.
정보를 지니지 않는 그래프 탐색의 또 다른 종류로는 탐색 트리에서 OPEN 에 있는 노드들의 순서를 깊이가 낮은 노드가 우선 되도록 하는 방법이 있다. 이러한 순서에 의한 탐색을 나비-우선 탐색이라 한다. 그림 6 은 8-퍼즐 문제에서 나비-우선 탐색 방법에 의해 유도된 탐색 트리를 나타내고 있다. 각 노드 옆의 숫자는 확장을 위해 선택되어온 순서를 표시하고 있다.
나중에 보이겠지만, 만일 시작 노드에서 목표 노드에 이르는 경로가 존재한다면 나비-우선 탐색은 가장 적은 비용을 가지는 (또는 짧은 길이의) 경로를 반드시 구하게 된다 (만약 경로가 존재하지 않는다면, 이 방법은 유한 개 노드를 지니는 그래프에서는 실패로 빠져 나오게 되며 무한 개 노드를 지니는 그래프에서는 결코 종료되지 않는다).
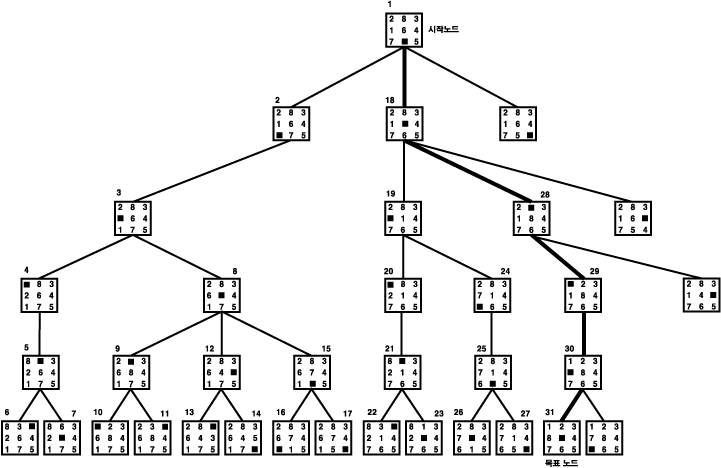
그림 5 깊이-우선 탐색으로 유도된 탐색 트리
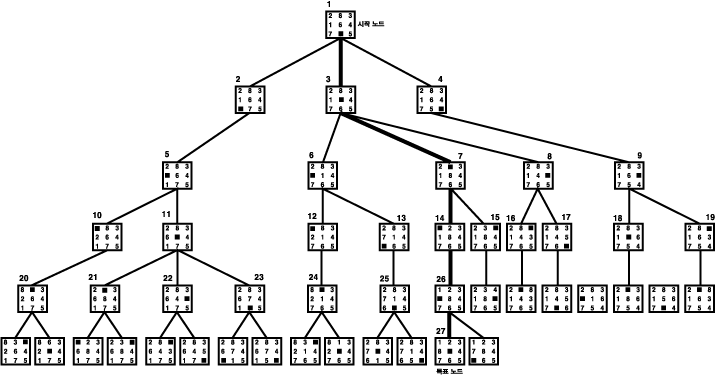
그림 6 나비-우선 탐색으로 유도된 탐색 트리
목표 노드에 이르는 경로를 구하기 위해 유용한 정보를 이용하지 않는 탐색방법 (나비-우선 또는 깊이-우선이든 관계없이) 을 적용하는 것은 소모적이라 하겠다. 이 방법은 원칙적으로는 문제에 대한 해결책을 제시하기는 하지만 경로가 발견될 때까지 너무 많은 노드가 확장되는 경우가 대부분이므로 인공지능 생성 시스템의 제어 방법으로는 이용되기 어렵다 하겠다. 탐색을 위해 소비되는 계산시간과 기억공간의 양에는 실제적으로 제한이 되어있으므로 정보를 제공받지 않은 탐색방법보다 더 효율적인 탐색방법이 필요하게 도니다.
어떤 작업에 있어서 그 작업에 연관된 정보를 이용하면 탐색과정을 줄이는 데 도움을 줄 수도 있다. 이러한 정보를 휴우리스틱 (heuristic) 정보라 하며, 이를 이용하는 탐색방법을 휴우리스틱 탐색방법이라 한다. 어떤 휴우리스틱의 이용은 목표 노드에 이르는 최소비용의 해결경로를 발견한다는 보장하에서 탐색 노력을 줄이는데 도움을 주게 되고, 또 어떤 휴우리스틱의 이용은 탐색 노력을 줄이는 데는 도움을 주지만 최소비용의 해결경로 (만일 그러한 경로가 존재한다면) 를 반드시 발견한다고 보장하지는 못한다. 대부분의 실제적인 문제에 있어서는 해결경로비용과 이 경로를 구하기 위해 요구되는 탐색 노력을 동시에 고려한 전체적 비용을 최소화하는데 관심이 있다. 그러므로 이와 같은 전체비용의 최소화를 유도할 가능성을 지닌 탐색방법들에 관심이 주어진다 하겠다. 만일 탐색방법 1 의 전체비용이 탐색방법 2 의 그것보다 적다면 탐색방법 1 이 탐색방법 2 보다 더 휴우리스틱 능력을 지녔다고 말한다. 그러나 경로비용과 탐색에 소요된 비용에 어떠한 방식으로 각각에 비중을 두어 전체비용을 산출할 것인지를 결정하는 것이 어려우며, 또한 휴우리스틱은 문제의 성질과 관계되기 때문에 실제적으로 고려 대상이 되는 문제 종류들에 대한 확률적 분포를 설정하기가 어렵다. 그러므로 우리가 측정하고자 하는 결합된 전체비용 (경로 비용과 탐색에 소요된 비용) 을 정확히 계산하기가 어렵다 하겠다. 한 탐색 방법이 다른 탐색방법보다 휴우리스틱 능력을 더 지녔다하는 기준은 실제적인 과거의 경험에서 얻어진 직관적인 지식에 준한다.
탐색과정에서 가장 유망하다 (이 용어는 문제 해결에 가장 접근해 있다고 추측되는 상황하에 쓰임) 고 짐작된 끝단 노드를 선택하기 위해 GRAPHSEARCH 의 단계 8 에서 OPEN 에 있는 노드들에 순서를 정하기 위해 휴우리스틱 정보가 이용된다. 이를 위해서는 우선 노드 유망성을 평가하는 측정값을 계산해야 한다. 한 가지 중요한 계산 방법은 평가하고자 하는 노드에 대해 그의 유망성을 수치로 표현할 수 있게끔 하는 평가함수 (evaluation function) 를 사용하는 것이다. 평가함수는 여러 가지 개념에 의존하여 설정된다 : 현재 노드가 가장 좋은 해결경로 상에 놓여 있을 확률에 의하거나, 현재 노드와 목표 노드 사이의 거리에 의하거나 또는 8-퍼즐과 같이 판 (board) 에서 하는 놀이에서 현재 판의 상황이 목표상태에서의 판의 상황과 얼마나 유사한가를 나타내는 정도를 평가하는 수치를 설정함에 의한다.
평가함수를 심볼 f 로 표기한다 가정할 때, f(n) 은 노드 n 에 대한 평가함수값이 된다. 우선 f 를 임의의 함수로 생각하자 (나중에 이것은 시작 노드에서 노드 n 을 거쳐 목표 노드에 이르는 최소비용경로에 대한 측정값으로 제시된다).
이제 GRAPHSEARCH 의 단계 8 에서 OPEN 에 있는 노드들에 순서를 정하는 데 함수 f 가 이용된다. 관습적으로 OPEN 에 있는 노드들은 이들의 f 값에 따라 크기가 증가하는 순으로 배열된다. 그리고 같은 크기를 가진 노드들 사이에튼 임의적으로 순서가 배열되지만 항상 목표 노드를 의식하여야 한다. 짐작하기를, 낮은 평가값을 가지는 노드는 아마도 최적경로 (최소비용의 경로) 상에 있을 가능성이 높다 하겠다.
GRAPHSEARCH 에서 평가함수를 사용하는 하나의 예로 8-퍼즐 문제를 생각해보자. 먼저 평가함수를 다음과 같이 간단히 정의한다 :
f(n) = d(n) + W(n)
여기서 d(n) 은 탐색 트리에서 노드 n 의 깊이를 나타내며 W(n) 은 노드 n 의 데이터베이스에서 잘못 놓여진 숫자 (목표 노드에서의 판의 숫자 배열과 비교했을 때) 의 갯수를 나타낸다. 에를 들어, 그림 7 에서 보여지는 목표노드에 대해 시작 노드의 배열이 아래와 같으면 f 값은 0 + 4 = 4 가 된다.
|
2 |
8 |
3 |
|
1 |
6 |
4 |
|
7 |
|
5 |
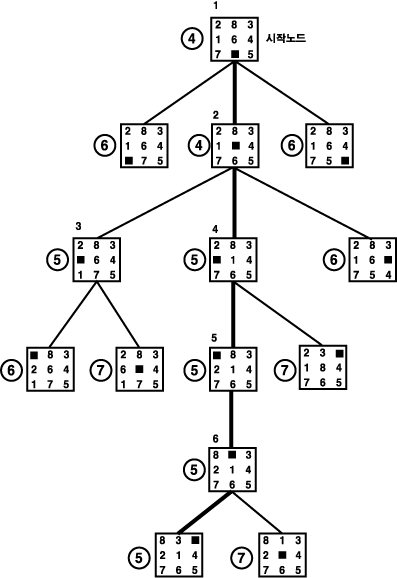
그림 7 평가함수를 사용한 탐색 트리
이 함수를 사용하여 GRAPHSEARCH 를 8-퍼즐에 적용한 결과는 그림 7 에 요약되어 있다. 각 노드의 f 값은 원으로 그려져 있으며 원으로 그려져 있지 않는 숫자는 탐색과정에서 노드가 확장되어온 순서를 나타낸다. 비록 이러한 평가함수의 사용으로 해서 해결경로를 구할 때까지 탐색과정에서 확장되어온 노드의 수를 많이 줄일지라도 이 평가함수를 사용하지 않은 다른 탐색방법에 의해서도 똑같은 해결경로를 구할 수 있다 (평가함수를 f(n) = d(n) 으로 하면 나비-우선 탐색과정이 된다).
평가함수의 선택은 탐색 결과에 결정적으로 영향을 미친다. 일부 노드에 대한 유망성을 정확히 평가 못하는 평가함수의 사용은 최소비용경로가 아닌 경로를 유도할 수도 있으며, 또한 모든 노드에 대한 유망성을 언제나 과대평가해 버리는 평가함수의 사용은 (예로서 나비-우선 탐색 형태처럼 되도록 하는 평가함수의 사용) 은 너무 많은 노드를 확장하게 한다. 이제부터 어떤 특정 평가함수를 사용했을 때 GRAPHSEARCH 의 성능에 대한 이론적 결과를 전개하기로 한다.
먼저 평가함수 f 를 다음과 같이 정의한다 : 노드 n 에서의 평가값 f(n) 이란, 시작 노드 s 에서 노드 n 까지의 최소비용경로의 경로비용과 노드 n 에서 목표 노드까지의 최소비용경로의 경로비용을 더한 값의 측정값이다. 즉, f(n) 이란 노드 n 을 경유하는 최소비용의 해결경로 비용에 대한 측정값이다. 그러므로 OPEN 에서 가장 적은 f 값을 지닌 노드를 선택하여 확장하고자 하는 것이 바람직하게 된다.
앞에서 정의한 평가함수의
성질을 제시하기 전에 먼저 몇 가지 유용한 표기법을 소개한다. 함수  는 임의의 두 노드
 와
 사이의 최소비용경로의 실제 비용을 나타낸다 (함수 k 는 경로가 존재하지 않는
노드들에 대해서는 정의되지 않는다). 노드 n 에서 특정 목표 노드
 까지의 최소비용경로에 대한 비용은
 로 나타난다.
 이란 목표 노드들로 이루어진 전체집합
 상의 모든
 중에서 최소값을 나타내는 표현이다. 따라서
 은 n 으로부터 목표 노드에 이르는 최소비용경로의 값이며, 노드 n 에서
목표 노드까지
 의 비용을 지닌 경로를 구하면 바로 이 경로가 최적경로이다 (함수
 는 목표 노드에 이르는 경로를 가지지 않는 노드 n 에 대해서는 정의되지
않는다).
시작 노드 s 에서 임의의
한 노드 n 까지의 최적경로에 대한 비용은 k(s, n) 으로 주어지게 되는데 표기상
간편하게 이를  으로 나타낸다. 즉 s 로부터 접근가능한 모든 노드 n 에 대하여
 이 된다.
이제 또 다른 새로운
함수  를 다음과 같이 정의한다 : 노드 n 에서
 이란 시작 노드 s 에서 노드 n 까지의 최적경로의 실제 비용과 노드 n 에서
목표 노드까지의 최적경로의 비용을 합한 값으로 정의된다. 즉
 은

따라서  값은 시작 노드 s 에서 노드 n 을 경유하여 목표 노드에 이르는 최적 경로에
대한 비용이 된다 (만일 n = s 일 경우
 가 되어 노드 s 에서의
 의 의미는 s 에서 목표까지의 제한이 없는 최적경로의 실제 비용이 된다).
이제 앞에서 정한 평가함수
f 는  의 측정치가 되며 다음과 같은 식에 의해 표현될 수 있다 :
f(n) = g(n) + h(n)
여기서 g 는  의 측정값이며 h 는
 의 측정값이다. g(n) 를 설정하는 아주 명백한 방식은 현재 탐색과정에서
나타난 탐색 트리에서 노드 n 에서부터 시작 노드 s 로 포인터를 따라 거슬러 올라가면서
나타나는 아크 비용을 모두 합계하면 된다 (이 경로는 탐색 알고리즘에 의해 여태까지의
수행과정 동안 유도된 경로 중에서 최적의 경로이다. 만일 단계 7 의 수행에서 탐색
트리가 다시 조정되면 g(n) 값에도 변화가 생겨 더 적은 비용의 경로가 될 수도 있다).
이와 같이 g(n) 을
설정하면, g(n) ≥  임은 자명하다.
 의 측정값인 h(n) 을 구하기 위해서는 문제영역으로부터의 휴우리스틱 정보에
의존하게 된다. 이러한 정보는 이전의 8-퍼즐 문제어서 함수 W(n) 을 구하는 데 이용된
것과 비슷할 수도 있다. 함수 h 를 휴우리스틱 함수라 하며 이것에 대해서는 A*-알고리즘의
휴우리스틱 유도 방법에서 상세히 논하게 된다.
이제 다음과 같은 평가함수를 사용한다고 가정하자.
f(n) = g(n) + h(n)
노드들의 확장 순서를
정하기 위해 이 평가함수를 사용하는 GRAPHSEARCH 알고리즘을 A*-알고리즘이라
한다. h = 0 이고 g = d (d 란 탐색 트리에서의 노드 깊이를 말함) 일 때 A-알고리즘은
나비-우선 탐색과 동일하다. 앞에서 약간 언급했듯이 나비-우선 알고리즘에 의한
탐색은 항상 최적해결경로를 유도할 수 있다고 하였다. 이제, 만일 모든 노드 n 에
대하여 측정값 h(n) 이 실제값  보다 크지 않는다면 이 휴우리스틱 h 를 이용한 A-알고리즘은 항상 최적경로를
유도하게 된다는 사실을 보이기로 한다. 이와 같이 A-알고리즘이 모든 노드 n 에
대해 항상 h(n) ≤
 을 만족시키는 h 를 사용할 때 이 알고리즘을 A*-알고리즘이라
부른다. h = 0 인 h 도 모든 노드 n 에 대해 h(n) ≤
 이 되므로 (모든 아크 비용은 작은 양의 수 e 보다 크므로
 은 언제나 양의 값을 취한다), 나비-우선 탐색은 A*-알고리즘의 특정한
경우가 되어 결국 최적경로를 유도하게 된다.
시작 노드 s 에서 목표 노드까지 경로가 존재하는 모든 형태의 그래프에 대해서 어떤 탐색 알고리즘이 s 로부터 목표 노드까지의 최적경로를 항상 유도한다면 이 탐색 알고리즘은 허용성 (admissibility) 을 지닌 알고리즘이라 한다.
알고리즘이 허용성을 가졌다는 것을 보이기 위해서는 첫째 시작 노드 s 에서 목표 노드에 이르는 경로가 존재한다면 이 알고리즘은 반드시 종결되어진다는 것을 보일 필요가 있다. GRAPHSEARCH 알고리즘이 종결될 수 있는 단계는 A-알고리즘 절에서 볼 수 있듯이 단계 3 또는 단계 5 에 있다. 이 알고리즘은 계속 루프를 거치면서 매번 OPEN 으로부터 한 노드를 꺼집어내고 유한 개의 새로운 후계 노드를 OPEN 에 첨가한다. 유한 개의 노드를 가지는 그래프에서는 결국 새로운 후계 노드 생성은 한계가 있게 되어, 단계 5 에서 목표 노드를 선택하는 순간에 성공적으로 종결이 되지 않는다면 결국 OPEN 이 비어지게 되어 단계 3 에서 종결이 되게 된다. 그러므로
결과 1 : GRAPHSEARCH 는 유한 개 노드를 가진 그래프에서 항상 종결된다.
다음에는, s 에 목표
노드까지의 경로가 존재한다면 무한 개의 노드를 가진 그래프에 대해서도 A*
는 항상 종결될 수 있다는 것을 보인다. 이를 위해 A* 가
종결되지 않는다고 반대로 부정해보자. 종결이 안된다는 의미는 OPEN 에 끊임없이
새로운 노드가 첨가되고 있음을 뜻한다. 이렇게 계속해서 OPEN 에 한 노드가 선택되고
동시에 후계 노드들이 첨가되는 과정의 반복은 결국 OPEN 에 있는 f 값이 가장 작다고
하는 노드의 f 값 조차도 엄청나게 큰 숫자가 됨을 의미한다 :  를 s 로부터 A* 에 의해 유도된 탐색 트리에서의 노드 n 까지의 가장
짧은 경로의 길이 (아크 수) 라 하자. 그래프에서 각 아크의 비용은 어떤 적은 양의
실수 e 보다는 큰 수이므로
 이 성립된다 (
 은 s 에서 n 까지의 최적 경로비용이며, g(n) 은 s 에서 n 까지의 현재까지 생성된
탐색 트리에서의 경로비용이다). 분명히
 이다. h(n) ≥ 0 이면 (앞으로 이렇게 가정함), f(n) ≥ g(n) 이며 따라서
 이다. 특히 OPEN 의 모든 노드 n 에 대해 f(n) 값의 크기는
 보다 크거나 같다. 그러므로 A* 가 끊임없이 많은 수행과정을 거친
후의 상황에서의 OPEN 에 있는 노드 중 가장 작은 f 값을 가진 노드를 선택한다 하더라도
이 노드는 아주 큰 값의
 를 가지게 되어 A* 가 종료되지 않으면 이의 f 값도 엄청나게 커진다.
이제, A*
가 결국에는 종결된다는 것을 보이기 위해, A* 가 종결되기 전에 OPEN
에는  를 만족하는 노드 n 이 항상 존재함을 보인다. 노드
 을 목표 노드라 할 때, (s =
 ) 를 s 에서
 까지 이르는 최적경로라 하고, A* 가 종결되기 전 어떠한 순간에
대해 노드 n' 을 OPEN 에 존재하는 (
 ) 에서의 어느 한 노드가 n' 이 된다). A* 에서의 f 정의에 의해
f(n') = g(n') + h(n')
n' 은 최적해결경로상의
노드이므로 현재 노드 n' 까지 도달한 수행과정에서 A* 는 이미 s 에서
n' 까지의 최적경로를 구한 것이 된다 (이 경로상에서 n' 의 모든 조상 노드들은
CLOSED 에 속해져 있다). 그러므로  이 되어
f(n') = g*(n') + h(n')
A* 에서는
 이므로 위의 식을 다음과 같이 쓸 수 있다.

그러나 최적해결경로
상에 있는 어떠한 노드에 대해서도 이 노드의 f* 값은 최적 비용 f*(s)
와 같으므로 위의 식으로부터  을 유도할 수 있다. 그러므로 다음과 같은 결과를 얻는다.
결과 2 : A* 가 종결되기 전 어떠한 순간에도, s 로부터 목표 노드에 이르는 최적 경로 상에 있고 f(n') ≤ f*(s) 를 만족하는 노드 n' 이 OPEN 에 존재한다.
위의 결과 2 와 바로 앞에서 논한 사실 (종결되지 않는 A* 수행에서 OPEN 에 있는 노드들 가운데 가장 작은 f 값도 무한히 커진다는 사실) 을 함께 생각하면 이는 모순이므로 결국 A* 는 무한 개의 노드를 가진 그래프에 대해서도 종결됨을 알 수 있다. 즉,
결과 3 : s 로부터 목표 노드에 이르는 경로가 존재한다면, A* 는 종결된다.
결과 3 으로부터 다음과 같은 사실을 추론할 수 있다 : OPEN 에 있는 노드로써 f(n) < f*(s) 을 만족하는 어떠한 노드 n 도 A* 의 수행과정 중에 언젠가는 확장되기 위해 선택이 된다. 이에 대한 증명은 이제 간단한 문제이다. A* 가 종결되는 경우는 단계 5 에서 목표 노드를 선택한 경우나 단계 3 에서 OPEN 이 비어진 경우이다. 그러나 결과 2 에 나타나듯이 수행과정 동안에 OPEN 에 있는 노드로써 최적 경로 상에 놓여 있는 노드가 항상 존재하기 때문에, s 로부터 목표 노드까지의 경로가 존재한다면, 종결이 되기 전에는 결코 OPEN 이 비어 있을 수 없다. 그러므로 A* 는 반드시 목표 노드에 도달함에 의해 종결된다.
다음에는 A* 가 항상 목표노드에 이르는 최적의 경로를 구하는 것으로 종결되어짐을 보인다. 이를 위해 A* 가 최적의 경로를 구하지 않고 단지 어느 목표 노드 t 에도 달함으로써 종결된다고 가정해보자. 즉, f(t) = g(t) > f*(s). 허나 결과 2 에 의해, A* 가 종결되기 전에 최적경로상에 있고 f(n') ≤ f*(s) < f(t) 를 만족하는 노드 n' 이 OPEN 에 항상 존재함을 알 수 있다. 그러면, 이 시점에서 A* 는 노드 확장을 위해 노드 t 보다는 n' 을 선택했어야만 할 것이다. 이는 A* 가 최적경로상에 있는 n' 을 선택하지 않고 t 를 선택하는 것에 의해 종결된다는 처음의 가정에 모순되므로 결국 우리는 다음과 같은 결과를 얻게 된다.
결과 4 : A* 알고리즘은 허용성을 가진다 (즉, 만일 s 에서 목표 노드에 이르는 경로가 존재한다면, A* 는 최적경로를 구함으로써 종결된다).
A* 에서 확장을 위해 선택된 노드에 대해서 결과 2 로부터 흥미로운 성질을 발견할 수 있다. 선택된 노드의 f 값은 최소비용 f*(s) 보다 결코 크지 않다. 이 결과는 나중에 중요하게 이용될 것이다. 이 결과를 증명하기 위해 노드 n 을 A* 수행과정 중에 선택된 한 노드라 하자. 만일 n 이 목표 노드이면 결과 4 에 의해 f(n) = f*(s) 이 된다. 그러므로 f(n) 은 f*(s) 보다 크지 않다. 만일 n 이 목표 노드가 아니라고 하자. 이 경우에는 결과 2 에 의해 최적해결경로 상에 f(n') ≤ f*(s) 을 만족하는 OPEN 에 있는 노드 n' 가 존재한다. 그러므로 만일 n = n' 이면 결과는 분명히 성립되며, 그렇지 않은 경우에는 f(n) ≤ f(n') ≤ f*(s) 이므로 (확장을 위해 선택된 노드가 n' 가 아니고 n 이므로) 당연히 결과를 성립시킨다. 그러므로 다음과 같이 결과를 표현할 수 있다.
결과 5 : A* 에 의해 확장되기 위해 선택된 어떠한 노드 n 에 대해서도,
f(n) ≤ f*(s)
휴우리스틱 함수 h 가 얼마나 정확한가 하는 것은 문제영역에 대해 가지고 있는 휴우리스틱 지식의 양에 좌우된다. h(n) = 0 을 사용하면, 모든 노드 n 에 대해 h(n) ≤ h*(n) 을 만족시키므로 허용성을 지닌 알고리즘이 될지라도 문제영역에 대한 어떠한 휴우리스틱 정보도 반영하고 있지 않다.
다음과 같은 평가함수
 를 각각 사용하는 A* 의 두 가지 유형
 과
 를 비교해보자 :

여기서  는 모두 h* 보다 크지 않은 값을 취한다. 목표 노드가 아닌 모든
노드 n 에 대해
 이 성립된다면 알고리즘
 가 알고리즘
 보다 더 많은 정보를 제공받고 있다 (more informed) 고 말한다. 직관적으로
생각해서 더 큰 h 값을 가진다는 것은 실제값인 h* 에 보다 더 접근한
측정값을 의미하므로 더 정확한 휴우리스틱 정보가 이용되었다 할 수 있으므로 이러한
정의는 타당하다고 하겠다.
예로서, 그림 7 에 나타난 8-퍼즐을 살펴보자. 여기서는 평가함수로 f(n) = d(n) + W(n) 을 사용했다. A* 에서 g(n) 을 d(n) (d(n) 은 노드 n 의 깊이를 말하므로 트리 형태에서는 g(n) 과 동일함) 으로 간주하고 h(n) 을 W(n) 으로 (W(n) 은 n 의 상태에서 잘못 놓여진 숫자배열의 갯수인데 이 상태 n 에서 바라는 목표상태로 이르기 위해서는 최소한 W(n) 의 단계 (상태 변화) 를 거쳐야 하므로 W(n) ≤ h*(n) 을 만족함) 간주할 수 있다. 이렇게 했을 때 h(n) = W(n) 을 사용한 A*-알고리즘은 h(n) = 0 을 사용한 나비-우선 탐색 (A*-알고리즘의 일종) 보다 더 많은 정보를 제공 받았다고 하는 것이 타당하다.
더 많은 정보를 제공받은 알고리즘은 문제 해결을 위해 그렇지 않는 알고리즘보다 좀 더 적은 수의 노드를 생성시킬 것이라는 것을 직관적으로 생각할 수 있다. 이러한 생각은 그림 6 과 그림 7 의 8-퍼즐에서 나타난다. 그러나, 물론 한 알고리즘이 다른 알고리즘에 비해 적은 수의 노드를 생성했다고 해서 이 알고리즘이 더 효율적이다라고는 말할 수 없다. 더 많은 정보를 제공받은 알고리즘은 아마도 더 많은 계산비용을 소비할 것이며 이것은 효율성을 낮게 만든다. 그럼에도 불구하고 알고리즘에 의해 생성되는 노드의 갯수는 효율성을 결정하는 중요한 요소들 중의 하나로서 고려해 볼 필요성이 있다.
A*-알고리즘의
유형으로  과
 가 있다하고
 가
 보다 더 많은 정보를 제공 받은 알고리즘이라 하자. 이제 이 두 알고리즘
 가 어떤 문제에 적용되었을 시 이들 모두가 동일한 최적의 경로를 유도하게 됨은
당연하다 (
 모두 A*-알고리즘의 종류들이므로 허용성을 지닌다). 허나 종결이
되고 난 후
 에 의해 유도된 탐색 그래프 G 에서
 에 의해 확장된 모든 노드 n 이
 에 의해서도 역시 확장되었음을 알 수 있다. 즉,
 은 더 많은 정보를 제공받은
 보다도 항상 더 많은 노드를 확장하게 된다고 하겠다.
위의 사실에 대한 증명은
 에 의해 종결된 후에 유도된 탐색 트리에서의 노드에 대한 깊이에 관해서 귀납법으로
보일 수 있다. 첫째,
 가 이것의 탐색 트리에서 깊이 0 인 노드 n 을 확장시키면 (확장이란 용어는
이 노드의 후계 노드들을 모두 생성시키는 것을 말함)
 도 이 노드 n 을 확장시킨다 (n 은 시작 노드 s 와 같으며 s 가 목표 노드이면
 모두 s 를 확장하지 않으며, s 가 목표 노드가 아니면
 모두 s 를 확장한다). 둘째, 귀납적 가정으로
 의 탐색 트리에서 깊이 k 나 이보다 작은 깊이를 가지는
 에 의해 확장된 노드들은 또한
 에 의해서도 확장된다라고 가정한다. 이제 여기서 증명해야 되는 것은
 의 탐색 트리에서 깊이 k + 1 을 가지는
 에 의해 확장되는 어떠한 노드 n 도
 에 의해서도 확장된다는 것이다. 귀납적 가정에서
 의 탐색 트리에서 노드 n 의 모든 조상 노드들은
 에 의해서도 확장되어진 노드들이므로 노드 n 역시
 탐색 트리에 존재하고 시작 노드 s 에서 노드 n 까지의 경로가 존재하므로 이
경로는
 탐색 트리에 존재하는 경로보다 비용이 크지 않다 (왜냐하면
 탐색 트리 상에서 확장된 모든 노드들은
 탐색 트리 상에서도 확장되어 있기 때문이다). 즉,

이제 위에서 증명하고자
하는 사실을 부정하여  은
 에 의해 확장되는 노드 n 을 확장하지 않는다고 가정해 보자. 이러면 분명히
 이 종결된 후 노드 n 은
 에서 OPEN 에 속해 있어야 한다 (왜냐하면
 은 n 의 부모 노드를 확장했기 때문에).
 은 노드 n 을 확장하지 않고 최적의 경로를 구하면서 종결되었기 때문에 다음과
같은 식이 성립된다.

그러므로

 을 앞에서 증명했으므로 위의 식은 다음과 같이 변환될 수 있다.

그러나, 결과 5 와
 가 노드 n 을 확장시켰으므로,

또는

또는

이 식을 앞에서의 식
 과 비교하면
 이므로
 가
 보다 더 많은 정보를 제공받았다는 전제에 위배된다. 그러므로 이제 다음과 같은
결과로 요약할 수 있다.
결과
6 :  과
 는 A*-알고리즘의 유형들로
 가
 보다 더 많은 정보를 제공받았다고 전제하자. 그러면 시작 노드 s 에서 목표
노드까지의 경로를 가지는 어떠한 그래프에 대해서도 이들의 탐색이 종결된 후
 에 의해 확장되어진 모두 노드들은 또한
 에 의해서도 확장되어진다. 그러므로
 은
 보다도 더 많은 노드를 확장한다.
앞에서 GRAPHSEARCH 알고리즘에서 노드 n 이 확장될 때 이 노드의 후계 노드들 가운데 OPEN 이나 CLOSED 에 이미 포함되어진 후계 노드들이 있는가를 검사하였다. 만약 존재해 있다면 탐색 트리에서의 포인터를 변형할 필요성이 있는지를 살펴보아 최종적으로 시작 노드에서 노드 n 의 자손 노드들에 이르는 각각의 경로들이 최소비용들을 갖도록 (현재까지 수행된 탐색 그래프 안에서의 경로들에 한해서) 해야 한다. 이와같은 작업은 탐색 트리를 조정하는 부담 외에 생성된 노드가 과거에 이미 생성되어진 적이 있는 노드인지를 알아보기 위해 비교 검사해야 하는 많은 계산비용이 필요하다. 휴우리스틱 h 에 관해 약간의 제한이 주어진다면 이를 이용한 A*-알고리즘이 확장을 위해 노드를 선택했을 때, 시작 노드 s 에서 이 선택된 노드까지의 최적경로는 이미 구해져 있는 상태가 된다는 것을 보일 수 있다.
그러므로 h 에 이러한 제한이 주어지면 A*-알고리즘에서 새로이 생성된 노드가 CLOSED 에 이미 속해져 있는 것인지 검사할 필요가 없으며 (만일 검사하여 CLOSED 에 속해 있던 노드라고 판명되어도 탐색 트리에는 아무런 변화도 생기지 않는다. 왜냐하면 CLOSED 에 있는 노드들은 과거에 이미 확장을 한 것이므로 앞의 사실에서 말했듯이 이 때는 벌써 이 노드까지의 실제적인 최적경로가 구해져진 상태이기 때문이다). 이 노드의 후계 노드들이 존재해 있어도 (CLOSED 에 있는 노드에는 이것의 후계 노드들이 존재해 있음) 이것들의 포인터들의 변경 여부를 검사할 필요가 없게 된다.
 가
 의 후계 노드인 두 개의 노드
 와
 에 대해, 다음과 같은 식이 성립하면 휴우리스틱 함수 h 가 단조 제한 (monotone
restriction) 을 만족한다고 한다 :

h(t) = 0, (t 는 목표 노드이며,  는 아크
 의 비용을 말함)
단조 제한을 다음과 같이 표현하면 삼각형 부등식과 유사한 것처럼 보인다 :

이는 노드  에서 목표 노드까지의 최적경로에 대한 측정값이
 와
 사이의 아크 비용과 노드
 에서 목표 노드까지의 최적경로에 대한 측정값을 합한 것보다 크지 않음을 나타내고
있다.
h(n) = W(n) 으로 정한 앞에서의 8-퍼즐 예에는 단조 제한을 만족시킴이 쉽게 검증된다. 그러나 함수 h 가 탐색과정 동안 변화된다면 단조 제한이 만족 안되는 수도 있다.
이제 단조 제한이 주어진
상황하에서 A* 에서 확장을 위해 노드를 선택할 때 이 선택된 노드까지의
최적경로는 이미 구해져 있다는 사실을 증명한다. 노드 n 을 A* 에서
확장을 위해 선택된 어떤 노드라 하자. 만일 n = s 이면 A* 는 s 까지의
최적 경로를 이미 구했다고 말해도 무방하다. 이제 n 가 s 와 다르다고 하자. 순서
P = (  ) 을 s 로부터 n 까지의 최적경로라 가정한다. 그리고 A* 가 확장을
위해 노드 n 을 선택한 바로 그 순간에 CLOSED 에 있는 노드로써 이 순서 P 에서
제일 나중의 노드를
 이라 하자 (노드 s 는 CLOSED 에 있지만 노드
 는 확장을 위해 금방 선택된 노드이므로 CLOSED 에 있지 않다). 그러면 순서
P 의
 은 A* 가 노드 n 을 선택한 그 순간에 OPEN 에 있다.
단조 제한을 이용하면 다음과 같은 식을 얻을 수 있다 :

 와
 모두 최적경로 상에 있으므로,

그러므로,

 이므로 다음과 같은 표현을 유도할 수 있다 :

또는

그러므로 A* 가
노드  대신에 노드 n 를 확장하기 위해 선택했을 그 순간에 g(n) ≤ g*(n)
이 성립되어 있는 것이 틀림이 없어야 한다. 만약 그렇지 않다면 f(n) 은
 보다 큰 값을 가지게 되어 노드 n 대신에 노드
 이 선택되기 때문이다. 그러나 탐색 트리의 모든 노드 m 에 대해서 g(m) ≥ g*(m)
이므로, 다음과 같이 결론을 내리게 된다 :
결과 7 : 단조 제한이 만족된다면, A* 는 확장에 선택된 어떠한 노드에 대해서도 이것의 최적경로는 이미 구해져 있다. 즉, A* 가 노드 n 을 확장을 위해 선택하면, 단조 제한이 만족된 상황하에서는 g(n) = g*(n) 이 된다.
단조 제한은 또다른
흥미로운 결과를 내포한다 : A* 에 의해 확장되는 일련의 노드들의 f
값은 감소하지 않는다. 이제 이 사실을 증명해 보도록 하자. 노드  는
 이 확장된 직후 바로 다음으로 확장된 노드라 가정하자. 만일
 이 확장 직후에 OPEN 을 살펴보니 그 안에
 이 포함되어 있는 경우라면 분명히
 가 성립한다 (
 이
 보다 OPEN 에서 먼저 선택되었다는 것은 그것의 f 값이 더 작다는 것을 의미한다).
그러나 만일
 이 확장될 때
 가 OPEN 에 존재해 있지 않다고 한다고 하자 (물론 이 때
 는 확장되지 않은 노드이므로 CLOSED 에는 속해 있지 않다).
그러면,  다음에
 가 확장되었으므로,
 의 확장하는 과정 중에
 는 OPEN 에 첨가되는 과정을 가진다. 그러므로
 는
 의 후계 노드이다. 이러한 상황에서
 가 확장을 위해 선택되면 이 때 다음과 같이 식이 유도된다.

단조 제한은 다음을 의미한다 :

그러므로,

위의 식은 A* 에 의해 확장된 일련의 노드들의 어느 인접한 노드들의 쌍에 대해서도 성립하므로 다음과 같이 결론지을 수 있다 :
결과 8 : 단조 제한이 만족되는 상황하에서 A* 에 의해 확장되는 일련의 노드들의 f 값은 감소하지 않는다.
단조 제한이 성립되지 않는 상황하에서는 전에 확장된 노드의 f 값보다 더 작은 f 값을 지닌 노드가 현재 확장될 수도 있다. 이와같이 단조 제한이 성립 안되는 조건하에서 이 사실을 활용하여 A* 의 효율성을 증가시킬 수 있다. 결과 5 에 의하면, 확장을 위해 선택된 어떠한 노드 n 도 f(n) ≤ f*(s) 가 성립한다. A* 가 수행되는 과정동안 이제까지 확장된 모든 노드들의 f 값들 중에서 최대값을 전체 변수 F 가 갖고 있다고 가정하자. 어느 때에도 F ≤ f*(s) 임은 명백하다. OPEN 에 있는 노드로서 f(n) < F 를 만족하는 노드 n 이 존재하면 언젠가는 이 노드 n 은 확장된다 (결과 3 에서의 부연 설명한 부분을 참조할 수 있다). 실제로 OPEN 에 있는 노드로써 이것의 f 값이 F 보다 작은 노드들이 여러 개 존재할 수도 있다. 이 경우에 이들 노드들 중에서 가장 작은 f 값을 지닌 노드를 선택하기보다는 가장 작은 g 값을 지닌 노드를 선택하여 확장할 수도 있다 (물론 이 모든 노드들은 언젠가는 확장을 위해 선택이 된다).
이와같이 노드 선택방식을 변화시키면 노드에 이르는 첫번째로 설정된 경로가 실제로 이 노드까지의 최적경로일 가능성을 높이게 된다 (g(n) 이 작다는 것은 시작 노드 s 에서 노드 n 에 이르는 현재 탐색에서의 경로길이가 짧음을 의미하므로). 그러므로 단조 제한이 성립되지 않는 때에도 이와같은 노드 선택방식은 알고리즘의 단계 7 에서의 포인터 재조정의 부담을 감소시킨다. 단조 제한이 만족되는 경우에는 결과 8 에서 알 수 있듯이, OPEN 에 있는 노드로써 F 보다 작은 f 값을 지닌 노드는 존재하지 않는다.
휴우리스틱 함수의 설정은 탐색 알고리즘 A 의 휴우리스틱 능력을 결정하는데 중요하다. h = 0 을 사용하면 허용성을 보장받지만, 나비-우선 탐색이 되어 비효율적이라 하겠다. h 를 h* 에 보다 접근하도록 그러나 크지는 않도록 설정하면 허용성을 유지하면서 적은 수의 노드를 생성하게 된다.
그러나 휴우리스틱 능력이 h 가 반드시 h* 보다는 작아야 한다는 조건을 없앰으로써 더 커지는 경우도 많다. 이와 같은 휴우리스틱 성질은 좀더 복잡한 문제를 해결하는데 도움을 주게 된다. 8-퍼즐에서 h(n) = W(n) (W(n) 은 잘못 놓여진 타일의 갯수) 은 언제나 h*(n) 보다 작은 값이 되지만 n 에서 목표에 이르기 위한 단계수를 측정하는 값으로는 매우 적합한 측정값이라 할 수 없다. 더욱 향상된 측정값은 h(n) = P(n) 으로서 P(n) 이란 현재 상태 n 에서의 각 타일이 옆의 타일들에 제약을 받지 않고 목표상태에서의 그 타일이 놓여야 할 위치로 가는 단계수를 모든 타일 (공백 타일은 제외) 에 대해 계산한 이것들의 합계를 말한다. 그러나 타일이 위치를 변동시킬 때 옆의 타일들에 대한 제약을 무시했음으로 어느 정도 정확성이 결여된 측정값이라 하겠다. 8-퍼즐에 대해 보다 더 정확한 측정값은 다음과 같다 :
h(n) = P(n) + 3S(n)
여기서 S(n) 은 다음과 같이 계산된다 : 8-퍼즐의 3 × 3 판에서 중간 위치 칸에 타일이 있으면 점수 1 을 주고, 그외에 중간 칸을 제외한 바깥의 8 개의 칸을 차례로 돌면서 한 방향으로만 놓여진 타일의 숫자가 바로 옆의 칸에 이 숫자의 다음 숫자가 놓여 있으면, 0 을 그렇지 않으면 2 의 점수를 준다 (예로서 바깥 원으로 돌면서 현재 검사하는 칸이 2 번 타일을, 다음 옆의 순서에는 3 번 타일이 놓여 있으면 2 번 타일에서 점수는 0 이 된다. 그렇지 않으면 2 가 됨). 이러한 식으로 정의한 함수 h 는 항상 h* 보다 작지는 않다. 허나 이 함수를 이용하면 이전에 소개한 h 함수를 이용했을 때보다 좀더 어려운 8-퍼즐 문제를 쉽게 풀 수가 있다. 예를 들어 초기의 배열상태가 다음과 같다고 하자 :
|
2 |
1 |
6 |
|
4 |
|
8 |
|
7 |
5 |
3 |
이 배열상태를 아래와 같이, 변환하기 위해 위의 평가함수와 함께 GRAPHSEARCH 를 적용한 결과로 유도된 탐색 트리는 그림 8 과 같이 된다.
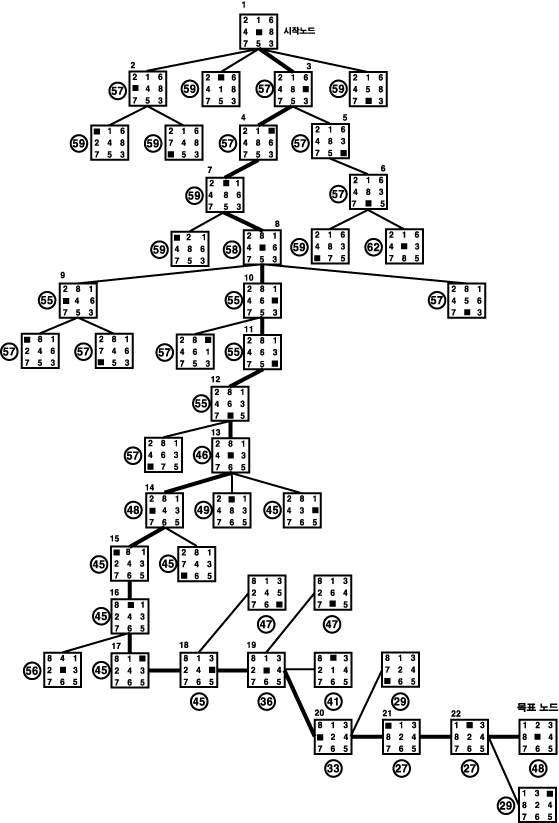
그림 8 8-퍼즐에 대한 탐색 트리
|
1 |
2 |
3 |
|
8 |
|
4 |
|
7 |
6 |
5 |
각 노드의 f 값은 원 안에 들어있는 수치이며, 원이 그려져 있지 않은 수는 노드가 확장된 순서를 나타낸다. f 가 최소인 값이 여러 개 있을 때는 탐색 트리에서 가장 깊은 노드에 있는 최소값을 가진 노드를 선택한다.
h 함수가 항상 h* 보다 작은 값을 가지는 것은 아니기 때문에 최적의 경로를 반드시 유도하게 된다고 보장은 할 수 없음에도 불구하고 이 탐색에서는 최소비용 (18 단계) 의 경로를 우연히도 유도하였다. 이 함수 h 의 사용은 단지 시작 노드 근처에서만 약간 옆으로 퍼졌지 그 외에는 목표 노드를 향해 계속 집중적으로 탐색했음을 그림 8 을 통해 알 수 있다.
탐색 알고리즘의 휴우리스틱 능력을 결정하는 또 다른 요소는 휴우리스틱 함수를 계산하는데 소요되는 계산비용이다. 가장 바람직한 함수는 h* 와 동일한 것이 되어 최소개의 노드를 확장하는 함수이다. 그러나 이러한 h 는 모든 노드에 대해 하나 하나씩 완전한 탐색을 한 후에 구해질 수 있으므로 전체적인 계산비용은 엄청나게 된다. 가끔, h* 보다 언제나 작은 값을 가지지는 않는 h 함수의 계산이 언제나 h* 보다 작은 값을 가지는 함수의 계산보다 더 간편하다. 이 경우에는 휴우리스틱 능력이 두 가지 면에서 향상된다. 즉, 허용성은 보장할 수 없지만 확장되는 전체 노드의 수가 감소될 수 있으며, h 의 계산비용이 감소된다.
어떤 경우에는 주어진 휴우리스틱 함수에 단지 1 보다 큰 어떤 양의 수를 곱함에 의해 휴우리스틱 능력을 향상시킬 수 있다. 만일 곱해지는 양의 수가 매우 큰 값이면 평가함수의 값은 거의 h(n) 값에 의존되기 때문에 마치 g(n) = 0 인 것처럼 된다. 많은 종류의 문제에서는 단지 목표 노드에 이르는 경로를 구하는 것 자체에 관심을 두며 그 구해진 경로의 비용에 대해서는 고려하지 않는다. 바꾸어 말하면 해결 경로를 구하기 위해 요구된 탐색 노력의 양을 최소화하는데 관심을 둔다. 이런 경우에는 탐색 동안의 그 단계에서는 여태까지 유도해 온 경로의 비용은 고려하지 않으므로 g 값은 완전히 무시될 수 있으며, 오직 현 단계에서 목표 노드에 이르는 가장 탐색 노력을 적게 들이는데 주안점을 두게 된다. 그러므로 이러한 문제에서는 평가 함수를 f = h 로 하여 사용하게 된다.
목표 노드에 이르는 어떤 경로가 결국에는 유도된다는 것을 보장받기 위해서는, 최소비용의 경로를 구하는데 g 가 필수적인 것이 아니라고 해도 f 계산에 g 값을 포함시켜야만 한다. 이러한 보장은 h 가 완벽한 측정값이 안 될 때 반드시 필요하다. 만일 최소의 h 값을 지닌 노드가 항상 확장된다면 탐색과정은 아마도 목표 노드에 도달하지 못하고 영원히 엉뚱한 노드만을 확장할 수도 있기 때문이다. g 값을 f 계산에 포함시키는 것은 탐색에 있어 나비-우선이라는 요소가 가미된 것을 의미하므로 암시된 그래프의 일부가 영원히 탐색되지 않게 하지는 않음을 보장한다.
평가함수에서 g 와 h 의 상대적 비중은 f = g + wㆍh (w 는 양수) 로 조정될 수 있다. w 값이 매우 큰 수가 되면 휴우리스틱 요소가 강조되며, 반대로 w 값이 매우 작은 수가 되면 나비-우선적인 성질을 강조하게 된다. 실험적인 결과로 볼 때, 탐색 효율성은 종종 탐색 트리에서 노드의 깊이에 반비례하여 w 값을 조정함에 의해 증가된다. 얕은 깊이의 노드에 대해서는 w 값을 크게하여 휴우리스틱 요소에 많이 의존된 탐색이 이루어지고, 깊은 깊이의 노드에 대해서는 나비-우선적 요소가 강하도록 하여 목표 노드까지 이르는 어떤 경로가 결국에는 유도된 것이라는 것을 보장한다.
요약해서, A-알고리즘의 휴우리스틱 능력에 영향을 미치는 중요한 요인은 다음 세 가지로 열거할 수 있다 :
(a) 경로의 비용
(b) 경로 유도를 위해 확장된 노드의 개수
(c) h 계산을 위해 요구된 계산 노력
적절한 휴우리스틱 함수 h 의 설정은 휴우리스틱 능력을 극대화시키기 위해 위의 세 가지 요인을 균형있게 조화시킨다.
어떠한 문제들은 전향이나 후향의 어느 방향으로도 규칙이 이용될 수 있는 생성 시스템을 사용해 풀려질 수 있다. 더우기 양방향에서 동시에 탐색이 이루어지는 경우도 있다. 이와 같이 양방향의 탐색을 가진 생성 시스템의 그래프 탐색과정이라 시작 노드에서 목표 노드를 향해 그리고 목표 노드에서 시작 노드를 향해 탐색이 동시에 진행되는 것이다. 이 탐색과정이 종결되는 순간은 두 탐색의 경계가 서로 마주칠 때이다.
두 개의 탐색이 모두 나비-우선 형태와 유사한 탐색으로 이루어진 양방향 탐색은 이것의 단일 방향 탐색 (나비-우선 형태와 유사한) 과 비교할 때 양방향 탐색이 더 효과적이라 하겠다. 그림 9 에 보듯이 양방향 탐색은 단일 방향 탐색보다 매우적은 수의 노드를 확장함을 알 수 있다.
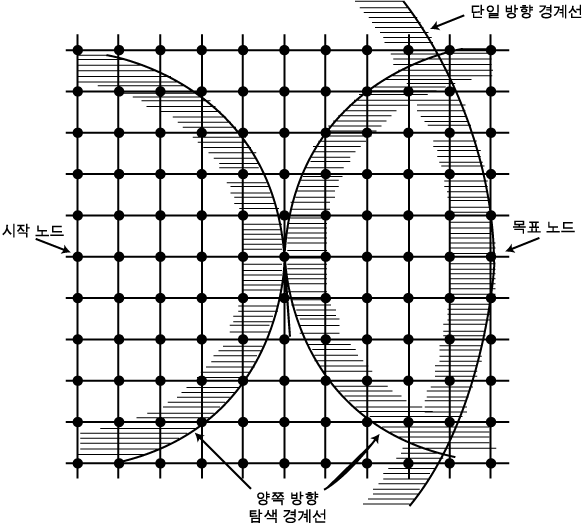
그림 9 양쪽 방향 및 단일 방향 나비 우선 탐색
그러나 위의 경우와는 달리 휴우리스틱 탐색 형태를 지닌 양방향 탐색과 단일방향 탐색과의 비교는 더욱 복잡하다. 양방향 탐색에 사용된 휴우리스틱 함수는 완전히 정확한 값이 아니고 측정값이므로 두 방향에 있는 탐색 트리들의 경계가 교차되지 않고 지나쳐 버릴 수도 있다. 이러한 경우에는 양방향 탐색에 의해 생성된 노드의 갯수는 단일 방향 탐색에 의해 생성된 노드 갯수보다 두 배나 많은 수가 된다. 그림 10 은 이러한 상황을 잘 나타낸다.
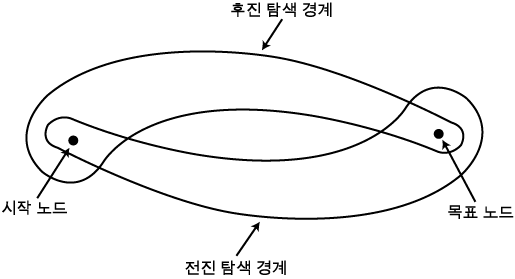
그림 10 빗나간 전진 및 후진 탐색
여태까지 설명한 바와 같이 휴우리스틱 정보의 사용은 해결경로를 유도하는데 필요한 탐색 노력량을 상당히 감소시킬 수 있다. 그러므로 이것의 사용은 더 큰 그래프도 탐색할 수 있게끔 한다. 그럼에도 불구하고 만족스러운 경로가 유도되기 전에 사용가능한 기억공간이 완전히 바닥나 버리는 경우가 생길 수 있다. 이러한 경우에는 탐색이 불가능하다고 단념하지 말고 탐색 그래프에 가지를 쳐서 (즉, 유망한 노드만 남기고 나머지는 삭제하는 형태), 다시 필요한 기억공간을 확보하여 탐색을 더 깊게 해나가는 것이 바람직하다 하겠다.
이와 같이 탐색과정은 수행 동안에 모자라는 기억공간을 확보하기 위해 삭제 연산을 하는 단계를 포함시키게 된다. 각 단계에서는 OPEN 에 있는 일부 노드 (예를 들어 크기가 작은 f 값을 가지는 노드들) 를 보존하기 위해 표시한다. 이렇게 표시된 노드들에 대해서는 시작 노드 s 에서 이 노드들에 이르는 경로가 보존되지만 탐색 그래프에서의 그외 나머지 부분은 제거된다. 그 다음에 탐색은 보존된 노드들을 가지고 재차 수행되어진다. 물론 각 단계에서 A* 가 사용되고 전체 탐색과정이 경로를 유도했다 할지라도 구해진 경로가 최적의 경로임에 대한 보장은 할 수 없다.
탐색 노력을 절약할 수 있는 한 가지 기법으로 작은 값을 가지는 몇 개의 훅 노드를 제외하고 나머지 후계 노드들을 삭제하는 기법이 있다. 물론 삭제된 노드들 중에는 목표에 이르는 최적경로 (또는 유일한) 상에 놓여 있어야 할 노드도 있을 수 있다. 그러므로 특정한 문제에 대해 이러한 기법을 사용한 경우 효과적인가 하는 것은 오직 경험에 의존하게 된다.
문제영역에 대한 지식은 가끔 어떤 노드가 해결경로 상에 있을 수 없는 노드라는 것을 미리 알게하는 데 도움을 준다 (그러한 노드는 역행 알고리즘에서 사용한 서술문 DEADEND 와 같은 서술문을 만족시킨다). 이러한 노드들은 A-알고리즘에 이 검사하는 과정을 포함시킴에 의해 제거시키거나 또는 이러한 노드들에 매우 큰 h 값을 배정하여 확장에 선택이 안되도록 할 수 있다.
어떤 탐색문제에서는, 노드의 후계 노드들이 일일이 열거될 수 있으며, 이들의 해당 데이터베이스들 자체가 완전히 계산되기 전에 h 값을 먼저 계산해 볼 수 있는 경우도 있다. 더우기 노드가 확장을 위해 선택될 때까지 이 노드의 해당 데이터베이스의 계산을 지연시키는 것 즉, 알고리즘에 의해 확장되지 않는 어떠한 후계 노드에 대해서도 계산을 하지 않는 방법은 바람직할 수도 있다.
탐색기법의 휴우리스틱 능력은 주어진 문제마다의 특유한 요인들에 좌우된다. 휴우리스틱 능력의 산정은 계산보다는 경험에 의해 주로 판단된다. 그러나 계산될 수 있는 성능 측정들이 있으며, 비록 이것들이 휴우리스틱 능력을 완전히 결정하지는 못하지만 여러 종류의 탐색기법들을 비교하는데 유용하다.
한 가지의 이러한 측정으로 관통력 (penetrance) 이 있다. 어떤 탐색의 관통력 P 는 탐색이 목표를 향해 얼마나 집중되었는가 (그외 쓸데없는 탐색은 상대적으로 적게 하고) 하는 정도를 나타낸다. 관통력 P 는 다음과 같이 정의된다 :
P = L / T
여기서 L 은 목표에까지 이르는 경로의 길이이며, T 는 이 경로를 유도하는 데까지 생성되어온 노드의 총 갯수 (목표 노드는 포함하나 시작 노드는 포함하지 않는다) 예를 들어, 탐색과정이 아주 정확하여 오직 해결경로 상에 있을 노드만을 생성했다면 P 는 자신의 최대값인 1 을 갖게 된다. 정보를 제공받지 않은 탐색과정에서는 P 값이 1 보다 훨씬 작은 값이 된다. 그러므로 관통력은 탐색으로 유도된 트리가 넓은 것에 비해 얼마나 좁은가 하는 정도를 나타낸다.
탐색의 관통력 값은 탐색방법의 효율성 뿐만 아니라 탐색되는 문제의 난이도에도 좌우된다. 주어진 탐색방법에 의해서 최적해결경로의 길이가 짧으면 관통력값이 높을 가능성이 많으며 반대로 길이가 길면 관통력 값이 낮아질 가능성이 많다 (해결 경로 길이 L 의 증가는 보통 T 를 더 크게 증가시킨다).
최적해결경로의 길이와 거의 독립적인 또하나의 측정요소로써 유효분기계수 (effective branching factor) B 가 있다. 이것의 정의는 다음과 같은 트리의 가정하에서 이루어진다 : (a) 트리의 전체 길이는 해결경로 (시작 노드에서 목표 노드까지의 경로를 말함) 의 길이와 같다. 그리고, (b) 트리에 있는 전체 노드 갯수는 탐색동안에 생성된 노드 수와 같다. 유효분기계수 B 란 이러한 트리에서의 각 노드가 소유하는 후계 노드의 일정한 갯수를 말한다. 그러므로 B 값은 경로길이 L 과 생성된 전체 노드 갯수 T 에 의해 다음과 같이 표현된다 :

비록 L 과 T 의 함수로써 B 를 나타낼 수 없을지라도 여러 가지 L 값에 대해 B 와 T 사이의 변화 관계를 그림 11 과 같이 나타낼 수 있다. B 의 값이 1 에 가까우면 목표를 향해 매우 집중된 탐색에 해당하고 다른 방향으로의 분기는 매우 적다. 반면에 폭이 넓은 탐색 그래프는 B 의 값이 높게 된다. P = L(B - 1) / B[BL - 1] 와 같이 관통력 P 는 B 와 L 에 의해 표현될 수 있다. 그림 12 를 여러 가지의 B 값에 대해 P 와 L 사이의 변화를 보여준다.

그림 11 여러 가지 L 값에 대한 B 와 T 의 관계

그림 12 여러 가지 B 값에 대한 P 와 L 의 관계
유효분기계수가 경로길이 L 에 무관하게, 주어진 문제 (예를 들어 8-퍼즐 문제) 에서 언제나 일정하다면, 여러 가지 경로길이의 탐색에 대해 각기 얼마나 많은 수의 노드를 생성하는지를 예측할 수 있다. 예를 들어, 그림 11 을 사용하면 그림 8 에 묘사한 f = g + P + 3S 의 평가함수를 사용한 8-퍼즐 문제는 B 값이 1.08 로 계산된다 (그림 8 에서 L = 18, T = 43 이며 B 는 L 과 T 로 표현되어진다).
이제 위와 똑같은 평가함수를 사용해서 L = 30 이 되는 좀더 복잡한 8-퍼즐 문제에서 얼마나 많은 수의 노드가 생성되는지 계산해 볼 수 있다. 유효분기계수 B 가 1.08 이므로 계산에 의해 총 120 개의 노드가 생성될 것이라고 예측할 수 있다. 우연하게도 이러한 예측의 결과는 8-퍼즐의 여러 문제에 대해 Doran and Michie (1966) 가 행한 실험적 결과와도 어느 정도 일치하고 있다.
제 3 장에서는 가분해 생성 시스템과 AND/OR 그래프의 구조에 대해 소개하였다. 이 절에서는 AND/OR 그래프 탐색을 위한 휴우리스틱 방법에 대해 논한다.
AND/OR 그래프에서 한 노드에 AND 또는 OR 명칭의 주어지는 것은 부모 노드와 이 후계 노드 사이의 관계를 말해 준다. 한 경우는, 복합적인 데이터베이스를 지닌 부모 노드가 AND 후계 노드들로 된 집합을 가지게 되는 경우로 이 때 각 AND 후계 노드의 데이터베이스의 구성요소들이 된다. 다른 경우는, 한 요소의 데이터베이스를 지닌 부모 노드가 OR 후계 노드들을 가지는 경우로 이 때는 각 OR 후계 노드의 데이터베이스는 부모 노드의 데이터베이스에 각 규칙을 적용함에 의해 얻어지게 된다.
여러 가지 종류의 규칙순서를 적용해서 동일한 데이터베이스를 유도할 수 있기 때문에 일반적으로 위의 탐색은 특별한 트리라기 보다는 그래프 (구체적으로 AND/OR 그래프) 에 관심을 두게 된다. 예를 들어 한 요소의 데이터베이스를 지닌 노드는 어떤 복합된 데이터베이스의 분해에 의해 얻어진 것일 수도 있고 또는 어떤 데이터베이스에 규칙을 적용해서 얻어진 것일 수도 있다. 전자의 경우에 이 노드를 부모 노드에 대해 AND 노드라 부르고, 후자의 경우에 이 노드를 부모 노드에 대해 OR 노드라 부른다. 또는 한 노드에 대해 이것이 AND 노드 또는 OR 노드라고 동시에 붙여질 수도 있다 (그러나 부모 노드는 다름). 여기서 먼저 AND/OR 그래프 구조 표현을 위한 일반적인 용어를 살펴본다.
여기서의 AND/OR 그래프는 하이퍼그래프 (hypergraph) 로 정의된다. 아크를 사용하여 두 노드 사이를 연결하는 것 대신에 부모 노드와 후계 노드들의 집합 사이를 연결하기 위해 하이퍼 아크 (hyper arc) 를 둔다. 이러한 하이퍼 아크를 연결자 (connector) 라 부른다. k-연결자란 의미는 부모 노드로부터 k 개 후계 노드의 집합으로 연결된 것을 의미한다.
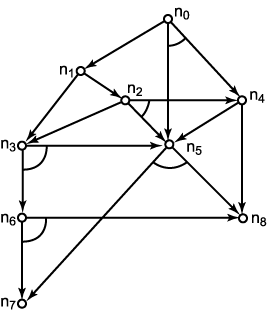
그림 13 AND/OR 그래프
그림 13 은 AND/OR
그래프의 한 예를 보여 준다. 여기서 살펴보면, 노드  는 후계 노드
 으로 1-연결자를 가지며, 후계 노드 집합
 로 2-연결자를 가진다. k 가 1 보다 큰 수일 경우의 k-연결자의 표시는 그림
13 에서 보듯이 부모 노드로 k 개의 후계 노드 사이를 연결한 k 개의 아크를 곡선으로
모으는 표기를 사용한다. 그림 13 에서 노드
 는 노드
 의 AND 노드 집합이며, 노드
 은 노드
 의 OR 노드이다. 또한 노드
 을 노드
 에 대해서는 AND 노드 집합에 속하는 노드이며, 노드
 에 대해서는 OR 노드가 된다.
AND/OR 그래프에서는 각 노드 (루트 노드는 제외) 는 적어도 하나의 부모 노드를 가진다. 그래프에서 후계 노드를 가지지 않는 노드를 잎 노드 (leaf node) 라 한다 (트리에서는 끝단 노드 (tip node) 라 했음).
가분해 생성 시스템은 AND/OR 그래프를 암시하고 있다. 초기 데이터베이스는 그래프에서 시작 노드에 해당된다. 만일 시작 노드의 데이터베이스가 분해될 수 있다면 시작 노드에서 후계 노드로 이루어진 집합으로 하나의 연결자가 생긴다. 여기서의 각 후계 노드가 지니는 데이터베이스는 시작 노드의 데이터베이스의 한 구성요소들이다. 연결자가 생기는 것은 생성규칙의 적용에 의한다. 연결자에 의해 가리켜진 노드가 지닌 데이터베이스란 규칙 적용과 분해에 의해 유도되어진 것이다. 암시적 그래프에는 생성 시스템의 종결조건을 만족시키는 데이터베이스를 지닌 종결 노드 집합이 있다. 여기서 생성 시스템이 하는 작업이란 시작 노드에서 종결 노드 집합 (이 집합을 N 이라 하겠음) 에 이르는 해결 그래프 (solution graph) 를 유도하는 것이다.
AND/OR 그래프에서
해결 그래프는 보통 그래프에서 해결경로에 비유된다. 이 해결 그래프의 유도는 먼저 노드
n 에서 시작하여 연결자를 선택하게 된다. 그 다음 연결자가 가리키는 후계 노드에서
다시 연결자를 선택하게 된다. 그 다음 연결자가 가리키는 후계 노드에서 다시 연결자를
선택하는 과정을 반복 수행하여 결국 생성된 모든 후계 노드가 집합 N 의 요소이면
종결된다. 암시적 AND/OR 그래프가 그림 13 과 같은 상황에서 노드  에서
 에 이르는 두 가지 해결 그래프가 그림 14 에 보여진다.
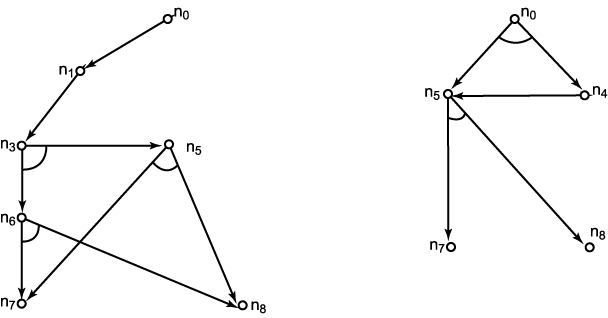
그림 14 두 가지 해결 그래프
여기서는 AND/OR 그래프는 어떠한 사이클 (cycle) 도 가지지 않는다고 가정한다. 즉, 그래프에서 어떤 노드의 한 후계 노드가 또한 조상 노드가 되는 그러한 노드는 없다는 것이다. 그러므로 노드들은 부분적 순서를 형성하게 되어 순환적 프로시쥬어 (뒤에 제시됨) 가 언젠가는 종결된다는 보장을 하게 된다.
AND/OR 그래프 G 에서, 노드 n 에서 종결 노드 집합 N 에 이르는 해결 그래프를 G' 라 표시한다. G' 는 G 의 부속 그래프가 된다.
만일 n 이 N 에 포함된
노드이면, G' 는 한 개의 노드 n 만으로 구성된다. 그렇지 않고, 만일 n 에서 노드
집합  로 향한 k-연결자가 존재하고 각 노드
 에서 N 에 이르는 해결 그래프가 존재한다면, G' 는 노드 n 와 k-연결자와 노드
집합
 와
 의 각 노드에서 N 에 이르는 해결 그래프들도 구성된다. 만일 위의 경우에도
해당하지 않으면 n 에서 N 으로의 해결 그래프는 존재하지 않는다.
보통 그래프에서 아크 비용을 사용한 것과 비슷하게 AND/OR 그래프에서는 연결자에 비용이 주어진다 (이 비용은 규칙적용비용을 의미하여 어떤 작은 크기의 양의 실수보다 항상 크다고 가정한다). 그러면 연결자 비용을 사용해서 해결 그래프의 비용을 계산할 수 있다. 어떤 노드 n 에서 N 에 이르는 해결 그래프의 비용을 k(n, N) 으로 표현하자. 그러면 k(n, N) 은 다음과 같이 순환적으로 계산되어진다 :
만일 n 이 N 에 포함된 노드이면,
k(n, N) = 0
그렇지 않으면, n 은
해결 그래프에서 후계 노드 집합  에 연결된 연결자를 가진다. 이 연결자의 비용을
 이라 하면,

이와 같이 n 에서 N 까지의 해결 그래프 G' 의 비용은, G' 에 있는 n 에서 나가는 연결자의 비용과 이 연결자에 있는 후계 노드들 (G' 에 있는) 의 해결 그래프들의 비용 합계를 합한 값이 된다. 이런 순환적인 정의는 그래프가 사이클을 가지지 않는다고 가정했기 때문에 만족된다고 하겠다.
해결 그래프의 비용에 대한 위의 정의는 해결 그래프에서의 어떤 연결자의 비용이 한번 이상 계산되는 수도 있다. 일반적으로, n 에서 N 까지의 해결 그래프의 비용을 계산하는데 있어, 해결 그래프상의 노드 m 으로부터 나가는 연결자의 비용을 n 에서 m 까지 이르는 경로수 만큼 계산한다. 그래서 그림 14 의 경우 해결 그래프의 비용은 각각 8 과 7 이 된다 (여기서 각 k-연결자의 비용은 k 임).
시작 노드에서 N 에서 이르는 해결 그래프를 단순히 찾고자 하는 것이 아니라 가장 적은 비용을 가지는 해결 그래프를 찾고자 할 경우가 있다. 이러한 해결 그래프를 최적 (optimal) 해결 그래프라 한다. n 으로부터 종결 노드 집합 N 에 이르는 최적 해결 그래프는 함수 h*(n) 으로 표현한다.
보통의 그래프에서 행한 것처럼, 해결 그래프를 구하기 위해 암시된 AND/OR 그래프 탐색을 위해 나비-우선 탐색 알고리즘이 제시될 수 있다. 그러나 나비-우선 방식은 문제영역에 대한 정보를 제공받은 탐색방법이 아니기 때문에 인공지능 응용에 썩 좋은 효과를 거둘 수 없다. 그러므로 휴우리스틱 요소를 지닌 평가함수를 이용한 어떤 다른 탐색방법이 AND/OR 그래프에서도 제시될 수 있을지 묻는 것은 당연하다 하겠다.
여기서는 노드 n 에서 종결 노드 집합에 이르는 최적 해결 그래프의 비용인 h*(n) 에 대한 측정값으로 휴우리스틱 함수 h(n) 을 사용한 탐색방법을 서술하기로 한다. GRAPHSEARCH 에서처럼, 설명될 탐색 알고리즘은 h 가 어떤 제한조건을 만족한다면 간단하게 표현될 수 있다.
h 에 대한 단조 제한을
가정하자. 즉, 노드 n 에서 후계 노드 집합  에 연결되는, 암시적 그래프에 나타날 수 있는 모든 연결자에 대해 다음이 만족된다고
하자 :

여기서 c 는 연결자의 비용이다. 위의 제한은 보통 그래프에서의 휴우리스틱 함수에 대한 단조 제한과 유사하다. 만일 종결 노드 집합에 있는 모든 노드 n 에 대해 h(n) = 0 가 성립한다면 위의 단조 제한에 의해 h 는 h* 보다 항상 크지 않은 값을 가지게 된다 (즉 모든 노드 n 에 대해 h(n) ≤ h*(n) 이 성립한다).
AND/OR 그래프에 대한 휴우리스틱 탐색과정은 다음과 같이 표현된다.
|
AO*-알고리즘 1.
시작 노드 s 만으로 구성되는 탐색 그래프 G 를 만든다. 2. s 가 SOLVED 로 명칭이 붙여질 때까지 단계 3 에서 단계 14 를 반복 수행한다. 3. begin 4. 노드 s 로부터 그래프 G 에서 표시된 (marked) 연결자를 따라 그래프 G 의 부분해결 그래프 G' 를 계산한다 (G 의 연결자가 표시되는 것은 아래의 단계에서 이루어진다). 5.
G' 로부터 종결 노드가 아닌 잎 노드 n 을 선택한다. 6.
노드 n 을 확장하여 이것의 모든 후계 노드를 생성하고 G 에 이것들을
배열한다. G 에 아직 나타나지 않은 각 후계 노드 7. 노드 n 만이 포함된 노드 집합 S 를 만든다. 8. S 가 빈 (empty) 상태가 될 때까지 단계 9 에서 단계 13 을 반복 수행한다. 9. begin 10. S 에 속해 있는 노드로써 이것의 어떤 자손 노드도 G 에 나타나지 않는 노드 m 을 S 로부터 제거한다. 11.
m 에 연관된 비용 q(m) 을 다음과 같이 조정한다 : 12. 만일 m 이 SOLVED 라 명칭이 붙어있거나 m 의 수정된 비용이 전의 비용과 다른 값이면 표시된 연결자에 대해서 m 을 후계 노드로 가지는 모든 부모 노드들을 집합 S 에 첨가시킨다. 13. end 14. end |
위의 AO*-알고리즘은 다음의 두 가지 주된 수행의 반복에 의해 쉽게 이해될 수 있다 : 첫번째, 위에서 아래로 오면서 (top-down), 그래프를 키워가는 수행으로 단계 4 ~ 단계 6 에 해당된다. 이 수행은 표시된 연결자들을 추적해 내려가면서 가장 유망한 부분적 해결 그래프를 구한다. 이와 같이 전에 계산된 표시들은 탐색 그래프에서 각 노드로부터 현재까지의 가장 유망한 부분적 해결 그래프를 나타낸다 (알고리즘이 완전히 종결되기 전에는 유망한 부분적 해결 그래프는 종결 노드를 가지지 않으므로 이러한 의미에서 부분적 해결 그래프라 한다). 이런 부분적 해결 그래프의 종결 노드 아닌 잎 노드들 중의 하나가 이제 확장되어 이것의 후계 노드들에 비용이 배정된다.
두 번째, 아래에서 위로 오면서 (bottom-up), 비용을 조정하고, 연결자를 표시하고, SOLVED 명칭을 붙이는 수행으로 단계 7 ~ 단계 12 에 해당된다. 방금 확장된 노드에서 시작하여 이 노드의 후계 노드들에 새로이 계산된 비용들을 이용하여 이 노드의 비용을 조정하고 종결 노드에 이르는 가장 유망하다고 기대되는 경로로 가는 연결자를 표시하게 된다 (단계 11). 이렇게 수정된 비용은 그래프를 따라 위쪽으로 영향을 미치게 된다. 수정된 비용 q(n) 이란 노드 n 에서 종결 노드까지의 최적해결경로의 비용에 대한 수정된 측정값이다. 비용 수정은 수정된 비용을 가진 노드의 조상 노드들에 대해서만 비용 수정을 가질 수 있으므로 이것들만 고려하면 된다. h 에 대한 단조 제한을 가정했으므로 비용은 조정과정에서 계속 증가하게 된다. 그러므로 모든 조상 노드들에 대해서가 아니라, 비용 수정을 행한 자손 노드들을 가지는 현재의 부분 해결 그래프에 있는 조상 노드들만 고려하면 된다 (단계 12).
AND/OR 그래프가 AND/OR 트리이면 각 노드는 하나의 부모 노드만 가지기 때문에 위의 두 번째 수행은 약간 간단해진다.
AO*-알고리즘의 복잡성을 덜기 위해서 후계 노드를 생성하지 못하는 노드가 확장을 위해 선택되는 가능성은 무시한다 (단계 6). 이러한 경우는 후계 노드를 생성하지 못하는 노드 m 에 대해 아주 높은 q(m) 값을 배정함에 의해 해결될 수 있다 (좀더 일반화시키면 이러한 노드를 어떠한 부분적 해결 그래프에도 포함시키지 않으면 된다). 두번째 수행인 아래에서 위로의 q 값 조정에서 이 높은 q(m) 값의 영향은 이 노드를 가지는 그래프가 가장 유망하다고 기대된 해결 그래프로 설정될 가능성을 제거하게 된다.
어떤 노드 n 이 암시적 AND/OR 그래프에서 유한 개의 자손 노드를 가지고 있으며 이것들이 n 에서 종결 노드까지의 해결 그래프를 포함하지 못한다고 가정하자. 그러면 결국에는 수정된 비용 q(n) 은 매우 높은 값이 될 것이다. 그러므로 시작 노드 s 에 매우 높은 값이 배정된다는 것은 시작 노드로부터의 해결 그래프가 존재하지 않는다는 표시로 이해할 수 있다.
만일 시작 노드 n 에서 종결 노드의 집합에 이르는 해결 그래프가 존재하고, 모든 노드 n 에 대해 h(n) ≤ h*(n) 이 성립되며 h 가 단조 제한을 만족한다고 하면 AO*-알고리즘은 최적의 해결 그래프를 유도하게 된다는 사실을 증명할 수 있다 (이 최적해결 그래프는 s 에서 시작해 종결 노드까지 표시된 연결자들을 따라감에 의해 나타난다). 그러므로 이러한 제한조건하에서 AO*-알고리즘은 허용성을 가진다. 이에 대한 증명은 생략하기로 하며 자세한 것은 [Martelli and Montanari 73] 을 참조하기 바란다.
h = 0 을 사용해서 AO* 로부터 나비-우선 알고리즘을 얻을 수 있다. 이러한 h 선정은 항상 h* 보다 작은 값이므로 이 나비-우선 알고리즘은 허용성을 가진다.
AO* 을 사용한 예로써 그림 13 의 그래프를 살펴보자. 먼저 이 그래프의 노드에 대해 다음과 같이 h 값이 주어진다고 가정하자 :

노드  은 모두 종결 노드이며 각 k-연결자의 비용은 k 이다. 여기서 보면 함수 h 는
항상 h* 보다 작은 값을 가지며 단조 제한을 만족시키고 있다.
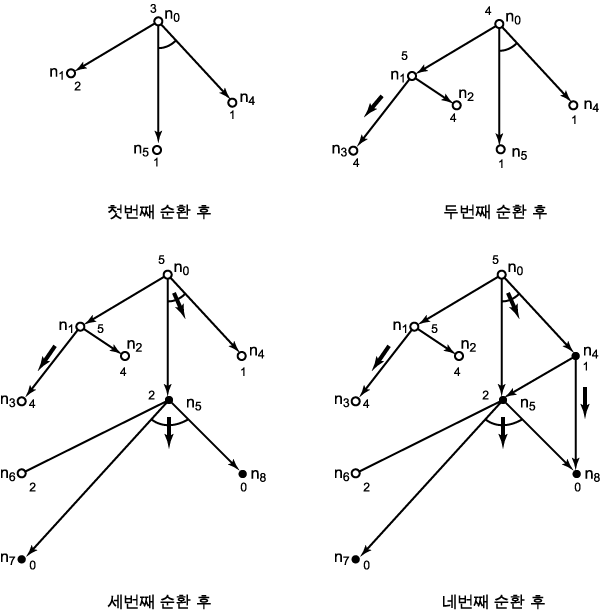
그림 15 AO* 의 각 순환단계에서의 탐색 그래프들
AO*-알고리즘의
바깥 순환을 매 번 돌 때마다 나타난 탐색 그래프가 그림 15 에 보여진다. 각 그래프에서
수정된 q 값이 노드 옆에 나타나 있으며, 굵은 화살표는 연결자에 표시를 붙인 것이며,
SOLVED 명칭이 붙여질 노드는 까만 원으로 표시되어 있다. 첫번째 순환 동안 노드
 가 확장되며, 다음에
 , 다음에
 가, 다음에
 , 다음에
 가 SOLVED 라 명칭이 붙여졌다. 최적비용 5 를 가지는 해결 그래프는 표시된
연결자를 추적함에 의해 구해진다.
AO*-알고리즘에서 유망하다고 기여된 부분적 해결 그래프의 어느 잎 노드를 선택하여 확장할 것인지를 아직 설명하지 않았다 (단계 5 에서). 아마도 가장 좋은 부분적 해결 그래프의 평가에 변화를 가장 많이 줄 수 있다고 생각되자 잎 노드를 선정하는 것이 효율적이다. 만일 가장 좋은 해결 그래프에 대한 평가가 결과 변화되지 않는다면 AO* 는 이 그래프의 모든 잎 노드를 언젠가는 확장시키게 된다. 그러나 만일 그 평가가 변화되어 더 최적에 가까운 해결 그래프를 유도하는 방향으로 진행되면 AO* 는 이러한 변화를 빨리하면 할수록 더 효율적이 된다. 아마도 가장 큰 h 값을 가지는 잎 노드 (부분적 해결 그래프에서) 을 확장하면 이 부분적 해결 그래프에 변화를 오게 할 수 있는 가능성이 가장 많다고 하겠다 (생성된 후계 노드들의 h 에 의해 부분적 해결 그래프에 영향을 줄 가능성이 많음을 의미한다).
A 와 A*-알고리즘과 마찬가지로 AO*-알고리즘도 특별한 상황에 보다 잘 응용되도록 다양한 형태로 변화를 줄 수 있다. 첫째로, 매 번 노드 확장이 이루어질 때 마다 부분적 해결 그래프를 다시 조정해 만들기 보다 하나 이상의 여러 자손 노드를 연속해서 확장하고 난 후에 부분적 해결 그래프를 조정할 수도 있다. 이러한 방법은 아래에서 위로 수행하는 반복되는 부담을 줄일 수 있는 반면에 어떤 노드의 확장이 가장 좋은 해결 그래프 상에 놓여 있지 않을 위험도 내포한다.
둘째로, AND/OR 그래프에 단계적 탐색방법이 적용될 수 있다. 이것은 AND/OR 탐색 그래프들 중 일부를 제거함으로써 필요한 기억공간을 주기적으로 확보하는 일이 필요하다. 예를 들어 전체 탐색 그래프 내에서 아주 큰 평가비용을 가지는 부분적 해결 그래프들 일부를 결정할 수 있으며, 주기적으로 이러한 부분적 해결 그래프들을 제거하면 된다 (물론 실제로 가장 최적인 해결 그래프에 속해진 것을 제거해 버릴 위험성도 가지고 있다).
3 장에서 전향과 후향, 어느 방향으로도 수행이 될 수 있는 생성 시스템에 의해 풀려질 수 있는 문제 종류에 대해 언급하였다. 여기서는 가환 전향 시스템과 가분해 후향 시스템 사이의 관계를 살펴 보고자 한다 (전향과 후진이란 용어를 두 시스템에 대해 서로 바꾸어도 무관하다).
어떤 생성 시스템이 존재하여 아래와 같은 재표기 (rewrite) 규칙들을 가진다고 가정한다.
R1
: T → A, B
R2 : T → B, C
R3
: A → D
R4 : B → E, F
R5
: B → G
R6 : C → G
이들 규칙들은 문자열 (string) 로 구성된 전체 데이터베이스에 적용되게 된다. 한 규칙이 적용가능하다 하는 것은 이 규칙의 왼쪽에 있는 심볼이 전체 데이터베이스에 나타나 있는 경우이며, 실제로 이 규칙의 적용은 전체 데이터베이스에 나타나는 이 심볼을 규칙의 오른쪽에 있는 심볼 (들) 로 대치하는 것을 말한다.
위의 규칙들처럼 규칙 왼쪽이 하나의 심볼인 재표기규칙을 사용하는 생성 시스템은 가분해 (decomposable) 시스템이다. 심볼 T 만으로 이루어진 초기 데이터베이스에 위의 재표기규칙들을 적용해서 나타나는 한 AND/OR 그래프가 그림 16 에 보여진다.
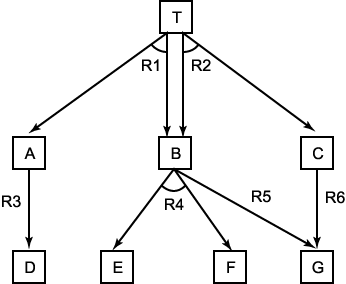
그림 16 탐색 그래프
이들 규칙을 반대방향으로 이용할 수 있는 방법이 있다. 즉, 전체 데이터베이스가 한 규칙의 오른쪽에 있는 심볼 (들) 을 모두 가지고 있다면 이 규칙의 왼쪽에 있는 심볼을 전체 데이터베이스에 첨가시키는 것이다. 그림 17 에서 {D, E, F, G} 로 구성된 초기 데이터베이스에 규칙들의 반대방향으로의 적용이 이루어진 한 예를 볼 수 있다 (여기서 규칙 R 의 반대방향 적용은 R' 로 표현됨).
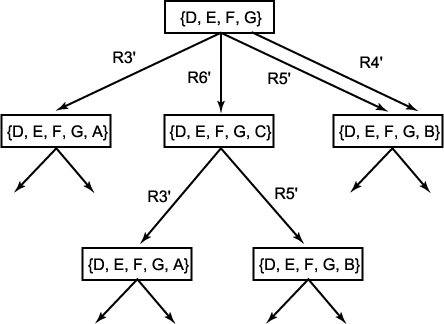
그림 17 반대방향으로의 적용
이와 같이 반대방향으로도 재표기규칙들을 적용하여 나타날 수 있는 생성 시스템은 가환 (commutative) 생성 시스템이다. 그러므로 여기에 과정 회복 불가능한 (irrevocable) 제어방법 (3 장에서 언급) 을 사용하여도 다른 어떤 가능한 규칙 적용을 막아 버리는 위험성을 가리지는 않는다.
만일 초기 데이터베이스
{D, E, F, G} 와 이것의 후속 데이터베이스들에 규칙  을 계속 적용하면, 결국 {D, E, F, G, A, B, C, T} 가 얻어진다. 이들 규칙 적용과
이 때마다 유도되는 전체 데이터베이스에 대한 추적은 유도 그래프 (derivation graph)
라 불리는 구조에 의해 이루어질 수 있다. 생성 시스템 수행의 각 단계에서의 유도
그래프란 이때까지 적용되어온 규칙들의 적용과정을 담은 전체 데이터베이스를 구축한
형태를 말한다.
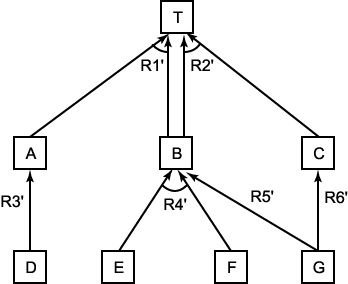
그림 18 유도 그래프
그림 18 은 위의 예에 대한 유도 그래프를 보여 준다. 전체 데이터베이스는 바로 이 유도 그래프이다. 그래프에 네모 칸에 들어 있는 심볼 표현이 유도되는 방법은 이것으로 향한 연결자에 붙은 반대방향 적용규칙에 의하게 된다.
연결자의 방향만 제외하면 그림 16 과 그림 18 은 동일한 구조가 된다. 관심을 가지는 많은 문제에는 가환 생성 시스템의 수행방향을 역으로 하면 가분해 생성 시스템이 얻어진다. 어떤 규칙들을 사용한 가환 시스템을 전향 시스템이라 하고, 이 규칙들의 반대방향을 사용한 가분해 시스템을 후향 시스템이라고 흔히 부른다.
이런 종류의 가환 생성 시스템을 제어하기 위해 유도 그래프에 연관되는 평가함수를 사용할 수 있다. 한 유도 그래프에 어떤 규칙이 적용되면 새로운 노드가 하나 더 첨가되는 유도 그래프가 얻어진다. 그러므로 그림 18 에 T 라 명칭이 붙여진 노드는 규칙 R1' 에 의해 첨가된 것이다 (물론 규칙 R2' 에 의해서도). 유도 그래프의 비용은 적용된 규칙 자체의 비용에다가 이 규칙의 입력에 해당되는 노드들에 대한 최적비용 부속 유도 그래프들의 비용을 합계한 값이다. 이와같은 유도 그래프 비용 계산방법은 AND/OR 그래프 비용의 순환적 적용방법과 매우 유사하다.
한 유도 그래프의 비용은 가환 생성 시스템에서의 g 함수 계산으로 간주할 수 있다. 또한 유도 그래프들에 대해 휴우리스틱 함수 h 을 정의할 수 있다. 한 유도 그래프에 대한 h 란 이 유도 그래프와 여기에서 종결에 이르는 최적경로 상에 있는 자손 유도 그래프들에 적용되는 일련의 규칙에 대한 비용 합계의 측정값이 되어야 한다. 그러나 한 유도 그래프에는 적용가능한 규칙들이 여러 개 있을 수 있다. 그러므로 이 가운데 가장 유망한 규칙을 선택하기 위해서는 각 규칙에 대한 값으로 이 규칙이 적용된 후에 나타날 유도 그래프에 대한 휴우리스틱 함수로부터 얻어진 값을 사용한다 (구체적으로 실현될 휴우리스틱 함수는 문제영역에 대한 지식에 의해 구해짐). 그러면 이제 규칙들을 평가하기 위해 각 규칙에 대해 g 와 h 값을 더하여 f 값을 얻게 된다. 다음에 선택된 규칙이란 가장 작은 f 값을 가진 규칙이 된다.
이와 같이 과정 회복 불가능한 제어방법을 사용하는 가환 생성 시스템은 그래프 탐색에서 A-알고리즘에 의해 사용된 과정과 유사하게 수행된다. h 가 h* 보다 항상 작은 값을 가진다고 가정하면, 위의 방법에 의해서 최적비용의 유도 그래프로 유도할 수 있으며, 더 많은 정보를 제공받은 h 의 사용은 더 적은 수의 규칙 적용을 하게 됨을 보일 수 있다.
1. 다음과 같은 초기 모양을 가진 블럭 퍼즐에 대해 살펴보자 :
|
B |
B |
B |
W |
W |
W |
E |
여기에는 검은 타일 (B) 이 3 개, 하얀 타일 (W) 이 3 개, 빈 공간 (E) 이 한 칸 있으며 아래의 규칙에 의해 타일이 이동한다 :
(a)
타일은 1 의 비용을 들여 인접된 빈칸에 이동이 될 수 있다.
(b) 타일이 다른
타일을 뛰어넘어 빈칸에 갈 수 있는데 이때 뛰어넘어야 할 타일의 수는 최대로 2
개까지이며 비용은 뛰어 넘어야 할 타일의 수 (1 내지 2) 와 같다.
이 퍼즐의
목표는 3 개의 하얀 타일 모두가 3 개의 검은 타일 모두에 대해 왼편에 있도록 하는
것이다 (검은 타일의 위치에 대해서는 아무런 조건이 없음).
이 문제를 해결하기 위해 h 함수를 명시해보고 이를 이용해 A-알고리즘에 의한 탐색 트리를 보여라. 명시된 h 가 단조 제한을 만족하는지 말할 수 있겠는가? 탐색 트리에서 노드들에 대해 단조 제한이 만족되는가?
2. 제 3 장에서 언급한 판매사원의 방문문제에 대해 h 함수 (음의 값이 아닌) 를 두 가지 제시하여라. 이들은 모두 h* 보다 작은 값을 항상 가지는가? 어느 함수가 더 효율적이라고 생각하는가? 3 장에서의 5 개 도시를 가지는 판매사원의 방문문제에 이 함수들을 각기 사용한 A-알고리즘의 탐색 트리를 보여라.
3. GRAPH SEARCH 프로시쥬어에서 한 번에 하나의 후계 노드만 생성되도록 단계 6 을 수정하여라. 수정된 프로시쥬어는 두 가지 선택을 해야 한다 : 다음에 확장될 노드가 어느 것이며, 또 어느 후계 노드를 생성시킬 것인가 하는 선택 (: 생성 시스템을 제어하는 데 있어, 이 수정된 프로시쥬어는 하나의 데이터베이스와 이것에 적용할 한 개의 규칙을 선택한다).
4.
결과 3 을 이용해서 다음을 증명하여라 :
OPEN 에 있는 노드로써 f(n) < f*(s)
을 만족시키는 모든 노드 n 은 A* 에 의해 언젠가는 확장되기 위해 선택된다.
5. OPEN 에 있는 노드로써 f(n) > F (여기서 F 는 f*(s) 보다 큰 어떤 값이다) 을 만족시키는 ) 어떠한 노드도 언제나 OPEN 에서 제거되어도 A*-알고리즘은 여전히 허용성을 지니게 됨을 보여라.
6. 평가함수 f(n) = d(n) + W(n) (4-(2) 절에서 정의된) 을 사용해서 그림 7 에 나타난 목표 노드에서 시작하여 시작 노드에 이르도록 하는 탐색을 A-알고리즘을 이용해 수행시켜 보아라. 어느 지점에서 이 탐색 (후향) 과 그림 7 의 탐색 (전향) 이 마주치게 되는가?
7. h 함수가 탐색과정 동안에 향상되도록 할 수 있는 방안에 대해 논하라.
8. 다음의 재표기규칙들을 사용하여 규칙 왼편이 규칙 오른편으로 대치되게 할 수 있다 :
6
→ 3, 3 4 → 3, 1
6 → 4,
2 3 → 2, 1
4 → 2, 2 2
→ 1, 1
이
규칙들을 이용하여 숫자 6 을 1 로 구성된 스트링으로 변환시키는 문제를 생각한다.
이
문제를 풀기 위해서 AO* -알고리즘이 어떻게 수행되는지 묘사해보아라.
여기서의
가정은 k-연결자의 비용은 k 이며, 숫자가 1 이 붙은 노드에 대한 h 값은 0 이며
숫자가 n(n ≠ 1) 이 붙은 노드에 대한 h 값은 n 이다.
9. 이 장에서는 주로 과정 회복 가능한 제어방법 (역행 탐색과 그래프 탐색) 에 대해 다루었다 (가환 생성 시스템의 가정 회복, 불가능한 제어방법에 대한 탐색 방법에 대해 논하여라 (이것은 아마도 7-(3) 절에 근거를 둔다). 첨가하여, 휴우리스틱 요소를 지닌 평가함수를 사용하는 탐색 알고리즘을 구체적으로 제시하여라.
 에 대해 비용
 로 한다. 후계 노드들 중에 종결 노드인 것은 SOLVED 라 명칭이 붙여진다.
 로 연결되는 각 연결자에 대해

 값은 과거의 이 순환과정에서 계산되어졌거나, 단계 6 에서 계산되어졌다].