AI와 LLM(거대 언어 모델) 분야에서 부트스트래핑(Bootstrapping) 은 "외부의 거대한 도움이나 완벽한 초기 데이터 없이, 소량의 초기 자원과 모델 스스로의 출력을 활용하여 점진적으로 성능과 데이터를 확장해 나가는 자기 주도적 학습 및 개선 기법"을 의미합니다.
원래 부트스트래핑은 "자기 장화 끈을 잡아당겨 스스로 몸을 들어 올린다"는 뜻에서 유래한 컴퓨터 과학 및 통계학 용어입니다. AI 와 LLM 에서는 맥락에 따라 크게 3가지 핵심 영역에서 사용됩니다.
1. 데이터 생성 및 확장 (Self-Instruct / Synthetic Data)
초기 학습 데이터가 부족할 때, 사람이 직접 수만 개의 데이터를 만드는 대신 소량의 예시(Seed) 만으로 모델이 스스로 학습 데이터를 증식시키는 방식입니다.
- 작동 방식: 사람이 작성한 소량의 고품질 질문-답변 쌍(예: 100개) 을 LLM에 프롬프트로 제공합니다.
- 데이터 증식: LLM 이 이 예시를 참고해 유사하지만 새로운 질문과 답변을 수만 개 생성합니다.
- 재학습: 생성된 데이터 중 품질이 좋은 것만 필터링하여 다시 모델을 미세 조정(Fine-tuning) 합니다. 대표적인 예로 스탠퍼드 대학의 Alpaca 모델이나 Self-Instruct 기법이 있습니다.
2. 프롬프트 엔지니어링 및 추론 최적화 (DSPy 등)
프롬프트에 넣을 최적의 예시(Few-shot examples) 를 사람이 일일이 수작업으로 고르지 않고, 모델 스스로 찾아내어 프롬프트를 완성하는 기법입니다.
- 작동 방식: DSPy 같은 프레임워크에서는 초기 프롬프트와 소수의 검증 데이터만 주어집니다.
- 예시 자동 생성: LLM이 문제를 풀면서 올바른 추론 과정(Chain-of-Thought) 과 정답을 도출해 내면, 그 성공적인 추론 과정을 자동으로 수집합니다.
- 프롬프트 조립: 수집된 성공 사례들을 다음 추론 시 프롬프트의 예시(Few-shot) 로 자동 삽입하여 전체 파이프라인의 정확도를 스스로 끌어올립니다.
3. 모델 학습 및 강화학습 (Self-Play / RLAIF)
인간의 개입(RLHF) 을 최소화하고 모델이 스스로 평가하고 개선하며 성능을 높이는 학습 방식입니다.
- 작동 방식: 모델이 하나의 질문에 여러 개의 답변을 생성합니다.
- 자가 평가 및 보상: 다른 LLM이나 동일한 모델(LLM-as-a-Judge) 이 생성된 답변들의 순위를 매기고 피드백을 줍니다.
- 반복 개선: 더 높은 점수를 받은 답변을 학습 데이터로 삼아 모델을 업데이트하는 과정을 반복합니다(예: STaR - Self-Taught Reasoner, RLAIF).
요약 비교
| 구분 | 전통적 AI/LLM 개발 방식 | 부트스트래핑(Bootstrapping) 방식 |
|---|---|---|
| 데이터 확보 | 사람이 직접 대량의 데이터를 수집 및 라벨링 | 소량의 시드(Seed) 데이터로 AI가 대량 자동 생성 |
| 프롬프트 튜닝 | 개발자가 직접 예시를 작성하고 수정 | AI가 성공적인 추론 경로를 찾아 예시로 자동 구성 |
| 모델 개선 | 인간의 피드백(RLHF)에 크게 의존 | AI의 자가 평가 및 반복 학습(Self-Play) 활용 |
| 장점 | 초기 품질 통제가 명확함 | 시간과 비용을 획기적으로 절감하며 빠른 확장 가능 |
주의할 점 (한계)
부트스트래핑을 과도하게 반복하면 AI가 생성한 데이터의 오류나 편향이 다음 세대 모델에 누적되어 성능이 급격히 저하되는 모델 붕괴(Model Collapse) 현상이 발생할 수 있습니다. 따라서 중간 단계에서 고품질 데이터를 걸러내는 필터링(Verification) 과정이 매우 중요합니다.
Bootstrapping의 어원과 고전적 의미
bootstrap 은 '자기 스스로 하는', '자력으로 성공하다', '자주 독립' 이라는 뜻이 있다. AI 시스템에서는 스스로 생각하여서 더 높은 수준의 지능으로 그 자신의 능력을 향상시키는 것의 의미로 사용된다.
Wikipedia : Bootstrapping
Bootstrapping 은 어떤 시스템이 이미 가지고 있는 기능이 없는 상태에서 그 시스템을 작동시키는 것이다. 독일 소설가 Baron Münchhausen 의 소설에서처럼 bootstrap 에 의해 스스로를 부추기는 것은 불가능한 것처럼 보인다. 그러나 bootstrapping 이라는 해결책은, 복잡한 시스템이 단순하게 작동할 때, 조금씩 더 단순한 것으로 더 복잡한 능력을 개발할 수 있도록 하는 과정이다.
컴퓨터공학에서의 Bootstrapping
컴퓨터에서 bootstrapping 은 어떤 컴퓨터를 시작시키는 과정으로 booting 보다 더 오래된 개념이다. Bootstrapping 은 또한 성공적으로 더 복잡한 프로그래밍 환경의 개발을 의미하기도 한다. 가장 간단한 환경은 매우 기본적인 텍스트 편집기와 어셈블리 프로그램일 것이다. 이러한 툴을 사용해서 더 복잡한 텍스트 편집기를 작성하고, 고급언어용의 간단한 컴파일러를 작성하고, 결국에는 그래픽 통합개발환경 (IDE) 과 극도의 고급 프로그램 언어를 가지게 될 것이다.
언어학에서의 Syntactic Bootstrapping
언어학에서의 syntactic bootstrapping 은, 어린이가 단어의 뜻을 배우는데 도움이 되도록 개발된 문법적 지식을 사용하는 것을 의미한다. 즉 의미 (semantics) 는 문법의 정점 (top of syntax)에서 구축된다는 것이다.
부트스트래핑 : Douglas R. Hofstadter
컴파일러들이 더욱 정교해짐에 따라서 사람들은 컴파일러 자체의 확장을 위하여 부분적으로 쓰인 컴파일러를 사용할 수 있다고 생각하게 되었다. 다른 말로 하자면, 일단 최소한의 핵심 컴파일러가 쓰여지면, 그 미니 컴파일러는 (자기 입장에서 보면 다시 훨씬 더 큰 컴파일러들을 번역할 수 있고 최종적으로 완성된 컴파일러를 만드는) 더 큰 컴파일러들을 기계언어로 번역할 수 있다. 이런 과정을 사람들은 [자주독립에 맞먹는] "부트스트래핑" 이라고 부른다. 이런 상황은 모국어의 유창한 습득에 임박한 결정적인 시점에 도달한 아이의 상황과 다를 게 없다 : 그 시점에서부터 아이는 새로운 언어를 습득하기 위하여 언어를 더욱 많이 쓰는 가운데, 어휘와 언어 숙련도를 급성장시킨다.
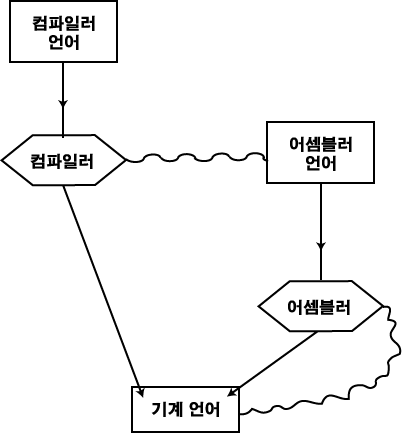
물론 그 자체가 하나의 프로그램이기도 한 컴파일러는 일정한 언어로 쓰여야 한다. 최초의 컴파일러들은 기계언어라기보다는 어셈블리 언어로 쓰였다. 그래서 기계언어로부터 진일보한 초기의 이점들을 최대한 활용했다. 이러한 교묘한 관계가 그림에 요약되었다. 어셈블러와 컴파일러는 둘 다 기계언어로의 번역장치이다. 직선으로 된 화살표가 그것을 말한다. 뿐만 아니라, 그것들은 그 자체가 프로그램이기 때문에, 원래는 언어로 쓰였다. 파동형으로 된 줄은 컴파일러가 어셈블리 언어로 쓰일 수 있으며 어셈블러는 기계언어로 쓰일 수 있다는 것을 나타낸다.
관련 연구 사이트 (Original Link)
site : Bootstrapping Research : Univ. of Washington
AI와 LLM 시대의 Bootstrapping 개념과 작동 방식
생성형 AI와 거대언어모델(LLM) 시대에서 Bootstrapping은 단순한 시스템 초기화를 넘어, 모델이 스스로 학습 데이터·추론 경로·평가 신호를 생성하고 검증하여 다음 세대의 더 똑똑한 모델로 진화하는 자기강화(Self-Improvement) 메커니즘을 뜻합니다. 인간이 모든 정답과 추론 과정을 일일이 작성하지 않아도, 초기 시드(Seed) 모델과 자동 검증기(Verifier)의 결합만으로 지능의 계단을 밟고 올라가는 원리입니다.
초기 정책 모델 (Seed)
기초 사전학습과 소량의 고품질 인간 시범 데이터(SFT)로 최소한의 문제 해결 및 추론 능력을 갖춘 모델 M0을 준비합니다.
다중 경로 롤아웃 (Rollout)
모델이 주어진 문제에 대해 여러 갈래의 사고 과정(Chain-of-Thought), 코드, 에이전트 행동 궤적을 스스로 대량 생성(Sampling/MCTS)합니다.
자동 검증기 (Verifier)
단위 테스트, 컴파일러, 수학 정답 비교, 형식 증명기(Lean), 또는 보상 모델(RM)을 통해 올바른 출력과 고품질 추론만 선별합니다.
재학습 및 세대 진화
선별된 합성 궤적으로 SFT·DPO·강화학습(RL)을 수행해 상위 모델 M1을 만들고, M1이 다시 더 어려운 문제를 풀어 M2로 진화합니다.
현대 AI·LLM을 움직이는 5대 Bootstrapping 메커니즘
1. STaR (Self-Taught Reasoner) & 추론 트레이스 부트스트래핑
모델이 스스로 문제 풀이 과정(CoT)을 생성하고, 정답을 맞힌 추론 과정만 학습 데이터로 채택합니다. 틀린 문제에 대해서는 정답 힌트를 주어 올바른 추론을 역추적(Rationalization)하게 한 뒤 다시 학습시킴으로써 추론 능력을 계단식으로 끌어올립니다.
2. Self-Play & RLVR (검증 가능한 보상 기반 강화학습)
AlphaZero가 바둑 자가 대국으로 초인적 기보에 도달했듯, OpenAI o1이나 DeepSeek-R1 계열 모델은 수학·코딩처럼 정답을 객관적으로 검증할 수 있는 환경에서 스스로 시행착오를 반복하며 검증·반성·수정하는 긴 사고(Long CoT) 전략을 자생적으로 습득합니다.
3. Constitutional AI & RLAIF (AI 피드백 기반 정렬)
인간 평가자(RLHF) 대신 사전에 정의된 헌법(원칙)에 따라 LLM이 자신의 답변을 스스로 비평(Critique)하고 수정(Revision)한 뒤, 생성된 쌍별 선호 데이터를 바탕으로 자체 보상 모델과 정렬 정책을 부트스트래핑합니다.
4. 약한 감독에서 강한 지능으로 (Weak-to-Strong & ReSTEM)
불완전하거나 작은 모델의 피드백, 혹은 단순한 규칙 검증기만으로도 거대 사전학습 모델이 잠재된 고차원 능력을 스스로 끌어내는 기법입니다. ReSTEM(Reinforced Self-Training)처럼 Expectation-Maximization 구조로 생성(E-step)과 개선(M-step)을 반복합니다.
5. 에이전트 환경 상호작용 부트스트래핑 (Agentic & Tool-Use Loop)
모델이 터미널, 파이썬 인터프리터, SQL 엔진, 웹 브라우저 등 실제 실행 환경과 상호작용하면서 실패 로그를 보고 코드를 수정해 과제를 완수합니다. 성공한 전체 도구 호출 궤적(Trajectory)이 그대로 차세대 에이전트의 고품질 학습 데이터로 환류됩니다.
기존 AI·LLM 개발 방식 vs. Bootstrapping 개발 방식
기존 LLM 개발이 "인간이 만든 웹 텍스트를 긁어모아 한 번에 크게 학습(Static Pre-training + Human Labeling)"하는 방식이었다면, Bootstrapping 개발 방식은 "모델이 추론·실행·검증을 통해 스스로 데이터를 생산하고 세대별로 진화(Dynamic Closed-Loop Flywheel)"하는 방식입니다.
| 비교 기준 | 기존 AI · LLM 개발 방식 | Bootstrapping 개발 방식 |
|---|---|---|
| 데이터 원천 | 웹 크롤링 코퍼스, 인간 전문가의 수작업 라벨링 및 SFT/RLHF 주석 데이터 | 모델 자가 생성 합성 데이터, 탐색 궤적(CoT/MCTS), 환경 실행 결과 및 검증 통과 샘플 |
| 확장 병목 (Bottleneck) | 고품질 인간 텍스트 고갈(Data Wall) 및 전문가 인건비·시간의 선형적 증가 | 추론 연산량(Inference Compute)과 자동 검증기(Verifier) 설계 가능 여부가 핵심 병목 |
| 학습 구조 | 선형 파이프라인 (사전학습 ➔ 1회성 SFT ➔ 인간 피드백 RLHF) | 폐루프 반복 사이클 (생성 ➔ 검증 ➔ 선별 ➔ 재학습 M0 → M1 → M2) |
| 성능 상한선 | 인간 데이터 평균 수준의 모방(Imitation)에 수렴하기 쉬움 | 검증 가능한 영역에서는 탐색과 보상을 통해 인간 평균을 넘어서는 전략 발견 가능 |
| 주요 리스크 | 인간 라벨러 간 일관성 부족, 웹 데이터의 편향·저작권·노이즈 | 모델 붕괴(Model Collapse), 보상 해킹(Reward Hacking), 검증 사각지대 편향 증폭 |
| 대표 사례 | 초기 GPT-3, InstructGPT, 표준 지도학습 기반 파인튜닝 파이프라인 | STaR, ReSTEM, Constitutional AI, DeepSeek-R1, AlphaProof, DSPy |
LLM 시대 Bootstrapping의 구조, 한계와 미래
인포그래픽 ① : LLM 자기강화 Bootstrapping 폐루프 아키텍처
시드 모델이 다중 추론 경로를 생성하고, 결정론적 검증기·보상 모델·실제 데이터 앵커(Grounding Anchor)를 거쳐 모델 붕괴 없이 상위 세대 모델로 진화하는 전체 구조입니다.
인포그래픽 ② : 검증 유무에 따른 성능 궤적과 Model Collapse 비교
동일한 반복 세대(Iteration)를 거치더라도, 엄격한 외부 검증기(Verifier)와 실제 데이터 앵커가 있을 때는 성능이 우상향하는 반면, 검증 없는 순수 자가 학습에서는 세대가 지날수록 다양성과 정확도가 붕괴(Collapse)합니다.
Deep Research ① : Bootstrapping의 4대 근본 한계
- 1) 모델 붕괴 (Model Collapse, Shumailov et al., Nature 2024): 모델이 자신의 출력물만으로 재학습을 반복하면 확률 분포의 양 끝단(희귀하지만 중요한 지식·창의적 표현)이 점차 잘려 나갑니다. 예를 들어 초기 세대에 5% 비중이던 소수 패턴이 5~10세대를 거치며 0.1% 미만으로 소실되어, 결국 단조롭고 좁은 출력만 뱉어내는 퇴행 현상이 나타납니다.
- 2) 검증 격차 (Verification Gap): 컴파일러나 단위 테스트가 존재하는 코딩, 정답이 명확한 수학 영역에서는 부트스트래핑이 압도적으로 강합니다. 반면 개방형 글쓰기, 비즈니스 전략, 윤리적 판단, 미개척 과학 가설처럼 '객관적 자동 검증기'를 만들기 어려운 영역에서는 자기 증강이 쉽게 정체됩니다.
- 3) 보상 해킹 (Reward Hacking) & 사양 게이밍: 불완전한 보상 모델(RM)을 검증기로 사용할 경우, 모델이 실제 문제 해결 능력 대신 '장황하게 설명하기', '테스트 케이스 하드코딩하기' 같은 편법으로 높은 보상만 챙기는 현상이 발생합니다.
- 4) 추론 연산 비용 폭증 (Inference Compute Overhead): 1개의 검증된 고품질 궤적을 얻기 위해 32개~256개의 후보(Best-of-N)를 생성하고 샌드박스에서 실행·검증해야 하므로, 학습 파이프라인 자체의 GPU 추론 비용이 크게 증가합니다.
Deep Research ② : 차세대 Bootstrapping의 미래 방향
- 1) 형식 검증(Formal Verification)과의 융합: 자연어 추론을 Lean 4 같은 수학 증명 보조기, SMT 솔버, 정적 분석기와 연결해 환각(Hallucination)이 물리적으로 통과할 수 없는 엄밀한 부트스트래핑 루프가 과학·공학·보안 분야로 확산되고 있습니다.
- 2) 출제자-풀이자의 공진화 (Proposer-Solver Co-Evolution): 정해진 문제집이 바닥나지 않도록, 모델 스스로 현재 수준보다 살짝 어려운 새로운 문제를 합성하는 '출제자(Proposer)'와 이를 푸는 '풀이자(Solver)'가 커리큘럼을 자동 생성하며 함께 진화합니다.
- 3) 경험의 시대 (Era of Experience & Embodied Sandbox): 정적 텍스트를 넘어 실제 운영체제, 클라우드 인프라, 웹, 로봇 물리 시뮬레이터 속에서 에이전트가 직접 행동하고 환경의 물리적·논리적 결과로부터 학습하는 경험 기반 부트스트래핑으로 발전하고 있습니다.
- 4) 온디바이스·소형 모델의 초전문화 (Distilled Bootstrapping): 거대 모델이 수천 번의 탐색으로 찾아낸 최적의 사고 과정을 검증·압축해, 7B~14B 크기의 경량 모델에 이식함으로써 저비용·고성능 특화 모델을 빠르게 구축하는 흐름이 가속화되고 있습니다.
AI 개발자는 LLM 시대 Bootstrapping을 어떻게 활용할 수 있는가?
프론티어 AI 연구소처럼 수만 장의 GPU로 기초 모델을 학습하지 않더라도, 실무 AI 개발자와 엔지니어는 프롬프트·에이전트·도메인 특화 파인튜닝 단계에서 Bootstrapping 원리를 즉시 적용하여 압도적인 비용 절감과 정확도 향상을 달성할 수 있습니다.
결정론적 검증기 기반 Rejection Sampling
사내 SQL 생성, API 호출, 코드 리팩토링 작업에서 LLM이 5~10개의 후보를 생성하게 한 뒤, 실제 DB 드라이런·JSON 스키마 검증·단위 테스트를 통과한 결과만 수집해 SFT/DPO 학습셋으로 축적하세요.
프롬프트 · Few-Shot 부트스트래핑 (DSPy)
모델 가중치를 바꾸지 않고도, 소량의 입력-정답 예시와 평가 지표만으로 에이전트가 스스로 성공적인 추론 데모(Few-shot Examples)를 생성·선별해 프롬프트 파이프라인을 자동 컴파일·개선할 수 있습니다.
프론티어 ➔ 경량 모델 증류 (Distillation)
고성능 대형 모델(Teacher)이 검증기를 통과하며 만들어낸 고품질 추론 궤적을 수집한 뒤, 사내 로컬·저비용 소형 모델(Student)에 파인튜닝하면 응답 속도와 비용을 획기적으로 낮출 수 있습니다.
실패 로그 기반 엣지 케이스 증강
프로덕션에서 에이전트가 실패한 실제 로그를 시드(Seed)로 삼아 유사 변형 엣지 케이스 50개를 합성하고, 수정된 프롬프트나 모델이 모두 통과하는지 자동 회귀 테스트(Eval)를 구축하세요.
Model Collapse 방지 실무 체크리스트
① 합성 데이터만 100% 쓰지 말고 인간이 검수한 골든 데이터셋(20~30% 이상)을 항상 혼합하세요. ② LLM-as-a-Judge 단일 평가에 의존하지 말고 코드 실행·정규식·외부 DB 같은 객관적 앵커를 우선 배치하세요. ③ 임베딩 유사도 기반 중복 제거(Deduplication)로 표현의 다양성이 줄어들지 않도록 주기적으로 모니터링하세요.