 개의 스키마들이 포함되어 있다. 임의의 스키마와 대응되는 모든 염색체들의
품질의 평균값을 그 스키마의 품질이라 한다.
유전알고리즘 : 문병로, 두양사, 2003, Page 69~102
빌딩 블록 가설 (Building-Block Hypothesis)
2. 스키마의 생존 확률
3. 상위 (Epistasis)
4. 문제 공간의 모양
5. 왕도 함수 (Royal-Road Function)
1.6 절에서 스키마, 특정 기호, 무관 기호를 정의하였다.
스키마는 1.6 절에서 정의되었듯이 염색체들에 포함되어 있는 패턴을 의미한다. 길이
n 인 이진 염색체 하나에는 총 개의 스키마들이 포함되어 있다. 임의의 스키마와 대응되는 모든 염색체들의
품질의 평균값을 그 스키마의 품질이라 한다.
유전 알고리즘은 초기의 염색체들에 포함되어 있던 '소규모의' 스키마들이 결합되어 점점 더 규모가 큰 품질의 스키마로 만들어져 가는 과정이다. 스키마의 맨 왼쪽 특정 기호에서 맨 오른쪽 특정 기호에 이르는 길이를 스키마의 길이 (defining length) 라 한다. 스키마의 특정 기호들의 총 수를 그 스키마의 차수 (order) 라 한다.
일점 교차에서 스키마의 크기 등이 다음 세대에서 그 스키마를 가지는 염색체들의 개수에 미치는 영향을 공식화한 것이 유명한 Holland 의 스키마 정리 (Schema Theorem) [Holland, 1975] 이다. 이 정리의 핵심은 일점 교차를 사용하는 유전 알고리즘에서 임의의 스키마의 생존에 스키마의 길이와 품질이 큰 영향을 미친다는 것이다.
[스키마 정리] [Holland, 1975]
유전 알고리즘의 세대 t + 1 에서의 임의의 스키마 H 를 포함하는 염색체의 개수의 기대치는 다음과 같다.

 : 세대 t 에서 스키마 H 를 포함하는 염색체의 수
 : 세대 t 에서 스키마 H 를 포함하는 염색체들의 평균 적합도
 : 세대 t 에서 해집단 내의 모든 염색체들의 평균 적합도
 : 교차 확률
 : 변이 확률
 : 스키마 H 의 길이
 : 스키마 H 의 차수
 : 염색체의 길이
여기서  은 염색체에서 자름선이 놓일 수 있는 모든 경우에 대한 스키마 길이의 비율,
즉, 스키마가 파손될 확률을 나타낸다. 그러나 자름선이 스키마 내부에 놓이는 경우라
하더라도 상대 부모해가 똑같은 특정 기호를 갖고 있다면 그 스키마는 파손되지 않는다.
즉, 스키마 정리는 스키마의 생존 가능성에 대한 하한선을 제시한다.
외부적으로 유전 알고리즘은 해집단에 속한 모든 염색체의 적합도를 평가하고 그로부터 각 염색체는 선택 확률을 배정 받는다. 그러나 사실상 이면에는 현재의 해집단에 있는 염색체들이 갖고 있는 훨씬 많은 수의 스키마의 품질을 동시에 평가하게 되고 이 암묵적 품질에 따라 스키마들은 스키마 정리에서처럼 늘어나거나 줄어들거나 한다. Holland 는 이렇게 해집단의 해들의 품질을 평가함으로써 그 속에 깃든 훨씬 많은 수의 스키마의 품질을 동시에 평가하게 되는 유전 알고리즘의 성질을 내재적 동시성 (implicit parallelism) 이라 하였다.
스키마 정리에서는 교차와 변이의 파괴적 성질과 관련시켜 분석을 하였고 교차의 건설적 성격은 명시적으로 나타나 있지 않다. 빌딩 블록 가설은 교차의 건설적인 측면과 관련해서 유전 알고리즘의 동작 원리를 설명하는 핵심적인 가설인데, 유전 알고리즘이란 궁극적으로 작은 (저차수의) 스키마들의 '병렬 배치' (juxtaposition) 에 의해 점점 더 큰 (고차수의) 스키마로 발전해 가는 과정이라는 것이다.
이 과정에서 후에 고품질의 스키마를 구성하게 될 작은 스키마들이 잘 보존되어야 할 필요가 있다. 일점 교차를 사용하는 유전 알고리즘에서는 길이가 짧은 고품질의 스키마들이 빌딩 블록 역할을 한다. 교차 연산자가 달라지면 빌딩 블록의 특성은 확장된다. 이러한 스키마의 보존/파괴는 인코딩 방식과 교차 연산의 영향을 가장 많이 받는다. 기존의 스키마들로부터 새로운 스키마를 만들어내는 생성 능력에 대한 연구는 별로 이루어져 있지 않다 [Thierens & Goldberg, 1993; Spears, 1993].
유전 알고리즘이 스키마의 발달 과정이지만 실제로 스키마들이 발달해 가는 과정을 쉽게 파악할 수 있는 문제는 거의 없다. Mitchell, Forrest, Holland (1992) 는 개별 스키마들의 품질을 미리 정의하고 이와 함께 발달 과정을 미리 알 수 있는 함수를 정의하여 연구에 사용하였는데 이를 왕도 함수 (Royal Road Function) 라 한다. 왕도 함수는 4.5 절에서 소개된다.
스키마는 초평면 (hyperplane) 이라고도 한다. 스키마는 다차원 문제 공간에서 항상 특정 영역과 대응되므로 이러한 용어를 쓴다. 예를 들어 세 개의 유전자로 이루어진 이진 염색체를 보자. 스키마 000, 001 등은 한 점을 가리킨다. 스키마 00*, 0*1 등은 한 선 (두 점) 을 가리킨다. 스키마 0**, *1* 등은 한 면 (네 점) 을 가리킨다. 스키마 *** 은 문제 공간 전체를 가리킨다. 이것을 그림 4.1 에서 보인다. 그림에서 첫번째 유전자와 두번째 유전자의 위치가 바뀌면 스키마 0*1 은 스키마 *01 로 바뀌고 따라서 이 스키마의 공간적 의미가 달라진다. 유전자의 위치가 바뀌면 문제 공간에서의 적합도 지형 (fitness landscape) 이 달라진다. 의도하든 안하든 염색체의 표현을 결정하는 것은 하나의 적합도 지형을 선택하는 행위이다.
이번에는  가 0 부터 31 까지의 정수값을 가질 때 함수
 의 최적해를 구하는 문제를 예로 들어보자. 32 개의 정수는 5 비트의 이진수로
표현 가능하므로 5 비트의 이진 염색체로 해를 표현하도록 하자. 물론 이 예는 후보해가
32 개에 불과한 것으로 유전 알고리즘을 이용할 필요는 전혀 없고 스키마와 문제
공간에 대한 설명을 위한 예일 뿐이다.
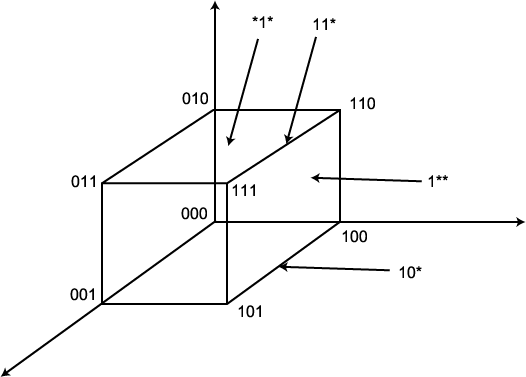
그림 4.1 스키마와 대응 공간
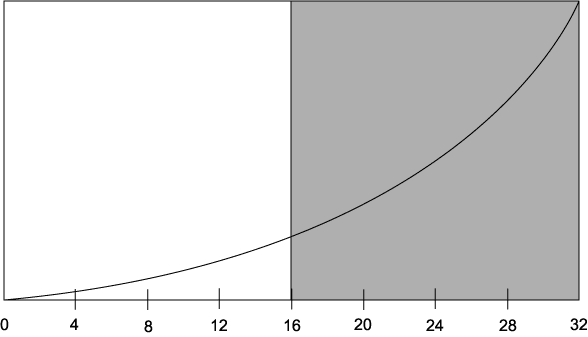
그림 4.2 스키마 1****의 대응 공간
그림 4.2 는 스키마 1****에 대응되는 문제 공간을 보여주고 있다. 그림 4.3 은 스키마 ****1 에 대응되는 문제 공간을 보여준다. 그림에서 가정한 함수에 대해서는 스키마 1**** 가 스키마 ****1 보다 품질이 좋다. 왜냐하면 1**** 에 대응되는 해들의 평균 품질이 스키마 ****1 에 대응되는 해들의 평균 품질보다 좋기 때문이다. 단 한 개의 특정 기호만 갖는 스키마들 중에서는 1**** 이 가장 품질이 좋다. 그러므로 스키마 1**** 를 포함하는 스키마들은 확률적으로 생존에 유리할 것이다 (주로 선택 연산자에 의해서. 대치도 약간 영향을 미칠 수 있다). 그림 4.4 는 스키마 **1*1 에 대응되는 문제 공간을 보인다.
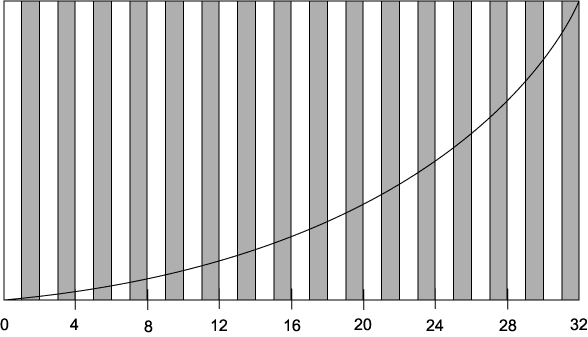
그림 4.3 스키마 ****1 의 대응 공간
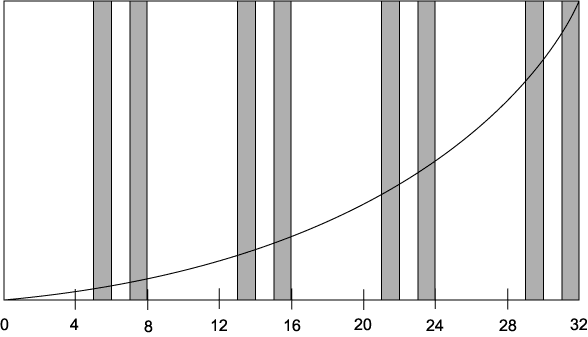
그림 4.4 스키마 **1*1 의 대응 공간
그림 4.1 부터 그림 4.4 는 [Goldberg, 1989] 에 있는 그림을 빌어 왔음을 밝혀둔다. 이것을 엄밀하게 표현하려면 5 차원의 공간에 표현을 해야 하지만 용이하지가 않으므로 다섯 비트를 십진수와 대응시켜 그려본 것이다. 다섯 비트 중 최상위 비트만 다른 두 해는 그림 4.2 ~ 4.4 에서는 16 만큼의 거리가 생기게 된다. 최하위 비트만 다른 두 해는 1 만큼의 거리만 떨어져 있다. 오차원 공간 상에서는 두 경우 1 만큼의 거리를 두게 될 뿐이다. 각 비트의 순서가 바뀌면 문제 공간의 모양은 달라진다.
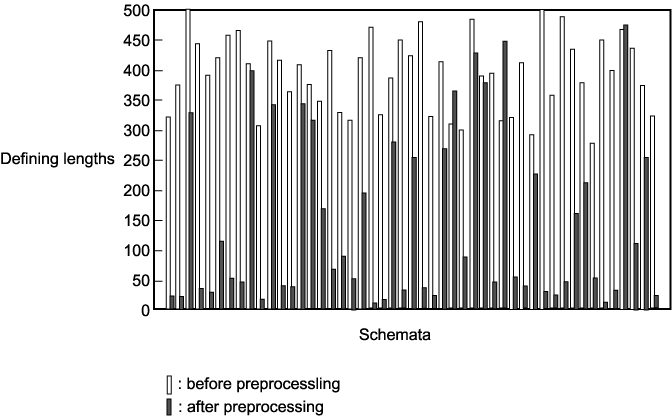
그림 4.5 유전자 재배치를 전후한 스키마의 길이 변동
그림 4.5 는 임의의 500 노드 짜리 그래프를 10 개씩의 노드를 가진 50 개의 클러스터로 나눈 다음 (50-way 그래프 분할 알고리즘 사용) 각 클러스터에 속한 노드들이 만드는 스키마의 길이를 측정해 본 것이다. 각 클러스터는 상대적으로 연결 강도가 높은 10 개씩의 노드들로 이루어져 있으므로 이들이 만드는 스키마는 대부분의 그래프 문제에서 같은 차수의 스키마들의 평균 품질을 상회할 것이다. 그림에서 흰 색의 막대는 주어진 일련 번호를 사용하여 표현했을 때 각 스키마의 길이이고, 검은 색의 막대는 그래프를 BFS 의 방문 순서에 따라 재배치한 다음의 각 스키마의 길이이다. BFS 재배치로 인해 평균적으로 극적인 스키마 길이의 감소가 있음을 관찰할 수 있다. 이로 인해 문제 공간의 모양도 달라지고 스키마의 공간적 의미도 크게 달라진다. 그래프 이등분 문제를 이용한 실험에서 이 재배치로 인한 스키마의 모양 변경은 극적인 성능 향상으로 연결되었다 [Bui & Moon, 1993, 1996].