
유전 알고리즘 : 문제의 표현
유전알고리즘 : 문병로, 두양사, 2003, Page 19~32
전형적인 유전 알고리즘은 이진수를 이용한 일차원적인 표현을 사용했지만, 이제는 이것을 유전 알고리즘의 대표적인 특징으로 볼 수 없을 정도로 다양한 표현법들이 등장하였다. 본 장에서는 다양한 표현법들 중 대표적인 방법들을 소개한다. 임의의 문제에 대한 염색체의 표현 방법이 결정되면 이에 맞추어 교차 연산자와 변이 연산자가 결정되어야 한다. 본 장에서는 염색체의 표현법들만을 소개하고, 이들과 관계된 연산자들은 3 장에서 설명한다.
1.5 절에서 이진수 표현과 16 진수 표현이 각각 소개된 바 있다. 홀랜드는 이진수 표현이 가장 다양한 스키마 처리를 가능하게 하여 가장 바람직하다고 주장했으나 이것은 현재 유전알고리즘 커뮤니티에서 전적인지지를 받지 못하고 있다 [Antonisse, 1989; Rogers, 1991]. 이진수 표현이 좋은지 k - 진수 표현이 좋은지에 대한 논쟁이 있으나 이들은 다음과 같은 점에서 차이가 있다. k - 진수로 표현되는 이진수로 표현하면, 교차시에 자름선을 둘 수 있는 위치가 보다 많아져 추가적인 변이의 효과가 발생한다. 아래와 같은 십진수 표현으로 된 염색체를 보자.
5 6 2 4 0 9
이것을 아래와 같이 이진수 표현으로 바꿀 수 있다.
010101100010010000001001
0 부터 9 까지의 수를 표현하려면 4 비트가 필요하므로 십진수 표현상의 한 유전자는 이진수 유전자 4 개로 대치된다. 십진수 표현에서 한 유전자가 6 이란 값을 가지면 6 은 교차시에 의미 단위로 움직이므로 나누어질 수 없다. 이것이 이진수 표현에서는 0110 으로 표현되므로 6 이 의미 단위로 움직이지 않고, 6 을 나타내는 이진수 0110 이 교차에 의해 분리될 수도 있다. 즉, 변이의 효과가 발생한다. 그러나 이러한 교차의 다양성이 좀 더 있다고 해서 이진수 표현이 k - 진수 표현보다 일반적으로 좋은 것은 아니다. 오히려 위에서처럼 6 이 의미 단위로 움직이는 것이 유전 알고리즘의 공간 탐색에 도움이 될 수도 있다. 또 변이 효과가 중요한 영향을 미칠 수 있다면 k - 진수 표현에서도 같은 효과를 내도록 변이 연산을 디자인할 수 있다. 이진수 표현이 좋은지 k - 진수 표현이 좋은지에 대한 논쟁은 이런 맥락에서 보면 다소간 의미없는 논쟁이라고 할 수 있다.
그레이 코딩은 이진수 표현의 한 갈래이다. 이것은 이진수 코딩의 체계를 바꾸어 인접한 수는 단 한 비트만 차이가 나도록 만든 것이다. 아래에 일반 이진 코딩과 그레이 코딩을 비교한다.
|
이진 코딩 |
그레이 코딩 |
|
0000 0001 0010 0011 0100 0101 0110 0111 1000 1001 1010 1011 1100 1101 1110 1111 |
0000 001 0011 0010 0110 0111 0101 0100 1100 1101 1111 1110 1010 1011 1001 1000 |
그레이 코딩의 매력은 인접한 두 수는 반드시 서로 한 비트만 차이가 나도록 고안되었다는 것이다. 즉, 의미상으로 유사한 두 해가 문제 공간에서 가까이 위치하도록 하고자 하는 것이 이 코드의 사용 동기이다. 이러한 성질은 임의의 비트를 변화시킬 때 급격한 변화를 막아주는 효과가 있다. 그런데, 인접한 두 수는 한 비트 차이가 나지만, 한 비트 차이가 나는 두 수가 모두 인접한 수인 것은 아니다. 즉, 모든 경우에 그레이 코딩에서 한 비트의 변화가 작은 변화를 초래하는 것은 아니다. 예를 들어, 1001 의 경우 그레이 코딩에서 한 비트를 변화시켜 인접한 수가 될 확률은 1/2 이다 (1011 과 1000). 이진 코딩에서는 이 확률이 1/4 이다 (1000). 그러나 이 경우 그레이 코딩에서 맨 앞의 1 을 변화시켰을 때는 이진 코딩에서보다 오히려 변화가 더 크다.
그레이 코딩을 사용한 성능 향상이 [Caruana & Schaffer, 1988], [Hollstien, 1971] 등에 보고되었다.
유전 알고리즘은 교차 연산자가 핵심적인 역할을 하므로 홀랜드가 교차 연산에 유리하다고 주장한 이진 표현이 자연스럽게 정석처럼 확립되었다. 그러나 독일의 '진화 전략' (Evolution strategy) 그룹은 초기체 교차 연산을 사용하지 않았으므로 굳이 이진 표현을 사용할 필요가 없었다 [Rechenberg, 1965]. 이들은 처음부터 자연스럽게 실수 표현을 사용하였다. 최근 진화 전략 분야의 대표적 연구자로 떠오른 Back (1993) 은 아예 유전 알고리즘과 진화 전략의 첫 번째 차이를 이진 코딩과 실수 코딩이라고 '과잉 분류' 하기도 할 정도이다.
교차 연산을 사용하는 유전 알고리즘 분야에서 가장 먼저 실수 표현을 사용한 사람은 Bremermann (1962) 이다. 실수 표현이 본격적으로 고려되기 시작한 것은 Weinberg (1970) 에 이어 Bosworth 그룹에 의해서이다 [Bosworth, Foo & Zeigler, 1972].
가장 간단한 실수 표현 방법은 실수 하나를 한 유전자로 삼는 것이다. C 프로그래밍 언어로 구현한다면 float 타입이나 double 타입의 변수 하나를 한 유전자에 할당하면 된다. 무엇보다도 인자들의 속성이 실수일 경우 인자들과 유전자들이 일대일 대응되는 간명함이 실수 표현의 큰 매력이다. 또한 수의 '크기' 개념을 연산자에 담을 수 있는 장점도 있다. 동일 위치에 있는 두 부모의 유전자들의 값을 평균 내어 자식의 동일 위치 유전자 값으로 삼는 산술적 교차 (arithmetical crossover) [Michalewicz, 1992, p.104] 가 한 예이다. 실수 표현에 대한 비교적 자세하고 다양한 실험 결과는 [Michalewicz, 1992] 의 pp.97-106 에 소개되어 있는데 전반적으로 실수 표현의 우수성을 강조하고 있다.
대부분의 유전 알고리즘에서는 해의 표현 방법이 한 번 결정되면 유전 알고리즘이 끝날 때까지 변하지 않는 고정 표현 방식을 쓴다. 만일 이 표현이 그리 바람직하지 않다면 유전 알고리즘은 표현상의 비효율로 인한 한계를 극복하기 힘들다. 이에 표현 방식을 미리 고정하지 않고 유전 알고리즘의 수행 중에 표현 방식이 변할 수 있도록 하는 방법들이 고안되었다. 절대 다수의 유전 알고리즘은 고정 표현을 사용하고 있으므로 아래에 몇 안되는 가변 표현의 예를 소개한다.
오래전에 Bagley (1967) 는 유전 알고리즘의 수행 중에 일군의 유전자들의 순서를 바꾸어 다시 표현하는 역치 연산자를 제안하였다. 아래는 역치 연산자의 예를 보여준다.
염색체 중 fghi 구간의 유전자 위치가 역순으로 바뀌었다. 만일 유전자 e 와 유전자 i 가 밀접한 관계를 갖는다면 이 역치를 통하여 두 유전자가 인접하게 위치함으로써 두 유전자가 만드는 패턴이 교차를 통해 생존하기 쉽게 된다 (나중에 스키마 이론을 통해 설명됨). 이와 같이 역치 연산자의 고안 동기는 좋은 패턴이 교차를 통해 덜 파괴되도록 하는 데 있다. 교차와 관련한 유전자 패턴의 생존 확률에 대한 본격적인 설명은 4.1 절로 미룬다. 위의 예에서 만일 유전자 e 와 유전자 f 가 밀접한 관계를 갖는다면 위의 역치를 통하여 오히려 나쁜 패턴으로 변하게 된다. 역치는 임의로 일어나므로 역치의 결과 표현이 개선될 확률과 나빠질 확률이 반반이다.
역치가 그간의 응용에서 별 눈에 띄는 결과를 내지는 못했으나 유전자들이 이루는 패턴을 바꾸어 보고자 하는 시도는 매우 의미가 있으며, 2.7 절에서 소개되는 유전자 재배치의 동기를 제공해 주었다.
유전학에서 어떤 유전자는 다른 유전자와의 상대적 관계 때문에 발현하지 못하고 있다가 다른 유전자가 없어지면 발현하는 경우가 있다. 대부분의 유전 알고리즘에서는 모든 유전자가 의미를 가지므로 잠재적인 우수 유전자가 발현하지 않고 숨어 있기는 힘들다. Goldberg, Korb, Deb (1989) 은 염색체의 길이가 변하면서 발현하지 않은 잠재적 유전자를 가지는 메시 유전 알고리즘을 제안하였다. 일차원 스트링으로 표현되는 임의의 최적화 문제를 위한 메시 유전 알고리즘에서 각 유전자는 (위치, 속성) 쌍으로 나열된다. 여기서는 한 위치에 대해 두 개 이상의 유전자가 나타날 수도 있고, 어떤 위치에 대해서는 유전자가 없을 수도 있다. 예를 들어
(1, 1) (2, 0) (2, 1) (4, 0) (1, 0)
는 해 10*0 를 의미한다. 여기서 위치 1 에 대해서는 (1, 1), (1, 0), 위치 2 에 대해서는 (2, 0), (2, 1) 두 유전자가 각각 나타나는데 이런 경우를 과잉 표현 (over-specification) 이라 한다. 이 경우는 먼저 나타난 것만 발현된다. 즉, 위치 1 의 값은 1 이 되고, 위치 2 의 값은 0 이 된다. 위치 3 에 대해서는 유전자가 없는데 이런 경우를 결손 표현 (underspecification) 이라 한다. 메시 유전 알고리즘에서는 염색체의 길이가 가변적이다.
과잉 표현은 해의 품질을 평가하는데 아무런 문제를 일으키지 않는다. 맨 앞에 나타난 것만 의미를 갖고 나머지는 무시해 버리기 때문이다. 결손 표현이 있을 경우 염색체의 품질을 평가하기 위해서는 어떻게든 온전한 해와 관계시켜 품질을 평가해야 한다. 골드버그 팀이 최초에 사용했던 방법은 결손된 유전자 위치마다 임의의 값을 채워서 만든 온전한 해의 품질을 해당 염색체의 품질로 삼는 방법이었다. 그러나 임의의 값으로 결손을 메운 해가 모든 가능한 경우들 중 대표성을 갖기는 어렵다는 것을 곧 알 게 되었고, 보완책으로 내놓은 방법이 지역 최적해를 찾는 방법이다. 이 방법은 먼저 임의의 값으로 결손을 메운 다음 한 비트씩 변화시켜서 개선시킬 수 있는 한계까지 개선시킨다. 아주 약한 지역 최적화 방법이다.
골드버그는 유전 알고리즘의 궁극적 가능성은 메시 유전 알고리즘에 있다고 주장하면서 왜 이것이 유전 알고리즘 학계에서 주목을 받지 못하는지 이해가 안된다고 말한 바 있다. 필자도 이 의견에 상당 부분 공감하며 나중에 여러분은 자신이 만든 유전 알고리즘에 메시 유전 알고리즘과 같은 요소를 가미하면 어떨까 하고 한 번쯤 생각해 보기를 권한다. 아직 메시 유전 알고리즘이 응용성이 강한 문제에 본격적으로 적용된 예는 드물다. INSPEC 데이터베이스를 조사해 보면 메시 GA 관련 논문이 1990 년부터 2002 년까지 34 개가 검색되고 있는데 골드버그의 바램만큼 그 가능성이 일반에게 알려져 있지는 않다.
존 코자에 의해 제안된 유전 프로그래밍은 LISP 프로그램을 자동 제작해주기 위해 트리 형태의 표현을 이용한다. 트리의 크기나 모양에 있어 원칙적으로 아무런 제한을 두지 않으며 유전 알고리즘의 수행 중에 트리의 크기와 구조가 자유로이 변한다. 근본적으로 트리의 크기와 모양 자체가 해를 결정하므로 가변적일 수밖에 없다. 유전 프로그래밍에 대해서는 2.8 절에서 더 언급된다.
대부분의 유전 알고리즘에서는 유전자의 위치가 해당 유전자의 속성을 결정한다. 예를 들어 함수 최적화 문제의 한 염색체에서 15 번째 유전자는 15 번째 변수의 값을 나타낸다거나, 이진 표현의 13 번째 유전자부터 16 번째 유전자의 집합이 5 번째 변수를 나타내는 것과 같은 경우를 들 수 있다. 임의의 그래프 문제의 염색체에서 28 번째 유전자는 대부분 28 번 노드의 속성을 나타낸다. 이러한 표현 방식을 '위치 기반 표현' (locus-based representation) 이라 한다. 이에 반해서 유전자의 위치는 별 의미가 없고 유전자 값들의 상대적 순서가 의미를 갖는 표현방법이 있다. 100 개의 도시를 다 방문하고 돌아오는 최적의 경로를 찾는 순회 세일즈맨 문제의 경우 1 부터 100 까지의 숫자를 순열로 나열함으로써 한 순회 경로를 표현할 수 있다. 여기서 78 번째 유전자는 그 위치가 별 의미를 갖지 않고 77 번째 유전자와 79 번째 유전자의 값이 무엇인가가 중요하다. 이러한 방식을 '순서 기반 표현' (order-based representation) 이라 한다.
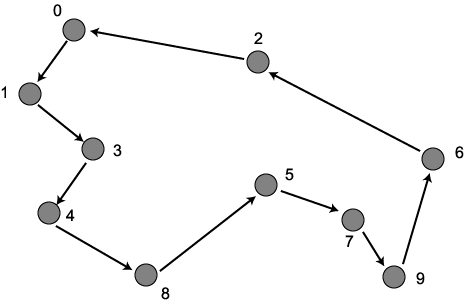
그림 2.1 순회 세일즈맨 문제의 한 해
그림 2.1 은 순회 세일즈맨 문제의 한 예를 보인다. 10 개의 도시는 각각 고유의 일련번호를 갖고 있는데 그림에서 보이는 순회 경로를 염색체로 표현하려 한다. 그림의 순회 경로에서 도시들의 방문 순서는 0, 1, 3, 4, 8, 5, 7, 9, 6, 2 순이다. 순서 기반 표현은 이들을 그냥 방문 순서대로 나열하면 되는데, 아래와 같이 10 가지의 표현이 동일한 경로를 나타낸다.
|
0134857962 1348579620 ... ... 2013485796 |
순서 기반 표현은 이해하기 쉽고 밀접한 관계를 갖는 일군의 도시들이 염색체상에서 비교적 가까운 위치에 자리하여 이로 인해 교차 연산시 중요한 스키마의 생존 확률을 높일 가능성이 많다 (물론 모든 종류의 교차 연산에 이러한 성질이 적용되는 것은 아니다). 이 방법으로 표현된 염색체에는 일정한 위치를 기준으로 염색체를 분할하는 전통적인 교차 연산자는 별 매력이 없어진다.
그림 2.1 의 경로를 위치 기반 표현으로 나타낼 수도 있다. 10 개 위치 각각을 도시 0 부터 도시 9 에 대응시킨다. 위치 i 는 도시 i 의 다음 방문 도시를 나타내도록 한다. 위의 해는 이러한 위치 기반 표현으로는 다음과 같이 나타낼 수 있다.
1304872956
이것은 도시 0 의 다음 방문 도시는 1 이고, 도시 1 의 다음 방문 도시는 도시 3, ..., 도시 9 의 다음 도시는 도시 6 이라는 뜻이다. 앞에서 예를 든 순서 기반 표현에서는 동일한 의미를 갖는 10 개의 다른 염색체가 존재하는데 반하여, 위치 기반 표현은 한 해에 대하여 단 하나의 염색체를 갖는다.
위치 기반 표현은 위와 같이 한 해에 대하여 유일한 염색체를 갖는 장점이 있으나, 유전자들의 위치가 교차 연산의 효율성에 영향을 많이 미치므로 대부분의 유전 알고리즘처럼 문제에서 주어지는 도시들의 일련번호를 그대로 이용해서는 유전자들의 배치로 인한 한계를 극복하기 힘들 수도 있다. 2.7 절에서는 이러한 고정 표현을 개선하는 유전자 재배치 방법을 소개한다.
유전 알고리즘하면 대부분 일차원의 염색체를 연상할 만큼 일차원 염색체는 유전 알고리즘의 상징적 전통 중의 하나라 할 수 있다. 그러나 최근에 들어 이것 또한 더 이상 유전 알고리즘을 특징짓는 성질 중의 하나라 할 수 없게 되었다.
많은 경우에, 어떤 문제의 해들은 일차원상의 염색체로 표현하는 과정에서 정보 손실이 일어난다. 예를 들어 그림 2.2 와 같이 이차원 격자 그래프를 일차원의 염색체로 표현하는 문제를 생각해 보자. 격자 그래프로 어떤 문제를 푸느냐 하는 것은 여기서는 중요하지 않으므로 일단 논외로 한다.
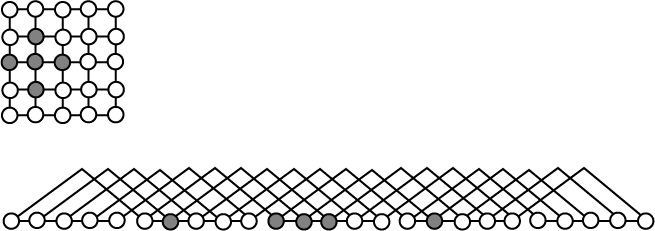
그림 2.2 2 차원 그래프를 1 차원으로 표현했을 때의 정보 손실
그림 2.2 의 첫 그림인 이차원 격자 그래프를 가로열 순서대로 일차원 염색체에 대응시키면 그 아래 그림처럼 되는데 원래의 그래프에서의 상하 인접 관계는 상당히 손실되는 것이 불가피하다. 이차원 배열에서 인접한 다섯 개 노드 (검은 색으로 칠함) 의 위치가 일차원으로 배열했을 때 분산된 예를 볼 수 있다. 어떤 방법으로 일차원 표현을 하든 원래 그래프에 존재하던 노드의 인접 관계를 상당 부분 손상시키지 않을 수 없다. 이러한 정보 손실이 반드시 유전 알고리즘의 성능을 저하시킨다는 이론적 증명은 쉽지 않을지라도, 표현 방법이 확정되고 나서 인접 관계의 손실이 일어나고 그 손실로 인해 발생하는 비효율성이 있다면, 표현을 바꾸지 않고는 회복하기 어려울 수도 있다.
문헌상에 나타나는 최초의 이차원 표현은 [Cohoon & Paris, 1986] 에서 볼 수 있다. 이들은 VLSI 회로의 최적 배치를 위해 이차원의 격자형 염색체를 사용하였다. Anderson 등 (1991) 은 Ising 문제를 위하여 격자형 염색체를 사용하였다. 필자 등은 이를 N 차원까지 확장하였다 [Bui & Moon, 1995 ; Kahng & Moon, 1995].
2.3 절에서 기술한 메시 유전 알고리즘과 역치는 유전 알고리즘의 수행 중에 표현이 바뀌는 동적인 재배열 방법이다. 이에 반하여 유전 알고리즘이 시작되기 전에 주어진 일련 번호 등을 사용하지 않고 문제의 특성을 이용하여 유전자들의 배치를 다시 하는 방법이 소개되었다 [Bui & Moon, 1993, 1996]. 이것은 유전 알고리즘의 시작 전에 단 한 번 배치를 바꾸어 주므로 정적인 재배치라고 할 수 있다.
이 방법은 그래프 분할 문제를 위하여 그래프에 BFS (너비우선탐색, Breadth First Search) 또는 DFS (깊이우선탐색, Depth First Search) 를 실시한 다음 그 방문 순서에 의해 염색체상의 유전자의 순서를 결정하는 것이다. 일점 교차를 하는 경우, 스키마의 생존 확률은 스키마의 길이에 반비례하는데 (4.1 절에 설명됨) BFS 를 이용하는 재배치 방법은 그래프 문제에서 우수 스키마의 길이를 줄여 주는 효과가 있음이 밝혀졌다. 다점 교차의 경우는 길이보다 스키마 내에서 특정 기호들이 군집적인 분포를 할 경우 생존에 유리하다는 것이 밝혀졌는데 DFS 를 이용한 재배치는 우수 스키마의 특정 기호들의 분포를 군집적으로 바꾸어 주는 효과가 있다 [Bui & Moon, 1998]. 그림 2.3 은 BFS 를 이용한 재배치의 예를 보인다.

그림 2.3 BFS 를 이용한 유전자 재배치의 예
2.5 절에서 소개한 순회 세일즈맨 문제를 위한 위치 기반 표현에서 먼저 지역 최적화 알고리즘을 수행한 다음 이의 방문 순서를 유전자의 배치 순서로 삼는 방법도 제안되었다. [Moon & Kim, 1997] 에서는 VLSI 회로의 게이트들을 배치하는 문제를 위하여 이차원 격자상 염색체를 사용하였는데, 게이트들을 이차원 격자상의 임의의 점에서 시작하여 먼저 배치된 게이트들과의 물리적 흡인력이 가장 강한 위치에 차례차례 배치해 나가는 방법을 사용하였다.
유전 알고리즘의 성능이 교차 연산과 그에 따른 우수 스키마의 보존에 큰 영향을 미치므로 우수 스키마의 보존을 도와주는 이 방법은 매우 큰 잠재력을 지니고 있다. 특히 그래프 형태로 나타내는 문제들의 경우에 효과가 있을 것이다. 이미 효과가 검증된 그래프 분할 [Bui & Moon, 1996], 최대 완전 그래프 문제 [Bui & Eppley, 1995], 순회 세일즈맨 문제 [Bui & Moon, 1994], VLSI 회로 배치 문제 [Moon & Kim, 1997] 등 이외에 신경망의 최적화에도 효과가 있음이 확인되었고, 퍼지 네트웍의 최적화, 컴퓨터 통신망의 최적 구성 등이 이러한 방법이 효능을 볼 수 있는 예에 포함될 것으로 보인다.
유전 알고리즘의 일차원 염색체의 관행을 깬 중요한 한 갈래는 트리 표현이다. 80 년대 중반 존 코자 (John Koza) 는 LISP 프로그램을 자동 생산하는 유전 알고리즘을 제안하고 이를 유전 프로그래밍 (Genetic Programming) 이라 명명하였다. 임의의 LISP 프로그램은 S-expression 으로 표현되고, 이는 트리 형태의 모양으로 표현할 수 있는데 코자는 이 트리 자체를 염색체로 사용하였다. LISP 프로그램의 자동 제작 이외에도 정보 검색에서의 질의어 최적화 (query optimization) 등에 트리 형태의 염색체를 사용한 예도 있다 [Kraft 등, 1994]. 그림 2.4 는 LISP 프로그램 (* (SQRT (AND A B)) (+ A C)) 를 트리 형태의 염색체로 나타낸 예를 보인다.

그림 2.4 LISP program 의 트리 표현의 예
최근까지 프로그래밍은 인간의 전유물이었다. 사람만이 프로그래밍을 할 수 있었다. 유전 프로그래밍은 프로그램의 품질을 외부에서 평가할 수만 있으면 컴퓨터가 자동으로 프로그램을 만들어 줄 수 있다는 특성으로 많은 저널리스트들의 호기심을 자극했다. 유전 알고리즘이 최근에 들어 급격한 관심을 끌고 있는 데에는 유전 프로그래밍의 이러한 특징도 한몫하고 있다.