 ) 들을 정렬하는 그러한 망을 보여준다 ("배처 정렬 (Bacher sort)"
- Knuth 1973). 각 수평선은 목록에 있는 한 구성요소를 나타내고, 각 수직 화살표는
두 구성요소들의 비교를 나타낸다. 예를 들어 가장 왼쪽에 있는 열의 수직화살표는
 와
 와
 등의 비교를 나타난다. 만약, 비교된 구성요소들이 원하는 순서로 되어있지 않다면
순서를 바꾼다.
(Two Brief Examples)
죄수의 딜레마를 위한 전략을 진화시키기 위한
유전자 알고리즘
GA 의 응용에 대한 보다 상세한 논의의 준비과정으로서 여기서 두 가지 특별히 흥미있는 프로젝트에서 이용되고 있는 GA 의 간단한 예를 살펴보자.
죄수의 딜레마 (the Prisoner's Dilemma) 는 1950 년대에 Merrill Flood 와 Melvin Dresher 에 의해서 고안된 간단한 2 인의 게임인데, 무기경쟁과 같은 실세계 현상에 대한 이상적인 모델로 간주될 수 있으므로 게임이론, 경제학, 그리고 정치학에서 깊이 연구되어 왔다 (Axelrod 1984, Axelrod and Dion 1988) 이것은 다음과 같이 공식화될 수 있다 : 두 사람 (Alice 와 Bob 이라고 하자) 이 범죄를 저질러 함께 체포되어 독립된 감방에 수감되었고, 서로 의사교환을 할 수 없게 되었다. Alice 는 다음과 같은 제안을 받았다 : 만일 자백하고 Bob 에 대하여 증언하겠다고 하면, 사면에 의해 형 집행정지를 받게 되고, Bob 은 5 년형을 살게 된다. 그러나 만일 동시에 Bob 이 자백하고 Alice 에 대하여 증언하겠다고 하면, Alice 의 증언은 불신을 받게되고 두 사람은 유죄를 인정받아 각각 4 년형을 받게된다. Alice 는 Bob 이 같은 제안을 받고 있다는 것을 알고 있다. 만일 두 사람 모두 서로에 대하여 증언을 하지 않는다면 2 년형이라는 가벼운 형을 받게된다는 것을 Alice 와 Bob 은 알고 있다.
만일 Bob 이 배신한다면 4 년형을 받게되는 위험을 무릅쓰고, Alice 는 형집행정지를 받을 수 있다는 희망하에 Bob 을 "배신 (defect)" 하여야 하는가? 아니면 만일 Bob 이 배신하면 자신은 5 년형을 받게되는 위험을 무릅쓰고, Bob 도 역시 협조하여 (cooperate) 2 년형씩을 받게될 수 있다는 희망하에 (서로 통신할 수 없다 하더라도) Bob 과 "협조" 하여야 하는가?
이 게임은 더 추상적으로 설명될 수 있다. 각 플레이어는 어떤 행동을 취할것인지, 즉 협조할 것인지 아니면 배신할 것인지를 독립적으로 결정한다. "게임" 은 각 플레이어의 결정 ("이동 (move)") 으로 이루어진다. 한 게임의 가능한 결과들이 그림 1.3 에 있는 것과 같은 보상행렬 (payoff matrix) 에 요약되어 있다. 여기서 목표는 가능한 한 많은 점수 (반대로 가능한 한 적은 햇수의 감옥생활) 를 얻는 것이다. (그림 1.3 에서 각 경우에서 보상은 5 에서 감옥에서의 햇수를 뺀 것이다.) 만일 두 플레이어가 협조하면 각각 3 점씩 얻는다. 만일 플레이어 A 가 배신하고 플레이어 B 가 협조하면, 플레이어 A 는 5 점, 플레이어 B 는 0 점을 얻고 그 반대도 마찬가지이다. 만일 두 플레이어가 모두 배신하면 각각 1 점씩 얻는다. 보상을 최대로 하기 위해서는 어떤 전략이 가장 좋은가? 만일 상대방이 협조하려고 한다고 생각되면 자신은 분명히 배신하여야 한다. 상대방 플레이어가 무엇을 하더라도 배신하는 것이 항상 더 낫다. 딜레마는 만일 두 플레이어가 모두 배신한다면 협조하는 것보다 더 나쁜 점수를 얻게될 것이다. 만일 게임이 반복된다면 (즉, 두 플레이어가 계속해서 여러 게임을 한다면), 두 플레이어가 항상 배신하는 것이 협조하는 것보다 전체적으로 훨씬 낮은 보상을 받게될 것이다. 어떻게 하면 상호간에 서로 좋은 협조가 유도될 수 있는가? 이 질문은 협조와 배신의 개념이 이를테면 실세계의 무기경쟁에서의 행동 (즉 군수품 제조설비를 감소시키거나 증가시키는 것) 에 해당할 때 특별한 중요성을 가지게 된다.
|
|
|
Player B |
|
|
|
|
Cooperate |
Defect |
|
Player A |
Cooperate |
3, 3 |
0, 5 |
|
|
Defect |
5, 0 |
1, 1 |
그림 1.3 죄수의 딜레마에 대한 보상행렬 (Axelrod 1987 에서 수정됨). 각 상자에 주어진 두 숫자는 주어진 상황하에서 플레이어 A 와 B 에 대한 보상들이고, 플레이어 A 의 보상은 각 쌍의 첫 번째에 열거되었다.
미시간 대학의 Robert Axelrod 는 죄수의 딜레마와 관계된 게임들을 깊이 연구하였다. 그는 어떤 것이 좋은 전략이 될 수 있는지 결정하는데 있어서의 관심을 가지고 있었으므로 두 죄수의 딜레마 시합을 조직하게 되었다 (Axelrod 1984 에서 설명되었음). 그는 많은 학문분야에서 연구자들로부터 전략들을 요청하였다. 각 참가자들은 특정한 전략을 구현한 컴퓨터 프로그램을 제출하였고, 다양한 프로그램들이 서로 반복해서 게임을 하였다. 게임하는 동안 각 프로그램은 이미 하였던 세 번의 이전 게임에서 자신과 상대방이 하였던 행동 (즉, 협조 또는 배신) 들을 기억하고, 자신의 전략은 이 기억에 기초하고 있다. 모든 프로그램들은 연속승자 진출전 (round-robin tournment) 둘씩 짝을 지어 다른 프로그램들과 많은 수의 게임을 하게 된다. 첫 번째 시합은 14 개의 다른 프로그램들로 구성되었고, 두 번째는 (랜덤행동을 취하는 것도 포함해서) 63 개의 프로그램으로 이루어졌다. 제출된 몇몇 전략들은 아주 복잡해서 가장 좋은 행동을 결정하기 위하여 다른 플레이어를 마르코프 프로세스와 베이스 추론과 같은 기법을 사용하였다. 그러나 두 번 모두의 시합에서 승자 (가장 높은 평균점수를 얻은 전략) 는 제출된 전략중에서 가장 간단한 것인 TIT FOR TAT 이었다. 이 전략은 Anatol Rapoport 에 의해서 제출되었는데, 첫 번째 게임에서는 협조하고 그 이후의 게임에서는 TIT FOR TAT 에 의한 직전의 게임에서 다른 플레이어가 하였던 행동을 무조건 하는 것이었다. 즉 이전의 게임에서 다른 플레이어가 하였던 행동을 무조건 하는 것이었다. 즉 이것은 협조를 제안하고 그것을 보답하는 것이었다. 그러나 만일 다른 플레이어가 배신하면, TIT FOR TAT 은 자신이 배신함으로써 그 배신에 벌을 주고, 다시 상대방 플레이어가 협조하기 시작할 때까지 계속 벌을 주는 것이었다.
두 시합이 끝난 후에 Axelrod (1987) 는 만일 GA 가 이 게임을 성공적으로 하는 전략을 진화시킬 수 있는지 보기로 결심하였다. 첫 번째 문제는 어떻게 전략을 문자열로 부호화시킬 수 있는지 알아내는 것이었다. 여기서 Axelrod 가 어떻게 부호화하였는지 설명하기로 한다. 각 플레이어의 기억이 하나 이전의 게임이라고 가정하자. 이전 게임에 대하여 네 가지 가능성들이 있다 :
CC (경우 1)
CD (경우 2)
DC (경우 3)
DD (경우 4)
여기서 C 는 "협조" 를 나타내고, D 는 "배신" 을 나타낸다. 경우 1 은 두 플레이어가 모두 이전 게임에서 협조하였을 때이고 경우 2 는 플레이어 A 가 협조하고 플레이어 B 가 배신한 경우이다. 전략이란 단순히 이와 같은 각각의 경우에서 행동을 규정하는 규칙에 불과하다. 예를 들어 플레이어 A 에 의해서 취해진 TIT FOR TAT 은 다음과 같다 :
만일 CC (경우 1) 이면, C 이다.
만일 CD (경우 2) 이면, D 이다.
만일 DC (경우 3) 이면, C 이다.
만일 DD (경우 4) 이면, D 이다.
만일 경우들이 이와 같은 표준적인 방식으로 나열되었다면, 전략은 문자열 CDCD 와 같이 간략하게 표현될 수 있다. 문자열을 전략으로 사용하기 위하여, 플레이어는 이전 게임에서 취해진 행동들 (예를 들어 CD) 을 기억시키고, 위에서 주어진 것처럼 정렬된 경우들의 표에서 찾아 경우지표 (case number) i 를 찾고 (CD 에 대해서는 i = 2 이다), 그 문자열의 i 번째 위치에서의 문자를 선택하여 다음 게임의 행동으로 정한다 (i = 2 에 대해서 행동은 D 이다).
Axelrod 의 시합은 세가지의 이전 게임들을 기억하는 전략들을 포함하였다. 이전 세 게임에 대해서는 64 가지의 경우들이 있다 :
CC CC CC (경우 1)
CC CC CD (경우 2)
CC CC DC (경우 3)
ㆍ
ㆍ
ㆍ
DD
DD DC (경우 63)
DD DD DD (경우 64)
그래서 한 전략은 예를 들어 CDCCCDDCCCDD... 와 같은 64 개 문자의 문자열에 의해 부호화될 수 있다. 전략을 사용하는 것은 이전의 세 게임들의 결과를 필요로 하기 때문에 Axelrod 는 실제로 70 개 문자 문자열을 사용하였는데 여기서 6 개의 별도의 문자들은 첫 번째 실제 게임에서의 행동을 결정하는 전략에 의해 사용된 세 개의 가설적인 이전 게임들을 부호화한 것이다. 그 문자열에서 각 위치가 두 개의 가능한 대립유전자 (C 와 D) 를 가지고 있기 때문에, 가능한 전략의 수는 270 가지이다. 따라서 탐색공간이 너무 커서 완전탐색하기가 어렵다.
Axelrod 의 첫 번째 실험에서, GA 는 20 개의 그러한 전략들의 집단을 가지고 있었다. 개체집단에서의 전략의 적합도는 다음과 같이 결정되었다 : Axelrod 는 두 번째 시합에서 인간에 의해 생성된 전략들 중에서 8 가지의 전략이, 모든 전략들의 집합을 대표하고 있다는 것을 알게 되었는데, 이것은 이들 8 가지 전략을 가지고 시행한 주어진 전략의 점수가 63 가지 전략 모두를 가지고 시행한 전략의 점수를 잘 예측하고 있다는 의미에서이다. 이들 8 개의 전략의 집합 (TIT FOR TAT 을 포함하지 않는) 이 개체집단에서 전략이 진화하는 "환경 (environment)" 으로 작용하였다. 개체집단에서 각 개체는 8 개의 고정된 전략들 각각을 가지고 게임을 반복하였고, 개체의 적합도는 시행한 모든 게임에 대한 평균점수로 정하였다.
Axelrod 는 각 실행마다 다른 난수 초기값을 사용하여 각각 50 세대씩의 40 개의 다른 실행을 하였다. 진화된 대부분의 전략들은 협조에는 보답하고 배신에는 벌을 준다는 관점에서 (반드시 직전의 행동에 기초할 필요는 없지만) TIT FOR TAT 과 유사하였다. 그러나 GA 는 TIT FOR TAT 보다 실질적으로 더 높은 점수를 얻는 전략을 발견하기도 하였다. 특히 GA 가 주어진 실행에서 270 가지의 가능한 개체의 방대한 탐색공간에서 20 × 50 = 1000 개체만을 테스트하였다는 사실을 보았을 때 이것은 놀랄만한 결과이다.
GA 가 인간이 고안한 어떠한 전략보다 "더 좋은 (better)" 전략들을 찾아냈다고 결론짓는 것은 잘못일 것이다. 어떤 전략의 성능은 환경, 즉 게임을 하는 전략들에 의해 크게 좌우된다. 여기서 실행 과정동안 인간이 고안한 8 개의 전략이 변화하지 않았으므로 환경은 고정되었다. 결과적으로 적합도 합수는 정적인 (변화하지 않는) 적합도 지형의 한 예이다. GA 에 의해 생성된 가장 높은 점수를 얻는 전략은 8 개의 고정된 전략의 여러 특정한 약점들을 이용하도록 고안되었다. 이들 가장 높은 점수를 얻는 전략들이 다른 환경에서도 마찬가지로 점수를 잘 얻을 것이라고 반드시 보장할 수는 없다. 가장 높은 점수를 얻도록 진화된 전략이 주어진 환경에 적합하도록 되었음에도 불구하고 TIT FOR TAT 는 일반적이다. Axelrod 는 GA 가 진화가 흔히 할 수 있는 일을 하는데 있어 우수하다고 결론지었는데, 그것은 환경의 구체적인 특징에 아주 전문화된 적응성을 개발해내는 것이다.
변화하는 (고정의 반대개념) 환경의 영향을 살펴보기 위하여 Axelrod 는 개체집단에서 개체들이 8 개의 고정된 전략들을 가지지 않고 서로 플레이하도록 함으로써 개체의 적합도가 결정되는 다른 실험을 실시하였다. 이제 상대편도 진화하기 때문에 세대가 변화함에 따라 환경도 변화한다. 모든 세대에서 각 개체는 19 개의 다른 멤버들 및 자신과 반복된 게임을 하고, 적합도는 모든 게임에 대한 평균점수로 정한다. 여기서 적합도 형태는 정적이 아니고 그 개체집단에 존재하는 특정한 개체의 함수이며 개체집단이 변화함에 따라 변화한다.
두 번째 실험에서 Axelrod 는 GA 가 초기에 비협조적인 전략을 진화시켰다는 것을 관찰하였다. 처음 몇 세대에서 협조하는 경향이 있는 전략들은 다른 동료 개체집단 멤버들에 의해 보답을 받지 못했고 따라서 소멸되는 경향이 있었다. 그러나 약 10-20 세대 이후에서는 경향이 반전되기 시작하였는데, GA 는 협조에 보답을 하고 배신에 벌을 주는 (즉, TIT FOR TAT 의 변종) 전략들을 발견하였다. 이 전략들은 서로 잘 수행되었으며 처음부터 협조적인 전략들처럼 덜 협조적인 전략에 의해 완전히 패배하지 않았다. 보답하는 전략들은 평균이상의 점수를 얻었으며 개체집단에 많이 분포하였다. 이것은 결과적으로 협조를 증가시켰고 따라서 적합도를 증가시켰다.
Axelrod 의 실험은 흥미있는 문제에 대한 해를 진화시키는 데 그리고 이상적인 방식으로 진화와 공진화를 모델화하는 데 어떻게 GA 를 사용할 수 있는지를 보여준다. 교배확률을 0 으로 하고, 즉 선택과 돌연변이 연산자만을 사용하여 (Axelrod 1987) GA 를 실행시키거나 주어진 전략에 허용할 수 있는 메모리의 양을 증가시키거나 감소시키는 (Lindgren 1992) 등 보다 비제한적인 종류의 진화를 허용하는 것과 같은 추가적으로 가능한 많은 실험들을 생각할 수 있다.
순서대로 나열된 요소들을 효과적으로 정렬하는
알고리즘을 고안하는 것은 컴퓨터 과학에 있어 기본적이다. Donald Knuth (1973)
는 이 주제를 위하여 그의 대표 저서인 The Art of Computer Programming
의 700 쪽짜리 책의 절반 이상을 할애하였다. 정렬의 목적은 최소의 시간내에 어떤
자료구조 (예를 들어 리스트 (list) 나 트리 (tree)) 의 구성요소를 특정한 순서로
(수의 크기나 알파벳 순서로) 나열시키는 것이다. Knuth 의 책에 기술되어 있는 정렬의
한 접근방식은 정렬 망 (sorting network) 인데, 고정된 n 개의 구성요소로 된 정렬
리스트를 위한 병렬처리가능 장치이다. 그림 1.4 는 n = 16 구성요소 () 들을 정렬하는 그러한 망을 보여준다 ("배처 정렬 (Bacher sort)"
- Knuth 1973). 각 수평선은 목록에 있는 한 구성요소를 나타내고, 각 수직 화살표는
두 구성요소들의 비교를 나타낸다. 예를 들어 가장 왼쪽에 있는 열의 수직화살표는
와 와 등의 비교를 나타난다. 만약, 비교된 구성요소들이 원하는 순서로 되어있지 않다면
순서를 바꾼다.
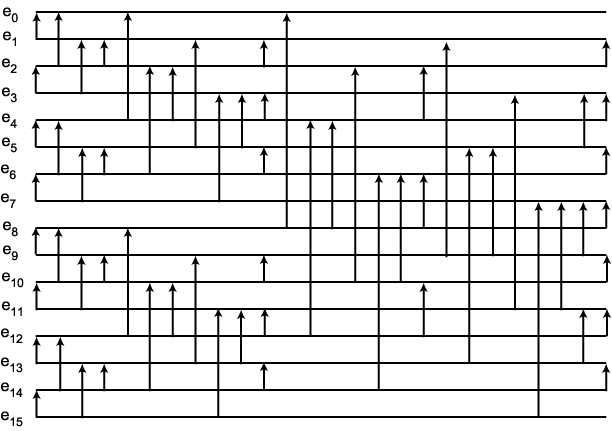
그림 1.4 "배처 정렬 (Batcher sort)" n = 16 정렬 망 (Knuth 1973 을 개작). 각 수평선은 이 목록의 한 구성요소를 나타내고, 각 수직 화살표는 두 요소들 간의 비교를 나타낸다. 만일 비교되는 요소들이 순서대로 되어있지 않으면, 서로 교환된다. 같은 열에서의 비교는 동시에 행해질 수 있다.
구성요소의 리스트를 정렬하려면, 망을 통해 왼쪽에서 오른쪽으로 리스트를 진행하면서 다음으로 진행하기 전에 각 수직열에 나타낸 모든 비교 (필요하다면 순서의 교체) 를 수행한다. 각 수직열의 비교들은 독립적이므로 병렬로 실행될 수 있다. 만약 망이 올바르다면 (배처 정렬에서 처럼), 어떠한 리스트라도 결국 완벽하게 정렬될 것이다. 정렬 망을 설계하는 하나의 목적은 이들을 올바르고 효율적으로 (비교의 수를 최소로) 하는 것이다.
흥미로운 이론적 문제는 n 개의 구성요소가 주어졌을 때 올바른 정렬 망이 필요로 하는 비교 횟수의 최소값을 결정하는 문제이다. 1960 년대에는 n = 16 일 경우 이 문제를 둘러싸고 매우 활발한 활동들이 있었다 (Knuth 1973 ; Hillis 1990, 1992). Hills (1990) 에 의하면, 1962 년에 Bose 와 Nelson 이 n = 16 일 경우에 65 번의 비교가 필요한 일반적인 정렬 망의 설계 방법을 개발하였고, 그 값이 최소라고 추측했다. 1964 년에 Batcher, 그리고 Floyd 와 Knuth 는 독립적으로 63 번의 비교만을 필요로 하는 망을 발견하였다. (이 망은 그림 1.4 에 나타냈다.) 몇몇에 의해서 이것이 최소값이라고 다시 생각되었지만, 1969 년에 Shapiro 는 62 번의 비교만을 필요로 하는 망을 만들어 내었다. 같은 해에 Green 이 단지 60 번의 비교만을 가지는 망을 발견하였기 때문에, 이 시점에서 아무도 망의 최적에 관한 추측을 하려고 하지 않았다. 이것이 n = 16 인 정렬 망의 설계의 작은 분야에서의 흥미있었던 시기였다. 비록 최적화를 증명하지 못했지만, Green 의 발견 이후에 모든 것이 조용해 졌다.
1980 년대에, W. Daniel Hillis (1990, 1992) 가 이번에는 유전자 알고리즘의 도움을 받아 이 문제에 다시 도전을 하였다. 특히, Hillis 는 대규모 병렬 Connection Machine 2 에서 유전자 알고리즘을 수행하여 n = 16 일 때의 최적 정렬 망의 설계 문제를 시도하였다.
죄수의 딜레마 예에서처럼, 여기서의 첫 단계는 정렬 망을 부호화하기 위한 좋은 방법을 알아내는 것이다. Hillis 의 부호화는 상당히 복잡하고, 대부분의 유전자 알고리즘 응용에서 사용되는 것 보다 더 생물학적으로 사실적이다. 이것이 동작되는 방법은 다음과 같다 : 정렬 망은 다음과 같이 나열된 쌍들의 리스트로 표현된다.
(2, 5), (4, 2), (7, 14), ……
이 쌍들은 구성요소들 간의 비교들을 나타낸다. ("먼저 구성요소 2 와 5 를 비교하고 필요하면 교환한다. 다음에 구성요소 4 와 2 를 비교하고 필요하면 교환한다.") (Hillis 는 최적의 병렬 정렬 망을 찾는 것보다 모든 비교의 수를 최소화하는 것에만 노력했기 때문에 그의 부호화는 어떤 비교들을 동시에 할 수 있는지는 규정하지 않았다.) 생물학과의 유사성을 고려하여, Hillis 는 망을 나타내는 쌍으로 나열된 리스트를 "표현형" 으로 연관시켰다. Hillis 의 프로그램에서 각각의 표현형은 60 개에서 120 개의 쌍들로 이루어져 있으며, 60 번에서 120 번 비교하는 망에 해당한다. 실제 유전학에서처럼 유전자 알고리즘에서는 표현형에서 동작하는 것이 아니라, 표현형을 부호화하는 유전형에서 동작한다.
GA 개체집단에서 개체의 유전형은 부호화되어 표현형을 구성하는 염색체의 집합으로 이루어져 있다. Hillis 는 GA 응용에서 보다 전형적인, 반수 염색체 (하나의 염색체) 대신 배수 염색체 (쌍으로된 염색체) 를 이용하였다. 그림 1.5a 에 보인 것처럼, 각 개체는 15 쌍의 32 비트 염색체들로 이루어져 있다. 그림 1.5b 에 나타내었듯이, 각 염색체들은 4 비트로 된 8 개의 "코돈 (codons)" 으로 구성되어 있다. 각 코돈은 16 개 구성요소 목록에서의 위치를 지정하는 0 부터 15 까지의 정수를 나타낸다. 염색체내에서 인접한 코돈의 쌍은 두 개의 구성요소 사이의 비교를 규정한다. 그러므로 각 염색체는 4 번의 비교를 부호화한다. 그림 1.5c 에 보인 것처럼, 각 염색체쌍은 4 와 8 의 비교를 부호화한다. 염색체 상을 가지런히 놓고 왼쪽에서 오른쪽으로 "읽어" 나간다. 각 위치마다 염색체 A 의 코돈쌍은 염색체 B 의 코돈쌍과 비교된다. 만약 이것들이 같은 쌍의 수들을 부호화한다면 (즉 "동질접합체 (homozygous)" 라면), 한 쌍의 수만 표현형에 삽입된다. 만약 이것들이 다른 쌍의 수를 부호화한다면 (즉 "이질접합체 (heterozygous)" 라면), 두쌍 모두 표현형에 삽입될 것이다. 15 쌍의 염색체는 고정된 순서로 이와 같은 식으로 읽혀져서 60 번에서 120 번의 비교로 표현형을 만들어 낸다. 각 염색체 쌍에서 동질접합체의 위치들이 더 많이 나타난다는 것은 결과로 얻어지는 정렬 망에 나타나는 비교가 더 적어진다는 것을 의미한다. 목적은 유전자 알고리즘이 Green 의 망과 같은 최소의 올바른 정렬 망을 찾아내는 것이고, GA 는 유전형에 동질접합체의 위치를 가지고, 동시에 올바른 정렬 망을 생성하는 개체를 발견해야 한다. Hillis 의 부호화 방법으로 GA 는 60 번이하의 비교를 갖는 망을 발견할 수 없다는 것을 주목하여야 한다.

그림 1.5 Hillis 의 실험에서 사용된 정렬 망의 상세한 유전형 표현. (a) 15 쌍의 32 비트 염색체로 구성된 개별 정렬 망에 대한 유전형의 예. (b) 하나의 염색체에 의해 부호화된 정수들의 예. 여기서 주어진 염색체는 정수 11, 5, 7, 9, 14, 4, 10, 그리고 9 를 부호화한다. 각 인접한 정수의 쌍은 비교하는 것으로 해석된다. (c) 염색체 쌍에 의해 부호화된 비교의 예. 여기서 주어진 쌍은 두 개의 동질접합체의 위치를 포함하고 있고 따라서 표현형 (11, 5), (7, 9), (2, 7), (14, 4), (3, 12), 그리고 (10, 9) 에 삽입될 총 6 번의 비교를 부호화한다.
Hillis 의 실험에서 초기 개체집단은 랜덤하게 발생되는 많은 유전형들로 이루어져 있다. 대부분의 알려진 16-구성요소 최소 정렬 망이 같은 패턴을 32 번 비교하는 것으로부터 시작된다고 생각했다는 것이 한가지의 주목할 만한 예외이다. 그래서 그는 이 비교치들을 (동질접합체처럼) 부호화 하기 위해 처음 8 개의 염색체 쌍을 선택했다. 이것은 문제영역 (여기서는 정렬 망) 에 관한 지식을 사용하여 유전자 알고리즘이 진척되도록 해 준 한 예이다.
임의의 초기 개체집단을 가지는 대부분의 망은 올바른 망이 될 수 없을 것이다. 즉 모든 입력 경우들 (16 개 숫자들의 리스트) 을 올바르게 정렬할 수 없다. Hillis 의 적합도 척도는 부분점수 (credit) 를 준다 : 망의 적합도는 그것이 올바르게 정렬한 경우들의 비율과 같다. 가능한 입력 경우가 너무 많으므로 각 망을 완전히 테스트하는 것은 비실용적이다. 그래서 각 세대에서 임의로 선택된 입력 경우의 표본에 대해 테스트된다.
Hillis 의 GA 는 위에 설명된 간단한 GA 보다 많이 수정된 것이다. 초기 개체집단에서 개체는 2 차원의 격자 (lattic) 에 위치한다. 그래서 간단한 GA 와는 달리, 두 문자열 사이에 공간적인 거리의 개념이 있다. 공간적인 격자에 집단을 배치시키는 목적은 그 개체집단 내에서 "종분화 (speciation)" 를 촉진시키기 위한 것이다. Hillis 는 전체 개체집단이 아주 유사한 망들의 집합으로 수렴하도록 하는 것 보다, 다른 형태의 망이 다른 공간위치에서 발생하기를 원했다.
개체집단에서 각 개체의 적합도는 테스트의 임의 표본에 대해 계산되었다. 그리고 다음에 낮은 적합도를 갖는 개체집단의 절반은 제거되고, 낮은 적합도를 갖는 개체들을 그 격자위에서 살아남은 이웃의 높은 적합도를 갖는 개체의 복제로 교체된다. 즉 높은 적합도를 갖는 개체집단의 절반의 각 개체는 한번만 재생산 될 수 있다.
다음에, 개체들은 근처공간의 이웃하는 다른 개체와 쌍을 이루어 자손을 생산한다. 배수 염색체를 갖는 유기체에 있어서 재결합은 위에서 설명된 간단한 반수 염색체의 교배와는 다르다. 그림 1.6 에 나타낸 것처럼 두 개체들이 쌍을 이룰 때, 각 개체 안에서 각 염색체쌍에서 교배가 일어난다. 15 개 염색체 쌍 각각에 대하여, 교배되는 점은 임의로 선택되고, 단독의 "배우자 (gamete)" 는 그 상에서 첫 번째 염색체로부터 교배되는 점 이전의 코돈과 그 쌍에서 두 번째 염색체로부터 교배점 이후의 코돈을 취함으로써 구성된다. 결과는 각 부모로부터 나온 15 개의 반수 염색체 배우자들이다. 첫 번째 부모로부터 나온 15 배우자들은 두 번째 부모로부터의 15 배우자들중 하나와 쌍을 이루어 단독의 배수 염색체 자손의 형태를 구성한다. 이 과정은 자연에서 배수 염색체 유기체사이의 유성 생식과 대략 유사하다.
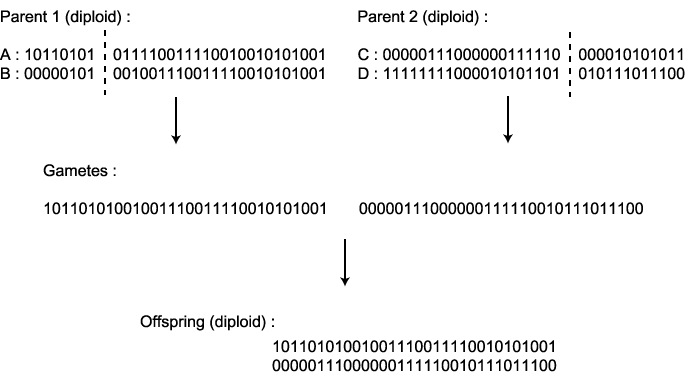
그림 1.6 Hillis 의 실험에서 수행된 배수 염색체의 재결합의 예. 여기서 한 개체의 유전형은 15 쌍의 염색체로 이루어진다. (명확하게 하기 위하여 각 부모의 단 하나의 쌍을 나타냈다.) 교배가 일어나는 점은 각 쌍에서 임의로 선택되었고 배우자는 첫 번째 염색체의 교배점 이전의 코돈과 두 번째 염색체의 교배점 이후의 코돈에 의해서 구성된다. 한 부모의 15 개 배우자는 다른 부모로부터의 15 배우자와 쌍을 이루어 새로운 개체를 만들어낸다. (다시 명확하게 하기 위하여 단 하나의 배우자쌍만 나타냈다.)
그러한 짝짓기는 새로운 개체집단이 형성될 때까지
계속 일어난다. 새로운 개체집단에서의 개체들은  = 0.001 의 확률로 돌연변이를 한다. 이 전체과정은 많은 세대동안 반복된다.
적합도는 망의 크기가 아니라 망의 정확도에만 전적으로 의존하므로, 최소망을 찾기 위해서 유전자 알고리즘은 어떻게 하여야 하는가? 자연에서처럼, 동질 접합체는 결정적인 비교를 막을 수 있기 때문에 Hillis 는 최소화를 위한 간접적인 압력 (pressure) 이 있다고 설명했다. 만약 어떤 결정적인 비교가 염색체내의 이질접합체에 위치한다면, 교배할 때 그것을 잃어버릴 수도 있다. 이에 반해, 동질접합체에서의 결정적인 비교는 교배할 때 잃어버릴 염려가 없다. 예를 들어 그림 1.6 에서, 염색체 B 에서 가장 왼쪽의 비교 (즉, 비교 (0, 5) 를 부호화하는 가장 왼쪽의 8 비트) 는 이질접합체 위치에 있고, 재생산할 때 이것은 잃어버리게 된다. (그 배우자는 염색체 A 의 가장 왼쪽과 비교된다.) 그러나, 염색체 A (10, 9) 의 가장 오른쪽 비교는 동질접합체의 위치에 있고, 이는 보존된다. (그러나 배우자는 염색체 B 의 가장 오른쪽과 비교된다.) 일반적으로, 일단 결정적인 비교나 여러 비교들이 발견되면, 그것들이 동질접합체 위치에 있게 되는 것은 아주 유리하다. 그리고 동질접합체의 위치가 많을수록 결과로 얻는 망은 점점 작아진다.
Connection Machine 의 대규모 병렬성의 장점을 이용하기 위해서, Hillis 는 512 에서 약 100 만개까지 이르는 매우 큰 개체집단을 사용했다. 매번 약 5000 세대까지 실행시켰다. GA 에 의해 발견된 가장 작은 망은 65 번의 비교를 가졌는데, 이것은 Bose 와 Nelson 의 망과 같지만, Green 의 망보다는 5 번이 더 많은 것이다.
Hillis 는 이 결과를 보고 실망하였다. 왜 유전자 알고리즘의 성능이 더 좋지 않았는가? 이것은 유전자 알고리즘이 전역적으로 가장 높은 봉우리가 아니라 적합도 지형에서 좁은 범위에서의 봉우리인 지역 최적점에 빠졌음을 나타낸다. 유전자 알고리즘은 65 번의 비교라는 꽤 좋은 해를 많이 찾아냈지만 더 이상 좋아지지 않았다. 한가지 이유는 초기 세대이후에 각 개체의 적합도를 계산하는데 사용되었던 임의로 발생한 테스트 경우들은 그다지 좋지 못했다. 망은 효과있는 전략을 찾아냈지만, 테스트 경우들의 어려움도 대체적으로 함께 생겨났다. 그래서 초기 세대 이후에 망이 현재의 근사 최적 정렬 전략을 바꿔야 한다는 강제성이 없어졌다.
이 문제를 풀기 위해 Hillis 는 생물학으로부터 또 다른 힌트를 얻었는데, 그것은 숙주-기생체 (host-parasite) (또는 포식자-먹이 (predator-prey)) 의 공진화 현상이다. 자연계에서는 자신을 공격하는 기생체를 방어하도록 진화한 유기체들의 예가 많이 있는데, 이것은 기생체가 이러한 방어를 피해갈 수 있게 진화시키고, 계속해서 숙주는 새로운 방어를 진화시키는데, 이 과정은 마치 나선형처럼 계속 증가하는 "생물학적 무기경쟁 (biological arms race)" 이다. Hillis 의 비유에서 정렬 망은 숙주로, 그리고 테스트 경우들 (16 개 숫자의 목록) 은 기생체로 볼 수 있다. Hillis 는 망의 집단이 기생체의 집단과 같은 격자위에서 공진화하도록 시스템을 수정하였는데, 여기서 기생체는 10 에서 20 개의 테스트 경우들의 집합을 구성되어 있다. 두 집단 모두 GA 하에서 진화하였다. 망의 적합도는 이제 망의 격자에 위치하는 기생체에 의해서 결정되었다. 망의 적합도는 올바르게 정렬한 기생체들의 시험 경우들의 백분율이다. 기생체의 적합도는 망을 망쳐놓은 (즉 망이 잘못 분류한) 테스트 경우들의 백분율이다.
진화하는 테스트 경우들의 집단은 진화하는 망의 집단에 대한 도전을 증가시킨다. 망이 테스트 경우들을 정렬하는 성능이 점점 좋아질수록 테스트 경우들은 점점 더 어려워지고, 망의 약점을 명확하게 목표로 하여 진화한다. 이것은 망의 집단이 동일한 하위 최적 전략에 빠지지 않고 계속 변화하도록 - 즉 새로운 정렬 전략을 계속 발견하도록 - 한다. 공진화에 의해 GA 는 61 번의 비교만에 올바른 망을 발견했는데, 공진화 없이 찾아낸 가장 좋은 망보다 실질적으로 개선시켰지만 경쟁상대인 Green 의 망과 비교하면 실망스러웠다.
Hillis 의 연구는 매우 중요한데, 그 이유는 생물학의 공진화에 의해서 착안한 새롭고 잠재적으로 매우 유용한 GA 기법을 소개하였으며, 그의 결과는 그러한 생물학적 착상의 잠재적인 힘을 설득력있게 소개하는 실례였다는 것이다. 숙주 - 기생체 아이디어는 매우 설득력있기는 하지만 그 유용성은 Hillis 의 연구 영역 외에는 더 이상 구체화되지 못하였고, 어떻게 일반적으로 적용될 것인지 그리고 보다 어려운 문제 (예를 들어 더 큰 정렬 망) 에 어느 정도 확장 시킬 수 있는지 분명하지 않다. 분명히 이 매우 흥미있는 분야에 더 많은 연구가 이루어져야 할 것이다.