유전알고리즘 : 문병로, 두양사, 2003, Page 139~199
1. 함수 최적화 (Function Optimization)
2. 시스템 최적화
순회 세일즈맨 문제 (Traveling Salesman Problem)
영상 압축을 위한 벡터 양자화 (Vector Quantization)
4. CRM 및 인터넷 1-To-1 마케팅
5. 죄수의 딜레마 (Prisoner's Dilemma) 문제
조합적 최적화 (combinatorial optimization) 는 유전 알고리즘의 응용 예들 중 가장 많은 결과를 낸 것들 중의 하나이다. 가장 관심을 끄는 연구 분야는 NP-Hard 군에 속하는 문제들일 것이다. 유전 알고리즘이 도전한 대표적인 문제 또는 문제군을 몇 가지 나열하면 순회 세일즈맨 문제 (traveling salesman problem) [Goldberg & Lingle, 1985; Nagata & Kobayashi, 1997 ; Jung & Moon, 2000], 작업공정 스케줄링 (job shop scheduling) [Davis, 1985 ; Candido 등, 1998], 네트웍 레이아웃 [Britten 등, 1997 ; Castillo & Gonzalez, 1998], VLSI CAD 레이아웃 [Cohoon & Paris, 1987 ; Bui & Moon, 1998], 채널 라우팅 [Liu 등, 1994], DB 질의 최적화 [Yang & Korfhage, 1993], 자동차 스케쥴링 [Thangiah, 1995], 그래프 분할 [Collins & Jefferson, 1991 ; Bui & Moon, 1996], 최대 완전 그래프 문제 [Bui & Eppley, 1997], 스타이너 (Steiner) 트리 최적화 [Esbensen, 1995], 부하 밸런스 (load balancing) 문제 [Mehra & Wah, 1997], 시간표 문제 (timetabling) [Kragelund, 1997], 이차원 배정 문제 (quadratic assignment problem) [Tate & Smith, 1995], 단백질 구조 최적화 (protein folding) [Carpio, 1996] 등 한정된 공간에 나열하기 힘들 정도로 많다.
유전 알고리즘의 공간 탐색 특성상 수행 시간이 자주 문제가 되는데 앞의 혼합형 유전 알고리즘에서 언급했듯이 장난감 사이즈 이상의 문제의 경우에는 기본적인 형태의 유전 알고리즘으로는 한정된 시간에 좋은 결과를 기대하기 힘든 것이 보통이고, 이 과정에서 얼마간 문제에 대한 이론적 지식이나 휴리스틱 알고리즘 등이 개입된다. 아래에 몇 가지 조합 최적화 문제들과 이들을 위한 유전 알고리즘을 표현 방법을 중심으로 소개한다.
N 개의 도시가 주어지고 한 도시로부터 출발하여 모든 도시를 한 번씩 방문한 다음 출발했던 도시로 돌아오는 가장 짧은 경로를 찾는 문제이다. 유명한 NP-Hard 문제이다 [Garey & Johnson, 1979]. 이 문제는 그 유명도와 대표적인 난이도로 인해 어떤 새로운 공간 탐색 기법이 고안되면 이 문제에 대한 실험이 이루어지지 않고는 제대로 평가받을 수 없을 정도로 큰 영향력을 가진 문제이다. 당연히 유전 알고리즘에서도 수많은 아이디어들이 쏟아져 나왔다.
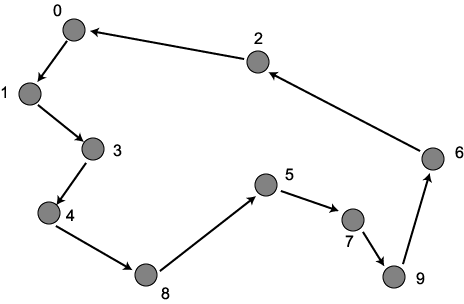
그림 6.5 의 순회 세일즈맨 문제의 예에서 10 개의 도시는 각각 고유의 일련번호를 갖고 있는데 그림에서 보이는 순회경로를 염색체로 표현하려 한다. 그림의 순회경로에서 도시들의 방문 순서는 0, 1, 3, 4, 8, 5, 7, 9, 6, 2 순이다. 순서 기반 표현은 이들을 그냥 방문 순서대로 나열하면 되는데, 아래와 같이 10 개의 염색체가 동일한 경로를 나타낸다.
|
0134857962 |
|
1348579620 |
|
... |
|
... |
|
2013485796 |
이 방법으로 표현된 염색체에는 일정한 위치를 기준으로 염색체를 분할하는 전통적인 교차 연산자는 별 매력이 없어진다.
그림 6.5 순회 세일즈맨 문제의 한 해
그림 6.5 의 경로를 위치 기반 표현으로 나타낸 염색체의 한 예는 아래와 같다. 10 개 위치 각각을 도시 0 부터 도시 9 에 대응시킨다. 위치 i 에 있는 수는 도시 i 의 다음 방문 도시를 나타내도록 한다.
1304872956
이것은 도시 0 의 다음 방문 도시는 1 이고, 도시 1 의 다음 방문 도시는 도시 3, ..., 도시 9 의 다음 도시는 6 라는 뜻이다. 앞에서 예를 든 순서 기반 표현에서는 동일한 의미를 갖는 10 개의 다른 염색체가 존재하는데 반하여, 위치 기반 표현은 한 해에 대하여 단 하나의 염색체를 갖는다.
위에서 순회 세일즈맨 문제를 위한 순서 기반 표현과 위치 기반 표현을 소개했다. 이들과는 달리 교차에서 문제에 대한 지식을 이용하여 휴리스틱한 교차를 사용하는 방법들이 있는데 [Whitley 등, 1990; Starkweather 등, 1991], 이들은 각 해의 특성을 '분석' 하여 부분 결합함으로써 표현 방식이 별 의미를 갖지 않게 된다. 유전자형을 이용하여 염색체를 자르는 작업을 하지 않기 때문이다. 또한 순회 세일즈맨 문제의 해답 그 자체의 이차원적 모양을 염색체로 사용하는 표현 방법과 교차 연산도 제시되었다 [Jung & Moon, 2000, 2002].
차량 라우팅은 복수 개의 차량으로 복수의 고객을 서비스하는 가장 효율적인 방법을 찾는 문제이다. 여기서 고객은 사람이 될 수도 있고, 백화점 등의 영업 장소일 수도 있고, 물건을 저장하는 창고일 수도 있다. 최적화하고자 하는 대상은 이동 거리, 서비스 총 시간, 연료 소비, 고객의 만족도 등이 될 수 있다.
기본형은 기본 차량 라우팅 문제로 VRP (Standard Vehicle Routing Problem) 라 부른다. 이 형에서는 각자의 부하 한계를 지닌 k 개의 차량이 준비되고, 출발지점과 도착 지점을 가진 고객들이 제공된다. 목적은 모든 고객들을 서비스하되 사용 차량의 수를 최소화하는 차량의 분배 및 라우팅 방법을 찾는 것이다. 이보다 다소 제한이 많은 변형들도 있는데 위의 VRP 에 각 고객이 자신이 서비스 받을 수 있는 가장 이른 시간까지 명시할 수 있는 모델을 VRPTD (VRP with time deadline) 라 부른다. VRPTD 에 각 고객이 서비스받아야 하는 가장 늦은 시간까지 명시할 수 있는 모델을 VRPTW (VRP with time window) 라 한다. 예를 들어, Dial-A-Ride 서비스는 전화를 하면 서비스 차량이 와서 목적지까지 데려다주는 서비스인데, 이를 이용하여 저녁 7 시에 시작하는 음악회에 가고자 하는데 한 시간 쯤 걸리는 거리에 사는 노부부는 VRPW 를 제공하는 서비스를 택해야 할 것이다. 만일 그렇지 않은 서비스를 택해 2 시에 데리러 온다거나 7 시가 넘어서 데리러 와서는 곤란할 것이다. 이 외에도 다양한 변형들이 가능하다. 제한이 까다로워질수록 고급 서비스가 되고 서비스의 비용은 비싸질 것이다.
차량 라우팅의 응용 가능성은 다양하다. 소매 체인의 물건 배달, 물품 배달 비용을 최소화하는 체인점들의 위치 선정, 스쿨버스 라우팅, 우편 배달 (UPS, Federal Express, DHL 등이 좋은 예), 쓰레기 처리 차량 라우팅, 유류 배달, Dial-A-Ride 서비스 등 실로 다양한 문제들이 발생한다. 현재 우리 나라에는 이러한 문제들이 본격적으로 발생하지 않고 있거나, 발생하더라도 고수준의 알고리즘을 적용한 예가 별로 알려져 있지 않은 수준인데, 이러한 문제들에 고수준의 해에 대한 필요성을 기업들이 느끼기 시작했고 초기 시장이 형성되고 있다. 특히 최근에 물류의 개선을 위한 SCM (Supply Chain Management, 공급사슬 관리) 분야에서 이러한 차량 라우팅 최적화의 필요성이 대두되고 있다.
차량 라우팅 문제는 고객을 k 대 이하의 차량에 할당하는 작업과 할당된 고객들을 서비스하기 위한 개별 차량들의 라우팅으로 나눌 수 있다. 이 중 고객들을 차량들에 할당하는 문제는 그루핑 (grouping) 또는 분할 (partitioning) 문제가 된다. 문제의 간명함을 위해 여기서는 고객들의 위치가 이차원상의 좌표로 주어지고 두 고객 위치간의 이동에 드는 시간은 둘 사이의 물리적 거리와 비례한다고 가정하자.
이 문제를 위한 유전 알고리즘의 표현을 위해 다음과 같은 간단한 방법을 생각할 수 있다.
|
2 |
5 |
3 |
2 |
k |
4 |
3 |
6 |
ㆍㆍㆍㆍ |
3 |
염색체의 길이는 고객의 수 (N) 와 같고 각 유전자는 각 고객이 소속되는 차량의 번호를 나타낸다. 이렇게 해서 고객이 k 대 이하의 차량에 분배되는 각각의 차량은 분배된 고객들을 가지고 라우팅을 한다. 라우팅은 허용되는 시간 예산에 따라 유전 알고리즘을 이용할 수도 있고 TSP 를 위한 LK [Lin & Kernighan, 1973] 같은 휴리스틱을 사용할 수도 있을 것이다. 이렇게 해서 차량의 분배와 라우팅이 일차로 마무리되면 고객의 소속 차량을 바꾸어서 개선할 수 있는 부분은 개선시킨다.
다음은 유전 알고리즘을 잉요한 풀이법의 하나인 Thangiah (1995, 1997) 의 방법을 기본으로 하는 접근법을 소개한다. 먼저 유전 알고리즘을 이용하여 k 개 (또는 k 개 이하) 의 원을 만든다. 이 k 는 차량의 수와 일치한다. 각각의 고객은 그 중 하나의 원에 속하도록 그루핑 된다. 어떤 고객이 임의의 원 안에 속하면 해당 원에 자연스럽게 속한다. 만일 어떤 고객이 아무 원에도 속하지 않으면 직교하는 선을 그었을 때 가장 가까운 원에 속하도록 한다. 이렇게 해서 모든 고객이 k 대의 차량에 할당되면 나머지는 앞에서 소개한 방법과 같다. 이 방법이 고객들의 지리적 위치를 잘 고려해서 분배하므로 후처리 비용을 줄이는 데 도움이 된다. 유전 알고리즘은 계속해서 다양한 원의 조합을 제공하고 이것은 위와 같이 개별 라우팅과 후처리 개선에 의해 지역 최적화된다. 그림 6.6 은 차량 라우팅을 위한 문제의 한 전형적인 예와 이의 그루핑의 한 예를 보인다. 염색체는 다음과 같이 디자인할 수 있다.
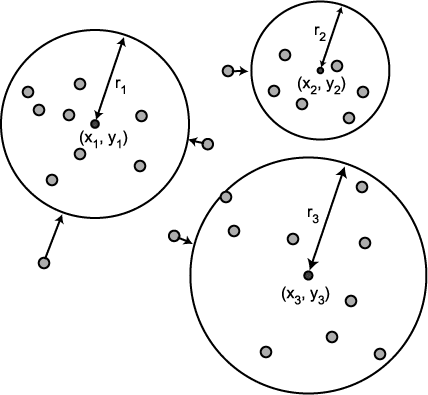
그림 6.6 고객들의 위치와 고객들을 세 개의 차량에 분할한 예
|
|
|
|
|
|
|
|
|
|
ㆍㆍㆍㆍ |
각 원은 x, y 좌표와 반지름의 길이로 명시된다. 염색체는 이렇게 k 개의 원을 나타낸다.
여기서는 분할 부분만 유전 알고리즘으로 푸는 경우를 소개했는데 라우팅 부분도 얼마든지 유전 알고리즘으로 가능하다. 다만 이 경우 두 유전 알고리즘이 계층적으로 수행되므로 시간이 만만치 않게 든다. 주어진 시간 예산을 잘 고려하여 적합한 방법을 찾아야 할 것이다.
그래프 이등분 문제는 임의의 그래프를 같은 수의 노드를 갖는 두 부분집합으로 분리하되, 두 부분 집합간에 걸치는 간선의 개수를 최소화하는 문제이다. 이것은 잘 알려진 NP-Hard 문제이다 [Garey & Johnson, 979]. 그림 6.7 은 그래프 이등분 문제의 한 보기와 이를 염색체로 표현한 예이다. 그림처럼 10 개의 노드가 있는 그래프의 경우, 10 자리의 이진수 하나가 한 해를 나타내게 된다.
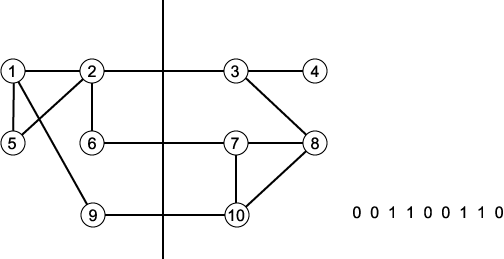
그림 6.7 그래프 이등분 문제의 염색체의 한 예
그래프 이등분 문제의 경우 두 개의 부모해로부터 교차를 통해 생성되는 해는 균형이 깨지기 쉽다. 이러한 해를 비적격해 (invalid solution) 이라 하는데 유전 알고리즘에 따라 해집단에 비적격해는 아예 포함시키는 경우는 이로부터 만들 수 있는 최선의 적격해의 품질을 이 해의 품질로 삼는 방법이 있다. 경우에 따라서는 비적격해에 페널티를 주는 경우도 있다. 비적격해를 포함시키지 않는 유전 알고리즘의 경우에는 이진수에서 0 과 1 의 수가 일치하도록 나름대로 수선을 하여야 한다. 간단한 예를 들면, 염색체에서 0 과 1 의 총 수를 센 다음 염색체 상의 임의의 지점을 선택하여 오른쪽으로 훑어가면서 모자라는 수만큼의 0 또는 1 을 바꾸어 주는 방법을 사용할 수 있다.
그래프를 두 개 이상의 부분 집합으로 나누되 서로 다른 부분 집합간에 걸치는 간선의 수를 최소화하는 문제를 그래프 다분할 (k-way partitioning) 문제라 한다. k 개의 부분 집합으로 나누는 문제는 역시 자연스럽게 k-진수 표현을 쓸 수 있다. 이를 이진수 표현으로 바꿀 수도 있는데 이진수 표현이 약간의 변이 효과가 더 있다.
단백질은 일련의 아미노산들의 띠로서 고유의 3 차원 구조를 갖는다. 단백질의 성격은 그것이 만드는 3 차원의 구조에 의해 결정된다. 임의의 단백질이 물과 같은 임의의 용액 중에 놓일 때 용액은 친수성 (hydrophilic) 아미노산은 끌어당기고, 소수성 (hydrophobic) 아미노산은 밀친다. 많은 가능한 3 차원 구조들 중 최소의 에너지를 갖는 구조를 찾는 것이 유명한 단백질 접기 (protein folding) 문제이다. 단백질의 3 차원 구조를 밝히는 것은 생물학 최대의 난제 중 하나로 'The Great Challenge' 라고 부르기도 한다.
단백질 접기 문제는 접히는 각도가 아무렇게나 가능한 실제 모델과 90° 로만 접히도록 허용하는 라티스 모델이 있다. 여기서는 간단한 라티스 모델을 대상으로 예를 든다. 그림 6.8 은 라티스 모델의 단백질 접기의 한 예를 보인다. 두 아미노산이 단백질의 체인에서는 이웃하지 않으나 접힌 결과로 이웃한 위치에 놓이게 될 때 이를 접합 (contact) 이라 한다. 두 소수성 아미노산이 만드는 접합을 소수성 접합 (hydrophobic contact) 이라 한다. 이 소수성 접합의 개수를 최대화하는 3 차원 구조를 찾는 것이 이 문제의 목적이다.
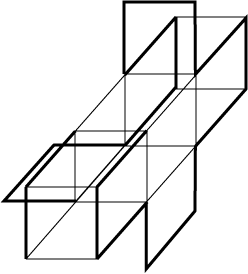
그림 6.8 라티스 모델의 단백질 접기의 한 예
라티스 모델에서의 임의의 3 차원 구조를 염색체로 표현하는 방법들 중 Patton 등 (1995) 의 방법을 기본으로 소개한다. 각 아미노산은 다섯 가지의 가능한 방향이 있다 (앞 (F), 좌 (L), 우 (R), 상 (U), 하 (D)). 첫 번째와 두 번째 아미노산을 고정하고 (이 둘의 연결 방향을 바꾸는 것은 대칭성에 의하여 별 의미가 없다) 세 번째 아미노산부터 직전의 연결에 근거하여 접는 방향을 명시한다. 예를 들어, 아미노산 i-1 과 아미노산 i 의 연결선에 의해 아미노산 i 와 아미노산 i+1 의 연결선의 방향의 의미가 상대적으로 결정된다. 그림 6.9 는 이를 그림으로 표현한 것이다.
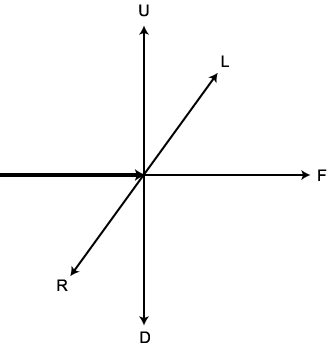
그림 6.9 아미노산의 방향
염색체는 아래와 같이 N-2 개의 유전자로 구성할 수 있다.
|
F |
D |
U |
L |
R |
U |
L |
F |
F |
ㆍㆍㆍㆍ |
즉, {F, L, R, U, D}N-2 가 된다. 각 유전자는 3 번째 아미노산부터 접히는 방향을 명시한다. 이렇게 함으로써 단백질의 3 차원 구조를 나타낼 수 있으나 이 방법은 5N-2 가지의 염색체 모두가 적법한 구조를 나타내는 것은 아니다. 임의의 아미노산 자리에 있는 유전자가 L 값을 갖고 있는데 왼쪽에 이미 다른 아미노산이 자리를 잡고 있으면 이 방향으로 접는 것이 불가능하다. 이 경우에는 적절한 해결 방법을 마련해 두어야 한다.
Patton 등 (1995) 은 적격해를 만들지 못할 가능성이 많은 위의 방법에 대1해 다음과 같이 개선책을 제시하였다. 염색체의 길이는 같으나 이번에는 각 염색체가 다섯 개의 방향 중에 하나를 갖고 있는 것이 아니고 각 방향의 우선 순위를 갖는다. 다섯 방향을 우선 순위로 매기는 방법은 120 (5!) 가지이므로 각 염색체는 아래와 같이 1 부터 120 사이의 값을 갖는다.
|
34 |
5 |
21 |
1 |
98 |
120 |
107 |
77 |
83 |
ㆍㆍㆍㆍ |
이렇게 하면 임의의 단백질이 첫 번째 방향으로 접는 것이 가능하지 않으면 두 번째 방향으로 접는다. 이렇게 함으로써 적법하지 않은 해를 만들 가능성은 현저히 떨어지게 된다. 그러나 이 경우에도 적법하지 않은 해가 만들어질 가능성은 여전히 있다. 이 경우는 해를 버리거나 수선책을 마련해 둘 필요가 있을 것이다. 수선책 중에는 적법한 지점까지 백트래킹한 다음 그 지점에서부터 유전자를 고치는 등의 방법도 생각해 볼 수 있다.
반도체 회로의 밀집도가 점점 높아지면서 한 칩에 수백만 개의 게이트가 집적되기도 한다. 반도체의 생산 단가를 낮추려면 모든 논리적 회로 부분이 가장 작은 면적을 사용해서 집적할 수 있어야 하고 배선을 위한 와이어의 총 길이를 짧게 해야 한다. 최근에는 단가 이외에도 다양한 요구 사항들을 만족해야 한다. 예를 들면, 회로의 지연 시간 최소화 (빠른 클럭 스피드를 갖도록 함), 전력 소모 최소화, 고수율 등 다양한 요구 사항들이 있다. 이들은 서로 상충 관계에 있는 경우가 많아 이들을 잘 조절하면서 최적의 배치를 하는 작업은 컴퓨터 과학의 대표적 난제 중의 하나이다.
회로 배치에는 다양한 모델들이 있는데 우선 가장 간단한 게이트 어레이 모델부터 살펴 보자. 게이트 어레이 모델에서는 모든 셀이 바둑판 모양의 격자 상에 놓인다. 한 배치가 주어지면 이의 품질을 평가해 주어야 하는데 평가 기준으로는 앞에서 언급한 다양한 요구 사항이 있을 수 있다. 여기서는 와이어의 총 길이를 최소화하는 가장 간단한 모델을 대상으로 설명을 한다. 배치가 끝나면 각 네트 (net, 끝점이 두 개 이상인 간선) 의 끝점 (endpoint) 들이 자동으로 결정된다. 각 네트의 라우팅에 필요한 배선의 길이를 합한다. 그러나 임의의 네트를 위한 배선 길이를 측정하기 위해서는 실제 라우팅을 해보지 않고는 정확한 계산이 불가능하다. 왜냐하면 네트들끼리 서로의 배선 상황에 따라 영향을 받으므로 라우팅 자체도 배치 못지 않은 난제이기 때문이다. 그래서 배치 단계에서는 라우팅 이후의 상황을 예측할 수 있는 간단한 근사 계산법을 쓰는데 이 또한 다양한 방법이 있다. 대표적인 한 방법은 반윤곽박스 (half bounding box) 를 이용하는 것이다. 이 방법은 모든 끝점들 중 X 축과 Y 축 상에서 가장 바깥쪽에 있는 점들을 대상으로 직사각형을 그린 다음 이 직사각형 둘레 길이의 반을 이 네트의 라우팅 비용으로 계산하는 것이다. 그림 6.10 은 네트 하나를 예로 들어 이를 보이고 있다. dx 와 dy 를 합한 값이 이 네트의 반윤곽박스의 길이가 된다. 이보다 현실에 가까운 방법들이 있으나 실험 결과로는 이 방법이 의외로 좋아 많이 쓰이고 있다.
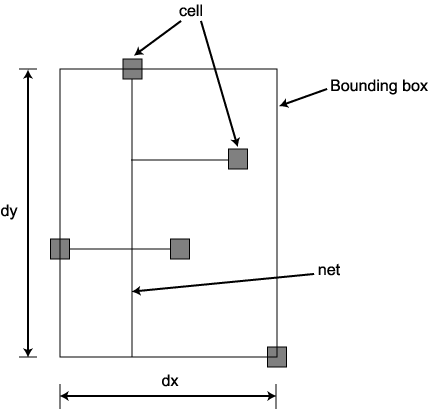
그림 6.10 네트의 끝점 배치와 반 윤곽 박스의 예
|
3 212 N 56 ... 386 234 51 23 .... |
|
3 |
212 |
N |
56 |
ㆍㆍㆍㆍㆍ |
386 |
|
234 |
51 |
23 |
|
ㆍㆍㆍㆍㆍ |
|
|
ㆍ ㆍ ㆍ ㆍ ㆍ |
ㆍ ㆍ ㆍ ㆍ ㆍ |
ㆍ ㆍ ㆍ ㆍ ㆍ |
|
ㆍㆍㆍㆍㆍ ㆍㆍㆍㆍㆍ |
|
그림 6.11 일차원 순서 기반 표현과 대응되는 배치의 예
그러면 이 게이트 어레이 모델에서 하나의 배치를 염색체로 표현하는 방법에 대해 알아보자. 먼저 전통적 일차원 표현 방법을 생각해 보자. 셀의 총 수를 N 이라 하고 각 셀이 1 부터 N 까지 색인된다면 그냥 이 N 개의 수를 순열로 늘어 놓는 것이 가장 간단한 방법이다. 이것은 2.5 에서 배운 순서 기반 표현의 한 예이다. 이것을 위치 기반 표현으로 나타낼 수도 있다. 위치 기반 표현에서는 예를 들면 한 유전자가 한 셀에 대응되도록 한다. 그림 6.11 의 배치는 아래와 같이 위치 기반 표현으로 나타낼 수 있다.
|
1 |
2 |
3 |
4 |
|
56 |
|
212 |
|
N |
|
ㆍ |
ㆍ |
1 |
ㆍ |
ㆍㆍㆍ |
4 |
ㆍㆍㆍ |
2 |
ㆍㆍㆍ |
3 |
즉, 셀 3 은 1 의 자리에 위치하고, 셀 56 은 4 의 자리에 위치하고, 셀 212 는 2 의 자리, 셀 N 은 3 의 자리에 위치한다는 뜻이다. 바둑판 상의 각 위치는 1, 2, 3, ... 으로 미리 번호가 매겨진다. 이차원의 표현도 가능하다. 배치되는 모양 그대로를 이차원의 격자형 염색체로 표현할 수 있다. 그림 6.12 는 그림 6.11 의 배치를 이차원 염색체로 나타낸 것이다. 실제로 배치되는 모양과 일치함을 볼 수 있다. 이 경우 교차는 3 장에서 배운 이차원 교차 연산자들을 사용하면 된다.
|
3 |
212 |
N |
56 |
ㆍㆍㆍㆍㆍ |
386 |
|
234 |
51 |
23 |
|
ㆍㆍㆍㆍㆍ |
|
|
ㆍ ㆍ ㆍ ㆍ ㆍ |
ㆍ ㆍ ㆍ ㆍ ㆍ |
ㆍ ㆍ ㆍ ㆍ ㆍ |
|
ㆍㆍㆍㆍㆍ ㆍㆍㆍㆍㆍ |
|
그림 6.12 그림 6.11 을 이차원 염색체로 나타낸 예
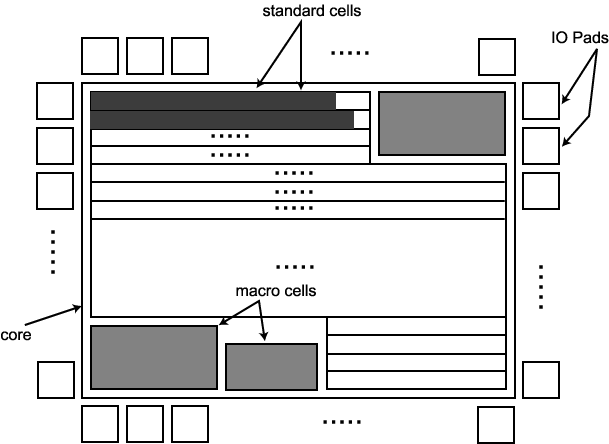
그림 6.13 표준 셀 모델의 전형적인 구성
다음은 보다 일반적인 표준 셀 모델 (standard-cell model) 을 소개한다. 그림 6.13 은 전형적인 표준 셀 모델의 배치 구조를 나타낸다. 그림에서 IO pad 들은 칩의 IO 단자에 리드를 통해서 연결되고 코어 구역으로의 모든 IO 는 pad 들을 통한다. 매크로 셀은 미리 디자인 해 놓았거나 라이브러리 형태로 제공되는 큰 셀로서 다소 복잡한 기능을 수행한다. 표준 셀은 간단한 단위 작업을 하는 셀 (예, NAND 게이트) 로서 높이는 고정되고 넓이는 셀에 따라 다르다. 전형적인 표준 셀 모델의 배치 작업에서는 먼저 수동 또는 자동으로 매크로 셀의 위치를 잡는다. 남은 영역은 표준 셀 높이에 근거하여 여러 행으로 나눈다. 이 행들에 남은 표준 셀들을 가장 효율적으로 배치하는 작업을 하게 된다.
이 모델에서의 셀 배치를 염색체로 표현하는 방법을 보자. 역시 순서 기반 표현과 위치 기반 표현이 가능한데 순서 기반 표현은 게이트 어레이 모델과 동일하다. 염색체는 N 개의 셀을 순서대로 늘어놓고 이 순서대로 위의 행부터 차곡차곡 채워 나간다. 각 행에 몇 개의 셀이 채워질 지는 미리 알 수 없다. 셀들의 넓이가 다양하기 때문이다. 그림 6.14 는 이의 한 예를 보인다.
위치 기반 표현을 사용하면 앞의 게이트 어레이 모델에서처럼 각 자리가 미리 고정되어 있지 않으므로 자리의 색인을 사용할 수가 없다. 대신 아래와 같이 X, Y 좌표로서 각 셀의 위치를 나타낼 수 있다.
|
2 |
250 |
121 |
35 |
48 |
21 |
178 |
..... |
|
2 |
|
250 |
121 |
35 |
48 |
|
|
|
|
||
|
21 |
178 |
13 |
|
19 |
|
244 |
35 |
|
|
||
|
..... |
|
|
|||||||||
|
..... |
|
||||||||||
|
..... ..... |
|||||||||||
그림 6.14 표준 셀 모델의 순서 기반 표현의 예
|
1 |
2 |
3 |
4 |
5 |
ㆍㆍㆍ |
N |
|
(2, 480) |
(0, 0) |
(0, 125) |
(8, 2390) |
(16, 120) |
|
(1, 1200) |
여기서 (x, y) 의 x 는 각 행의 색인이고, y 는 실제 도면 상의 Y 좌표값이다. 표준 셀의 높이가 같으므로 행으 번호만으로 실제 x 좌표를 알 수 있으므로 X 좌표 대신 간단한 표현을 사용할 수 있다. 이 경우는 셀이 중복되는 부분에 대해 보수를 하거나 페널티를 주는 방법이 고려되어야 한다.
여기서 설명한 것은 VLSI 회로 배치 뿐만이 아니라 다양한 다른 배치 문제의 기본형이 될 수도 있다. 예를 들어 창고에 물건을 채워넣는 데 공간의 효율적 이용과 나중에 물건을 꺼낼 때 소모되는 비용을 최소화하는 등의 요구가 있을 수 있다. 이러한 3 차원 문제들에 위의 방법을 변형하여 적용해 볼 수도 있을 것이다.
VOD (Video-on-Demand) 서비스는 높은 대역폭이 필요하다. 광섬유는 이를 지원하는 만족할 만한 방법이지만 값이 비싸다. 비용절감을 위해 케이블을 필요할 때 분기시키면 케이블이 소모를 줄일 수 있다. 그러나 분기가 될 때마다 신호의 세기가 감소한다. 따라서 분기시킬 수 있는 최대 회수에 제한이 있게 된다. 그림 6.15 는 광섬유 케이블 배치의 한 예를 보인다. 그림에서는 총 32 고객의 위치가 고정되어 있고 이 고객들을 모두 연결하는 가장 효율적인 케이블의 배치 방법을 찾으려 한다. 중계 노드를 두어 케이블의 소모를 줄이려 하는데 primary node 와 secondary node 의 분기도의 곱은 32 를 넘을 수 없다. 문제는 케이블의 길이를 최소화하는 primary node 와 secondary node 의 위치 및 이들의 분기도, 각 노드에 연결될 고객을 결정하는 것이다. 한 노드와 고객간의 거리의 상한선도 있을 수 있다.
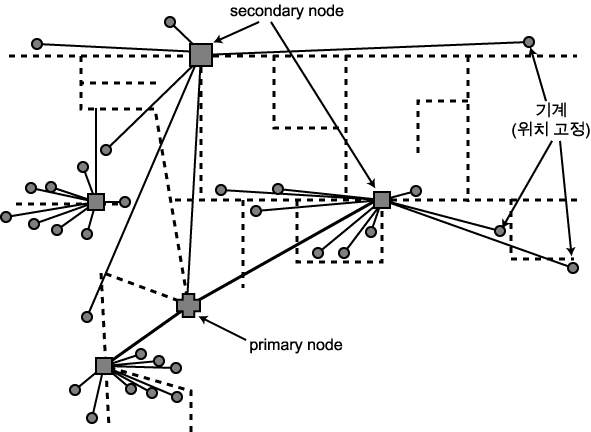
그림 6.15 광섬유 케이블 배치의 한 예
이 문제의 염색체 표현은 그리 간단하지 않다. 결정해야 할 사항이 하나가 아니므로 쉽지가 않다. 문제의 복잡도를 줄이기 위해 primary node 는 4 개의 secondary node 로 분기하고, secondary node 는 최대 8 고객까지 연결할 수 있다고 가정한다. 그림의 문제는 총 32 고객이므로 하나의 primary node 와 4 개의 secondary node 를 두면 된다. 임의의 배치는 아래와 같은 염색체로 표현할 수 있다.

위의 노드들의 위치를 나타내는 유전자들은 실수이거나 범위가 꽤 큰 정수를 사용할 수 있으며, 고객들의 분할을 나타내는 유전자들은 고객의 수만큼의 정수들을 순열로 늘어놓는 것이다. 성격이 다소 다르므로 서로 다른 교차 연산을 사용하는 것이 더 효율적일 수도 있다. 다음과 같이 염색체 쌍을 사용할 수도 있다.
|
|
|
|
|
|
|
5 |
1 |
13 |
23 |
2 |
8 |
13 |
19 |
28 |
..... |
고객들을 각 노드에 연결시키는 것은 기본적으로 분할 (partitioning) 문제이므로 보다 분할 문제답게 아래와 같이 표현하는 방법도 사용할 수 있다.
|
|
|
|
|
|
|
1 |
1 |
3 |
4 |
1 |
2 |
3 |
1 |
4 |
..... |
이 경우는 각 유전자가 한 고객과 대응되고 유전자의 값은 고객이 속한 (연결된) secondary node 의 번호를 나타낸다. 네 개의 secondary node 가 있으므로 각 유전자의 값은 1 부터 4 까지의 수 중 하나이고, 1 부터 4 까지의 수가 각각 8 번 출현하도록 제한을 두어야 한다. 반면 앞의 순열을 이용한 표현 방법은 1 부터 32 까지의 수가 한 번씩 나타나야 되는 제한이 있다.
이차원 공간에 N 개의 점이 주어진다. 이 점들을 다 잇되 이에 사용되는 간선의 길이와 총합을 최소화하려고 한다. 만일 사이클이 발생하면 그 중에 한 간선을 제거해도 연결 상태는 유지되므로 최소 비용의 연결은 트리 (tree) 형태를 갖게 된다. 이것은 유명한 최소 비용 스패닝 트리 문제로 O(|E|log N) 의 시간이 소요되는 간단한 문제이다 (|E| 는 간선의 총 수). 그냥 N 개의 점의 위치만이 주어진 경우에는 사실상 완전 그래프이므로 총 N(N-1)/2 개의 간선이 있는 셈이 되어 이 문제는 O(N2logN) 의 복잡도를 가진 문제가 된다. 그렇지만 실제로 최소 비용 스패닝 트리에 나타날 수 있는 간선은 상당히 제한되므로 실용적으로 알고리즘을 변형시키면 O(NlogN) 이면 충분할 것이다.
스타이너 트리 (Steiner tree) 는 위와 같이 모든 점을 연결하는 최소 비용의 방법을 찾되 비용 감소에 도움이 된다면 새로운 점을 추가할 수 있는 트리를 말한다. 이 문제는 통신 네트웍 디자인, 전력 배분 네트웍 디자인, 유류 파이프라인 설계, VLSI 회로의 라우팅 등 다양한 응용 예를 갖고 있다. 직교형 (rectilinear) 스타이너 트리는 수평 또는 수직의 간선만을 사용한 스타이너 트리를 말한다. 그림 6.16 은 여섯 개의 점을 연결한 최소 비용 트리와, 이에 두 개의 점을 추가하여 연결 간선의 총 길이를 감소시킨 스타이너 트리, 이에 두 개의 점을 추가하여 연결 간선의 총 길이를 감소시킨 스타이너 트리, 네 개의 점이 추가된 직교형 스타이너 트리의 한 예를 보인다.
직교형 스타이너 트리 문제는 주어진 N 개의 점을 연결하는 최소 비용의 직교형 직교형 스타이너 트리를 찾는 것이다. 대표적인 응용 예는 VLSI 회로의 라우팅이다. 이 문제는 바로 N 개의 점만으로 시작할 수도 있고, 쉽게 풀 수 있는 최소 비용 트리를 우선 구한 다음 이로부터 개선을 하는 방법을 사용할 수도 있다. 후자의 경우는 탐색 공간의 크기가 현저히 작아진다. 여기서는 후자의 방법을 사용하는 예를 보인다. 우선 최소 비용 트리를 구하면 이에는 N-1 개의 간선이 포함되어 있다. 수평선과 수직선만 이용하여 점들을 연결할 수 있으므로, 각 간선을 하나의 수평선과 하나의 수직선 쌍으로 연결하는 방법들의 조합들 중 최소의 비용을 가진 방법을 찾는다. 이것은 각 간선에 대해서 그림 6.17 과 같이 단 두 가지 중의 한 방법을 찾는 것이다. 물론 이것은 최소 비용 직교형 스타이너 트리를 보장하지 않는다.
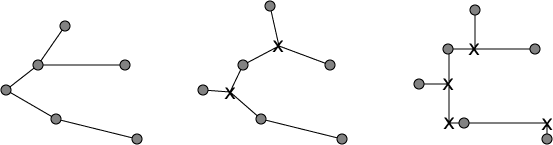
그림 6.16 최소 비용 트리, 스타이너 트리, 직교형 스타이너 트리의 예
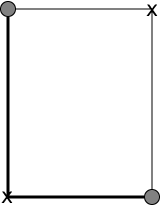
그림 6.17 간선을 직교형으로 바꾸는 두 가지 방법
최소 비용 트리가 반드시 최소 비용 직교형 스타이너 트리를 만들 것이란 보장은 없다. 그러나 이러한 것은 위의 방법으로 얻은 해에서 개선할 수 있는 가능성을 어느 정도는 알아낼 수 있으므로 실용적으로는 매력이 있다고 할 수 있겠다. 이것만으로도 총 2N-1 개의 후보해를 가진 공간 탐색 문제가 되어 매우 어려운 문제가 된다. 염색체는 아래와 같이 표현할 수 있다.
|
1 |
2 |
3 |
|
|
|
|
N-1 |
|
1 |
0 |
0 |
1 |
1 |
0 |
ㆍㆍㆍㆍ |
1 |
그림 6.17 의 두 가지 방법 중 왼쪽의 연결 방법은 0, 오른쪽의 연결 방법은 1 로 나타낼 수 있다. 앞에서 언급했듯이 최소 비용 스패닝 트리가 반드시 이런 식으로 스타이너 트리를 만들 때 최소 비용 스타이너 트리를 제공하지는 않는다. 따라서 최소 비용 스패닝 트리의 간선과 위의 연결 방법을 동시에 진화시키는 방법도 탐색 공간의 크기는 현저히 증가하지만 해 볼만한 방법이라 하겠다.
통신 매체의 급속한 발달로 인해 영상 (정리 영상 또는 동영상) 을 처리할 필요성이 급증하고 있다. 그러나 통신 대역폭의 제한과 저장 매체의 용량의 한계로 영상 정보 압축의 필요성도 따라서 급증하고 있다. 이를 위해 현재 정지 영상을 위한 표준인 JPEG 와 동영상을 위한 표준인 MPEG 시리즈가 제정되어 있다.
영상 압축을 시간적 필요성에 따라 구분하면 실시간 영상 압축과 오프라인 영상 압축으로 나눌 수 있다. 실시간 영상 압축은 유선 또는 무선의 생중계 방송이나 폐쇄회로 시스템 등과 응용을 들 수 있다. 이 경우 가장 중요한 것은 압축의 속도이다. 동영상의 속도를 따라가기 위해서라면 화질의 손실은 감수한다. 속도의 문제로 하드웨어에 의한 압축이 강력하게 요구된다. 오프라인 압축은 CD-ROM 의 제작이나 VOD 서비스, 폐쇄 회로 영상의 주기적 저장 등과 같은 응용을 들 수 있다. 이 경우는 압축에 사용할 수 있는 시간은 비교적 충분하므로 압축의 정도와 화질이 더 중요하다. 소프트웨어적인 압축도 무방하다. 벡터 양자화는 높은 압축율을 제공하면서 손실율을 다른 방법들에 비해 상당히 줄일 수 있는 잠재력이 강한 방법이다.
벡터 양자화는 현재 JPEG 이나 MPEG 에 표준으로 들어있지 않다. 이것은 압축하는 데 시간이 다소 많이 소요되는 벡터 양자화의 특성 때문으로 보인다. MPEG2 의 요구사항 중 실시간 응용에서는 150 msec 이하, 그 외의 응용에서는 500 msec 이하의 지연 시간을 허용한다는 규정 때문에 현재로서는 표준으로 채택되는 데 어려움이 있다. 그러나 실시간 재생은 절대적인 요구 사항이지만 실시간 압축은 모든 경우에 대해 절대적인 요구 사항이 될 필요는 없다.
영상은 많은 수의 픽셀들로 구성된다. 각 픽셀은 흑백 영상이면 한 비트로 표현되고, 흑백 그레이 영상이면 예를 들어 4 비트 정도로 16 등급의 명도를 사용할 수 있다. 칼라 영상의 경우 256 칼라이면 8 비트, 트루 칼라의 경우 24 비트나 32 비트를 사용한다. 640 × 480 영상의 경우 한 프레임을 24 비트 트루 칼라를 사용하여 그대로 처리하는 데는 7,372,800 비트, 즉, 7M 비트 이상의 정보가 필요하다. 고급 동영상의 경우 얼마나 막대한 정보가 필요한 지 짐작할 수 있다. 통신의 대역폭이 제한되어 있는 상황에서는 압축에 의해서만이 실시간 전송이 가능한 실정이다.
벡터 양자화 기법은 영상을 그대로 전송하는 대신, 전체 영상을 먼저 픽셀들의 블록 단위로 자른다 (예, 4 × 4). 다음에는 그리 크지 않은 (예, 256 엔트리를 가진) 코드북을 만든다. 코드북의 각 원소를 코드워드라 하는데 각 코드워드는 하나의 블록 패턴을 갖고 있다 (위의 예라면 4 × 4). 전체 영상 그 자체를 저장하는 대신 각 블록과 가장 유사한 코드북 상의 코드워드를 가리키도록 함으로써 영상을 표현하는 데 필요한 정보를 현저히 보인다. 이 기법에서 영상의 품질을 좌우하는 것은 코드북의 내용이다. 원 영상과 압축 후 회복한 영상의 차이가 최소화되는 코드북을 디자인하는 것이 벡터 양자화의 주목표다. 이 결과에 run-length encoding 기법 등을 사용하여 추가로 압축할 수도 있다. 코드북의 생성은 전형적인 '조합론적 폭발' (combinatorial explosion) 에 해당하는 문제 공간의 크기를 가지는 난제이다. 이것을 고품질로 풀 수 있는 알고리즘을 하드웨어로 구현하는 것은 현재의 기술로는 거의 불가능하다. 그림 6.18 은 벡터 양자화의 원리를 시각적으로 보여준다. 최적의 벡터 양자화는 고도의 문제 공간 탐색을 요하므로 소프트웨어적인 해결책만이 진정한 고품질의 압축을 가능하게 한다.

그림 6.18 벡터 양자화를 이용한 압축의 원리
전기전자, 컴퓨터, 물리학 분야의 대표적 데이타베이스인 INSPEC 에서 1995 년부터 2000 년까지 등재된 video compression, image compression 에 관한 논문을 검색해 보면 18,000 여 편의 논문이 리스팅될 정도로 영상 압축은 폭발적인 관심을 끌고 있는 연구 분야이다. 그 중 벡터 양자화 관련 논문은 2,100 여 편이고, 유전 알고리즘과 관계 있는 벡터 양자화 논문은 50 여 편이 검색된다. 대단한 관심을 끌고 있는 주제이며 유전 알고리즘 관련 연구들은 상대적으로 초창기임을 알 수 있다.
유전 알고리즘을 이용한 벡터 양자화 알고리즘들은 제법 나와 있다. 지역 최적화 알고리즘과 결합한 혼합형 유전 알고리즘 [Zheng 등, 97], 어닐링과 유전 알고리즘을 혼합한 벡터양자화 알고리즘도 선보인 바 있고 [Delport, 96; Ostrowski & Ruoppoila, 97], 신경망과 유전 알고리즘을 결합하여 벡터 양자화 코드북을 만들기도 한다 [Jiang & Butler, 97]. 코드북의 탐색 시간을 줄이기 위해 트리를 이용하는 트리구조 벡터 양자화 알고리즘도 많이 연구되었고 [Buzok & Gray, 85], 트리 구조 벡터 양자화 알고리즘과 유전 알고리즘을 결합한 연구도 있다 [Tseng & Yang, 98]. 여기서는 이 중 LBG 알고리즘과 유전 알고리즘을 결합한 Zheng 등 (1997) 의 방법을 소개한다. 앞에서 언급했듯이 이러한 종류의 문제는 순수 유전 알고리즘으로는 한정된 시간 예산 내에 인상적인 결과를 얻기 힘들고, 실용적인 결과를 얻으려면 어느 정도 문제 자체에 대한 지식이나 휴리스틱이 유전 알고리즘에 스며들 필요가 있다.
복원된 영상과 원래 영상의 차이를 재는 방법 중에 가장 간단한 방법은 MSE (Mean Square Error) 로서 다음과 같이 계산된다.

여기서  와
 는 각각 원 영상에서의 벡터와 코드북상의 대응 벡터 (코드워드) 를 나타낸다.
이것을 사용하여 영상의 왜곡 정도를 나타내는 측도의 하나인 PSNR 을 다음과 같이
계산한다.

예를 들어 임의의 영상에서 픽셀의 값이 40 부터
244 까지 분포하면 PSNR 은  가 된다.
각 블록 (벡터) 이 코드북 상에서 대응되는 코드워드가 결정되면 최적의 코드북을 만드는 것은 어렵지 않다. 즉, 대응되는 모든 벡터들의 산술적 평균값을 코드워드로 삼으면 된다. 이렇게 되면 코드북 생성 문제는 각 블록들을 각 코드워드에 대응시키는 방법을 정하는 문제, 즉, 코드북의 사이즈가 k 라면 k-way 분할 문제가 된다.
염색체는 아래와 같이 표현할 수 있다.
|
21 |
21 |
20 |
13 |
30 |
1 |
125 |
ㆍㆍㆍㆍ |
각 유전자는 하나의 블록 즉 벡터에 대응된다. 유전자의 값은 해당 블록이 대응되는 코드워드의 번호를 가리킨다. 이것은 방대한 문제 공간을 가지므로 지역 탐색 휴리스틱과 결합하는 것이 자연스럽다. 대표적인 지역 탐색 알고리즘으로는 Linde-Buzo-Gray (LBG) 알고리즘 (1980) 을 들 수 있다. LBG 알고리즘의 구조는 아래와 같다.
|
Algorithm LBG // 초기 코드북 준비 벡터들을 k 개의 집합으로 분할한다. 각 집합에 대응되는 벡터들의 산술적 평균값을 코드워드로 삼는다. // 순환적 개선 go { 각 벡터가 가장 가까운 코드워드를 찾아 대응되도록 한다; 대응되는
벡터가 하나도 없는 코드워드 이 대응되는 코드워드를 찾아 해당 벡터들을 두 그룹으로 나눈 다음
그 중 한 그룹을 변화가 있는 코드워드들을 다시 계산한다; } while (종료조건) ; |
매 분할이 만들어질 때마다 위의 LBG 알고리즘을 사용하여 분할을 개선시킬 수 있다. 예를 들어, Zheng, Julstrom, Cheng (1997) 은 매 분할이 만들어질 때마다 위의 LBG 알고리즘의 do-while 루프를 단 1 회만 수행시키고 있다. 만들어진 솔루션의 품질 평가를 위해서는 위에서 소개한 PSNR 을 이용한다.


 가 존재하면 가장 많은 벡터들
 에 대응시킨다;