유전자 알고리즘의 응용
지능정보시스템 원론 : 정환묵 편저, 21세기사, 1999, Page 378~387
유전자 알고리즘은 신경망이나 퍼지와 비교하면 응용면에서는 다소 늦다고 할 수 있다. 그러나 유전자 알고리즘에는 매우 큰 가능성이 있다. 여기서는 순회외판원 문제(TSP : Traveling Salesman Problem), 배치설계 문제(LSI의 설계) 등의 조합 최적화 문제와 같은 응용에 대해서 설명한다.
신경망이나 퍼지와 마찬가지로 유전자 알고리즘의 응용으로서 과학, 공학, 비즈니스, 사회과학 등 많은 분야에서 연구되고 있다. [표 1]에 지금까지 실제로 유전자 알고리즘의 연구대상이 된 분야와 그 예를 나타낸다. Job Shop 스케쥴링이란 정해진 다수의 기계가 있고, 이들을 사용하여 여러개의 다른 일을 효율이 좋게 수행하는 스케쥴을 구하는 것이며, 실제로 생산현장 등에서 자주 나오는 문제이다.
|
[표 1] 유전자 알고리즘의 응용 분야 |
|
|
응용 분야 |
응 용 사 례 |
|
최 적 화 |
수치적 함수의 최적화, 가스 파이프라인의 최적화, 전력 송전망의 최적화, 컴퓨터 자판의 최적 배정 문제, 항공기 승무원 배정 문제, 순회 외판원 문제, 그래프 분할 문제, 유전자 정보 해석 |
|
설 계 |
VLSI 회로 설계, 비행기 날개의 공기 역학적 설계, 엔진 노즐의 설계, 컴퓨터 통신망의 최적 설계, 심장 박동기의 설계, 디지털 필터 설계, 퍼지 제어기 설계 |
|
인공지능 |
LISP 프로그램의 자동 생성, 문제해결 규칙의 자동 습득, 신경망 합성 및 학습, 패턴 인식, 자연언어 처리, 멀티에이전트 시스템 |
|
시스템 분석
|
시스템 동정, 케이오틱 시계열의 예측, 환율 변화 예측, 단백질 구조 분석, 재정 및 경제 분야의 예측 및 분석 문제 |
|
제어 및 로보틱스 |
이동 로봇의 경로 계획, 신경망 및 퍼지로직과 유전알고리즘의 결합에 의한 제어 |
예를 들면, 스케쥴링 문제는 기획, 설계, 생산, 재고관리 등에서 생기고, 경우에 따라서 매우 규모가 크고 동시에 복잡한 문제가 된다. 이러한 경우, 종래의 수리계획법 등의 방법에서는 대형 컴퓨터를 이용해도 해를 구하는 것이 곤란하다고 말할 수 있다.
순회 외판원 문제란 정해진 도시를 모두 한번만 방문하는 가장 짧은 경로를 구하는 문제이다. 여기서 유전자 알고리즘을 사용하여 해결하는 방법에 대해서 설명한다.
순회
외판원 문제의 해를 구할 경우에는 특히 교배 방법을 고려해야만 한다. 여기서는
그 이유와 대책 방법에 대해서 설명한다. 도시 A로부터 도시F까지
6개의 도시가 있다고 가정하자. 간단하게 하기 위하여 염색체가 도시의 방문 순서를
그대로 나타내고 있다고 한다.
예를 들면, 염색체가 C B D F A E인
경우
도시 C →도시 B → 도시 D → 도시 F → 도시 A → 도시 E
의 순서로 방문한다고 한다. 이러한 형태의 염색체를 2개 사용하여 일점교배(one-point crossover)를 수행해 보자.
교배는 4번째 심볼과 5번째 심볼 사이에서 수행되고 있다고 하면, 자식의 염색체는 다음과 같이 생성된다.
부모 1 : C B D F | A E → 자식 1 : C B D F | E C
부모 2 : A D F B | E C → 자식 2 : A D F B | A E
교배위치
교배위치
자식
1은 도시 C를 2회나 방문하지만 도시 A는 방문하지 않는다. 자식 2는 도시 A를 2회
방문하고, 대신에 도시 C는 방문하지 않게 된다. 교배에 의해서 해로서의 최저 조건을
만족하지 않은 것이다. 이러한 개체는 치사유전자(致死遺傳子)를 가지고 있다고 말할
수 있고, 해의 후보가 아니기 때문에 도태된다. 치사유전자가 발생하면 낭비가 많아지기
때문에 가능한한 발생하지 않도록 생각할 필요가 있다. 이러한 문제를 해결하기 위해서
코딩에 의한 방법과 고안된 교배법에 의한 방법이 제안되고 있다.
따라서
코딩에 의한 방법으로서 순서 표현(ordinal representation)을 설명하고, 교배법에
의한 방법으로서는 부분 일치 교배(partially matched crossover)을 설명한다.
(1) 순서표현(코딩에 의한 방법)
순서표현에서는
①
최초에 도시를 알파벳 순서로 늘어선 도시 리스트를 만들어 둔다.
② 다음에 방문 순서로 늘어선 도시가 알파벳 순으로 늘어선 도시 리스트의 왼쪽으로부터 몇 번째에 있는가를 조사하고, 그 숫자로 치환한다. 이때, 도시 리스트로부터 그 도시(알파벳)를 삭제하며, 이러한 조작을 반복하여 간다.
그러면, 예를 들어 설명하기로 한다. 처음에 도시를 알파벳 순으로 늘어선 도시 리스트를 만든다.
A
B C D E F
(방문순서 : 1 2 3
4 5 6)
앞의
부모 1(C B D F A E)를 코딩해 보자.
우선 도시 C에 주목하면 도시
리스트의 왼쪽부터 3번째에 있기 때문에 부모 1의 C를 3으로 치환한다. 동시에 도시
리스트 C를 삭제한다.
부모 1 : 3 B D F A E (도시 리스트 : A B D E F)
다음에 도시 B에 주목하면 도시 리스트의 2번째에 있기 때문에 부모 1의 B를 2로 치환하고 도시 리스트의 B를 삭제한다.
부모 1 : 3 2 D F A E (도시 리스트 : A D E F)
같은 조작을 반복해 가면
부모 1 : 1 3 2 2 3 1 1 (도시 리스트 : 0으로 되었다.)
부모 2에 대해서도 마찬가지로
부모
2 : A D F B E C (도시 리스트 : A B C D E F)
부모 2 : 1 3 4 1 2 1 (도시
리스트 : 0으로 되었다.)
이렇게 하여 표현된 2개의 염색체에 앞에서와 마찬가지로 일점 교배를 수행해 보자. 교배는 4번째 기호와 5번째 기호 사이에서 수행되었다.
부모 1 : 3 2 2 3 | 1 1 → 자식 1 : 3 2 2 3 | 2 1
부모 2 : 1 3 4 1 | 2 1 → 자식 2 : 1 3 4 1 | 1 1
교배위치 교배위치
자식 1, 자식 2 각각에 대해서 앞의 경우와 같은 조작을 실시한다. 예를 들면, 자식 1의 경우,
자식 1 : 3 2 2 3 2 1 (도시 리스트 : A B C D E F)
제일 왼쪽의 3에 주목하면, 도시 리스트 3번째는 C이기 때문에 자식 1의 3은 C로 치환할 수가 있다. 동시에 도시 리스트 C를 제거하는 조작을 반복해 간다.
자식 1 : C 2 2 3 2 1 (도시 리스트 : A B D E F)
그러면,
자식 1 : 3 2 2 3 | 2 1 → C B D F E A
자식 2 : 1 3 4 1 | 1 1 → A D F B C E
교배위치
가 되고, 각 도시를 모두 1회만 방문하는 순회 외판원 문제의 해로서 최저 조건을 만족하는 것을 알 수 있다.
(2)
부분일치 교배(교배법에 의한 방법)
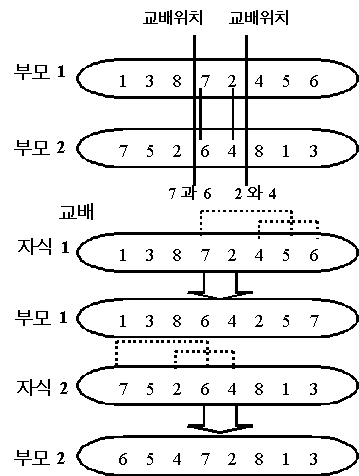
부분일치
교배에서는
■ 2개의 염색체에 있어서 교배시킬 부분을 결정한다.
■ 그리고 대응되는 심볼의 조를 만든다.
■ 2개의 염색체에 있어서 대응할 심볼끼리를 교환한다.
[그림 1] 부분일치 교배
[그림 1]은 부분일치 교배의 예를 나타낸다. 이 예에서는 7과 6, 2와 4가 교배 부분에 있어서 대응하고 있는 것을 알 수 있다. 따라서 각각의 염색체에 있어서 7과 6, 2와 4를 교환하여 넣음으로써 교배가 종료한다. 이 경우도 각 도시를 모두 1회만 방문하는 외판원 문제의 해로서 최저 조건을 만족하는 것을 알 수 있다.
■
순서표현
자식
1, 자식 2는 각각 부모 1, 부모 2의 교배 위치로부터 왼쪽을 계승한다. 그러나 오른쪽에
대해서는 자식 1은 부모 2의 끊어진 쪽을, 자식 2는 부모 1의 끊어진 쪽을 계승하게
된다. 특히 교배위치가 염색체의 왼쪽에 오면, 양친모두 유전 형질이 많은 부분을
잃어 버릴 위험성이 있게 된다.
■
부분일치 교배
치사
유전자의 발생을 방지하는 효과는 있지만, 순서표현의 경우와 마찬가지로 교배에
의해서 양친의 유전형질을 잃어 버릴 위험이 있다. 이들의 공통점은 유전자 알고리즘의
본질인 적목가설(참고)에서의 부품으로서의 적목이 파괴되는 위험성이 있다. 순회
외판원 문제에서의 "적목"은 부분적인 방문순서(subtour)가 있다. 이 부분
방문순서를 파괴되지 않도록 교배를 수행하려고 하는 아이디어(부분방문-교환 교배)를
여기서 소개한다. 부분방문을 파괴하지 않기 위하여 교배시 2개의 부모에서 공통의
요소를 포함한 부분을 찾아낸다. 이들을 교환 혹은 역순에 의해서 자식을 생성하는
것이다. [그림 2]에 부분방문 교환교배의 예를 나타낸다.
부모는
앞의 [그림 1]의 경우와 같다. 2개의 부모에서 공통의 요소를 가지고 있는 부분은
점선으로 둘러쌓여진 부분이다. 그와 관련하여 공통요소는 {2, 4, 5, 6}이다.
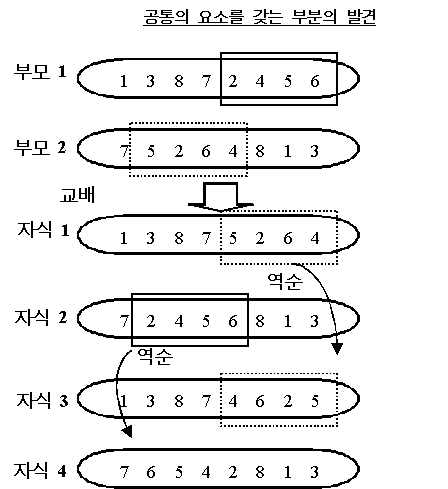
[그림 2] 부분방문의 교환교배
자식은 다음과 같이하여 생성된다.
자식
1 : 부모 1에 부모 2의 부분방문(점선부분)을 그대로 계승
자식 2 : 부모 2에
부모 1의 부분방문(점선부분)을 그대로 계승
자식 3 : 부모 1에 부모 2의 부분방문(점선부분)을
역순으로 계승
자식 4 : 부모 2에 부모 2의 부분방문(점선부분)을 역순으로 계승
부분방문 교환교배에서는 이렇게 하여 2개의 부모로부터 원리적으로 4개의 자식이 생성 가능하다. 이 방법은 유전에 있어 형질 유전을 중시한 방법이라고 말할 수 있다. 순회 외판원 문제 뿐만 아니라 다른 문제로의 응용이 충분히 가능한 아이디어라고 말할 수 있을 것이다.
|
적 목 가 설 |
|
나무로 모형 건물을 만들 때, 목재를 가공하여 만드는 것보다 이미 어떤 적목을 조합하여 만드는 쪽이 효율적이다. 유전자 알고리즘에서는 염색체 중에서 높은 적응도를 보여주는 부분을 적목에 비유하는 것이 가능하다. |
여기서는 단순하면서 효과가 큰 배낭(Knapsack)문제의 응용 예를 설명하기로 한다. 배낭문제란 [그림 3]에 보여주는 것과 같은 배낭에 물건을 넣을 때, 제한 용량을 넘어서지 않는 범위에서 채워 넣는 방법을 구하는(채워넣는 화물을 결정한다) 것이다. 이 문제는 언뜻 보아서는 예제를 위한 예제같지만, 실은 많은 응용예의 기초가 된다. 예를 들면,
■ 일정 예산 내에서의 물자의 구입
■ 종업원의 능력에 기초한 인사관리
■ 금융거래 의사결정(일정한 자금을 사용하여 위험이 최소가 되도록 하는 주식, 채권
등으로의 투자법을 결정한다.
■ 화물운송 시스템
등을
들 수 있다. 이들은 "어떤 조건을 만족하면서 최대의 효율을 20kg을 넘지 않는
범위에서 가능한 많이 채워넣는 조합을 구한다"고 하는 공통 부분이 있다. 따라서,
위의 예제 이외에도 많은 응용이 있다. 그러면, 배낭문제를 유전자 알고리즘으로
해결하는 방법을 설명하기로 한다.
[그림 3]과 같이 화물은 모두
10개이고, 그 중에서 20kg을 넘지 않는 범위에서 가능한한 많이 배낭에 넣는 조합을
구하기로 한다.
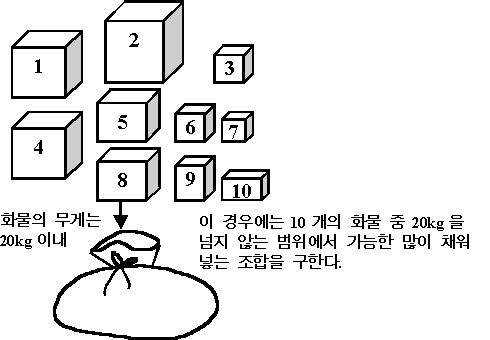
[그림 3] 배낭문제
(1)
유전자형의 결정
염색체의
각 비트를 각 화물에 대응시키기로 한다. 결국 어떤 비트가 1이면, 대응하는 화물을
배낭에 넣고, 0이면 넣지 않는다. 화물은 모두 10개이기 때문에 각 염색체는 10비트
길이의 2진 부호로 표현된다. 예를 들면, 어떤 염색체를 1010100001이라고 했을 때,
값이 1인 비트는(왼쪽에서부터 헤아려서) 1번째, 3번째, 5번째이기 때문에 화물 1,
화물 3, 화물 5, 화물 10을 배낭에 넣는 것이 된다.
(2)
적응도의 평가
적응도를
계산할 때에는
■ 개체가 조건을 만족하는 경우 →채워 넣는 화물의 용량의 합계
■ 종업원의 능력에 기초한 인사관리 →용량을 넘어서는 분량에 기초하여 적당하지 않는 값과
같이 설정하여 두면 해가 되지 않는 개체는 감소하고 해는 차례로 가장 적절한 해에 가까
워지기 쉽게 된다.
후에 선택이나 교배, 돌연변이에 관해서는 앞절에서 설명한 보통의 방법을 사용할 수가 있다. 화물의 수가 10인 경우는 조합의 수는 각 화물에 대해서 넣는지, 넣지 않는지 2가지가 있기 때문에 2의 10승, 즉 약 1,000이 된다. 이 정도이면, 하나 하나 조사하여 모든 조합에 대해서 조사해 가는 것이 가능하다.
그러나 화물의 수가 40개에 달하면, 조합의 수는 1조를 넘고, 55개가 되면 조이상의 단위인 즉 1경(1뒤에 0이 16개)이나 된다. 어떤 문헌에 의하면, 화물의 수가 50개인 경우, 모든 경우를 들어서 조사하는 단순한 방법과 비교하여 유전자 알고리즘에 의한 방법은 수만배 빠르다고 보고되고 있다. 또한 다른 문헌에 의하면, 화물의 수가 40개인 경우, 개인용 컴퓨터에서도 몇 초만에 해결할 수 있다고 보고되고 있다. 더욱이 모든 경우를 들어서 조사하는 단순한 방법과 비교하여 수십만배 빠르다고 보고되고 있다. 어느쪽으로 해도 배낭문제와 같은 "어떤 조건을 만족하면서, 최대의 효율을 거둘 수 있는 조합을 구하는 문제"는 유전자 알고리즘에 매우 적절한 분야라고 말할 수 있다.
유전자 알고리즘을 응용할 때의 요점은 다음과 같다.
①
문제가 유전자 알고리즘에 의한 해법에 적합한가를 판단
문제가
많은 조합 중으로부터 해를 구하는 것과 같은 성질을 가졌는가의 판단이 매우 큰
요점이다.
② 해의 명확한 평가법
해의
평가법이 불명확하면 각 개체의 적응도의 정의도 불명확하고, 무의미해지며 단지
많은 해 후보만이 얻어지게 된다.
더욱이 유전자 알고리즘에서는
적응도의 계산을 빈도로 수행하기 때문에 적응도의 계산이 복잡한 경우에는 아주
유효한 방법이 되지 않는다.
③
해를 유전자로 표현할 수 있는가
염색체
상에서 능숙하게 표현할 수 있는지 어떤지가 유전자 알고리즘의 큰 전제가 된다.
또한 그 때, 나무 쌓기(Building block)가설에 의한 효과를 고려할 필요가 있다. 동시에
염색체 상에서 가능한 간단하게 표현될 수 있도록 염색체 상으로의 문제의 표현을
연구하는 것이다.
또한
각각의 문제에 대해서 코딩 방법의 연구가 필요하다. 표현 방법의 좋고 나쁨에 따라
시스템의 특성이 크게 변하기 때문이다.
유전자형을 결정할 때에는
다음과 같은 사항들이 중요하다.
■ 해 후보는 모두 염색체로서 표현할 수 있을 것
■ 해 후보와 염색체는 1대1로 대응지울 수 있을 것
■ 부모의 형질을 교배에 의해 자식에게 적절하게 전해질 수 있을 것
④
다른 기술과의 조합
유전자 알고리즘의 문제점으로서 국소적인 탐색 능력이 없는 것을 들 수 있다. 따라서 다른
기술과의 조합이 매우 효과적이다.
⑤
실제 시스템에서 해가 구해지지 않았을 경우의 대응책
해를
항상 구할 수 있다는 보장이 없기 때문에 그 대책을 고려해둘 필요가 있다. 예를들면,
그 시점에서 가장 최적의 것을 해로서 간주하거나 혹은 다른 초기 집단을 사용하여
다시 반복하는 방법 등을 고려할 수 있다.