사고의 심리학 : 자연속에 인공의 개입
인공과학 : Herbert Simon 저, 이종범 역, 삼영사, 1987 년 (원서 : The Science of the Artificial, 2nd ed, MIT Press, 1981), Page 87~129
Ⅳ. 기억의 모수치들 : 일곱 개의 덩어리인가 아니면 두 개인가?
바람과 파도에 씻겨진 해변을 힘들이며 가고 있는 개미를 보자. 그는 앞으로 나아가다가 가파른 모래 언덕을 기어오르기 쉽게 오른쪽으로 각도를 바꾸고 조약돌이 나오면 빙 둘러가고 친구와 정보를 교환하기 위해 잠시 멈춰 선다. 기와 같이 멈칫거리고, 돌면서 자기 집으로 돌아간다. 그가 인간적인 의도를 가진 것처럼 생각하지 않기 위해 그가 간 길을 종이 위에 스케치 해 본다. 그것은 일정하지 않고 비뚤어진 부분들의 연속이지만 방향감각과 목표를 지향하는 의식이 밑바닥에 있기 때문에 완전히 무작정 걷는 것만은 아니다.
아주 이름도 붙이지 않은 그 스케치를 친구에게 보여주면서 "누가 간 길인가?" 를 질문한다면 그는 어떻게 대답할까? 가파르고 다소 바위로 된 비탈을 회전활강하면서 내려간 스키 선수라고 할까? 아니면 섬과 장애물들이 어지러운 해협을 맞바람을 안고서 거슬러 올라가는 돛대 달린 범선이라 할까? 아니면 아마 다소 추상적인 공간 속의 통로, 즉 기하하의 정리를 증명하려는 학생의 탐구과정이라고 대답할까?
누가 그 통로를 지나갔건, 어떤 공간 속을 지나갔건 왜 그것은 곧바르지 못한가? 왜 그것은 출발점에서 목표지점까지 곧바로 향하지 않았나? 개미의 경우에 있어서 (그 점에 관한 한 다른 것들의 경우에 있어서도) 우리는 그 이유를 안다. 개미는 집의 위치에 대한 일반적인 감각은 갖고 있지만 그 사이에 있는 모든 장애물들을 예견할 수는 없다. 그는 가는 도중에 그가 마주치는 역경들에 계속적으로 적응해야 하고 종종 넘을 수 없는 장벽들은 돌아가야만 한다. 그의 시계는 매우 좁다. 따라서 그는 모든 장애물들을 직접 마주치게 되었을 때에 해결해 나아간다. 그는 앞으로 나타날 장애에 대해서는 별로 생각하지 않고 그 장애물을 넘어가거나 돌아가는 길을 찾는다. 따라서 그를 아주 멀리 돌아가도록 함정에 빠뜨리는 일은 쉬운 일이다.
기하학적 도형의 관점에서 보았을 때 개미의 통로는 불규칙하고 복잡하고 묘사하기 어렵다. 그러나 그 복잡성이라는 것은 사실은 해변의 표면에 나타난 복잡성이지 개미 자신의 복잡성은 아니다. 똑같은 해변에서 그 개미와 같은 곳에 집을 가진 또 다른 작은 생물이 있다면 그도 아마 매우 비슷한 통로를 따라갈 것이다.
몇 년 전 그레이 월터 (Grey Walter) 는 수면을 탐색하고 전지를 충전시키기 위해 주기적으로 자기 보금자리를 찾아올 수 있는 전기장치의 "거북이"를 만들었다. 최근에 목표를 찾아가는 자동장치가 매사추세스 케임브리지에 있는 마빈 민스키 (Marvin Minsky) 교수의 연구실을 포함하여 몇 군데의 연구실에서 제작되어 왔다. 우리가 그러한 자동장치에 개미의 것과 비슷한 크기와 비슷한 운동수단과 비견할 수 있는 감각적 예민성을 부여하도록 설계한다고 생각해 보자. 그리고 그것에 몇 가지 단순한 적응능력을 주어보자. 즉, 가파른 언덕을 만나면 비스듬히 올라가려고 노력하고 이겨낼 수 없는 장애물을 만나면 빙 둘러가고 하는 등등 (부품들을 소형화하는 문제를 빼놓고는 현재 기술의 상태는 그러한 설계를 분명히 구체화할 수 있을 것이다.) . 그러면 그것의 행태는 개미의 행태와 얼마나 다르게 될까?
이러한 생각은 하나의 가설을 제안케 한다. 이 가설은 인공물에 대한 이전의 논의의 당연한 추론이기도하다.
개미를 하나의 행태체계로 보았을 때 그것은 매우 단순하다. 시간의 경과에 따른 행태의 외면적인 복잡성은 주로 그가 처해 있는 환경의 복잡성의 반영이다.
처음에 이 가설은 그럴 듯하게 보이기도 하고 그렇지 못하기도 하다. 이것은 경험적인 가설이다. 그 검증은 개미의 적응체계에 매우 단순한 속성들을 부가한 경우에 우리가 주어진 환경 또는 비슷한 환경 속에서 그들의 행태를 설명할 수 있는지를 살펴봄으로써 가능하다. 앞 장에서 자세히 설명한 이유로 볼 때 가설의 진. 위 여부는 보다 더 미시적인 관점에서 보아 개미가 단순체계인가 복합체계인가 하는 문제와는 별개의 것이 되어야 한다. 세포나 분자의 수준에서 볼 때 개미는 분명히 복잡하다. 그러나 내부환경의 이러한 미시적 부분들은 외부환경과 관련된 개미의 행태와는 거의 관계가 없을지도 모른다. 그러한 사실이 바로 자동화장치가 미시적 수준에서는 전적으로 다르지만 그 점에도 불구하고 개미의 전체적 행태를 모사할 수 있다는 이유가 된다.
이 장에서 나는 이 가설을 탐구해 보고 싶다. 그러나 "개미" 대신에 "인간" 이라는 단어로 대치해서 보고자 한다.
인간을 하나의 행태체계로 보았을 때 인간은 매우 단순하다. 시간의 경과에 따른 행태의 외면적인 복잡성은 주로 그가 처해 있는 환경의 복잡성이다.
이제 나는 나의 논의를 약간 한정하고 싶다. 분비선과 내장을 완전히 갖춘 "전인" 을 생각하기 보다는 논의를 호모사피엔스 (homo sapiens) , 즉 "생각하는 사람" 에 한정하고 싶다. 내 자신은 이 가설이 전인에게도 적용된다고 믿지만 처음부터 난점을 갈라내어 행태 일반을 분석하기보다는 인지작용만을 분석하는 것이 훨씬 신중한 방법일 것이다. (이 가설을 감정과 동기현상에 적응시켜 본 것은 "Motivational and Emotional Controls of Cognition" Psychological Review, 74 (1967) pp. 29 ~ 39 에 그리고 지각의 몇 가지 분야에 적용시켜 본 것은 "An Information - Processing Explanation of Some Perceptual Pheomena" British Journal of Psychology, 58 (1967) pp. 1 ~ 12 에 간략히 서술했다. 두 개의 논문은 Models of Thought, 1.3 과 6.1 에 재수록되었다. 그러나 이 두 가지 영역은 이 책에서 고려된 인지현상에 포함된 것보다 더 세련된 생리적 구조에 대한 논의를 필요로 하는 것처럼 보인다.)
또 하나의 한정을 가하고 싶다. 인간 존재는 적절한 자극에 의해 환기될 수 있는 거대한 정보량을 기억장치에 저장할 수 있다. 따라서 나는 이 정보를 저장하는 기억을 유기체의 일부이기보다는 유기체가 적응하는 환경의 일부로 보고자 한다.
단순한 가설에 어떤 선형적인 (a priori) 개연성을 부여하는 이유는 이미 앞 두 장에서 설명했다. 생각하는 인간은 하나의 적응체계이다. 즉, 인간의 목표는 그의 내부와 저장된 기억을 포함하는 외부의 환경 사이의 관계 (interface) 를 규정한다. 그가 효과적으로 적응을 하는 한 그의 행태는 주로 외부환경 (그의 목표에 비추어 볼 때) 의 특성을 반영하며 내부환경, 즉 그가 생각할 수 있도록 해주는 생리적 장치에 대해서는 몇 가지 한정적인 속성만을 밝혀 줄 것이다.
나는 이것의 이론적 논의를 자세히 반복하고 싶지는 않다. 오히려 인간의 사고과정의 영역에서 그것에 대한 경험적 검증을 하고 싶은 것이다. 특히 사고 하는 인간의 내부환경에 있어서 그의 사고를 문제 환경의 형태에 적응시키는 것을 제한하는 "내재적" 특성은 단지 몇몇에 지나지 않는다는 증거를 지적하고 싶다. 사고와 문제해결 행태에 있어서 그 밖의 모든 것들은 인공적이다. 즉, 그 모두가 학습되어지며 더 나은 설계의 고안과 기억저장에 의해 개선되어진다.
문제해결이란 종종 환경을 서술해 주는 다양한 가능성의 미로를 통한 탐색으로 서술되어진다. 성공적인 문제해결이란 그 미로를 선별적으로 탐색하고 그것을 다룰 수 있는 정도로 줄이는 것을 말한다. 암호수학문제 (cryptarithmetic problems) 로 알려진 수수께끼를 예로 들어보자. (암호 수학문제는 문제해결의 탐색을 위해 F. Bartlett 가 그의 Thinking (New York : Basic Books, 1958) 에서 최초로 사용하였다. 여기에서의 설명은 그의 연구와 또한 나와 Allen Newell 의 공동연구, Human Problem Solving, (Englewood Cliffs, N.J. : Prentice Hall, 1972) 의 8 ~ 10 장에 따랐다.)
DONALD
+ GERALD
————— D = 5
ROBERT
문제는 이러한 배열 속의 글자들을 0 에서 9 까지의 숫자로 바꾸어 놓는 것이다. 똑같은 글자는 모든 경우에 있어서 똑같은 숫자로 바뀌어지고 다른 글자들은 다른 숫자들로 바뀌어져서 결과적인 숫자의 배열이 산수문제로 정확히 풀려지게 해야 한다. 바로 위의 문제에 있어서 하나의 힌트는 글자 D 는 숫자 5 에 해당된다는 것이다.
이 문제를 바라보는 한 가지 방법은 10 개의 숫자가 10 개의 글자에 대입되어질 수 있는 10 ! 의 모든 경우를 생각해 보는 것이다. 10 ! 이라는 숫자는 현대의 컴퓨터로 볼 때 아주 놀랄 만큼 커다란 숫자는 아니다. 그것은 고작해야 3 백만을 약간 넘을 정도다 (정확히 3, 628, 800) . 가능한 모두를 체계적으로 대입하도록 설계되어지고 각각을 대입하고 검증하는 데 10 분의 1 초가 소요되는 프로그램은 그 일을 하는 데 기껏해야 약 10 시간 정도 걸릴 것이다. D = 5 라는 실마리만 있으면 단지 1 시간이면 족할 것이다. 나는 프로그램을 해보지는 않았으나 커다란 컴퓨터가 각각의 가능성을 조사하는 데 필요한 시간은 10 분의 1 초에 훨씬 못미치리라 생각한다.
인간이 이것을 할 수 있다는 증거는 없다. 각각의 대입을 해보고 검산해 보는 데 1 분은 걸릴 것이고 그가 어디에서 시작했는지 어떤 대입을 이미 해 보았는지 하는 것을 알아내기가 매우 어려운 것이다. 이미 한 계산을 적어놓기 위해 종이와 연필을 사용할 수는 있으나 그것은 속도를 훨씬 느리게 할 것이다. 이런 식으로 문제를 풀려면 1 주일에 40 시간씩 잡아 몇 년간의 일이 될 것이다.
망라적이고 체계적인 탐색을 문제를 해결하기 위한 방법에서 제외시키는 과정 가운데 인간은 인간능력에 대해 매우 포괄적인 가정을 한다는 데 주목하자. 우리는 단순한 산술적 계산이 시간이 든다는 것과 그 계산들은 병렬적으로 행해진다기 보다는 근본적으로 순차적으로 행해진다는 것과 새로운 지식은 몇분의 1 초 사이에 저장될 수 있으며, 이를 위해 거대한 기억량이 요구되지 않는다는 것을 전제로 한다. 이러한 전제들의 인간의 중추신경계의 생리학에 대해 무언가를 말해주기는 하지만 많은 것을 말해주지는 않는다. 예를 들어 두뇌 속에다 탁상용 계산기의 모든 속성들을 갖춘 새 하위체계를 집어넣어 두뇌를 개조한다면 그것은 뇌수술의 매우 뛰어난 공적, 또는 진보가 될 것이다. 그러나 그와 같은 급진적인 변화조차도 문제 환경 속의 행태를 설명하거나 예측하기 위해 관련된 전제들을 조금밖에 바꾸지 못할 것이다.
인간은 종종 DONALD + GERALD = ROBERT 문제를 푼다. 어떻게 그것을 푸는가? 환경을 표상하고 탐색은 행하는 데 어떤 대안적인 방법이 있는가?
탐색활동을 급격하게 줄이는 한 가지 방법은 앞서와 같이 체계적으로 대입하되 차례차례 글자에 숫자를 대입하여 대입을 끝까지 하기 전에 일치되지 않는 것을 찾아낸다. 그러면 어떤 가능한 대입은 그 전과정이 단번에 제외된다. 어떻게 그렇게 되는가 설명해 보겠다.
오른쪽에서 시작하여 글자 D, T, L, R, A, E, N, B, O, G 에 대치되는 숫자, 1, 2, 3, 4, 5, 6, 7, 8, 9, 0 까지를 차례로 대입시킨다고 생각해 보자. 이미 D = 5 라는 것을 알았기 때문에 가능한 숫자의 목록에서 5 는 빼어놓을 수 있다. 이에 T = 1 이라고 해보자. 오른편 옆을 조사해 보면 C 를 10 이나 0 이라고 할 때 D + D = T + C 이기 때문에 모순되는 것을 알 수 있다. 따라서 (D = 5, T = 1) 이 가능하지 않기 때문에 나머지 8개의 글자에 8개의 숫자를 대입하는 나머지 8 ! 의 대입은 제외시킬 수 있다. 마찬가지 방법으로 T = 0 을 제외한 T 에 대한 모든 가능한 대입은 나머지 글자에 대해서는 대입을 해보지 않고서도 제외시킬 수 있다.
그 기술은 덧셈에 의해서 더해지는 두 개의 숫자를 알게 되면 그 줄의 합계에 어떤 숫자가 대입되어야 하는가 하는 것을 직접 계산할 수 있는 편리함이 있기 때문에 더 진전될 수 있다. 이러한 진전으로 T 에 대해 여러 가지 숫자를 대입해 볼 필요도 없이 T = 0 라는 것이 D = 5 라는 것에서 직접적으로 도출될 수 있다. 이러한 기법을 사용하여 DONALD + GERALD = ROBERT 의 문제가 종이와 연필로 쉽게 풀려질 수 있다. 10 분이면 충분하다. [도표 3] 은 탐색의 맥을 조금 단순화시켜 보여주고 있다. 각각이 가지는 모순이 발견되는 곳까지 뻗어나간다. 예를 들어 (D = 5, T = 0) 라는 대입이 주어진 후에 L = 1 이라는 대입은 R = 3 이라는 결론을 끌어내는데 그것은 왼쪽 줄의 문제 배열에서 R = 3 이면 G 가 마이너스라는 것을 뜻하기 때문에 모순이 된다.
D = 5 T = 0 L = 1 R = 3 G < 0 ?
L = 2 R = 5 G = 0 ?
L = 3 R = 7 A = 1 E = 2 ?
A = 2 E = 4 ?
A = 4 E = 8 ?
A = 6 E = 2 ?
A = 8 E = 6 ?
A = 9 E = 8 ?
L = 4 R = 9 A = 1 E = 2 ?
A = 2 E = 4 ?
A = 3 E = 6 ?
A = 3 E = 6 ?
A = 6 E = 2 ?
A = 7 E = 4 ?
A = 8 E = 6 ?
L = 6 R = 3 G < 0 ?
L = 7 R = 5 ?
L = 8 R = 7 A = 1 E = 3 ?
A = 2 E = 5 ?
A = 3 E = 7 ?
A = 4 E = 9 N = 1 B = 8 ?
N = 2 B = 9 ?
N = 3 G = 0 ?
N = 6 O = 2 G=1
[도표 3] DONALD + GERALD = ROBERT 의 해결을 위한 가능한 탐색형태
[도표 3] 은 한 가지 면에서 지나치게 단순화하였다. E 의 값을 대입한 후 모순으로 끝나게 되는 모든 각각의 가지들은 실제로는 한 과정 더 가지로 연결되어야만 한다. 왜냐하면 이 경우들의 모순은 글자 O 에 대해 어떠한 대입도 일치하지 않는다는 것을 봄으로써 나타나기 때문이다. 이것을 결정하기 위해서 각각의 경우에 4 가지의 대입이 더 조사되어야만 한다. 따라서 완전한 탐색의 줄기는 68 가지로 될 것이다. —— 10 ! 이나 9 ! 에서 볼 때 얼마나 큰 개가인가?
체계적이고 망라적인 탐색에서 약간 벗어남으로써 거대한 공간이 아주 작은 공간으로 축소된 것이다. 그 벗어난 것이 내가 보여준 것처럼 그렇게 단순하지는 않다는 것을 고백해야겠다. 제시된 기법에 있어서 하나의 과정이 진행되려면 대입을 함으로써 나타난 모순들을 발견하는 것이 필요하다. 물론 이것은 "비교적 직접적인" 모순들을 의미하는 것이다. 왜냐하면 만약 우리가 직접이건 간접이건 모든 모순된 내용을 찾아낼 수 있는 빠른 방법을 갖고 있다면 그것은 거의 당장에 문제 해결을 찾게 해 줄 것이기 때문이다. 이 문제에 있어서 의나의 올바른 것 말고는 어떠한 대입들도 모순되기 때문이다.
직접적으로 모순을 찾아낸다는 것이 뜻하는 바는 다음과 같은 것이다. 새로운 대입이 이루어지면 새롭게 대입된 글자가 나오는 줄을 찾아봐야 한다. 가능하다면 각각의 그러한 줄들은 아직 대입되지 않은 글자에 대한 답을 주어야 하고 그렇게 해서 나온 답이 아직 대입되지 않은 숫자인가를 조사해 봐야 한다. 만약 대입되어 있다면 모순이 있는 것이다.
무작정 덤벼 드는 탐색을 우리는 탐색과 "논리" 가 결합된 체계로 대치하였다. 이러한 과정을 더 진전시킬 수 있을까? 해결방법에서 모든 시행 착오의 탐색을 완전히 제거시킬 수 있을까? 그것은 비록 모든 암호 수학문제에 대해 할 수는 없지만 이 문제에 대해서만은 가능하다는 것을 알 수 있다. (예를 들어 앞으로 서술되어지는 방법은 CROSS + ROADS = DANGER 라는 암호 수학문제의 탐색방법과 같은 것을 배제시키지는 않는다.)
우리들 앞에 놓여있는 문제를 푸는 데 모든 시행착오와 과정을 하지 않게 해주는 기본적인 생각은 체계적으로 오른쪽에서 왼쪽까지 숫자를 대입하는 것은 벗어나는 것이다. 그보다도 새로운 대입을 할 수 있거나 적어도 그 대입의 속성에서 충분히 새로운 추론을 가능케 하는 문제 배열의 줄을 찾아보는 것이다.
간단히 그 과정을 살펴보겠다. 앞에서와 같이 D = 5 에서 금방 T = 0 이라는 것을 추론해 낼 수 있다. 또한 1 이 다음칸으로 넘어가고 따라서 R 은 2 L + 1 로 홀수라는 것을 알 수 있다. 제일 왼쪽 끝줄의 D = 5 에서 R 은 5 보다 크다는 것을 알 수 있다 (R = 5 + G 이기 때문에 ) . 이 두 추론들을 연결시키면 R = 7 이거나 R = 9 가 된다. 하지만 이것들을 대입해 보지는 않는다. 그러면 이제 왼쪽 두 번째 줄이 O + E = O 라는 독특한 구조를 갖고 있다는 것을 알 수 있다. 즉, 하나의 숫자에 다른 것을 더했는데도 마찬가지로 있다 ( 그 줄 밖으로 무엇이 나갔거나 또는 안으로 무엇이 들어왔는가 하는 것은 별개로 하고) . 수학적 지식으로 보거나 실험에 의해서 이것은 E = 0 또는 9 일 때에만 사실이 될 수 있다는 것을 알 수 있다. 이미 T = 0 라는 것을 알고 있기 때문에 E = 9 가 된다. 이것은 R 의 두 가지 대안 가운데 하나를 제외시키게 되고 따라서 R = 7 이 된다.
E = 9 이기에 A = 4 가 되고 오른쪽에서 3 번째 칸에 1 이 하나 넘어가야만 한다. 따라서 2 L + 1 = 17, 즉 L = 8 이 된다. 이제 남은 것은 1, 2, 3, 6 을 N, B, O, G 에 대입시키는 것만이 남았다. O 에 어떠한 숫자를 대입하든 간에 숫자 하나가 맨 왼쪽 칸에 넘어간다는 것을 보고 G = 1 이라는 것을 알 수 있다. 이제 3 ! = 6 가지의 경우만 남았는데 그것은 기꺼이 시행착오로 도출해 낼 수 있을 것이다. 즉, N = 6, B = 3 이고 따라서 O = 2 가 된다.
탐색전략에 대한 세 가지 서로 다른 전제에서 문제의 미로를 통과하는 해결 통로를 추적해 봤다. 어떤 면에서 그 전략이 세련되면 될수록 탐색은 덜 필요하게 된다. 그러나 한번 전략이 선택되면 그 탐구의 과정을 문제를 푸는 사람의 어떤 특성에 달린게 아니라 문제의 구조에만 달려 있다는 사실을 주목하는 것이 중요하다. 이러한 문제환경에서 활동하는 사람이나 자동장치를 봄으로써 그에 대해 무엇을 알아낼 수 있을까? 우리는 당연히 그가 어떤 전략을 택했는가를 추론해 낼 수 있을 것이다. 그가 행한 실수와 그것을 극복하고 성공하는 것에서 우리는 그의 기억력과 기본적 과정들이 갖고 있는 능력 또는 정확성의 어떤 한계를 찾아낼 수 있을 것이다. 이러한 과정들의 속도에 대해 무엇인가를 배울 수도 있다. 유리한 조건이라면 우리는 생각할 수 있는 전략들 가운데서 그가 실제로 얻을 수 있는 전략과 어떤 상황에서 그것들을 얻기 쉬운가 하는 것을 알 수 있게 될 것이다. 우리는 분명히 그의 중추신경계의 신경학적 특성에 관한 어떤 특별한 것을 알 수는 없을 것이고, 그 신경계의 특별한 성격은 가능한 것에 대한 제약이 된다는 것 외에는 그의 행태와 관련되지도 않을 것이다.
우리가 제약과 한계라고 생각하는 것을 이같은 문제 상황에서 행태가 드러내는 대로 적극적으로 이야기해 보자. 그렇게 하는 동안 우리는 인간의 업무수행에 관한 실험상의 증거와 컴퓨터의 모의실험에 나타난 증거에 의존하게 될 것이다. 그 증거는 비교적 복잡한 것들 (암호수학, 장기, 정리증명) 에서 중간적인 것 (개념획득) 과 심리학 실험의 인기 대상인 단순한 것들 {기계적 어휘학습 (rote verbal learning) , 단기 기억폭 ( short - term memory span)} 에 이르기까지 다양한 인지상의 작업들에 관련된다. 이러한 매우 다양한 업무수행에 있어서 내부체계의 적응성에 대해서는 단지 적은 수의 한계만이 드러나며, 이것들이 근본적으로 모든 일들에 대해 똑같은 한계가 된다는 것은 매우 중요한 사실이다. 따라서 이러한 한계의 서술은 이질적인 (heterogeneous) 작업환경의 전역에 걸친 인간의 업무수행에 대해 단일하고 일관성 있는 설명을 제공해 준다는 것을 의미한다.
다음과 같은 일반적 파라다임 안에서 개념획득에 대한 광범위한 심리학적 연구가 수행되어져 왔다. (개념획득의 이러한 설명은 나의 후기의 동료인 Lee Gregg 과 함께 " Process Models and Stochastic Theories of Simple Concept Formation" Journal of Mathematical Psychology, 4 (June, 1967) pp. 246 ~ 276 논문에 기초를 두고 있다. 또한 A. Newell and H.A. Simon, "Overview : Memory and Process in Concept Formation, " Chapter 11 in B. Kleinmuntz (ed.), Concepts and the Structure of Memory (New York : Wiley, 1967) , pp. 241 ~ 262 를 보라. 전자는 Model of Thought, 5.4 장에 재수록되어 있다.) 자극은 단순한 기하학적 도안이 담겨진 일련의 카드인데 그것은 카드마다 여러 가지 차원, 즉 모양 (사각형, 삼각형, 원) , 색깔, 크기, 카드에서 그림의 위치등등에 따라 다양하게 나타난다. 하나의 "개념" 은 어떤 종별의 카드들에 의해 외연적으로 규정된다. 즉, 카드들은 그 개념의 각 국면을 나타낸다. 개념은 이들 각 국면이 공통으로 갖고 있으나, 다른 어느 카드가 갖고 있지는 않은 속성에 의해 내포적으로 규정되어진다. 그러한 개념들의 예로서는 단순개념에 속하는 "노랑" 이나 "사각형", 연언적 개념에 속하는 "초록색 삼각형" 이나 "크고 붉은 것", 선언적 개념들에 속하는 "작거나 노란" 등이 있다.
이곳의 논의에서는 각 차원에 두 개의 가능치를 갖고 하나의 관련 차원 (단순개념들) 을 가진 N - 차원의 자극을 사용한 실험을 말해보고자 한다. 각각의 시도에서 한 경우 (긍정적이거나 부정적인) 가 피실험자에게 주어진다. 그러면 그는 "긍정" 또는 "부정" 으로 대답하고 그는 그때 그때의 경우에 따라 "정" "오" 에 의해 강화되어진다. 이러한 종류의 전형적인 실험에 있어서 피실험자의 행태는 그가 실수 없는 수행을 할 때까지 시도한 숫자 또는 틀리게 대답한 숫자를 보고 되게 된다. 또한 몇몇 실험은 피실험자에게 그가 대답하는 데 대한 일정한 기준으로 사용하는 (만약 있다면 ) 내포적 개념들을 주기적으로 기록하도록 요구한다.
암호 수학문제에 있어서와 같이 이러한 상황은 매우 단순해서 우리는 피실험자가 가장 효율적인 발견전략을 사용한다고 가정하고 의도한 개념을 알아내는 데 평균적으로 얼마나 많은 시도가 필요한가를 미리 추정해 낼 수 있다. 어떠한 대답을 하는 피실험자는 시도할 때마다 실험자의 강화에 따라 그 자극이 실제로 그 개념의 한 국면인가 아닌가를 결정할 수 있게 된다. 그것이 개념의 한 국면이라면 그는 자극에 관련된 속성들 —— 예를 들어 그것의 색깔, 크기, 모양 등 —— 가운데 하나가 그 개념을 규정한다는 것을 알 게 된다. 만약 그것이 실제의 한 국면이 아니라면 그는 그것에 관련된 속성들 가운데 하나에 대한 나머지 (여집합) 가 그 개념을 규정한다는 것을 알 게 된다. 어떠한 경우든간에 각각의 시도는 가능한 단순개념들의 반은 제외시키게 되고 자극의 연속에 의해서 평균적으로 각각의 새로운 자극은 이전에 제외되지 않은 개념들의 약 반 정도를 제외시킨다. 따라서 올바른 개념을 찾아내는데 드는 평균시행의 숫자는 자극에 있는 자원의 수의 log 값에 따라 변화하게 된다.
만약 각각의 시도에 충분한 시간 (크게 보아서 1 분 정도) 이 주어지고 피실험자에게 종이와 연필이 있다면, 정상 지능을 가진 피실험자는 누구나 이러한 가장 효율적인 전략을 따르게 될 것이며 큰 어려움 없이 그렇게 해낼 것이다. 이러한 실험들이 실제로 행해질 때는 피실험자들에게 효율적인 전략도 지시되지 않고 종이와 연필도 주어지지 않고 각각의 연속적 자극에 대답하는 데 단지 짧은 시간 —— 주로 4 초 —— 만이 주어진다. 이 경우에 그들은 정확한 개념을 발견하기 위해 효율적인 전략보다 더 많은 시도를 해야 한다. 내가 아는한 비록 실험은 하지 않았지만, 훈련을 거친 피실험자조차도 종이와 연필 없이 4 초 안에 자극에 대답해야만 한다면, 효율적인 전략을 적용할 수 없으리라는 것은 매우 확실하다.
이러한 실험들은 인간의 사고에 대해 무엇을 이야기해 주는가? 첫째, 그 실험들은 인간들이 쉽게 배울 수 있는 영리한 전략들을 언제나 스스로 발견하는 것은 아니다는 것을 우리에게 알려 준다 (장기 참피언이 멍청한 수를 놓는 것을 보면 그것을 또한 알 수 있다.) . 이러한 사실이 알려주는 바는 있지만 매우 놀랄 만한 결론은 결코 아니다. 잠시 후에 다시 논의하겠다.
둘째로, 그 실험들에서 만약 자극이 매우 느리게 주어지지 않거나 피실험자가 기억을 돕는 외적 수단을 가질 수 없거나 또는 둘다 없다면 인간이 스스로 효율적인 전략을 적용할 수 있도록 기억 속에 정보를 저장하는 충분한 수단을 갖지는 않았다는 것을 알 수 있다. 다른 증거들에서도 인간은 실질적으로 무제한의 반영구적인 정보의 저장 (기이한 사실들을 거의 평생 동안 기억 속에 저장할 수 있는 그들의 능력에서 나타난 것처럼) 을 할 수 있다는 것을 알기 때문에 실험에 있어서의 분계점은 가능한 한 빠르게 축적할 수 있는 양이 적다는 것과 (소위 단기기억), 제한된 단기간의 축적에서 대규모의 장기간의 축적까지 항목들이 옮겨지는 데 시간이 걸린다는데 있는 것이다. (아마도 J.S. Bruner, J.J. Goodnow, and G.A. Austin, A Study of Thinking (New York : Wiley, 1956) 은 개념획득 작업의 수행에 있어서 단기기억의 한계들 (그들의 용어는 "인지상의 긴장" 이었다) 의 역할을 강조한 최초의 저작이었을 것이다. 그 작업은 또한 몇몇 피실험자의 전략들에 대한 다소 분명한 서술을 제공했다.)
다른 실험들의 결과에 의하면 약 7 개의 (또는 아마 4개 정도의 적은) 항목들만이 빠르게 단기기억 속에 들어올 수 있고 하나의 항목을 단기에서 장기의 축적으로 바꾸어 놓으려면 암 5 초에서 10 초 정도의 시간이 든다는 것으로 추정되어진다. 이러한 내용들을 조작화하기 위해서는 곧 "항목" 의 의미에 대해 그 개념을 좀 더 정확히 해야 한다. 우선은 단순개념이 하나의 항목이라고 가정하자.
종이와 연필이 없다고 하더라도 피실험자에게 만약 (1) 효율적인 전략이 지시되거나, (2) 각각의 시도에 있어서 자극에 대답하고 처리하는 데 20 초 내지 30 초가 주어진다면, 그는 효율적인 전략을 적응하는 것이 기대되어질 수 있을지도 모른다. 내가 실험을 해보지 않았기 때문에 이러한 주장은 하나의 예측으로 이론을 검증하는 데 사용될 수 있다.
또한 그 결과가 사소한 것이 아니라면 독자들에게 분명한 것으로 나타날 것이다. 만약 분명하다면 여러분이 나의 일반적 가정, 즉 대체로 인간의 목표 지향적 행태는 단순히 그 행태가 일어나는 환경의 모습을 반영하고, 그것을 예언하기 위해서는 인간의 정보처리 체계의 특성에 관한 단지 총괄적인 지식만 있으면 된다는 가정을 받아들일 때만, 그것은 명백하다는 것을 여러분에게 일러두고 싶다. 이 실험에서 관련된 특성들은 다음과 같이 나타난다. (1) 항목들 (또는 "덩어리" (chunks) 라고 앞으로는 부르겠다.) 의 숫자에 의해 측정된 단기기억의 용량, (2) 항목 또는 덩어리를 장기기억 속에 고정시키는 데 드는 시간, 다음 절에서는 이러한 특성들이 작업환경의 범위에 있어서 얼마나 일관성 있게 나타나는가를 탐구할 것이다. 그렇게 하기 전에 전략에 대한 피실험자의 지식과 훈련된 피실험자의 결과에 대해 결론적인 평을 하고 싶다.
전략들이 가르쳐질 수 있다는 것이나, 그렇게 배워진 전략들이 일의 수행을 엄청나게 변화시키고 그 효과성을 향상시킬 수 있다는 것은 결코 놀랄 만한 사실은 아니다. 모든 교육제도는 이러한 전제 위에 세워진 것이다. 이 전제들의 완전한 의미가 인지에 대한 실험을 하는 심리학자들에 의해 밝혀진 것은 아니다. 행태가 인간의 정보처리 체계의 "내재적" 특성보다는 학습된 기술의 함수인 한 행태에 관한 지식은 성격상 심리학적이라기보다는 사회학적인 것으로 보아야 한다. 즉, 인간이 특정한 사회환경 속에서 자라면서 실제로 무엇을 배웠는가를 밝히는 것으로 보아야 한다. 그들이 언제 어디에서 독특한 것들을 배웠는가 하는 것은 어려운 질문일 것이나 학습된 전략과 기초적인 생물학적 체계 속에 내장된 속성들을 혼동하지는 말아야 한다.
암호수학의 작업에 대해 바틀레트 (Bartlett) 와 우리 자신의 실험에서 얻어진 자료는 똑같은 점을 설명해 준다. 서로 다른 피실험자들은 정말로 그 작업에서 상이한 전략 —— 앞 절에서 간략히 다룬 전략의 모든 영역뿐 아니라 다른 것들도 —— 을 적용한다. 비록 전략의 정교함을 피실험자가 이전에 수학에 대해 얼마나 접해 봤고 또 편하게 생각하는가에 따라 직접적으로 다르게 된다는 것은 우리가 알아도 그들이 이것들을 어떻게 배웠고 작업을 수행하는 동안에 어떻게 알 게 되는가 하는 것은 정확히 모른다. 그러나 전략문제를 떠나서 암호수학의 작업에서 강하게 나타난 유일한 인간의 특성은 단기기억의 제한된 크기이다. 피실험자들의 전략들의 조합 (이러한 전략들에 대한 일반적인 반감 역시) 의 수행과정상 겪는 어려움의 대부분은 그러한 전략들이 단기기억에 가하는 심리적 부담감에서 기인한다는 것이다. 피실험자들은 그들이 어디에 있으며, 이전에 어떻게 대입했는지 그들의 조건부로 행한 대입에 내재하는 전제조건들은 무엇인가 하는 것을 잊어 버리기 때문에 쉽게 어려움에 빠지게 된다. 단기기억 속에는 단지 몇 가지 덩어리만을 보존할 수 있고 그것들을 장기기억으로 전환시키기 위해서는 주어진 시간보다 더 많은 시간을 필요로 하는 정보처리자에게 모든 어려움들은 필연적으로 일어나게 될 것이다.
우리가 논의해 온 몇가지 모수치 (parameter) 들이 인간의 인지상의 행태에서 드러나는 내부체계의 주요 한계들이라면, 이러한 모수치들의 양을 추정하고 그 양이 피실험자간 또는 과업간에 얼마나 차이가 큰가 또는 일정한가를 결정하는 것이 실험심리학의 주요 과제가 된다.
감각심리학 (sensory psychology) 의 몇 분야를 빼놓고는 심리학에 있어서의 전형적인 실험상의 파라다임들은 모수치는 추정하는 것보다는 가설을 검증하는 것에 더 관심이 있다. 많은 실험보고서들은 한 모수치의 값이 다른 것과는 "동의적 차이" 가 있다 —— 또는 그렇지 않거나 —— 고 주장하지만 값 그 자체에 대해서는 별로 언급이 없다. 사실상, 추론들 밑에 깔려 있는 모수치들의 수치에 대해서는 전혀 보고하지 않고서 분산분석의 결과나 유의수준만을 보고하는 나쁜 관습들이 종종 나타난다.
실험심리학에 있어서 발표하는 관습에 대해 반대를 하면서 또 하나의 불평을 더 털어놓겠다. 이론에 가장 관련깊은 행태의 척도를 선택하는 데 전혀 주의를 기울이지 않는다는 점도 두드러진다. 따라서 학습실험에 있어서 "학습률" (rate of learning) 은 대체로 무관심하게 "평가기준에 대한 시행의 숫자," "오류의 총수," "평가기준에 대한 총시간" 또는 다른 척도들에 의해서 보고된다. 구체적으로 20 세기 전반을 풍미하고 거의 오늘날까지 유행인 시간보다는 시행 숫자의 관점에서 학습률을 보고하는 관습은 내가 이제 논의하고자 하는 모수치의 놀라운 항상성 (constancy) 을 논의에서 감추어 버릴 뿐만 아니라 "한번의 시행" 대 "점진적인" 학습에 대한 무의미한 논쟁을 불러 일으켰다. (고정 모수치의 항상성에 대한 증거는 L.W. Gregg and H.A. Simon, "An Information - Processing Explanation of One - Trial and Incremental Learning" Journal of Verbal Learning and Verbal Behavior 6 (1967) pp. 780 ~ 787. H.A. Simon and E.A. Feigenbaum, "An Information - Processing Theory in Verbal Learning," ibid, 3 (1964) pp. 385 ~ 396 ; Feigenbaum and Simon, "A Theory of the Serial Position Effect" British Journal of Psychology 53 (1962) pp. 307 ~ 320. E.A. Feigenbaum 의 미발표 박사학위 논문인 "An Information Processing Theory of Verbal Learning," Pittsburgh : Carnegie Institute of Technology, 1959 와 그 안에서 인용된 참고문헌들에서 살펴볼 수 있다. 마지막 것을 제외한 모든 논문은 Models of Thought 에 재수록되어 있다.)
에빙하우스 (Ebbinghaus) 는 보다 분별력이 있었다. 그는 무의미한 음절의 학습에 대한 고전적 실험에 스스로 피실험자로서 참여하면서 서로 다른 길이의 연속된 음절을 학습하는데 드는 반복의 회수와 시간의 양을 모두 기록하였다. 만약 여러분이 수고스럽게도 그것을 계산해 본다면 그의 실험에서 한 음절당 시간이 약 10 초에서 12 초 정도 걸린다는 것을 알 게 될 것이다. (Herman Ebbinghaus, Memory (New York : Dover Publications, 1964) 1885 년 독일어판의 번역 특허 pp. 35 ~ 36, 40 , 51.)
나는 숫자를 왜 소수점 두 자리 —— 또는 심지어 한 자리 —— 에서 계산하는지 잘 모르겠다. 이 곳에서 항상성이란 크기의 정도에 대한 아마도 둘 가운데 한 인자에 대한 항상성을 말한다 —— 즉, 빛의 속도의 항상성보다는 절대온도 켈빈 263 ° 와 333 ° 사이에 있는 평상온도의 항상성과 오히려 더 잘 비견될 수 있을 것이다. 둘 가운데 한 인자에 대한 항상성을 무시할 이유는 없다. 소리의 속도에 대한 뉴튼의 최초의 추정은 30 % 의 터무니없는 오차가 포함되었었고 (100년이 지난 후에야 제거되었다.) , 오늘날 소립자에 대한 몇가지 새로운 물리학적 "상수" 들은 훨씬 더 모호한 것이다. 어떤 근사치의 , 심지어는 매우 어림짐작의 항상성 아래에서, 측정하는 동안에 우리가 통제해야 하는 조건들을 알기만 하면 우리는 그 값을 정확히 규정할 수 있는 순수한 파라미터를 발견할 수 있으리라고 대체로 기대할 수 있다.
만약 그 항상성이 에빙하우스의 모수치 —— 여러 해 동안 그대로 유치되어 온 것이지만 —— 를 단순히 반영한다면 그것은 심리학보다는 전기에서 더 흥미있는 것이 될 것이다. 그러나 사실은 그렇지 않다. 예를 들어 보고된 바와 같이 스티븐스 (S.S. Stevens) 의 논문집 (Handbook) 안의 호브랜드 (Carl Hovland) 의 장에 있는 1930 연대의 헐 - 호브랜드 (Hull Hovland) 의 실험들 가운데 몇몇을 조사해 보면 대학 2 학년생들의 순차적인 예상방법에 의해 의미가 거의 없는 음절들을 머리 속에 고정시키는 데 10 초나 15 초 가량의 시간이 든다는 것을 다시 한번 (시간 대신에 시행이 기록되기 때문에 그것을 계산해 본 후에) 알 게 된다. 메모리 드럼의 속도가 증가될 때 (즉, 한 음절당 4 초에서 한 음절당 2 초로) , 평가기준에 대한 시행의 숫자는 비례적으로 증가하나 전체 학습시간은 근본적으로 일정하다.
이러한 곳에 중요한 것이 많이 들어 있다. 만약 과거의 넌센스 음절 실험이 이러한 관점에서 재음미된다면 많은 실험은 기본적인 학습상수가 음절당 약 15 초 정도임을 밝힐 것이다. 예를 들어 맥지오크 (J.A. McGeoch) 의 <인간 학습의 심리학> 에 보고된 실험을 여러분 스스로 계산을 해 볼 수 있다. 그러나 부젤스키 (B.R. Bugelski) 는 이 모수치의 항상성을 공식적 기록의 문제로 하고 그것을 확정하려는 직접적인 목적을 가진 실험을 해서 최초의 사람이었던 것으로 보인다. (B.R. Bugelski, "Presentation Time, Total Time, and Mediation in Paired - Associate Learning," Journal of Experimental Psychology, 63 (1962) pp. 409 ~ 412.)
나는 상수가 얼마나 "일정한가" 하는 것을 과장하지 않으려고 노력해 왔다. 그러나 한편으로 모수치 측정을 깨끗하게 하려는 시도는 좀처럼 시작하기가 어려웠다. 우리는 모수치의 값에 대해 중요한 영향을 미치는 몇 가지 변수들에 대해 확실히 안다. 그리고 이제까지 잘 제시된 이러한 결과들에 대한 이론적 설명도 갖고 있다.
우리는 의미있다는 것이 매우 중요한 변수라는 것을 안다. 높은 연상값을 가진 넌센스 음절들과 상호관련이 없는 한 음절의 단어들은 낮은 연상값을 가진 넌센스 음절들에 드는 시간의 약 1/3 이면 배울 수 있다. 연속된 문장은 상호관련이 없는 낱말의 연속들에 드는 시간에 대해 단어 하나당 약 1/3 의 시간이면 학습될 수 있다 (나중에 나온 숫자는 돈환 (Don Juan) 을 암기하는 에빙하우스의 실험에서도 알 수 있다. 의미를 가진 상징 (symbol) 하나를 암기하는데 드는 시간은 대체로 넌센스 음절에 관련된 시간의 10 % 정도이다.) .
우리는 유사성, 특히 자극에 있어서의 유사성이 고정화의 모수치에 미치는 영향이 유의성 (meaningfulness) 의 영향보다 다소 적다는 것을 안다. 또한 우리는 이론적 근거에서 그것의 크기를 추정할 수 있다.
이러한 것들과 기계적 단어학습에 관한 문헌에 보고된 다른 현상들을 설명하는 데 가장 성공적인 이론은 인간 행태에 대한 컴퓨터 모의실험으로 프로그램된 EPAM 이라 불리우는 정보 처리이론이다. EPAM 은 여러 문헌에서 자세히 소개가 되었기 때문에 우리의 분석과 관련된 한 가지 점을 제외하고는 이곳에서 그것을 논의하지 않겠다. EPAM 이론은 우리에게 "덩어리" 가 무엇인가를 이해하는 기준을 제공해 준다. 덩어리란 자극에 있어 최대로 익숙한 하부구조 (a maximal familiar substructure of the stimnlus) 를 말한다. 따라서 "QUV" 와 같은 넌센스 음절은 "Q", "U", "V" 라는 덩어리들로 이루어졌으나 "고양이" (CAT) 라는 말은 그것이 바로 매우 익숙한 단어이기 때문에 하나의 덩어리로 이루어진 것이다. EPAM 은 하나의 덩어리를 고정시키는 데 드는 시간에 있어서 항상성을 가정한다. 그 항상성은 경험적으로 덩어리 하나에 대해서 약 5 초, 또는 그보다 약간 시간이 더 드는 것으로 나타난다. 실제로 학습속도에 미치는 유의성, 친숙성과 유사성의 효과에 대한 EPAM 의 양적인 예측들은 덩어리에 대한 개념과 한 개의 덩어리를 고정시키는 데 드는 시간의 항상성의 대한 개념의 의한 것이다. (EPAM 이 검증되어진 대부분의 실험들은 단순한 인식보다는 회상작업에 관한 것이다. EPAM 은 고정성에 내포된 두 개의 하위과정들, 즉 분화학습 과정과 이미지 저장 과정을 포함한다. 인지란 주로 후자보다 전자를 내포하기 때문에 인지작업의 연구는 한 덩어리의 기억을 고정시키는 데 드는 시간이 5 초 이하라는 것을 보여주는 것은 가능하다. 사실상 월터 라이트만 (Walter Reitman) 과 메리 포터 박사 (Dr. Mary Potter) (사적인 의사교류) 의 실험보고에 따르면 피실험자가 매우 익숙한 대상들이나 그 사진을 금방 본 것을 저장하는데 드는 시간이 아마 1 초 또는 2 초 정도에 불과하다고 한다.
학습과 문제 해결 실험에서 계속적으로 나타나는 내부체계의 제한된 속성 가운데 두 번째는 단기기억에서 유지될 수 있는 정보의 양이다. 여기서도 관련단위는 덩어리이며 그 용어는 고정화의 모수치의 정의에서와 똑같은 의미를 갖는다.
밀러 (George Miller) 의 잘 알려진 논문 "마술의 숫자 일곱, 더하거나 빼기 둘" (George Miller, "The Magical Number Serven, Plus or Minus Two," Psychological Review 63, (1956) , pp. 81 ~ 97.) 에 의해서 숫자의 기억범위, 수 판단, 그리고 사물판별력에서 이미 알려진 이 모수치에 대한 관심이 집중되었다. 위의 세 가지 종류의 작업에 각각 서로 다른 세 가지의 모수치가 있다기보다는 단 하나의 모수치만이 있다는 것은 그가 논문을 쓴 그 당시처럼 그럴 듯해 보이지는 않는다. 우리는 이곳에서 숫자 범위의 다양성에 관한 작업만 고찰해 보겠다. 오늘날 모수치의 정확한 값이 7 인지 4 인지 —— 다소 범위가 너무 크다 —— 도 완전히 분명한 것은 아니다.
단기기억에 관한 최근의 실험들에서 나타난 것처럼 보이는 사실들은 이러하다. 한 피실험자가 일련의 숫자나 글자를 읽고 단지 그것들을 반복하도록 요구하게 된다면 일반적으로 그는 길이가 7 개나 심지어 10 개까지에 이르는 일련의 항목들을 정확히 기억해 낼 수 있다. 그가 항목들을 듣고 되풀이하는 사이에 아무리 단순한 것일지라도 어떠한 다른 작업이 끼어들 게 되면, 그가 유지할 수 있는 숫자는 2 개로 떨어진다. 친숙한 일상생활의 예부터 우리는 이 숫자들에 "전화번호의 상수" 라는 이름을 붙일 수 있다. 일반적으로 우리는 어떻게든 —— 심지어 우리 자신의 생각에 의해서도 —— 방해를 받지 않는다면 전화번호부를 보고 전화를 걸 때 7 개의 숫자를 기억할 수 있다.
실험에서 방해가 있었음에도 불구하고 두 개 이상의 덩어리들이 파지된 (retained) 것으로 나타났을 때 그 현상은 거의 언제나 앞절에서 논의한 메카니즘에 의해 간단히 설명될 수 있다. 즉, 일부 실험들의 결과를 통해서 설명할 수 있는 것은 —— 이미 밀러의 의해 지적된 바와 같이 —— 피실험자는 자극을 단기기억 속에 집어넣기 전에 더 작은 수의 덩어리로 재부호화 한다는 사실이다. 만일 10 개의 항목이 두 덩어리로 재부호화 된다면 10 개의 항목은 모두 파지될 수 있다. "너무 많은 것" 이 단기기억에서 파지된 것처럼 보이는 또 다른 실험에서는 사실상 피실험자에게 과도한 항목들을 장기기억으로 고정시킬 수 있는 시간이 주어진 것이다.
두 개의 예만 들겠다. 워 (N.C. Waugh) 와 노만 (D.A. Norman) 은 그들 자신과 다른 사람들의 실험을 보고했는데, 이에 따르면 방해가 나타날 때는 단지 처음 두 개의 연속된 항목만이 확실히 파지되고 나머지 항목들은 부분적으로 조금 파지된다. (N.C. Waugh and D.A. Norman, "Primary Memory," Psychological Review, 72 (1965) , pp. 89 ~ 104) 이 실험들에서 피실험자가 정보를 고정화하기 위해 요구하는 시간을 계산해 보면 5 초당 하나의 덩어리라는 장기기억으로의 이전율이 대부분의 나머지 현상들을 설명할 수 있으리라는 것을 알 수 있다. (이 설명은 워와 노만 스스로 제시한 이론적 모델과 전적으로 일치한다.) .
로저 셰퍼드 (Roger Shepard) 의 보고에 따르면 매우 긴 연속된 사진들 —— 주로 풍경들 —— 을 본 피실험자들은 (많은 것들 가운데서 선택을 하라고 하면) 그들이 본 것들을 매우 신빙성 있게 기억해 낼 수 있다. (Roger N. Shepard, "Rocognition Memory for Words, Sentences, and Pictures," Journal of Verbal Learning and Verbal Behavior, 6 (1957) , pp. 156 ~ 163.) 그 작업이 사물을 구분하는 단서들만의 저장을 요구하는 인지작업이고 또한 항목당 평균 시간이 약 6 초라는 점을 주목할 때, 그 현상은 우리가 제시하는 이론적 틀 안에서 전적으로 이해할 만하고 실제로 예측이 가능한 것이 된다.
고정화의 모수치와 단기간의 용량모수치 (short - term capacity parameter) 를 입증하기 위해, 그리고 이러한 모수치들이 기본적 심리실험에 의해 나타나거나 또는 나타날 수 있는 정보처리체계의 중요하고 거의 유일한 특성이 된다는 가정을 입증하기 위해 모든 실험의 목록을 다 열거할 것은 결코 아니다.
이것은 다른 모수치들이 없다거나, 그것들이 나타나고 또 추정되어질 수 있는 실험을 우리가 발견할 수 없다는 사실을 뜻하지는 않는다. 그것이 뜻하는 바는 인간의 행태는 정말로 단순하고 동시에 오직 환경만이 복잡한 상황에서는 인간행태를 지배하는 법칙 가운데서 커다란 복잡성을 찾아서는 안된다는 것이다.
우리의 실험에서 우리는 암산작업이 다른 가능한 모수치들을 고려하는 데 유용한 환경을 제공해 준다는 사실을 알았다. 단스로 (Dansereau) 가 수행한 작업을 보면 기초 산술문제를 풀고 중간의 결과를 고정시키는 데 요구되는 시간은 4 자리 숫자 x 2 를 암산으로 하는데 드는 전체의 시간 가운데 일부분 —— 아마 반 정도 —— 에 해당할 뿐이다. 대부분의 나머지 시간은 숫자들의 일시적으로 고정되어 있던 기억에서 다시 숫자들을 생각해 내고 그것들이 계산될 수 있는 단기기억 속의 위치에다 "놓는데" 사용되는 것처럼 보인다. 단스로의 작업을 통해서 우리는 이들 새로운 모수치들을 추정하고 그들 밑에 깔려있는 과정들을 어느 정도 이해하는 데까지 이르기를 바란다. (암산작업에 드는 전체시간에 대한 최초의 연구결과는 Donald F. Dansereau and Lee W. Gregg, "An Information Processing Analysis of Mental Multiplication," Psychonomic Science, 6 (1966) , pp. 71 ~ 72 에 보고되었다. 기억의 모수치에 관한 것은 Models of Thought 2.2 와 2.3 장에 최근까지의 것이 또한 자세히 논의되었다.)
이제 나는 어떤 실험에서 나타난 내부체계 —— 보다 더 "구조적" 이고 또한 덜 계랑적인 —— 의 또 다른 특성을 지적하고자 한다. 기억이란 일반적으로 "연상의" (associatiove) 형태로 조직되는 것으로 파악되지만 그 말의 의미는 정확하지 않다. 그것이 의미하는 한 가지 사실은 매클린과 그렉 (McLean and Gregg) 에 의해 드러났다. 그들은 피실험자들에게 학습되어야 할 목록 —— 구체적으로 순서가 뒤바뀐 알파벹의 24 자들 —— 을 주었다. 그들은 그 글자들을 한꺼번에 하나, 또는 셋, 넷, 여섯, 또는 8 개를 한 카드 안에 적어 넣음으로써 목록들을 덩어리짓도록 자극하고 유도했다. 모든 그룹지어진 조건 속에서 피실험자는 한번에 하나를 학습하는 조건에서 드는 시간의 약 반만에 학습하였다. (R.S. McLean and L.W. Gregg, "Effects of Induced Chunking on Temporal Aspects of Serial Recitation," Journal of Experimental Psychology, 74 (1967) , pp. 455 ~ 459.)
매클린과 그렉은 또한 학습과정이 하나의 긴 목록으로 기억되어지는지 각각이 더 짧은 목록으로 계층화된 덩어리의 목록으로 기억되는지를 확인하고자 했다. 그들은 이 사실을 목록으로 기억되는지를 확인하고자 했다. 그들은 이 사실을 피실험자가 목록을 암송할 때 특히 그들이 거꾸로 암송을 할 때 감정적으로 어떻게 항목들을 그룹짓는가 하는 것을 측정함으로써 알아냈다. 결과는 뚜렷했다. 알파벹들은 짧은 하위 연속들 (short subsequences) 의 연속으로 저장되어진다. 그리고 그 하위 연속들은 실험자들에 의해 주어진 덩어리들 또는 그 덩어리들보다 더 짧은 형태에 대응하게 된다. 그리고 자기 자신의 방법에 따르게 하면 피실험자들은 세 개나 네 개의 글자들로 된 덩어리들을 선호하는 경향이 나타난다 (기계적 학습에 있어서의 유의성의 효과에 관한 실험에서 이러한 길이의 덩어리들이 행하는 역할에 대해 다시 생각해 보라.) .
매클린 - 그렉 실험에서 사용된 재료는 일련의 상징들이다. 우리는 2 차원의 시각적 자극에 대한 정보의 저장 형태에 관해 비슷한 질문을 제기할 수 있다. (물론 매클린 - 그랙 (McLean - Gregg) 실험의 자극에서 글자들은 또한 2 차원적 시각자극이다. 그러나 그것들은 낯익은 덩어리들이고, 즉각적으로 인식되고 재부호화될 수 있기 때문에 그들의 1 차원적 성격이 실험에서 피실험자의 형태에 대해 어떤 역할을 수행한다고 생각할 이유는 없다. 물론 이러한 사실은 "명백하다," 그러나 우리가 어떻게 자극이 "내부에서" 처리되는가에 대한 일반이론을 이미 갖고 있을 때에만 그렇다.) 어떤 의미에서 기억과 사고가 시각적 특성을 나타내는가? 나는 "상이 없는 사고" (imageless thought) 에 대한 논쟁을 —— 논쟁이 일어났던 최초의 형태에서는 결코 —— 다시 하고 싶지 않다. 그러나 그 문제는 이제 그것이 세 기초에 그랬던 것보다는 훨씬 더 조작 가능해졌을 것이다.
내가 이 위험한 곳으로 들어가면서 유심론의 가장 강력한 반대자들조차도 나를 앞질렀다는 생각에 위안을 받는다. 예를 들어 스키너 (B.F. Skinner) 의 <과학과 인간행태> (Science and Human Behavior, 1953, p. 266) 에서 인용을 하겠다.
인간은 조건반사의 유형에 "있지 않은 자극을" 보거나 들을 수 있다. 즉, 그는 X 가 나타날 때뿐만 아니라 종종 X 를 수반하던 어떤 자극이 나타날 때에도 X 를 볼 수 있다. 저녁식사 종소리는 우리 입에 침을 고이게 할 뿐만 아니라 우리들로 하여금 음식도 보게 한다.
스키너 교수가 "음식을 본다" 는 말이 무엇을 뜻하는지는 정확히 모르지만 그의 말은 내가 그것에 의해 정보처리이론이 의미하는 바를 말할 수 있게 하는 힘을 준다. 이제 간단하게 질문에 실마리를 던져주는 데 한 가지 사용되어 왔던 한 가지 실험을 서술해 보겠다. 우리가 피실험자에게 아래의 시각적 자극 —— 마술의 4 각형 —— 을 외우도록 했다고 하자.
4 9 2
3 5 7
8 1 6
이제 자극을 치워 버리고 피실험자에게 그것에 대한 일련의 질문을 하여 그 대답에 대한 시간을 재보자. 3 의 오른편에, 1 의 오른편에 무슨 숫자가 있나? 5 바로 아래 무슨 숫자가 있나? 3의 오른쪽 대각선 위에 무슨 숫자가 있나? 이 질문들은 모두 똑같은 난이도를 가진 것은 아니다. 실제로 나는 그것들을 점점 어려운 순서로 배치했고, 첫 번 것보다 마지막 질문에 대답하는 데 분명히 시간이 더 걸리리라고 예상했다.
왜 그래야만 하는가? 만약 기억 속에 저장된 영상이 자극의 그림과 똑같은 형태라면 서로 다른 질문에 대해 대답을 하는 데 드는 시간에 커다란 차이를 기대할 수는 없다. 우리는 저장된 영상은 그림과 아주 다르게 조직된다고 결론내려야만 한다. 또 다른 가설은 그것이 목록구조라는 것이다. 즉, 예를 들어 매클린 - 그렉 실험의 자료와 일치하고 정보처리적인지 모델의 생각이 많이 담긴 가설이다.
예를 들어, 만약 저장된 것이 작은 목록들로 구성된 목록이라면, 즉 "꼭대기" 는 4 - 9 - 2, "중간" 은 3 - 5 - 7, "바닥" 은 8 - 1 - 6 이라는 작은 목록들로 구성된 목록이라면 경험적 결과는 쉽게 이해될 수 있을 것이다. "3 의 오른편에 무슨 숫자가 있나?" 라는 질문은 목록을 찾아내려가며 대답할 수 있다. 한편 "5 의 바로 아래 무슨 숫자가 있나?" 라는 질문은 두 개의 목록을 항목별로 연결시켜 가면서 대답할 수 있다. —— 앞의 것보다 훨씬 더 복잡한 과정이다.
물론, 의심할 여지없이 피실험자가 왼쪽에서 오른쪽의 관계뿐 아니라 위에서 아래의 관계 또는 대각선의 관계를 "학습" 할 수도 있다. EPAM 같은 이론은 왼쪽에서 오른쪽, 위에서 아래의 관계를 동시에 외우는 시간이 앞의 것만을 외는데보다 약 2 배가 더 들 것이라는 것을 예언할 것이다. 이 가설은 쉽게 검증되어질 수 있지만, 내가 알기로는 아직 검증되지 못했다.
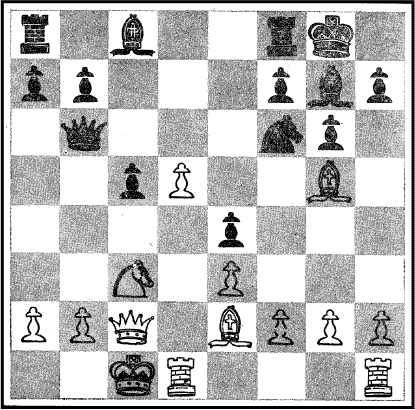
내가 방금 제시한 예와 똑같은 방향을 나타내는 "시각적" 영상저장의 성격에 관한 증거가 드구루 (A. de Groot) 의 장기 지각 (chess perception) 에 대한 유명한 실험에서 나타났다. (Adriaan D. de Groot, "Perception and Memory versus Thought : Some Old Ideas Recent Findings," in B. Kleinmuntz (ed.) , Problem Solving (New York : Wiley, 1966) , pp. 19 ~ 50. Models of Thought, 6.4 와 6.5 장에 수록된 Chase 와 Simon 의 논문을 보라.) 드그루는 실제 게임이 나타난 장기의 상태를 피실험자에게 5 초마다 제시했다. 그리고 그것을 치우고 나서 피실험자들에게 그것을 복기해 보라고 했다. 장기 명수들이나 대가들은 거의 틀림이 없이 그 상태 (판 위에 약 20 개 내지 약 24 개의 장기알들을 가진) 를 다시 만들어 나갈 수 있었지만, 못 두는 사람은 하나의 장기알도 올바로 놓을 수가 없었고 중간 정도의 기술을 가진 사람은 대가들과 못 두는 사람 사이의 어떤 수준에 머물렀다. 그러나 주목해야 할 사실은 대가들과 명수들이 똑같은 숫자의 장기알들로 되는대로 배열된 다른 장기판을 보고 그것을 복기하는 능력은 못두는 사람이 실제 게임의 판을 재구성하는 것보다 별로 나은게 없었다. 반면에 못 두는 사람들은 그들이 앞에서 했던 것과 비슷하게 두었다.
이 실험에서 무슨 결론을 끌어낼 수 있을까? 이 자료들은 장기 대가들이 시각적 영상에 어떤 특별한 재능을 가졌다는 가정과 일치하지 않는다 —— 그렇지 않다면 왜 그들의 복기가 형편없이 되었는가? 자료들이 강하게 제시하는 바는 장기판에 대한 정보는 64 칸에 대한 "텔레비전 주사 (television scan) 의 형태라기보다는 장기알 사이의 관계의 형태로 저장된다는 사실이다. 누구든지 심지어 장기명수조차도 10 초 안에 64 가지의 정보 (또는 24) 를 저장할 수 있다고 생각하는 것은 앞에 제시한 모수치들 —— 단기간의 기억에서는 7 개의 덩어리, 한 덩어리를 고정시키는 데는 5초 —— 과 일치하지 않는다. [도표 4] 에 있는 장기판을 복기해 낼 수 있게끔 그는 충분한 관계 (각각의 것은 익숙한 덩어리라고 가정하고) 에 대한 정보를 (단기, 장기 기억에서) 저장할 수 있다는 사실은 상당히 믿을 만하다.
도표 4 기억실험에 사용된 장기판
1. 검은 말은 K 의 기사를 보호하는 옆에 놓인 K 의 주교 (bishop) 와 함께 K 의 편에서 성을 구축했다.
2. 흰 말은 왕 바로 앞의 여왕을 중심으로 Q 의 편에서 성을 쌓았다.
3. K? 에 있는 검은 말 졸과 Q? 에 있는 흰 말 졸이 공격을 당해서 각각 K 와 Q 의 기사에 의해 방어되었고 흰 말의 여왕은 대각선으로 검은 말 졸을 공격한다.
4. 흰 말의 Q —— 주교가 KN? 에서 기사를 공격한다.
5. 검은 말 여왕이 자기의 QN₃에서 흰 말 K의 위치는 공격한다.
6. 검은 말 졸은 QB₄에 서 있다.
7. K₃에 있는 흰 말 졸은 반대편 검은 말 졸의 진격을 저지한다.
8. 양편이 각각 졸 하나와 기사 하나를 잃었다.
9. 흰 말 K —— 주교가 K₂에 서 있다.
언급되지 않은 장기알들은 처음 시작된 장소에 있는 것으로 본다. 열거된 몇 가지 관계들이 복잡하기 때문에 그것들을 하나의 "덩어리들" 로 보기 위한 몇 가지 이유들을 제시해야만 한다. 나는 대부분의 잘 두는 장기 선수들이 덩어리들을 그와 같이 본다고 생각한다. 덧붙여 말하면 나는 이러한 관계들을 그것들이 내 머리에 떠오른 순서대로 장기판에 대한 내 기억을 적어 내려갔다. 전문적 장기선수가 판을 보는 눈 움직임은 어떻게 관계들이 분석되고 저장되는가에 대한 이러한 분석을 입증해 준다. (Voprosy psikhologii, 1966, vol. 12 의 영어번역, O.K. Tikhomirov and E.D. Poznyanskaya, "An Investigation of Visual Search as a Means of Analysing Heuristics," in Soviet Psychology, Vol. 2 , No. 2 (Winter, 1966 ~ 1967) , pp. 3 ~ 15. Models of Thought, 6.2 와 6.3 의 장도 보라.) 눈 움직임에 관한 자료는 특별히 3 과 5 의 관계들을 분명히 보여준다.
나의 주제와 관련하여 시각적 기억의 논의가 지니는 의의는 시각화되는 많은 현상들이 세부에 있어 그 기초인 신경학에 의존하는 것이 아니라 기억 조직의 아주 일반적으로 추상적인 양상들 —— 기계적 학습과 개념획득현상의 정보처리이론들을 형성하기 위해 가정되었던 것과 근본적으로 같은 양상들 —— 에 근거해서 설명되고 예측될 수 있다는 것이다.
특히, 우리는 기억이 목록구조 (구성요소 자체도 목록이 될 수 있는 목록들) 의 조직이고 그것은 서술적 요소들 (2개의 용어로 된 관계들) 과 짧은 (3 개나 4 개의 요소로 된) 구성요소 목록들을 포함한다는 가설에까지 이르렀다. 이와 같은 조직 형태를 가진 기억은 "상징적" 자극 뿐만 아니라 시각적이고 청각적인 자극의 저장에 관련된 현상을 설명하기에 알맞는 속성들을 갖고 있는 것처럼 보인다.
인간 사고의 이론은 인간의 가장 특징적인 인지상의 기술, 즉 언어의 사용과의 관계를 피할 수도 없고 피해서도 안된다. 어떻게 언어가 내가 개관한 인지과정에 대한 일반적인 묘사라는 것과 심리학이 인공과학이라는 나의 일반적인 주제에 들어맞을 수 있는가?
역사적으로 변형언어학 (transformational linguistics) 의 현대이론과 정보처리적 인지이론은 동일한 모체, 즉 현대의 계수형계산기 발전에 의해 전개된 생각과 컴퓨터는 하드웨어로 구체화되지만 그것의 정신은 프로그램이라는 인식 속에서 발생한다. 변형언어학에 대한 최초의 논문과 정보처리 심리학에 대한 최초의 논문은 차례차례로 1956 년 9 월 M. I. T 에서 열린 회합에서 발표되었다. (N. Chomsky, "Three Models for the Description of Language," 와 A. Newell and H.A. Simon, "The Logic Theory Machine." 모두 IRE Transactions on Information Theory, IT - 2, No. 3 (September 1956) 에 수록) 따라서 두 개의 이론은 초창기부터 친숙한 관계를 갖고 있었고 그것은 두 이론이 개념적으로 인간 사고에 대한 동일한 견해에 입각하고 있기 때문에 아주 당연하다.
이제 어떤 사람들은 이것은 옳지 못하며, 그리고 그것들은 인간사고에 대해 거의 정반대의 견해에 입각하고 있다고 반대할지도 모른다. 내가 인간사고의 인공적인 성격, 즉 인간의 사고가 어떻게 지식의 개인적 학습과 사회적 전달을 통해 주어지는 환경의 요구에 스스로 적응하는가 하는 것을 강조했기 때문이다. 한편 형식언어학이론의 대표자들은 종종 "생득론자" (nativist) 의 입장을 취한다. 만약 어린아이가 태어날 때부터 언어에 대한 기술의 훈련을 위한 기본적인 장치를 자기 안에 갖고 태어나지 않았다면 언어를 말하고 이해하는 것 같은 그렇게 복잡한 기술을 얻을 수는 없을 것이라고 그들은 주장한다.
이 주제는 언어의 보편성에 대한 논쟁, 즉 알려진 모든 언어가 공통적으로 갖고 있는 특성이 있는가에 대한 논쟁을 생각나게 한다. 언어들 사이의 공통점은 결코 구체적이 아니며, 오히려 그것들은 모든 언어가 어떤 방식으로 공유하고 있는 것처럼 보이는 매우 포괄적인 구조적 특성들과 관련이 있다는 사실을 우리는 안다. 명사와, 동사 사이, 대상과 활동 또는 관계 사이의 구별 같은 것은 모든 인간의 언어에 나타난다. 모든 언어는 구문구조라고 불리우는 상자 안의 상자와 같은 성격을 갖고 있는 것으로 나타난다. 모든 언어는 변형에 의해 다른 언어에서 어떤 실마리를 끌어내는 것으로 나타난다. (언어 보편성에 대해서는 Joseph H. Greenberg (ed.) , Universals of Language (Cambridge : M. I. T. Press, 1963) , 특히 Greenberg 자신이 쓴 장 pp. 58 ~ 90 을 보라. "생득론자" 의 입장에 대해서는 Jerrold J. Katz, The Philsophy of Language (New York : Harper & Row, 1966) , pp. 240 ~ 282 를 보라.)
이제 우리가 이것들을 생득론자가 주장하는 전형적인 보편성으로 받아들인다 하더라도, 그 논의에는 적어도 두 가지의 서로 다른 가능한 해석이 남아 있게 된다. 그 가운데 하나는 언어능력이란 순전히 언어학적이고, 언어란 독자적이며, 그것이 요구하는 인간의 능력이란 다른 활동에서처럼 모두 사용되게 되는 것이 아니라는 것이다.
생득론자의 입장에 대한 또 하나의 해석은 말을 하고 다른 사람이 말하는 것을 알아듣고 하는 것은, 모든 언어에 공통적이며 또한 말하고 듣는 것 외의 사고에 필수적인 중추신경계의 몇 가지 특성에 달려 있다는 것이다.
전자의 해석은 현대 언어학이론에 담겨진 인간능력에 관한 기본적인 가정들과 인간사고의 정보처리이론들에 담겨진 가정들 사이에 나타나는 눈에 띄는 평행적 성격을 설명해 주지 못하지만 후자의 해석은 그것을 해준다. 내가 앞에서 인간 기억의 구조에 관해 만든 가정들은 언어를 다룰 수 있는 처리체계에 대한 가정들과 같은 종류의 것이다. 사실 두 분야 사이에는 광범위하게 서로 빌려오는 것이 많았다. 둘다 기억 조직의 기본적 원칙에 따라 계층적으로 조직된 목록구조를 가정하고 있다. 둘다 연속적으로 작동하는 처리자가 어떻게 일련의 상징들을 목록구조로 바꿀 수 있고 또 목록구조를 일련의 상징들로 바꿀 수 있는가 하는데 관심을 기울이고 있다. 양 분야에 있어서 같은 종별의 일반적인 컴퓨터 프로그래밍 언어가 현상을 모형화하고 모의실험하는 데 편리하다는 것이 증명되었다.
언어학이론과 사고의 정보처리이론들 사이의 관계가 과거에서보다 앞으로 더 가까워지게 되는 한 가지 방법을 제시하겠다. 지금까지 언어학이론은 주로 구문론과 문법이론이었다. 그것들을 자동번역과 같은 작업들에 실제 적용하는 데 있어서 번역이 구문의 실마리 이상의 것에 의존하게 될 때 —— 즉, 문맥이나 "의미" (meaning) 에 의존하게 될 때 —— 어려움에 직면하게 된다. 언어학의 진보를 위한 중요한 방향의 하나가 구문을 보충하기 위한 적절한 어의학 (semantics) 의 개발이라는 사실은 상당히 분명하다.
내가 대충 살펴본 사고의 이론은 이미 그러한 어의적 요소의 중요한 부분을 제공할 수 있다. 내가 서술한 기억 조직의 원칙들은 언어적인 연쇄와 2 차원적인 시각적 자극 또는 다른 비언어적 자극의 내적 표상을 논의하기 위한 기초로서 사용될 수 있다. 몇 가지 종류의 자극의 조직에 대해 이러한 비교될 수 있는 기초가 주어지면 언어의 해석에 있어서 구문적인 실마리와 어의적 실마리의 협동을 개념화하는 것은 더욱 쉬워진다.
최근에 이에 대한 몇 가지 연구조사가 M. I. T. 와 카네기 - 멜론대학에서 수행되어졌다. 이들 가운데 두 개를 언급하고 싶은데 그것들은 이러한 접근방법이 어떻게 어의상의 실마리를 사용함으로써 구문상 모호한 것의 해결을 설명해 주는가를 보여준다.
스테픈 코울즈 (L. Stephen Coles) 는 1967 년 완성된 학위논문에서 구문상의 모호함을 해결하기 위해 브라운관 위에 그림을 사용하는 컴퓨터 프로그램을 서술했다. (L. Stephen Coles 의 박사학위 논문인 Syntax Directed Interpretation of Natural Language, doctoral dissertation, Carnegie Institute of Technology, 1967. 요약된 것은 H.A. Simon and L. Siklossy (eds.) , Representation and Meaning (Englewood Cliffs, N. J. : Prentice Hall, 1972). ) 그가 실제로 사용한 것보다 생각해 보기에 쉬운 예를 갖고서 그의 방법을 설명해 보겠다. 다음과 같은 문장을 생각해 보자.
I saw the man on the hill with the telescope.
이 문장은 적어도 세 가지 가능한 해석을 갖고 있다. 물론 언어학자라면 다른 해석도 찾아낼 수 있을 것이다. 우리가 뽑은 세 가지 분명한 해석들은 각각 망원경의 위치에 관한 우리의 생각에 따른다. 즉, 내가 갖고 있는가? 언덕 위에 있는 사람이 갖고 있는가? 또는 그것은 그의 손 안에 있는 것이 아니라 그냥 언덕 위에 있는 것인가?
이제 그 문장에 [도표 5] 가 수반된다고 생각해 보자. 문제는 더 이상 의심의 여지가 없게 됐다. 분명히 망원경을 가진 사람은 나다.
코울즈의 프로그램은 그림 속에 있는 사물과 사물 사이의 관계를 인식할 수 있게 한다. 그리고 목록구조로 그 그림을 표시할 수 있게 한다. 그것을 앞의 예는 다음과 같이 서술할 수 있게 한다.
SAW (( I WITH (telescope)) (man, ON (hill))
그가 사용한 방법의 실제적인 자세한 내용은 되풀이하려고 하지는 않았지만, 위에 나타난 바와 같이 그림은 어휘연결의 다양한 어구분해를 막는데 쉽게 사용되고, 따라서 어휘연결의 모호성을 해결해 주는 데 사용되어질 수 있다는 것을 간단히 보여 주었다.
최근에 로렌트 시클로씨 (Laurent Siklossy, 사적인 의견 교환) 에 의해 완성된 또 하나의 프로그램은 어의적 정보가 언어의 습득에 있어 얼마나 도움을 줄 수 있는가 하는 것을 설명한다. (역시 Representiation and Meaning 에 재수록되어 있다.) 여러분들은 리차드 (I.A. Richards) 교수와 그의 동료들에 의해 개발된 "그림을 통한 언어" (Language Through Pictures) 라는 책들에 익숙하리라고 본다. 이 책들은 여러 나라 언어들을 위해 만들어져 있다. 매 페이지마다 그림이 있고 그 아래에는 배우고자 하는 언어로 그림에 대해 무엇인가 얘기해 주는 한 두 문장이 있다. 그림과 거기에 따르는 문장들은 연속적으로 매우 간단한 상황 ("나는 여기 있다," "저것은 사람이다.")에서 보다 복잡한 것 ("책은 선반 위에 있다.") 으로 나아가도록 꾸며져 있다.
시클로씨의 프로그램에서 투입은 <그림을 통한 언어> 책과 비슷할 것이다. 그림은 이미 내적 표상인 목록구조 (앞에서 코울즈 체계에 대해 설명한 것과 같은) 로 바뀌어졌다고 가정된다. 그 프로그램의 과제는 그러한 그림을 보았을 때 배우고자 하는 자연언어의 적절한 문장 —— 그림이 보여주는 것을 말해주는 문장 —— 을 말하는 것을 배우는 것이다 (그 방법이 실제로 테스트되었던 어떤 것보다도 약간 더 복잡해진) . 망원경에 관한 문장의 경우에 있어서 사람들이 그 그림에 대해서 만약 영어를 배운다면 "I saw the man on the hill with the telescope" 라고 하고 독일어를 배운다면 Ich habe dem Mann auf dem Berg mit dem Fernglas gesehen 이라고 그 프로그램이 응답하게 되기를 기대할 것이다.
물론 그 프로그램이 번역에 필요한 어휘와 문법을 이미 알고 있기만 하다면 정확하게 응답할 수 있을 것이다. 다른 경우에 있어서 그것의 어휘와 구문에 덧붙이기 위해 그림과 관련된 문장을 사용하게 될 것이다.
나는 몇 가지 선구적 실험들을 어의학의 포괄적 이론에까지 확장하고 싶지는 않다. 위의 예들의 요점은 보다 간단한 인지작업에서의 인간행태를 설명하기 위해 다른 이유에서 가정된 기억구조유형이 다음의 내용을 설명하는데 적합하다는 것이다. 즉, 어떻게 언어적 연쇄가 내적으로 표상되고, 어떻게 다른 종류의 자극도 그와 같이 표상되며 또 어떻게 표상의 공통성 —— 두 경우 모두에 대해 계층적으로 조직된 목록구조의 사용 —— 이 언어와 "의미" 가 동시에 인간의 머리속에 들어오게 되는가를 설명할 수 있는가에 대한 답을 하는데 적합하다.
그러면 인간은 태어날 때 언어를 습득하고 이용할 수 있는 능력을 소유하고 있다는 명제와, 언어는 가장 인공적이고 따라서 인간의 모든 구성물 가운데 가장 인간적이라는 명제 사이에 모순이 없게 된다. 앞의 명제는 내부환경이 존재하고 내부환경은 유기체가 할 수 있는 정보처리의 종류에 대해 한계를 정한다는 주장이다. 언어의 구조는 이러한 한계를 보여준다. 그리고 이런 한계가 여러 언어의 혼돈 속에 존재하는 공통성을 설명해 준다.
언어의 인공성에 대한 후자의 명제는 내부환경에 의해 부과되는 적응과 가능한 언어들에 대한 한계가 구문에 한정된 한계가 아니라 유기체에 대한 매우 폭넓은 한계라는 주장이다. 더군다나 이 명제에 의하면 그것들은 언어에 국한된 한계가 아니라 외부의 자극을 통하여 받아들여진 경험을 내적으로 표상하는 모든 다른 양식에도 부과되는 한계이다.
언어와 사고의 관계에 대한 이 견해는 표현할 수 있는 것만이 생각될 수 있다는 —— 지나치게 강한 형태로 표현된 —— "볼피안" (Whorfian) 의 가설에 새로운 빛을 던진다. 이 견해가 옳다면 다음과 같이 말하는 것이 옳은 것이다. "생각될 수 있는 것만이 표현될 수 있다." —— 내가 생각하기에 칸트가 매우 마음에 드는 것으로 생각했을 견해이다.
내가 이 장을 시작할 때 갖고 있던 명제는 다음과 같은 것이었다.
인간을 하나의 행태체계로 보았을 때 인간은 매우 단순하다. 시간의 경과에 따른 행태의 외면적인 복잡성은 주로 그가 처해 있는 환경의 복잡성의 반영이다.
마찬가지로 이 가설은 첫 장의 명제에 기초를 둔 것이었다. 즉, 그러한 행태는 목표에 적응하게 되고, 따라서 인공적이며, 적응을 제한하는 행태체계의 특성만 드러낸다.
어떻게 이러한 명제들을 검증하기 시작했고 동시에 인간행태의 기본이 되는 단순한 원칙들에 관한 이론을 세우기 시작했나 하는 것을 설명하기 위해, 나는 인간이 일을 수행하는 영역에서 몇가지 증거를 조사했고 특별히 심리적 실험에서 연구되어진 것들을 조사했다.
암호 수학문제를 풀고, 개념을 획득하고, 암기하고, 단기간의 기억에서 정보를 보존하고, 시각적 자극을 처리하고, 자연 언어를 사용하는 작업을 수행하는 피실험자들의 행태는 이러한 명제들을 강하게 입증해 준다. 인간행태의 인공성 —— 따라서 가변성 —— 은 일상생활의 관찰을 넘어선 증거를 요구하지 않는다. 따라서 실험은 (상이한 작업에 종사할 때) 인간의 정보처리체계의 조직에 나타난 광범위한 공통성을 밝혀준 점에서 대단히 의미가 깊다.
체계는 근본적으로 그것이 작동되는 데 있어 순차적이라는 증거는 압도적이다. 즉, 체계는 단지 몇 개의 상징만을 동시에 처리할 수 있고 처리되어지는 상징들은 내용이 급속히 변화되어질 수 있는 특수하고 제한된 기억구조에서 유지되어야만 한다는 것이다. 피실험자가 효율적인 전략을 택하는 능력에 있어서 가장 두드러진 한계는 단기기억구조의 매우 적은 능력 (4개의 덩어리) 과 한 덩어리의 정보를 단기기억에서 장기기억으로 옮기는 데 드는 상대적으로 긴 시간 (5초) 에서 일어난다.
우리가 주로 중추신경계의 단기기억과 순차적 처리능력을 행사하는 일들에 저장된 정보를 다시 돌이키는 일들로 옮겨가면 우리는 새로운 적응의 한계를 직면하게 되고, 이러한 한계들을 통해서 정신과 두뇌의 조직에 관한 새로운 정보를 얻게 된다. 시간적 인식과 자연 언어의 사용에 요구하는 일에 대한 연구를 보면 점점 더 분명히 기억은 실로 연상의 형태로 조직되어, 그 "연상점" (associations) 은 컴퓨터 용어로 "목록구조" 라고 불리는 것의 속성들을 갖고 있다는 사실을 알 수 있다. 그러한 속성들이 어떠한 것인지는 간략히 지적했다. 세세한 내용은 다음 장에서 다루어질 것이다.
이것들은 실험상의 증거에 나타나는 인간의 사고에 관한 몇 가지 일반화이다. 그것들은 우리의 가설에서 예견할 수 있는 것처럼 간단한 사실들이다. 더군다나 그 양상이 계속해서 확대되고 명확해질 것이지만 그것이 근본적으로 보다 더 복잡해지리라고 기대해서는 안된다. 인간의 자존심만이 우리 통로의 외면적인 복잡함이 개미 통로의 얽히고 섥힌 것과는 매우 다른 근원에서 나온다고 주장한다.
나의 접근방법 —— 내 명제 —— 의 재미있는 결과 가운데 하나는 내가 생리학에 대해서는 아무 말도 하지 않았다는 사실이다. 그러나 정신은 대체로 뇌 안에 자리잡고 있다고 생각된다. 나는 뇌의 구조에 대해 한 마디도 하지 않고 정신의 조직에 대해 논의했다.
이렇게 정신을 신체에서 분리한 중요한 이유는 물론 내가 방금 논의한 명제 때문이다. 컴퓨터의 하드웨어와 뇌의 "하드웨어" 사이의 차이가 컴퓨터로 하여금 다양한 종류의 인간 사고를 모의 실험하지 못하게 하지는 않았다. —— 사고 작용에 종사하게 될 때 뇌와 컴퓨터는 모든 주어진 환경의 형태에 자기 자신을 맞추어 나가려고 하는 적응체계들이기 때문이다.
만약 이와 같은 결론이 신경생리학은 인간의 행태를 설명해 주는 데 아무 기여도 하지 못한다고 오해된다면 그것은 불행한 일이 될 것이다. 또한 그것은 어리석은 주장이 될 것이다. 그러나 인공성에 대한 우리의 분석은 우리로 하여금 행태에 대한 생리학적 해석이 취해야만 하는 특별한 형태의 견해를 갖도록 해준다. 신경생리학이란 호모 사피엔스라고 불리는 적응체계의 내부환경에 대한 연구이다. 적응의 한계 —— 즉 왜 단기기억은 네 개의 덩어리로 한정되었는가, "덩어리" 에 대응하는 생리학적 구조는 무엇인가, 덩어리가 고정되어지는 5 초 동안에 무슨 일이 일어나는가, 연상구조는 뇌에서 어떻게 실현되는가? —— 에 대한 설명은 생리학에서 구해야 한다.
우리의 지식이 증가함에 따라 생리학적 설명과 정보처리 설명과의 관계는 생물학에 있어서 양자역학의 설명과 생리학적 설명과의 관계 (또는 컴퓨터 과학에 있어서 반도체 물리학과 프로그래밍의 설명과의 관계) 와 똑같은 것이 될 것이다. 그것들은 그들 사이의 상응성에서 나타나는 내부체계의 제한된 속성 (우리 앞에 있는 경우에) 과 함께 설명에 있어 두 개의 연결된 수준을 이룬다.
끝으로 정보처리심리학을 내부에 관한 생리학에 연결시킬 때 우리는 또한 심리학을 외부 —— 주어지는 환경의 면 —— 의 거대한 결합적인 영역에 대한 탐색의 일반이론에 연결시키는 것이 될 것이다. 그러나 그러한 것은 설계이론이 탐색의 일반이론이기 때문에 제 5 장의 주제가 된다. 우리가 그 주제를 취급하기 전에 설계자가 사용하는 거대한 양의 정보가 어떻게 인간의 정신 속에 저장되어 있고 접근되는가에 관하여 얘기하여야 한다.