기타 논리를 사용한 지식의 표기
인공지능 : Elaine Rich 저서, 유석인.전주식.한상영 편역, 상조사, 1986 (원서 : Artificial Intelligence, McGraw-Hill, 1983, Artificial Intelligence (2nd ed, 1991)), Page 187~216
(2) 충분한 증거가 없는 결정적 분야의 문제를 처리하는 기법
(3) MYCIN : 규칙을 토대로 추정에 의한 추론을 사용한 시스템
(4) 결론 : 확률적 추론 과정이 적합한 때는 언제인가?
지금까지 논의했던 것처럼, 서술 논리의 기법은 다양한 분야의 문제를 풀기에 적합하다. 그러나 서술 논리만으로는 중요한 정보를 적절히 표현하고, 처리할 수 없는 많은 분야가 있다. 표현하기 어려운 종류의 지식 몇 가지를 다음에 소개한다 :
"오늘 날씨가 매우 덥다." 이 때 더위의 상대적인 정도를 어떻게 표현할 수 있는가?
"금발 머리의 사람들은 흔히 푸른 눈을 가지고 있다." 이 경우, 확실성의 정도를 어떻게 표현할 수 있는가?
"모순을 나타내는 증거가 없다면, 여러 분이 만난 사람들은 누구든지 글을 읽을 줄 안다고 가정한다." 다른 사실이 존재하지 않는다는 것을 이용하여 이 사실을 추론할 수 있었다는 것을 어떻게 표현할 수 있는가?
"나는 쟈이언트팀이 이길 것이라고 철 수가 생각한다는 것을 알지만, 나는 쟈이언트팀이 질 것이라고 생각한다." 이 문장의 경우, 여러 개의 신뢰 시스템을 동시에 어떻게 표현할 수 있는가?
"체스를 둘 때, 상대방이 가진 것보다 더 많은 장기말을 장기판 위에 가지고 있는 것이 더 유리하다." 이러한 종류의 경험적 지식을 표현할 수 있는 방법은 무엇인가?
현실 세계에서는 신뢰 집합을 처리해야 한다. 각 신뢰는 여러 증거에 의해 뒷받침되며, 이를 유지하고자 하는 개인적인 동기에 의해 강화된다. 신뢰 집합 즉 신뢰 시스템은 불완전할 수도 있고, 또한 동시에 모순을 포함할 수도 있다. 프로그램을 사용하여 신뢰 시스템을 처리할 경우, 위에 소개된 종류의 정보를 처리할 수 있는 적절한 시스템을 구성해야만 한다. 퀸 (Quine) 과 유리안 (Ullian) 이 쓴 "The Web of Beliefs" 에서는, 신뢰와 신뢰 시스템을 구성하고 조사하여, 수정하기 위한 중요한 여러 기법이 논의되었다. 이 책 중에 소개된 예를 하나 사용하여, 중요한 많은 사항들을 설명하고자 한다 :
애버트 (Abbott), 배비트 (Babbit), 그리고 캐버트 (Cabot) 가 살인 혐의자로 주목받고 있다. 애버트는, 앨버니 (Albany) 에 있는 유명한 호텔의 숙박부에 그의 이름이 기재되어 있어, 살인 사건이 일어날 당시 알리바이를 가지고 있다. 배비트 또한, 그의 처남이 살인 사건이 일어났던 시간에 배비트가 브룩클린에 있는 그를 방문했다고 증언하여, 알리바이를 가지고 있다. 캐버트도 캣스킬스에서 열린 스키 대회를 관람했다고 그의 알리바이를 주장한다. 그러나 캐버트의 이런 주장을 뒷받침해줄 다른 어떤 사람도 없다. 이들 사실로부터, 다음 사항을 알 수 있다 :
(1)
애버트는 죄를 범하지 않았다.
(2) 배비트는 죄를
범하지 않았다.
(3) 애버트 혹은 배비트 혹은 캐비트가
죄를 범했다.
그러나, 이 때 캐버트의 알리바이를 증명해 주는 보고가 들어 왔다. 텔레비젼 방송국에서 이 스키 대회를 방영했는데, 이 프로그램에 캐버트의 얼굴이 나왔다.
이 새로운 사실은 다음 사항을 뒷받침한다 :
(4) 캐버트는 죄를 범하지 않았다.
(1)부터 (4) 까지의 신뢰는 서로 모순되기 때문에, 네 개의 신뢰 중, 적절한 신뢰를 하나 선택해 제거함으로써, 일관성있는 신뢰 시스템을 만들어야 한다. 가장 근거가 미약한 증거는 어느 것인가? 훌륭하고 명성있는 호텔의 숙박부에 이름이 기재되어 있기 때문에, (1) 의 근거는 믿을 만하다. 배비트의 처남이 거짓말을 할 수도 있기 때문에, (2) 는 근거가 부족하다. (3) 에 대한 근거는 두 가지 측면에서 살펴 볼 수 있다 : 강도에 의한 살인의 흔적이 없으며, 강도의 흔적이 없는 살인으로부터 이익을 얻을 수 있는 사람은 애버트, 배비트 그리고 캐버트 뿐이다. 강도의 흔적을 배제한다고 가정하더라도 사건의 해결에는 전혀 영향을 받지 않지만, 애버트, 배비트 그리고 캐버트 외에도, 이러한 살인으로부터 이익을 얻을 수 있는 다른 어떤 사람이 존재할 가능성이 있다. (4) 의 경우, 이 신뢰에 대한 근거는 확실하다. 왜냐하면 이 증거가 텔레비젼으로부터 얻어진 것이기 때문이다. 따라서, (2) 와 (3) 에 미약한 점이 있다. (1)부터 (4) 까지의 신뢰에 존재하는 모순을 해결하기 위해서는 (2) 나 혹은 (3) 을 기각함으로써, 배비트를 구속하던지, 혹은 새로운 다른 혐의자를 찾아야 한다.
이 후, 어떠한 사실이 어떻게 수정되는지 살펴 보자. 만약 (2) 를 기각한다면, 처남이 진실을 말했고, 배비트가 브룩클린에 있었다는 임시적인 신뢰를 수정해야 한다. 만약 (3) 을 기각한다면, 애버트, 배비트 그리고 캐버트를 제외한 어느 누구도 강도의 흔적이 없는 살인으로부터 이익을 얻지 못한다고 가정된 신뢰를 수정해야 한다.
따라서, 이러한 분석을 구성하기 위해서는 어떤 중재가 있어야 한다. 앞의 네 개의 신뢰로 이루어진 신뢰 시스템에서, 모순을 유발한 신뢰를 하나 선택하고, 다양한 더 많은 신뢰를 기본적인 증거로서 첨가하여, 현재의 상태를 보충한다 : 호텔 숙박부에 대한 신뢰의 정도, 호텔의 명성에 대한 신뢰의 정도, 텔레비젼에 대한 신뢰의 정도, 처남의 진실성에 대한 신뢰의 정도 등 등 여러 신뢰를 보충한다.
이 많은 신뢰를 하나의 목록으로 만들어 모순이 존재하는지 조사하고, 만약 존재한다면, 여러 방법을 사용하여 원하는 작업을 쉽게 할 수 있다. 제거할 신뢰 중 가능성이 가장 높은 네 개의 신뢰에 초점을 두고, 이 네 개의 신뢰를 제외한 나머지 신뢰들은 이 네 개의 신뢰 중 제거될 초점을 두고, 이 네 개의 신뢰를 제외한 나머지 신뢰들은 이 네 개의 신뢰 중 제거될 신뢰를 선택하는데 보조를 사용한다.
위에 설명된 방법은 일종의 분리에 의한 해결 (divide and conquer) 기법으로써, 상당히 효율적인 것처럼 보인다. 이 기법은 모순이 발생할 때까지 신뢰들을 수집하고, 일단 신뢰 시스템에 모순이 발생하면, 이 신뢰들 중 모순을 포함하는 가장 작은 신뢰의 집합을 찾는다. 예를 들면 (1) 부터 (4) 까지의 신뢰가 이러한 집합을 이룬다. 이 부분 집합에 포함된 신뢰 중 제거할 몇 개를 선택해야 한다. 부분 집합에 포함된 신뢰의 증거를 다시 검토하고 비교하여, 상당히 체계적인 방법으로 새로이 구성된 부분 집합을 이끌어 낸다. 결국 이 신뢰들 중에서 제거될 신뢰가 발견된다.
어느 시점에서, 증거에 대한 조사를 중단해야 하는지의 문제에 대해 살펴 보자. (1) 부터 (4) 까지의 신뢰에 대한 증거를 조사할 때, 기초를 이루는 여러 신뢰들을 수집할 수 있는데, 또한 이 신뢰들에 대한 증거를 찾기 위해 조사를 계속해야 한다. 그러나 실제적으로는 신뢰들 간에 만족할 수 있을 만큼의 일관성이 보여질 때까지 조사를 계속하여, 논의되고 있는 신뢰들 중에서 버려야 할 신뢰들을 찾아낸다.
위의 예는 불확실하고 애매모호한 정보로부터 기인되는 일부 문제들을 나타낸다. 컴퓨터 프로그램을 사용하여 이러한 문제들을 처리하기 위해 여러 기법들이 개발되었는데, 이 중 일부 기법들을 다음에 소개한다 :
이 장에서는 첫번째와 두번째 기법이 소개된다. 세번째 기법은 비록 상당히 잘 개발된 수학적 이론을 가지고 있지만, 인공 지능 프로그램에 성공적으로 사용되고 있지는 않다. 네번째 기법을 지식을 표기하는 여러 다른 기법에 매우 많은 영향을 받으며, 9-3 절에서 다루어진다.
서술 논리를 기본으로 한 전형적인 시스템은 참으로 판명된 언명의 수가 시간이 경과함에 따라 계속 증가만 하는 시스템이기 때문에, 단조적이다. 새로운 언명을 시스템에 첨가하고, 새로운 정리를 증명할 수 있지만, 이들 중 어느 것도 이미 알려졌거나 증명된 언명을 거짓으로 만들지 못한다. 이와 같은 시스템을 사용할 경우, 다음과 같은 장점이 있다 :
그러나 현실 세계에서 발생하는 문제들은 불완전한 정보와 변화하는 상황, 그리고 복잡한 문제를 푸는 과정에서 새로이 만들어지는 가정들 때문에, 위의 단조 시스템 (monotonic system) 을 사용해서는 처리가 어렵다.
유용한 모든 정보를 수집하여, 뜻하는 대로 충분히 사용할 수 있는 시스템은 거의 존재하지 않는다. 그러나 이런 정보가 부족할 때, 모순을 유발하는 증거가 존재하지 않는 한, 적절한 정보를 추론하여 사용할 수 있다. 추론하여 정보를 사용하는 기법을 결장 추론 기법 (default reasoning) 이라 한다.
예를 들어, 친구의 집에 저녁 식사 초대를 받아 가는 도중, 꽃 가게를 지나가게 되었다고 가정하자. 여주인이 꽃을 좋아할까? 여러분이 이 질문에 답할 수 있는 어떤 정보도 가지고 있지 않다고 가정해 보자. 그러나 대부분의 사람들이 꽃을 좋아한다는 일반적인 규칙을 사용하여 모순되는 증거가 없는 한, 상대방도 꽃을 좋아한다고 가정하여 적절한 행동을 취할 수 있다. 이러한 방법에 의해 유도된 언명은 어떤 다른 언명에 포함된 신뢰가 부족했기 때문에 얻어진 것으로, 이 결장 추론 기법을 비 단조적이라 한다. 즉, 만약 이전에 시스템에서 필요로 했지만 존재하지 않았던 언명 중의 하나가 시스템에 첨가된다면, 결장 추론 기법에 의해 얻어진 언명은 제거되어야 한다. 위의 예에서, 꽃을 들고 초대받은 집에 도착했을 때 꽃을 전해받은 여주인이 꽃을 싫어한다는 사실을 알게 되었다면, 이 여주인이 꽃을 좋아한다고 가정했던 신뢰를 지워야 한다. 물론 이 신뢰를 토대로 하여 얻은 다른 모든 신뢰들을 전부 제거해야 한다.
앞의 예는 가장 높은 가능성을 가진 것의 선택 (most probable choice) 이라 불리는 일종의 결장 추론 기법이다. 참인 문장들로 구성된 집합에서, 정보가 불완전할 경우, 가능성이 가장 높은 것을 선택하는 기법이다. 대부분의 사람은 꽃을 좋아한다. 대부분의 개에는 꼬리가 있다. 혹은 스웨덴인이 가지고 있는 가장 일반적인 머리카락 색깔은 금발이다와 같은 것이 이 기법에 의해 선택한다. 결장 추론 기법에 속하는 또 다른 중요한 종류로는 범위 한정 기법 (circumscription) 이 있다. 어떤 성질 P 를 만족시킬 가능성이 있는 정보만이, P 를 만족시키기 위해 사용될 수 있는 정보이다. 예를 들어, 나룻배를 타고 강을 건너가는 문제를 살펴 보자. 노가 부족하다든지, 배에 물이 들어 온다든지 혹은 배가 진흙속에 빠졌다든지 하여 배의 사용이 불가능한 여러 경우가 있다.
문제 풀이 프로그램이 이 모든 조건이 참이 아님을 명시적으로 꼭 증명할 필요는 없다. 문제에는 노에 대한 어떤 사항도 언급되어 있지 않을 수가 있다. 명백히 참으로 증명될 수 있는 정보만이 참이며, 이 외에는 모두 거짓이라고 프로그램에 가정할 수 있다. 이런 가정하에서, 프로그램이 수행되어 노를 사용할 수 있다.
정확하고 체계적으로 결장 추론 기법을 기술한다면, 결장 추론 기법을 정보 X 중 부족된 부분을 결론 Y 와 관련시키는 것이다. 즉 이것은 다음과 같다.
결장
추론 : 정의 1
만약
X 가 알려지지 않았다면, Y 로 결론짓는다.
그러나 가장 단순한 시스템을 제외한 모든 경우, 알려졌다고 간주할 수 있는 정보의 매우 작은 부분만이 데이터 베이스에 기록되어 있다. 나머지 다른 정보들은 이 기록된 정보로부터 증명될 수 있다. 따라서 다음과 같이 말할 수 있다 :
결장
추론 : 정의 2
만약
X 가 증명될 수 없다면, Y 로 결론짓는다.
그러나 서술 논리를 사용한다고 가정할 경우, X 가 증명될 수 없다는 것을 어떻게 알아 낼 수 있겠는가? 서술 논리를 사용할 경우, 이것을 항상 알 수 있는 것은 아니다. 따라서, 임의의 X 에 대해, 이것의 증명 여부를 확실히 말하는 것은 불가능하다. 따라서 다음과 같이 정의한다.
결장
추론 : 정의 3
제한된
시간 내에 X 를 증명할 수 없다면, Y 로 결론짓는다.
그러나, 이로부터 논리 이외에, Y 를 유도하는 추론 과정의 정의에 영향을 끼치는 요인이 존재함을 알 수 있다. 이것은 할당된 시간 내에 행해질 수 있는 계산의 양과, 탐색 과정 동안, 원하는 증명에 이 계산이 적절한 것인지의 여부에 의해 결정된다. 따라서 시스템이 어떻게 작동되는지를 나타내는 일정한 형식을 갖춘 언명을 작성하는 것은 근본적으로 불가능할 뿐만 아니라, 제안된 증명이 정당한 것인지도 증명할 수도 없다. X 를 증명할 능력이 부족하기 때문에, Y 로 결론짓는다는 앞의 정의를 사용하여 증명을 유도한다고 가정하자. 그러나 X 의 증명 여부를 항상 명백히 판결할 수 없기 때문에 X 를 사용하여 얻은 증명의 타당성 또한 명백히 결론짓을 수가 없다. 따라서 완전한 정보가 부족하다는 사실을 이용하여 어떤 사실을 유추하는 결장 추론 기법을 사용할 경우, 일정한 형식에 의해 작동 방법을 특정짓는 것이 불가능한 시스템을 사용할 수밖에 없다.
비록 어떤 주어진 상황에 대한 완전한 정보를 가지고 있다 할지라도, 현실 세계에서의 상황은 급격히 변할 수 있기 때문에, 이 수집된 정보들이 항상 완전한 것은 아니다.
즉, 현재 참으로 판명된 정보가 이 후에 거짓으로 처리될 수 있다. 이것은 골조 문제 (frame problem) 이며, 이러한 문제를 처리하기 위해 앞의 3-3 절에서 언급되었던 상태 변수가 사용된다. 그러나 각 술어를 포함한 명제가 참으로 인정받는 상태를 알려 주는 독립적인 언명을 만들어야 하기 때문에, 이 방법은 불완전하다. 즉, 변화 속도가 매우 느린 동일한 사실을 계속 반복하여 알려야 하는 불필요한 작업을 수행해야 한다. 또한 연산 작용이 행해진 후에야, 새로이 만들어진 사실을 발견할 수 있기 때문에, 일련의 연산 작용을 수 차례 반복할 경우, 이 전에 이미 만들어진 사실이 다시 만들어진다는 것을 미리 알 수가 없다. 수집된 사실들이 변하는 특성을 가진 문제들을 풀기 위한 또 다른 방법은, 단순히 언명들이 더 이상 관련된 문제를 정확히 기술하지 못할 때, 이 언명들을 제거하고, 좀 더 정확한 다른 언명들을 대치시키는 방법이다. 데이터 베이스 내에 언명을 첨가할 뿐만 아니라, 지워 버릴 수도 있기 때문에 이 방법 또한 비 단조 시스템을 구성한다. 그리고, 한 언명이 제거될 때마다, 이 언명을 사용하여 얻은 다른 모든 언명들도 또한 제거해야 한다.
문제를 풀기 위해 이에 적합한 문제 풀이 시스템을 사용한다 할지라도 비 단조적으로 지식의 데이터 베이스가 구성된다. 자신의 일에 매우 바쁜 세 명의 사업가가 협상을 위해 함께 모이고자 할 때 이들의 모임 시간을 어느 때로 결정해야 하는지 이를 푸는 프로그램을 작성하여 보자. 이 문제를 푸는 한 가지 방법은 먼저 회의가 개최될 요일을 가정한다. 예를 들어 수요일에 회의가 개최될 예정이라고 하자. 이 가정으로부터 얻어진 주장에 이러한 사실을 알리는 적절한 표시를 하여 이것을 데이터 베이스에 첨가한 후 수행을 계속하여 적절한 시간을 찾는다. 만약 이렇게 하여 결정된 시간에 세 사람이 모두 참석할 수 없다면, 가정을 나타내는 언명을 버리고, 모순이 없는 다른 언명으로 대치한다. 물론, 현재 제거된 가정을 기초로 하여 유추된 다른 모든 언명도 제거해야 한다. 이 방법도 또한 비 단조 시스템을 유도한다.
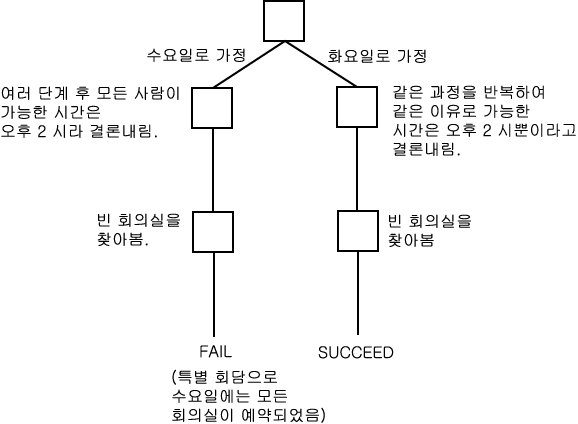
물론, 이러한 종류의 상황은 후진이 허용된 트리의 탐색을 사용하여 처리할 수 있다. 이 경우, 모든 가정과, 이 가정들로부터 이끌어 낸 추론들을 해당되는 탐색, 노드에 기록한다. 만일 가정과 추론의 결과 사이에 불일치가 발생한다면 이미 탐색된 노드 중, 탐색되지 않은 후계 노드를 가지고 있는 노드를 찾아 후진한다. 이 때, 모순을 발생시킨 가정과 이로부터 얻어진 모든 추론들이 자동적으로 지워져 버린다. 회의의 개최 시기를 결정하는 프로그램에 대한 탐색 트리 중 일부분이 그림 1 에 소개되었는데, 이 그림으로부터 이 방법의 결점을 알 수 있다. 회의의 개최 시기를 결정하는 프로그램은 세명의 사업가가 모두 바쁘지 않고, 또한 이들을 모두 수용할 만큼 충분히 넓은 회의실을 이용할 수 있는 요일과 시간을 찾아내야 하는 제한 조건의 만족 문제를 풀어야 한다.
이 문제를 풀기 위해, 시스템은 한 번에 하나씩 제한 조건을 만족시키는 방법을 사용한다. 먼저 회의가 개최될 요일을 수요일로 가정한다. 이로부터 풀이의 나머지에 의해 만족되어야 하는 새로운 제한 조건이 만들어진다. 회의가 수요일날 개최될 예정이라는 가정을 이것을 표기하기 위해 만들어진 노드에 기록한다. 이제 세 사람의 사업가가 모두 참석할 수 있는 시간을 찾아야 한다. 사업가들은 2 : 00 를 제외한 모든 시간에 정기적으로 매일 자신들의 회의에 참석해 왔다. 따라서 회의 개최 시간으로 2 : 00 를 선택하였다. 그러나 이 경우, 요일은 고려하지 않고 결정한 것이다. 이 시점에서 수요일에는 이용할 수 있는 회의실이 없음을 알게 되었다. 따라서 수요일에 회의가 개최될 것이라는 가정에서 후진하여 다른 요일, 예를 들면, 화요일을 시도한다. 후진하여 요일을 선택할 때 2 : 00 를 선택한 일련의 추론 과정을 기억하고 있지 않기 때문에 이 과정을 반복 수행해야 한다.
그림 1 의존도를 기초로 하지 않는 후진 기법
탐색 과정에 의해 만들어진 순서를 토대로 하여 모순을 일으킨 언명을 삭제하는 것은 모순의 발생에 대한 책임을 따져 언명을 삭제하는 것보다, 불필요한 많은 작업을 수행해야 하는 결점을 가지고 있다. 따라서 가정과 이로부터 얻은 추론을 데이터 베이스에 직접 첨가하고 필요에 따라 이들을 삭제할 수 있도록 하는 것이 효과적이다. 이 방법을 의존도를 기초로 한 후진 기법 (dependency-directed backtracking) 이라 하며, 아래에서 더욱 자세히 설명한다.
지금까지 비단조적인 추론이 필요한 다음과 같은 이유에 대해 살펴 보았다.
이제, 단조 시스템을 비 단조 추론이 허용된 시스템으로 확장시키는 방법에 대해 알아 보자.
데이터 베이스에 포함된 언명을 삭제하고자 할 때, 이 삭제될 언명에 의해 영향을 받는 증명 과정을 가진 다른 언명들로 후진하여, 이 언명들을 삭제해 버리거나 혹은 현재의 데이터 베이스를 참으로 하는 새로운 증명을 찾아야 하기 때문에, 비 단조 시스템은 단조 시스템의 처리보다 어렵다. 하나의 언명을 지워 버릴 경우, 이 언명에 의존하는 다른 모든 증명 또한 지워야 하기 때문에, 전체 데이터 베이스에 커다란 영향이 미친다. 비단조 시스템을 만들 때 발생한 변화를 주변에 전달하는 작업에 시스템의 모든 시간이 허비되지 않도록 해야 한다.
데이터 베이스에 변화를 전달하고, 현재의 타당성을 위한 증명을 조사하기 위해서 각 정리를 따라 이것의 증명, 혹은 적어도 이 증명이 의존하는 다른 언명의 목록을 기록해야 한다. 일단 증명을 발견하면, 그것을 다시 조사할 필요가 전혀 없기 때문에 단조 시스템에서는 위의 일이 불필요하다. 따라서 비 단조 시스템은 단조 시스템보다 많은 기억 장소와 처리 시간을 필요로 한다.
진리값의 유지 시스템 (Truth Maintenance System : TMS) 은 비 단조 추론을 돕기 위해 구현된 시스템이다. 이것은 다른 추론 프로그램에서의 진리값을 유지하기 위해 구현된 시스템이다. 이것은 다른 추론 프로그램에서의 진리값을 유지하기 위해 사용되는 시스템으로 이것의 역할은 새로운 추출을 만드는 것이 아니라 다른 프로그램에 의해 만들어진 언명들 사이에 모순이 없도록 유지시키는 것이다. 언명간에 모순이 발생하면, TMS 는 자신의 추론 기법인 의존도를 기초로 한 후진 방법을 사용하여 최소의 신뢰 집합을 변경시켜 모순을 해결한다.
TMS 에서 각 언명 혹은 규칙은 노드라 불리며, 각 점에서 다음 두 상태 중 하나로 존재한다 :
IN 참으로 믿어진다.
OUT 이것을 참으로 믿을 만한 이유가 없거나, 가능한 이유 중에 어느 하나도 현재 타당하지 못하기 때문에 참이라 믿어지지 않는다.
각 노드에는 정당성을 증명하는 목록이 포함되어 있으며, 이것은 각 노드의 합당함을 설정한 방법을 설명한다. IN 노드는 현재 타당한 정당성의 증명이 적어도 하나 존재하는 노드이다. OUT 노드는 현재 타당한 정당성의 증명이 하나도 존재하지 않는 노드이다. OUT 노드를 버리지 않고 그대로 두는 이유가 무엇인지에 대해 알아 보자. 실제로 OUT 노드가 만들어진 이유는 무엇일까? 명백히 거짓으로 판명된 언명을 나타내는 노드를 만들기 위해 많은 작업을 수행하는 것은 전혀 의미가 없는 것처럼 보인다. 그러나 비 단조 시스템에서는, 말하자면 결장 추론 기법에 의한 결과와 같이 참으로 가정된 언명을 표기하기 위해 노드를 만든다. 원래 노드가 IN 의 상태에 있다는 가정을 토대로, 다른 노드를 만든다. 그러나 이러한 원래 노드를 OUT 의 상태로 변화시킬 수 있는 새로운 정보를 후에 수집할 수 있다. 이 때, 이 원래의 노드를 기초로 하여 얻은 모든 노드를 OUT 상태로 해야 하지만, 만약 이용 가능한 정보가 변화하여, 원래 노드를 IN 으로 한다면, 이 노드를 기초로 하여 추론할 수 있는 다른 모든 노드들을 다시 만들기 위해, 이전에 이미 수행되었던 추론 과정을 다시 반복해야 하기 때문에 이를 피하기 위해 이 모든 노드와 상호 의존도를 그대로 유지하는 것이 효과적이다. 원래 노드가 다시 IN 의 상태로 되면 곧 이 노드를 기초로 하여 얻을 수 있는 다른 노드들의 정당성이 입증되어, 이 노드들의 IN 의 상태로 된다.
시스템에는 두 가지 종류의 정당성을 규정하는 표시가 있는데 이것은 한 노드의 타당성에 의해 좌우되는 두 가지 방법을 반영한다.
-
지원 리스트 (Support List) (SL(in-노드)
(out-노드))
- 조건부 증명 (Conditional Proof) (CP<결론
(consequent)>
(in-가정)
(out-가정))
지원 리스트 (SL) 정당성 규정 표시 (SL justification) 는 가장 일반적으로 사용된다. IN 노드의 리스트에 언급된 모든 노드가 현재 IN 이고, OUT 노드의 리스트에 언급된 모든 노드가 현재 OUT 일 때 이것이 참이다. 다음 노드를 살펴 보자 :
(1)
겨울이다 (SL ( ) ( ))
(2) 날씨가 춥다 (SL (1) (
))
노드 1 의 SL 정당성 규정 표시 내에 IN 과 OUT 리스트에 어떤 원소도 가지고 있지 않는데, 이것은 노드 1 이 어떤 다른 노드의 현재 신뢰나, 신뢰의 부족에도 영향을 받지 않는다는 것을 말한다. 이와 같은 노드를 전제 (PREMISE) 라 한다. 반면 노드 2 의 SL 정당성 규정 표시의 IN 리스트는 노드 1 을 포함하고 있다. 이것은 노드 2 를 믿는다는 결론을 이끌어 낸 추론 과정이 노드 1 의 현재 신뢰에 의해 결정된다는 것을 알린다.
만약 미래의 어떤 점에서 노드 1 로 표기된 전제가 제거되었음을 TMS 가 탐지한다면, 노드 2 가 더 이상 잘 구성된 지원 (well-founded support) 를 받지 못하기 때문에, IN 리스트으로부터 노드 2 를 삭제해야 할 것이다.
지금까지의 TMS 추론 기법은, 이것이 전제를 제거하고, 이와 관련된 나머지 적절한 변화를 데이터 베이스에 만들 수 있다는 것을 제외하면, 서술 논리의 추론 과정과 유사하다. 그러나 만약 SL 정당성 규정 표시의 OUT 리스트가 어떤 원소를 포함한다면, TMS 는 다음 예에서 보여진 것처럼 결장 추론을 처리할 수 있다 :
(1)
겨울이다. (SL ( ) ( ))
(2)
날씨가 춥다. (SL (1) (3))
(3)
날씨가 따뜻하다.
노드 1 이 IN 이고, 노드 3 이 OUT 이면, 노드 2 가 IN 이다. 이 정당성 규정 표시는 만약 겨울이고 날씨가 따뜻하다는 증거가 없다면 날씨가 춥다고 결론짓는다는 것을 말한다. 만약 미래에 덥다는 증거가 나타나면, 노드 2 가 더 이상 타당한 정당성 규정 표시를 가지지 못하기 때문에 TMS 에 의해 노드 2 가 OUT 이 된다. 노드 2 와 같이 비어 있지 않은 OUT 리스트를 가진 SL 정당성 규정 표시를 기초로 하여 IN 상태에 있는 노드를 가정 (assumption) 이라 한다. 위의 예로부터 OUT 상태에 있는 노드를 기억하고 있어야 하는 이유를 알 수 있다. 노드 3 이 OUT 이라는 사실은 노드 2 에 대한 정당성 규정 표시의 일부분이 된다. 노드 3 이 존재하지 않는다면, 이것을 표시할 수 없다.
여기서 중요한 점은 TMS 가 스스로 정당성을 입증하지 않는다는 것이다. 위의 노드 2 에 대한 정당성은 겨울은 일반적으로 춥다는 겨울이라는 영역에 대한 지식으로부터 입증될 수 있다. 이러한 영역에 대한 지식은 TMS 를 사용하여 문제를 푸는 프로그램에 의해 제공되어야 한다. 결국 TMS 는 이러한 지식을 사용하여 일관성있는 신뢰 데이터 베이스를 유지시킨다.
조건부 증명 (CP) 정당성 규정 표시 (CP justification) 는 가설 논증을 표기한다. in-가정에 포함된 노드가 IN 의 상태에 있고 out-가정에 포함된 노드가 OUT 가 될 때면 언제든지 항상 결론 노드가 IN 상태로 된다면 이 CP 이 타당하다고 인정된다. CP 정당성 규정 표시는 SL 정당성 규정 표시보다 처리하기가 어렵다. 사실상 TMS 는 CP 정당성 규정 표시를 동등한 SL 정당성 규정 표시로 변환하여 처리한다.
TMS 가 현재 참으로 인정된 언명을 따라 정당성 규정 표시를 명백하게 기록하고 있기 때문에, 모순이 발견되면 필요한 언명만을 제거할 수 있다. 이전에 언급한 것처럼 이 과정을 의존도를 기초로 한 후진 과정이라 부른다. 이 과정이 작용하는 방법을 설명하기 위한 예로서, 회의의 개최 시간을 결정하는 문제를 다시 살펴 보자. 다음 노드와 함께 시작한다 :
(1)
Day(M) = Wednesday (SL ( ) (2))
(2) Day(M) NEQ Wednesday
회의 개최 요일이 수요일이 아니라고 믿을 만한 정당성 규정 표시가 현재 존재하지 않기 때문에 노드 1 이 IN 이며, 개최 요일이 수요일이라고 가정할 수 있다.
어느 정도의 추론 과정이 수행된 후, 스케쥴 시스템을 회의가 2 : 00 시에 개최되어야 함을 알게 된다. 이러한 결정은 관련된 사람들의 스케쥴에 대한 언명을 표기한 여러 노드 (여기서는 57, 103, 45 로 말하자) 를 기초로 하여 얻어진 것이다. 이 때 존재하는 노드는 다음과 같다.
(1)
Day(M) = Wednesday (SL ( ) (2))
(2) Day(M) NEQ Wednesday
(3)
Time(M) = 1400 (SL
(57, 103, 45) ( ))
물론 노드 1 과 노드 3 은 IN 이고, 노드 2 는 OUT 이다. 이제, 이용 가능한 회의실을 찾는 작업의 수행이 시작되고, 수요일 2 : 00 에는 이용할 수 있는 회의실이 없음을 발견한다. 다음 노드를 만들어 이러한 사실을 TMS 에 알린다.
(4) CONTRADICTION (SL (1, 3) ( ))
TMS 는 서로 모순되는 가정 중의 하나를 선택하고 (여기서는 노드 1 만 있기 때문에 선택이 용이하다), OUT 리스트에 있는 노드 중의 하나를 IN 으로 하고, 앞에서 선택한 노드를 OUT 으로 만든다 (모든 가정은 적어도 한 개의 원소로 구성되어 있는 OUT 리스트를 가지고 있기 때문에, 이것은 항상 가능하다). 다시 이 문제의 경우, IN 으로 만들어질 노드가 노드 2 하나 뿐이다. 이 전의 OUT 노드를 IN 으로 만드는 방법은 NOGOOD 노드를 토대로 한 정당성 규정 표시를 이 노드에 만드는 것이다. 이로부터 다음과 같은 노드가 얻어진다 :
(1)
Day(M) = Wednesday (SL
( ) (2))
(2) Day(M) NEQ Wednesday (SL
(5) ( ))
(3) Time(M) = 1400 (SL
(57, 103, 45) ( ))
(4) CONTRADICTION (SL
(1, 3) ( ))
(5) NOGOOD N-1 (CP
4 (1, 3) ( ))
노드 5 가 IN 의 상태에 있기 때문에, 노드 2 또한 IN 의 상태에 있다. 그러나, 이로부터 노드 1 의 정당성 규정 표시가 OUT 인 노드 2 에 의해 결정되기 때문에, 노드 1 이 OUT 이 된다. 노드 4 또한 OUT 이 된다. 따라서, 모순이 해결되고, 새로운 요일을 선택할 수 있지만, 개최 시간은 모순에 포함되지 않았기 때문에, 2 : 00 에 개최된다는 결론은 전혀 영향을 받지 않은 채 존재한다. 즉, 이 결론을 얻는데 수반되는 과정을 다시 반복 수행할 필요가 없어진 것이다.
이로부터, CP 정당성 규정 표시의 중요성을 알 수 있다. 위에서 보여진 것처럼 노드 5 의 정당성을 규정하는 대신, 단순히 다음과 같은 정당성 표시만이 주어졌다고 가정하자 :
(5) NOGOOD N-1 (SL (4) ( ))
다시 말하면, 노드 5 는 IN 의 상태에 있는 노드 4 에 의해서만 결정된다. 노드 1 과 노드 3 에 대한 의존도는 노드 4 가 그들 두 노드에 의해 결정된다는 사실에 의해 표현된다. 그러나 위에 설명된 것처럼 노드 4 가 OUT 이 될 때, 노드 5 도 OUT 이 될 것이다. 이로 인해 노드 2 가 OUT 이 되고, 노드 1 이 다시 IN 이 된다. CP 정당성 규정 표시에 포함된 노드가 현재 IN 인지 OUT 인지에 관계없이 유지되어야 할 논리적 추론체 (logical derivation) 를 기록함으로써, CP 정당성 규정 표시는 위와 같은 일의 발생을 막는다.
지금까지 논의될 사실의 표기 방법과, 이미 알려진 사실로부터 새로운 사실을 추론해 내는 방법에서는, 수집된 사실이 참으로 입증되었거나, 참으로 알려지지 않았거나, 혹은 이것에 관해 전혀 아무 것도 모른다고 가정했다. 여기서는, 참일 가능성이 있는 지식에 대해서는 고려하지 않았다. 그러나 이러한 지식이 중요하게 사용되는 경우가 있다. 이런 지식에는 어떤 것이 있으며 이 지식을 어떻게 표기해야 하는지에 대해 알아 보자.
확률적 추론은 다음과 같은 세 가지 유형의 상황에서 사용된다 :
처음 두 경우에서는 확률적 추론을 사용하여 매우 효과적으로 풀이를 얻을 수 있다. 그러나 세번째 경우에는 확률적 추론을 적용하기에 앞서 먼저 이 추론 방법을 사용하지 않고도 문제를 풀 수 있는 다른 더 좋은 모델이 있는지를 조사한다. 다음 몇 가지 예를 소개하여 이러한 이유를 확실히 알아 보고자 한다.
브리지 게임에서, 사용할 카드를 결정하는 문제를 살펴 보자. 어떠한 정보로도 상황을 확실히 기술할 수 없기 때문에 확률적 추론의 사용은 필수 불가결한 것이다.
임상 기록을 바탕으로 하여 환자의 병을 진단하는 문제를 살펴 보자. 이와 같은 종류의 문제에는 임의성이 존재한다. 의학으로 인간의 신체가 작용하는 방법을 완전히 이해한다는 것은 불가능하기 때문에, 이 문제를 기술하는 데는 많은 임의성이 수반된다. 또한 일부 임상 조사는 많은 비용을 필요로 하며, 또한 위험하기 때문에, 의학 기술로부터 얻을 수 있는 모든 가능한 데이터가 준비되지 않더라도 작용할 수 있는 프로그램을 만들어야만 한다. 특별히 사용할 데이터가 불완전한 경우에는 확률적 추론을 이용해야 한다.
그러나 위 문제들과 1 장에서 소개한 문자 인식 문제를 비교해 보자. 문자를 점들의 집합으로 간주한다면 매우 다양한 형태로 문자를 나타낼 수 있다. 그러나 호와 선과 같은 특성에 따라 문자를 분석한다면, 임의성은 많이 제거된다. 예를 들어, 선의 굵기 등을 고려할 필요가 없다. 이 문제의 경우, 가능한 한 적게 확률적 추론을 사용할 수 있다.
다음 몇 개의 절에서는, 확률적 정보를 표기하고, 처리하기 위한 특수한 기법들이 소개된다.
불확실한 지식을 표기하고 처리하기 위해, 확률에 관한 수학적인 이론이 사용된다. 때때로, 매우 간단한 확률적 기법을 인공 지능 분야의 문제에 효과적으로 사용할 수 있다. 브리지에 대한 문제를 다시 살펴 보자. 다른 경기자들이 가지고 있는 카드의 내용을 모르기 때문에, 현재 상태에 관한 완전한 정보를 이용한다는 것은 불가능하지만, 카드의 다양한 분포에 대한 확률은 추정할 수 있다. 알아야 할 가장 중요한 사항은 하트의 에이스를 가지고 있는 경기자가 누구인지와, 각 경기자가 가지고 있는 스페이드의 수라고 가정하자. 먼저, 각 경기자가 에이스를 가지고 있을 확률을 계산한다. 사용 가능한 정보가 없을 때는, 이 확률이 0.5 라고 가정한다. 가능한 스페이드의 각 분포에 대한 확률을 계산한다. 특정한 사람이 하트의 에이스와 특정한 수의 스페이드를 가지고 있다는 결합 확률 (joint probability) 을 계산하는데, 이때 만약 A 와 B 가 독립 사건이라면,
prob (A and B) = prob (A)* prob(B)
라는 사실을 이용한다.
매 경기마다 이 경기에서 이길 수 있는 가능성을 평가하기 위해, 각 카드의 분포에 대한 경기의 결과를 평가할 수 있다. 각 경기 결과에 대해 평가된 이길 가능성과 이 경기 결과가 발생할 확률을 곱하여, 이렇게 얻은 곱들을 더한다. 다시 말하면,
Score = Σ prob(i) * rating(i) 1 ≤ i ≤ 가능한 경기 결과의 수
를 계산한다. 이로부터 특정한 움직임을 만들어 얻을 수 있는 평균 위치를 측정한다.
여기서는 각 가능한 결과가 일어날 확률을 바탕으로 하여, 이 결과를 실제로 수행할 때, 이 경기에서 이길 가능성을 결정하였다. 이처럼 간단한 통계적인 방법을 사용하여 문제 상태를 알리는 정보 속에 존재하는 불확실성을 어느 정도 효과적으로 처리할 수 있다.
확률론의 가장 효과적인 결과 중의 하나는 관찰에 의해 수집된 여러 사실들의 조건하에서, 특정한 한 사건의 확률을 계산하는 베이스의 정리 (Bayes' theorem) 이다.
 : 증거 E 의 조건아래, 가정
 가 발생할 확률
 : 가정
 가 참인 조건아래, 증거 E 가 발생할 확률
 : 어떤 특정한 증거가 없을 때, 가정
 가 참일 사전 확률
k : 가능한 가정의 수
라고 하자. 이 때 베이스의 정리는,

이다.
예를 들어, 탐사 중인 장소가 원하는 광물이 묻혀 있는 장소인지 결정하기 위해 특정한 장소에 대한 지질학적인 증거를 조사한다고 가정하자. 만약, 다양한 광물 각각을 찾을 수 있는 사전 확률 (priori possibility) 을 알고 있고, 광물이 존재할 경우, 이로부터 어떤 물리적 특징을 관찰할 수 있는 확률을 알고 있다면, 베이스의 정리를 사용하여, 모아진 증거로부터 다양한 광물이 존재할 가능성을 계산할 수 있다. 이 방법은 PROSPECTOR 프로그램에 사용되었다.
패턴 인식 문제의 풀이를 찾기 위해, 베이스의 정리가 매우 중요하게 사용된다.
완전히 결정적인 문제 (deterministic problem) 의 풀이를 찾고자 할 때, 문제 풀이 과정의 매 단계마다, 결과의 확실한 예측을 위해 사용될 정보가 불충분하기 때문에, 이를 처리하기 위한 확률적 기법이 사용된다. 이러한 상황에서는 경험적 지식을 사용하여, 풀이로 유도할 가능성이 매우 높은 방향을 결정하는데 도움을 줄 확률적인 정보를 표기한다. 때때로 이 확률적 정보가 이것을 사용하는 프로그램에 숫자로 나타나지 않을 수도 있다. 규칙을 토대로 한 많은 시스템은 각 사이클마다, 일치된 첫번째 규칙을 선택하며 작용한다. 따라서, 데이터 베이스 내에 나타난 규칙의 암시적 순서는, 일부 규칙이 나머지 다른 규칙보다 풀이로 이끌 가능성이 높다는 것을 알려 준다. 때로는 확률적인 정보가 개개 노드를 평가하는 경험적 지식에 사용되는 평가 함수에 포함되어 사용될 수도 있다. 8-퍼즐 문제를 살펴 보자. 만약 완전한 정보가 주어졌다면, 직접 최단 경로를 따라 갈 수 있다. 그러나 완전한 정보를 얻을 수 없기 때문에, 경험적 지식에 사용되는 평가 함수를 이용하여 여러 경로의 길이를 각각 추정하고, 이 중 가장 유망한 경로를 택하여 조사를 시작한다. 이 경우, 현재 그렇게 수행하고 있다는 것을 모른 채 확률적 정보를 이용하고 있으며, 이보다 더 복잡한 문제를 풀고자 할 경우, 이 확률적 정보의 출처를 고려해야 하며, 이들을 결합하는 방법도 살펴 보아야 한다.
8-퍼즐의 경우, 주어진 판의 위치에서 한 가지 특성, 즉 부적합한 위치에 놓인 타일의 수만을 고려하는 합리적인 경험적 평가 함수를 설정하였다. 그러나 체스를 위한 경험적 평가 함수를 만든다고 가정하자. 이 경우에는, 장기말의 장점, 움직임, 중앙의 제어 등 여러 요인들을 고려해야 한다. 이 때, 장기말의 장점이란 장기판 위에 존재하고 있는 장기말의 갯수와 그 장기말의 위치 및 움직임의 방향을 말한다. 이 요인 각각으로부터, 주어진 장기판의 위치가 승리로 이끌 가능성에 대해 알 수 있다. 그러나 이 요인들을 어떻게 결합해야 하는지, 그리고 각 요인에 어느 정도의 가중값을 주어야 하는지의 문제가 대두된다. 이와 같은 문제는 패턴 인식 문제에서도 발생한다. 이를 해결하기 위한 한 가지 방법은 각 요인에 할당할 최적 가중값을 결정해야 하는 것이다. 그러나 최적 가중값을 미리 결정하는 것은 어려운 일이기 때문에, 프로그램이 수행될 때마다 그 결과에 따라서 가중치를 변경시키는 기법이 더 효과적이다. 이 기법은 폭넓게 연구되고 있으며, 통계적 패턴 인식과 통계적 지식을 얻는 과정에 이용된다.
그러나, 이 확률적 추정값에 포함된 지식의 양이 증가함에 따라, 지식에 대한 규칙을 토대로 한 표기법으로 변경하는 것이 효과적이다. 이렇게 함으로써 시스템과 사용자간에 정보를 교환하는 더 효과적인 방법뿐만 아니라, 규칙을 사용하는 방법에 융통성을 증가시킨다. 그러나 더욱 중요한 것은 이러한 정보가 다양한 결론을 내리는데 도움을 주기 위해 사용된다는 점이다. 장기말의 위치가 어느 정도 승리로 이끌 것인가와 같은 하나의 결론을 얻기 위해 모든 사실을 대수적으로 결합하는 것은, 이 결론 하나에만 관심이 있다면 매우 유효한 방법이다. 그러나 흔히 하나가 아닌 여러 개의 결론에 관심을 갖고 있다. 예를 들어, 의학 진단 프로그램은 환자가 가지고 있는 여러 가지 병들 각각에 대한 결론을 얻고자 한다. 여기에는 두 가지 방법이 있다. 한 방법은 관심을 가지고 있는 결론의 각각에 대해 개별적인 경험적 평가 함수일 것이고 또 다른 한 방법은 최종 평가를 내리는 과정을 여러 작은 단체로 나누어, 각 단계마다 소수의 증거를 결합하는 방법이다. 후자의 방법으로 이루어진 중간 단계의 결론은 이후의 많은 결론을 형성하기 위해 사용된다. 이를 위해 각 가능한 요인이 나머지 다른 요인에 게는 전혀 영향을 미치지 못하도록 하고, 필요에 따라 이 영향력을 결합시킬 수 있는 방법이 필요하다. 이는 각 규칙에 확률을 결합시킨 규칙을 토대로 한 확률적 시스템에 의해 처리된다.
이러한 기법의 이점을 살펴 보기 위해, 환자에게 투여할 약을 선택하는 문제를 살펴보자. 이용 가능한 임상 데이터가 주어졌을 때, 각 약이 병을 치료할 가능성을 나타내는 경험적 지식에 사용되는 평가 함수를 개별적으로 만든다면, 이러한 평가 함수를 수천 개 만들어야 한다. 더군다나 새로운 임상 테스트가 만들어질 때마다, 이들 각각을 적절히 조정해야 한다. 또한 새로운 약이 상품 시장에 나올 때마다, 이에 대한 새로운 함수를 만들어야 한다. 어떠한 경우에서든지, 투여할 최적의 약을 매우 정확하고 효과적으로 계산할 수 있는 방법이 필요하다. 그러나 이 방법은 변하면서 계속 증가하는 종류의 문제를 처리할 수 있는 융통성이 부족하다. 반면, 규칙을 토대로 한 기법을 사용한다고 가정하면 다음과 같은 규칙을 쓸 수 있다.
만약 성질 X1 과 Y2 를 가진 유기체의 증거가 있다면, 유기체 Z 로부터 기인된 감염이 존재한다는 어떤 증거가 있다.
만약 성질 X2 와 Y2 를 가진 유기체의 증거가 있다면, 유기체 Z 로부터 기인된 감염이 존재한다는 어떤 증거가 있다.
만약 유기체 Z 로부터 기인된 감염이 있다면, 의약품 Q 가 환자를 치료할 것이라는 어떤 증거가 있다.
만약 환자가 약 R 을 이미 복용하고 있다면, 약 Q 는 효력이 없을 어떤 증거가 있다.
위와 같이 개개 규칙들로 지식을 표기한다면, 약 Q 에 의해 치료될 수 있는 증세들의 각 결합을 특별히 기록할 필요는 없다. 특정한 병의 치료약으로 이 약을 한 번에 표현할 수 있다. 또한 수 많은 증상으로부터 약 Q 에 의해 치료될 수 있거나 약 R 에 의해 치료될 수 있다 하여, Q 와 R 을 함께 각각 독립적으로 투여하는 일이 없도록 하는 것도 나타낼 수 있다.
이러한 규칙을 바탕으로 하여 특정한 환자에게 적합한 치료약을 조제하기 위해서는, 추천된 여러 가지 규칙들을 결합할 수 있는 방법이 있어야 한다. 이를 위한 한 가지 방법은 각 규칙에 적절한 확률을 배정하는 것이다. 예를 들어 규칙 1 을 다음과 같이 표기한다 :
만약 성질 X1 과 Y1 을 가진 유기체의 증거가 있다면, 확률 0.7 을 가지고 유기체 Z 로부터 기인된 감염이 있다고 말할 수 있다.
확률론에 의해 제공된 직접적인 방법을 사용하여 규칙을 결합할 수 있다. 다음 절에서는 규칙을 결합하는 특정한 방법에 대해 설명한다. 많은 결론을 요구하는 복잡한 상황에서, 한 번에 한 단계씩 확률적 추론 과정을 수행하기 위해 규칙을 토대로 한 시스템을 사용할 경우에 얻어지는 장점에 대해 논의해 왔는데, 하나의 결론만이 존재하는 더 간단하다고 여겨지는 분야의 문제에 이 기법을 사용할 때의 장점에 대해 다시 살펴볼 수 있다. 체스 프로그램에 이용될 경험적인 정적 평가 함수를 만드는 문제를 다시 다루어 보자. 주어진 위치가 궁극적으로 승리로 이끌 확률을 측정하고자 할 때, 다양한 여러 요인들을 고려해야 한다. 이것은 다음과 같은 규칙을 사용하여 쉽게 할 수 있다.
만약 배치 A 가
존재한다면,
여왕이 공격받을 어떤 증거가 있다.
만약 배치 B 가
존재한다면,
여왕이 공격받을 어떤 증거가 있다.
만약 여왕이 공격받을
상황하에 없다면,
게임에서 패배할 어떤 증거가 있다.
만약 상대방의
장기알이 유리한 위치에 있다.
게임에서 패배할 어떤
증거가 있다.
위의 규칙을 수정하여, 좌측의 변수들이 결론의 확률에 영향을 미치도록 하고자 한다. 예를 들어, 장기알의 장점 (장기말의 장점의 뜻은 앞에서 설명하였다) 의 크기는 패배할 확률에 영향을 미친다. 장기를 위한 이러한 표기법은 의학 진단의 경우에 이 표기법이 가지는 것과 동일한 장점을 가지고 있다. 이미 존재하는 어떤 규칙도 변화시키지 않는 새로운 규칙을 첨가할 수 있고, 문제 속에 내포된 고도의 구조를 얻어낼 수 있다.
체스 프로그램에 이 규칙을 토대로 한 경험적인 평가 함수를 사용하기 위해서, 한 생성 시스템을 다른 한 생성 시스템에 집어 넣기만 하면 된다. 가장 위에 있는 시스템이 게임 트리를 통해 최대 최소 탐색 과정을 수행한다. 단말 노드에 도달할 때마다, 평가 시스템을 불러 사용한다. 이 평가 시스템은 다른 모든 생성 시스템처럼 결론에 도착할 때까지 작용하며 일단 결론에 도달하면, 얻은 풀이와 함께 제어를 주 탐색 과정에 돌려 준다.
확률적 규칙을 처리하는 방법을 논의하기에 앞서, 규칙을 토대로 한 확률적 시스템을 사용할 경우 얻어지는 유리한 점을 살펴 보자.
불완전한 정보를 가진 결정적인 상황에 사용될 확률적인 정보를 표기하기 위한 방법으로 이 시스템을 소개하였다. 이 때 확률적인 정보는 탐색을 유도하기 위한 경험적 방법에 사용된다. 그러나 동일한 기법을 사용하여 순수한 무작위 사건에 대한 정보를 표기할 수 있으며, 또한 쉽게 두 종류의 정보를 결합할 수 있다. 이것은 매우 중요하다. 예를 들어, 의학 진단 작업에서는 미소 유기체의 행동을 확실하게 예측할 수 없는 무작위성이 존재한다. 관련된 과정에 대한 불완전한 지식에 의해 기인된 분명한 무작위성이 있다. 그리고 잠재적으로 관련된 데이터의 부족에 의한 좀 더 명백한 무작위성이 존재한다. 이 모든 종류의 무작위성을 주어진 어떤 증거에 대해서라도 작용할 수 있는 확률적 추론 규칙을 사용하여 즉시 처리할 수 있다.
경험적 방법에 사용되는 정보를, 결정적인 규칙과 이 규칙을 바탕으로 탐색을 유도할 개별적인 경험적 평가 함수로서가 아니라, 확률적 생성 규칙의 집합으로 나타내어, 결정적이고, 또한 확률적인 사실을 기술하고, 일정한 방법으로 이 사실을 이용하여 작업을 수행할 수 있는 장점이 있다. 또한 이 두 종류의 추론 과정을 설명할 수 있다.
제 5 장에서는 서술 논리를 사용하여 많은 사실을 표기하는 방법과, 이 사실을 사용하여 추론하는 방법을 다루었는데, 이로부터 다음과 같은 사실을 처리할 수 있었다 :
그러나 다음과 같이 단순한 사실을 처리할 수 없었다 :
그러나 각 사실과 어떤 확률을 결합시킨 규칙으로 동일한 사실을 쉽게 표기할 수 있다. 규칙을 함께 사용하여 연역 추론하고, 추론 과정에 확률을 결합하여 결론이 참일 확률을 계산한다.
이것으로부터, 규칙을 토대로 한 시스템의 확률적 추론 과정을 기술하는 것이 얼마나 쉬운지를 알 수 있다. 체스 프로그램이 특정한 움직임을 선택할 이유를 알고자 한다. 만약 프로그램이 간단한 통계적 정적 평가 함수를 사용했다면, 이 프로그램으로부터 얻은 응답은 거의 의미가 없을 것이다. 그러나 만약 프로그램이 프로그램의 정적 평가 함수로 규칙을 토대로 한 확률적 추론을 사용한다면 프로그램은 사용된 각 규칙을 간단하게 기술할 수 있으며, 이것은 특정한 움직임을 선택한 이유를 훨씬 더 현명하게 설명한다.
지금까지, 규칙을 토대로 한 확률적 추론 시스템의 여러 장점을 대략적으로 살펴 보았다. 이제부터는 이것을 구현할 때 발생하는 중요한 문제점에 대해 논의하기로 하며, 여기에는 다음과 같은 것이 포함된다 :
위의 질문에 대한 가능한 대답이 여러 개 존재한다. 다음 절에서는 이에 대한 하나의 기법을 보여 준다.
의학 진단은 현실 세계의 복잡성과 완전한 지식의 결여 때문에 절대적이거나 단언적인 분석이 불가능한 문제의 한 예이다. 이러한 종류의 문제를 해결하기 위해서는 추정에 의한 추론이 필요하다. 그러나 명백하고 확률적인 추론을 사용하여, 여러 종류의 의학 진단 프로그램을 만들 수 있다. 본 절에서는 박테리아에 감염된 환자에게 적절한 치료제를 추천하는 마이신 (MYCIN) 이라 불리우는 프로그램에서 사용되는 추론 체계에 대해 알아 본다. 마이신은 필요한 임상 자료를 얻기 위해, 의사에게 자료를 요구하기도 한다. 또한 TEIRESIAS 시스템은, 의사가 마이신과 상호 작용하여, 마이신의 데이터 베이스에 지식을 첨가하거나 수정하는 일과 마이신의 추론에 대한 질문을 하는 일을 할 수 있는 방법을 제공한다. 마이신은 전문가가 전문적인 일을 정상적으로 하듯이 작용하기 때문에 대화식 전문 시스템의 한 예로 볼 수 있다.
마이신은 여러 가지로 설명되지만, 시스템으로서의 설명, 지식 표기를 위한 생성 시스템으로의 사용, 추정에 의한 추론의 사용 등으로 설명된다. TEIRESIAS 시스템에 관한 자세한 설명은 8-3-2 절에 주어졌다. 앞 절에서 설명한 대로, 마이신은 불확실한 지식의 영역에서 작동해야 한다. 이러한 불확실한 지식을 표기하기 위해 마이신은 다음과 같은 규칙에 대한 데이터 베이스를 갖고 있다.
If
: (1) the stain of the organism is gram-positive, and
(2)
the morphology of the organism is coccus, and
(3)
the growth conformation of the organism is clumps,
then
there is suggestive evidence (0.7) that
the
identity of the organism is staphylococcus.
이것은 마이신의 사용자에게 규칙이 표현되는 형태이다. 그러나 내부적인 형태는 다루기 쉬운 LISP 의 리스트 (list) 구조로 표현되어 있다. 위의 규칙은 내부적으로 다음과 같이 표현된다.
PREMISE
: ($AND (SAME CNTXT GRAM GRAMPOS)
(SAME
CNTXT MORPH COCCUS)
(SAME
CNTXT CONFORM CLUMPS))
ACTION : (CONCLUDE CNTXT
IDENT STAPHYLOCOCCUS TALLY .7)
마이신은 병의 원인이 되는 중요한 유기체를 찾아내는 중요한 목표로부터 이용 가능한 임상 데이터로 후진 추론하기 위해 이러한 규칙을 사용한다. 일단 이러한 유기체를 찾아내면, 마이신은 병이 치료될 수 있는 처방을 선택하게 된다. 이 때에 문제는 결론에 대한 확실성을 평가하기 위해 각 규칙의 확실성에 대한 추정값을 어떻게 결합하는가에 있다. 이러한 문제를 다루기 위해 한 가지 분명한 방법은 각 규칙의 확실성에 대한 추정값을 확률처럼 취급하고, 베이스의 정리를 사용하여 주어진 관찰에 대한 결론의 조건부 확률을 계산하는 것이다. 이 문제나 이와 비슷한 문제를 위해 베이스의 정리를 사용하는 것은 몇 가지 결점이 있다.
이러한 이유 때문에, 베이스의 정리는 비록 몇몇 확률적 인공 지능 분야 시스템의 기초를 제공하고 있지만, 현실 세계에서 불확실한 추론에서 일어나는 모든 문제를 해결하지 못한다. 이러한 문제점들을 피하기 위하여 마이신에서 사용한 기법을 살펴 보자.
마이신에서 고려되는 모든 주장은 신뢰값 (MB) 과 불신뢰값 (MD) 에 관계된다. 증거 e 가 주어졌을 때, 가설 h 의 신뢰값은 h 의 불신에 대한 비례적인 감소이며, 확률에 의해 다음과 같이 나타내진다.
|
|
|
1 |
if P(h) = 1 |
|
MB[h, e] = |
max[P(h|e), P(h)] - P(h) |
otherwise |
|
|
|
max[1, 0] - P(h) |
같은 방법으로, 불신뢰값을 증거 e 의 결과로 h 의 신뢰에 대한 비례적인 감소로 다음과 같다.
|
|
|
1 |
if P(h) = 0 |
|
MD[h, e] = |
min[P(h|e), P(h)] - P(h) |
otherwise |
|
|
|
max[1, 0] - P(h) |
하나의 특정한 증거에 대해, MB(h, e) = 0 (h 를 불신할 이유가 없음) 인 경우에는 h 가 일어날 확률을 증가시키고, MD(h, e) > 0 이고 MB(h, e) = 0 인 경우에는 h 가 일어날 확률을 감소시킨다. 이러한 관계는 위의 MB 와 MD 를 계산하는 식에서 알 수 있다.
이 두 값으로부터, 가설의 신뢰에 대하여 전체적인 시스템의 신뢰에 대한 추정값을 계산할 수 있다. 이 추정치는 확신 계수 (certainty factor : CF) 라 불리우며 다음과 같이 주어진다.
CF[h, e] = MB[h, e] - MD[h, e]
만약에 CF 가 양이면 시스템은 가설이 참이라 믿고, CF 가 음이라면 가설에 반대되는 증거가 많기 때문에 시스템은 가설이 거짓이라고 믿게 된다. 이렇게 CF 의 측정값에 MB 와 MD 를 분리하여 긍정적인 증거가 부정적인 증거로 되는 것을 막는다.
이제, 여러 가지 증거가
어떻게 결합되어 가설의 CF 를 결정하나 알아 보자. 두 개의 관찰 결과,  과
 가 주어졌을 때, 가설에 대한 신뢰값과 불신뢰값은 다음과 같이 계산된다.
|
|
|
0 |
if MB[h, |
|
MB[h, |
|
|
|
|
|
MB[h, |
|
|
|
0 |
if MB[h, |
|
MD[h, |
|
||
|
|
MD[h, |
위의 식으로부터, 만약 h 가 확실히 불신이면, h 의 신뢰값은 0 이다. 두 개의 관찰 결과가 주어졌을 때, h 의 신뢰치는 하나의 관찰 결과가 주어졌을 때의 h 의 신뢰값에 두 번째 관찰에 의한 값을 더한 것이다. 두 번째 관찰에 의한 값은 두 번째 관찰 결과에 의한 h 의 신뢰값에 1 에서 첫 번째 관찰에 의한 h 의 신뢰값을 빼어 곱하여 계산한다. 사실상 1 에서 첫 번째 관찰에 의한 h 의 신뢰치를 뺀 값은 두 번째 관찰에 의해 가질 수 있는 가장 큰 값이다. 불신뢰값에 대해서도 같은 방법으로 설명된다. 이러한 경우에도, MD 와 MB 를 사용하여 CF 를 계산한다. 이러한 식은 관찰된 순서에 관계없는 관찰 결과의 교환성 같은 만족해야 될 필요한 조건을 충족시킨다.
간단한 예로 이들 식이
어떻게 작용하는지를 살펴 보자. 예를 들어, 처음 관찰 결과로 h 의 신뢰값 MB =
0.3 을 얻었다고 가정하자. 그러면 MD(h,  ) = 0 이 되고 CF(h,
 ) = 0.3 이 된다. 다음 두 번째 관찰 결과에 의해 h 의 신뢰값 MB(h,
 ) = 0.2 를 얻었다고 하자.
MB(h,  ) = 0.3 + 0.2 * 0.7
=
0.44
MD(h,  ) = 0
CF(h,  ) = 0.44
이 예로보아 조그마한 긍정적인 증거로부터 제법 큰 확신 계수 값을 만들어낼 수 있음을 알 수 있다.
경우에 따라서는 여러 개의 가설의 결합에 대한 확신 계수를 고려해야 할 필요가 있다. 이는 MB 와 MD 의 결합에 의해 계산될 수 있으며, 마이신에서는 두 가설의 곱과 합에 대한 MB 를 다음 식으로 계산한다 :
MB[ , e] = min(MB[
 , e], MB[
 , e])
MB[ , e] = max(MB[
 , e], MB[
 , e])
같은 방법으로 MD 도 계산된다.
또한 경우에 따라서는 가설을 지원하기 위해 사용되는 증거가 올바른지를 확신할 수 없을 때가 있다. 이러한 현상은 증거가 정확하지 못한 실험실이나 연구소의 실험 결과일 때 쉽게 일어난다. 이 경우, 가설의 확실성에 대해 영향을 미치는 요인은 증거에 의해 뒷받침되는 가설의 강도와 증거에 대한 신뢰도로 이 두 가지를 모두 고려해야 한다. s 의 올바름을 절대적으로 확신할 수 있을 때, h 에 대한 신뢰값을 MB'[h, s] 로 나타낸다. s 를 신뢰하도록 유도하는 관찰 결과를 e 라고 하자. (예를 들어, e 는 실험실의 실험 결과가 된다) 그러면,
MB[h, s] = MB'[h, s] * max(0, CF[s, e])
물론, 이러한 식이 없이도 실험 기구의 눈금을 읽는 것과 같은 직접적인 관찰 결과로부터 어떠한 약을 투여할 것인가와 같은 결론에 간단히 도달할 수 있다. 그러나 이렇게 되면, 영역에 대한 대부분의 규칙이 소용없게 된다. 위 식을 사용하여, 실험실의 데이터로부터 유기체의 특성을 예측하는 규칙을 만들 수 있고, 유기체의 특성으로부터 어떤 유기체인지를 밝혀내는 규칙도 만들 수 있고, 또한 밝혀진 유기체를 적절히 치료하는 규칙도 만들 수 있다. 각 단계에서 나타나는 불확실성은 최종 가설의 전체적인 확실성에 대한 척도를 위해 결합할 수 있다.
앞에서 말했듯이, 마이신에서는 약에 대한 지식이 특정한 증상이 주어졌을 때 내려질 수 있는 여러 가지 결론의 확실성을 말해 주는 규칙의 집합으로 나타내진다. 또한 마이신에서는 일반적인 규칙을 토대로 한 시스템의 모든 장점과 추정에 의한 추론 기법의 장점을 결합하여 사용한다고 볼 수 있다. 규칙에 의해 사용된 일부 증거는 직접적인 관찰 결과일 수도 있고, 또한 일부 증거는 따로 규칙에 의해 사용된 일부 증거는 직접적인 관찰 결과일 수도 있고, 또한 일부 증거는 따로 규칙에 의해 시사되는 가설을 나타낼 수도 있다. 각 규칙은 가설, 규칙을 적용하기 위해 필요한 일련의 증거, 확신 계수로 구성되어 있다. 처음에는 하나의 CF 측정값보다는 MB 와 MD 두 가지 모두 필요한 것처럼 보인다. 그러나, 특정한 가설 h 와 일련의 증거 e 가 주어졌을 때, 만약 P(h|e) > P(h) 이면 MB(h, e) > 0 이고 MD(h, e) = 0 이다. 또한 P(h|e) < P(h) 라면 MB(h, e) = 0 이고 MD(h, e) > 0 이 된다. 마지막으로 P(h|e) = P(h) 이면 MB(h, e) = MD(h, e) = 0 이다. 따라서, 하나의 CF(h, e) 측정값으로부터 MB(h, e) 와 MD(h, e) 의 값을 구할 수 있다. 이러한 CF 의 값은 규칙을 시스템에 넣을 때 동시에 의사에 의해 제공된다.
본 절의 시작에 주어진 마이신 규칙의 예를 다시 살펴보자. 증거 부분에 세 개의 요소가 있는데, 이것은 전형직인 마이신 규칙이다. 일련의 증거에 의해 CF 를 구하고 다음서로 독립적인 CF 들로부터 주어진 가설에 대한 CF 를 계산하는 공식이 있음에도 불구하고 왜 규칙의 데이터 베이스는 이렇게도 복잡한 규칙들을 포함해야 하는지의 문제와 왜 기초적인 일련의 증거 중 각각에 대해 간단한 규칙들을 사용하여 이 규칙들을 공식에 의해 결합하지 않는가와 같은 문제가 존재한다. 이러한 문제들에 대한 답은 베이스의 공식을 사용하는 것을 원하지 않는 이유 중의 하나와 같다. 다시 말하면, 베이스의 공식을 사용한다면, 일반적으로 서로 독립이 아닌 증거를 고려하기 위해 여러 가지 증거의 결합 확률을 알아야 하기 때문이다. 다음과 같은 예를 보자. 어떤 환자에 대해, 증상 A 에 의하여 특정한 병이 CF = 0.7 로 예측되고, 증상 B 에 의해 같은 특정한 병이 CF = 0.7 로 예측된다고 하자. 그러나 증상 A 가 일어나면, 증상 B 가 일어나고, 이의 반대도 성립한다고 가정하자. 이때, 증상 A 와 B 로부터 이 환자가 특정한 병에 CF = 0.91 로 걸렸다고 결정짓는 결합 공식을 사용하는 것은 명백한 잘못이다. 그 대신, 확신 계수 0.7 로 특정한 병에 걸렸다고 해야 한다. 왜냐하면, 증상 A 로부터 증상 B 가 일어남을 알 수 있지만, 증상 B 로부터는 추가되는 정보가 전혀 없기 때문이다. 이러한 문제는 서로 관계되는 관찰 결과들을 하나의 규칙을 위한 증거로 취급함으로 없앨 수 있다. 물론, 서로 독립이 아닌 관찰 결과로부터 오는 부정확성을 피하기 위해서 규칙의 집합이 매우 크게 되어 베이스의 공식을 사용할 때와 거의 마찬가지인 상태로 갈 가능성도 있다. 실제적으로는 상호 작용하지 않는 경우가 많기 때문에 위의 방법이 더 효과적이다. 그러나 의사에 의해 만들어질 수 있는 규칙보다 더욱 많은 규칙이 존재하거나, 시스템의 처리 한계를 벗어나는 숫자의 규칙이 존재한다. 이 문제에 대한 실질적인 해결책으로 마이신에서는 상호 작용이 중요한 경우에만 사용되는 복합 증거에 대한 규칙이 있다. 이러한 기법은 CF 자체가 대단히 정확하다고는 볼 수 없기 때문에, 상당히 적절한 기법이라고 볼 수 있다.
본 절에서는 마이신에서 사용된 추정에 의한 추론 시스템을 간단히 설명하였다. 이 시스템은 이 책에서 언급되지 않는 여러 가지 범주를 만족하도록 주의깊게 고안되었다.
비록 마이신에서 사용된 추정에 의한 추론 시스템은 불확실한 현상의 문제를 풀 수 있지만, 다음과 같은 문제점이 있다 :
1. 인간이 사용하는 말은 숫자적인 확신 계수로 바꾸는 방법에 대한 문제, 예를 들어 "매우 가능성이 높다." 라는 말에 대한 확신 계수를 구하는 문제.
2. 만약에 위의 문제에 대해 사람들이 제각기 어떤 숫자를 직접 만든다면 이러한 숫자의 척도에 대한 표준화 방법 문제.
3.
새로운 증거에 의한 CF 의 변화를 얼마나 전달할 것인가의 문제. 예를 들어,
만약 CF[ , e] 가 약간 변하고,
 이 다른 가설
 에 관계되는 증거의 한 부분일 때, CF[
 , e] 도 변해야 하는가의 문제. 만약 미소한 변화가 가능한 한 멀리까지 전달된다면,
시스템은 최종 결과에 거의 영향을 못미치는 이러한 전달 작업을 하는데 대부분의
시간을 소모하게 될 수도 있다. 이와 반대로, 수 많은 조그마한 변화가 무시되어서는
안될 주요 변화가 될 경우도 있다.
4. 규칙에 대한 CF 의 정확성을 높이기 위해 어떻게 데이터 베이스를 변화시킬 것인가 하는 문제. 마이신에서는 이 문제를 추론 과정을 의사에게 설명하는 기능과 규칙이 어떻게 바뀌어야 하는가를 의사로부터 받아들일 수 있는 기능을 갖춘 TEIRESIAS 시스템에 의하여 부분적으로 해결하였다.
이와 같이 아직도 해결해야 할 문제점들이 있지만, 규칙을 토대로 한 시스템과 추정에 의한 추론 시스템을 결합하여 적어도 몇몇 어려운 문제들이 성공적으로 적용할 수 있다.
지금까지, 확률적인 정보를 처리하는 기법들에 대해 여러 가지 논의하였다. 또한 이 기법들에 근본적으로 내재하는 위험성에 대해서도 언급하였다. 확률적 추론 과정이 적합한 때와, 이것이 행해지는 방법에 대한 설명서를 가지고 있다면, 문제를 푸는 데 많은 도움이 될 것이다.
인공 지능에 속하는 다른 분야의 문제에서와 같이, 관련된 분야에서 가능한 한 많은 적절한 일반성을 이끌어내는 것은 매우 중요한 작업이다. 이렇게 함으로써, 더욱 복잡하고 큰 문제를 풀 수 있고, 문제 풀이 프로그램과 사용자 및 데이터를 제공하는 사람간에 효율적으로 교신할 수 있기 때문에 중요하다. 일반성에 대한 필요는 확률적 (혹은 통계적) 기법을 사용하기 위해 필요한 다음 두 가지 사항을 설명해 준다 :
통계적 기법을 사용할 때, 사용된 방법의 고도화에 관계없이, 얻은 풀이는 입력 데이터보다 결코 정확할 수 없음을 명심해야 한다. 만약 입력 데이터가 정선되지 않은 추정값이라면, 이것은 시간의 낭비일 뿐만 아니라, 결론의 확률에 대한 매우 정확한 추정값을 계산하려고 하는 것은 무의미하다.
제 5 장에서는 서술 논리와 같은 형식적인 시스템을 토대로 한 기법을 사용하여 지식을 표현하는 방법에 대해 다루었다. 이 장에서는 이 개념을 확장하여 서술 논리로는 부적합한 지식을 표기하기 위한 기초를 마련하기 위해 다른 형식 시스템에 사용되는 방법을 소개하였다. 이에 속하는 시스템에는 다음과 같은 두 가지가 있다.
1. 서술 논리로 표기하여 처리하기 어려운 사실에 대한 예를 다섯 가지 찾아 보라.
2. 다음 상황 중 통계적 추론 과정이 적당한 것은 어느 것인가? 이유는?
a.
포커 게임
b. 음성 인식
c. 전자 회로의 결점 진단
d. 특정 법안이 국회에서
승인될 가능성의 예측
3. TMS 는 완전한 풀이를 위한 탐색 과정 도중 발생하는 비 단조 추론 과정을 쉽게 하기 때문에 제한 조건의 만족 문제를 풀기에 적절한 기법이다. TMS 가 제 2 장의 암호 산술 문제를 풀기 위해 어떻게 사용되는지 보여라.
4. 아침에 입을 옷을 찾는 방법을 살펴 보자. 이 문제를 풀기 위해, 다음과 같은 지식을 사용할 필요가 있다.
a.
이 문제를 풀기 위해 필요한 사실을 나타내는 TMS 식 데이터 베이스를 만들어라.
b.
이 문제가 풀어지는 방법과 관계되는 사실 (청바지의 더러운 정도와 시간) 이 변함에
따라 풀이가 변하는 방법을 보여라.
5. TMS 가 의학 진단에 사용되는 방법을 보여라.
"콧물이 나오면, 알레르기 계절이 아니라면, 감기에 걸렸다고 가정한다" 와 같은 규칙을 참고하라.
6. 시청할 TV 프로그램을 선택하기 위해 TMS 가 사용되는 방법을 보여라.
"6 시이면, 미식 축구 경기가 끝났을 경우, 채널 2 의 뉴우스를 시청한다" 와 같은 규칙을 참고하라.
7.
추정에 의한 추론을 위해 마이신의 규칙을 사용하여  의 CF, MB, MD 를 계산하라. 단, 이 때 세 개의 관찰된 사실은 다음과 같다 :
MB( ) = .5
MB( ) = .3
MB( ) = .2
8. 다음 중 한 가지 영역을 선택하여, 자체로서 추론에 사용될 수 있는 마이신 형태의 규칙을 작성하라.
9. 마이신 형태의 규칙 시스템을 위한 인터프리터를 작성하여, 문제 6 에서 만든 규칙에 적용해 보아라.


 ] = 1
 ] =
 ] + MB[h,
 ] * (1 - MB[h,
 ])

 ] = 1
 ] =
 ] + MD[h,
 ] * (1 - MD[h,
 ])