Robot
Vision
인공지능-지능형
에이전트를 중심으로
: Nils
J.Nilsson 저서, 최중민. 김준태. 심광섭. 장병탁 공역, 사이텍미디어, 2000
(원서 : Artificial Intelligence :
A New Synthesis 1998), Page 89~117
소개 (Introduction)
자동차 운전 (Steering a Van)
로봇시각의 두 단계 (Two Stages of Robot Vision)
화상처리 (Image
Processing)
장면 분석 (Scene
Analysis)
스테레오 시각과 깊이 정보 (Stereo Vision)
참고문헌과 토론 (Additional Readings and
Discussion)
지금까지 이 책의 예제들은 격자 공간(grid
space)에서 자기 주변의 셀(cell)에 대한 정보만을 전달하는, 상당히 제한된 지각
입력(sensory input)을 사용하는 상태 기계(state machine)와 S-R (Sense-Response)
을 설명하기 위한
것이었다. 그러나 에이전트가 존재하는 공간에 대한 중요한 정보를 제공하는 음향(acoustic),
온도(temperature), 압력(pressure) 등과 같은 다른 형태의 지각 기능들도 많이 있다.
이처럼 환경에 반응하는 기능을 갖는 여러 다른 형태의 기계들도 지각 변환기(sensory
transducer)를 사용한다.
동물의 시각은 힐끗 살펴보는 것만으로도
자신이 처한 세계에 대해서 많은 양의 기본적인 정보를 제공하는 능력이 있다. 기계에
이러한 시각(see) 기능을 제공하는 것은 컴퓨터 시각이라는 분야의 주요 관심사이다.
이 분야는 매우 광범위하며 크게 보면 일반적인 기술과 문자인식, 사진 해석, 얼굴인식,
지문 확인, 로봇 제어 등처럼 특화된 기술로 구성된다.
인간에게
있어서 시각 능력이란 태어날 때부터 주어지는 것이지만 기계에 시각 능력을 부여하는
것은 상당히 어려운 문제이다. 왜냐하면 변화가 심하고 제어되지 않는 조명, 그림자,
복잡하고 기술하기 어려운 풍경이나 다른 물체를 포함하고 있는 물체 등은 기계가
인식하기 어렵기 때문이다. 이러한 문제점들 때문에 컴퓨터 시각은 건물 내부 등과
같이 인위적으로 만들어진 환경에서만 성공적으로 작동하고 있다. 로봇 시각의 주요한
개념들을 설명하기 위해서 대표적인 예들을 소개하려 한다.
컴퓨터
시각 분야의 첫 단계는 TV카메라의 광 센서와 같이 빛에 민감한 장치에 물체의 화상을
만드는 것이다. 스테레오 시각(stereo vision)의 경우 두 개 이상의 상이 형성되며
이 내용은 뒤에서 논의한다. 화상은 카메라가 상을 받아들이는 부분인 렌즈에 의해
원근법적 투사(perspective projection) 방법으로 카메라에 형성된다. 광 센서는
화상을 시간 변화에 영향을 받는 2차원 행렬 형태로 변환시킨다. 이 행렬의 각 원소는
 의 값을 갖게 되고, 여기서
 는 각 행렬에서의 광 센서 위치를 나타내며
 는 시간의 범위를 의미한다 [색깔이 포함된 시각(color vision)의 경우 이런 행렬이
3개가 만들어지고, 세 개의 행렬은 각각 삼원색을 나타낸다. 그러나 여기에서는 색깔이
없는 흑백의 경우와 시간변수를 제외시킨 정적인 화상만을 얘기하려 한다.] 시각을
통해 반응하는 에이전트는 이 배열을 반드시 자신이 처한 환경을 표현하는 아이콘
형태 또는 자신의 행동을 직접 계산할 수 있는 형태의 특징(feature)으로 바꾸어야
한다.
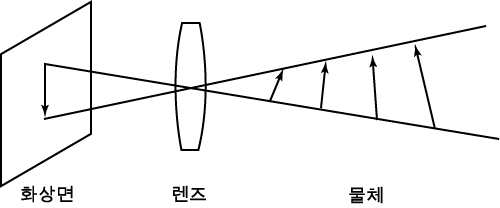
그림 1 화상처리의 다대일 특징
그림 1에서 나타나 있듯이, 원근법적인
투사 방식은 다대일 변형이다. 따라서 여러 개의 다양한 모습들이 동일한 화상으로
만들어질 수 있다. 문제를 복잡하게 하면, 주위의 낮은 광도와 다른 요소들을 이용하여
화상에 노이즈를 생성할 수도 있다. 따라서 화상을 직접 변환하여(invert) 어떤 화면으로
재구성할 수는 없다. 그 대신에 풍경 속의 화상으로 추측되는 물체에 대한 특화된
지식과 풍경을 구성하고 있는 표면의 속성, 그 표면을 비추고 있는 주변의 광도들에
관한 지식들이 추출되어 에이전트에게 유용한 주변 정보로 사용된다.
추출되는
정보는 주로 에이전트의 목적이나 수행 임무에 따라 다르다. 예를 들어, 장애물이
많은 지역을 안전하게 이동하기 위해서는 에이전트가 장애물의 위치, 경계, 그리고
지역을 구성하는 표면의 속성 등을 알 필요가 있다. 그리고 물체를 조작하기 위해서는
물체의 방향, 크기, 구성요소, 질감 등의 정보가 필요하다. 또 다른 형태의 임무를
수행하기 위해서 물체의 색상이나 종류를 알 필요도 있다. 에이전트는 지정된 시간
동안에 이러한 물체에 대한 정보의 변화에 기반하여 미래의 가능한 변화를 예측하는
일이 필요할 수도 있다. 하나 이상의 화상으로부터 이러한 정보를 추출하는 것은
이미 기술한 바와 같이 어려운 문제이며, 이 장에서는 이러한 기술의 일반적인 개요만을
소개하고자 한다.
S-R 에이전트를 적용한 응용의
경우, 화상을 표현한 행렬을 직접 행동으로 변환하기 위해 인공 신경망(artificial
neural network)을 사용하기도 한다. 유명한 사례로는 자동차 운전을 위한 ALVINN
시스템이 있다[Dean
Pomerleau 1991, Pomerleau 1993]. 로봇 시각에 대한 보다 일반적인
과정을 설명하기 이전에 이 시스템에 대해 먼저 설명하고자 한다. 신경망의 입력은
해상도가 낮은(30×32) TV화상이다. TV카메라는 자동차 위에 장착되어 자동차가
지나가게 될 앞부분을 촬영하게 된다. 이 화상은 960차원의 입력 벡터로 표본화되어
신경망의 입력으로 사용된다. 그림 2에 네트워크가 소개되어 있다.

그림 2 ALVINN 네트워크
신경망은 첫 번째 계층에 5개의
은닉 노드(hidden node), 두 번째 계층에 30개의 출력 노드(output node)구성되어
있으며, 모든 노드는 시그모이드(sigmoid) 함수를 사용한다. 출력 노드들은 선형적인
순서로 정렬되어 있고, 자동차의 운행 각도를 조절한다. 만약 배열의 최상위 부분
근처의 출력 노드의 값이 다른 출력 노드들보다 높은 출력값을 가지면, 자동차의
진행 방향을 왼쪽으로 돌리는 것을 의미한다. 반대로 배열의 최하위 부분 근처의
출력 노드의 값이 높은 출력값을 가지게 되면, 자동차가 오른쪽으로 진행 방향을
돌리는 것을 의미한다. 모든 출력 노드의 "중심"(centroid)도 역시 계산되는데
이 값에 따라 극단적인 오른쪽과 왼쪽 사이의 적절한 방향으로 자동차의 운행 방향이
결정된다.
이 시스템은 조금 변형된 운행중(on-the-fly) 학습 형태이다.
사람이 실제로 운전을 하고 사람의 실제 운행 각도가 입력에 대한 정확한 출력값으로
취해진다. 이 신경망은 역전파 방법(back propagation)을 이용해 실제 운행중에 입력된
시각 형태(visual pattern)에 반응하여 특정 운전자에 특화된 운행 각도를 만들어내면서
지속적으로 훈련된다. 훈련은 약 5분간의 실제 운행을 통해 이루어졌다.
학습과정은
두 가지 잠재된 문제를 해결하기 위해서 수정되었다. 첫 번째 문제는 일반적으로
운전자는 운전을 잘하기 때문에 신경망이 틀린 형태의 경험은 얻을 수 없다는 것이다.
또한 훈련시에 사용되는 도로가 직선 도로일 경우 일반적인 커브도로에 적응할 수
없다는 점도 있다. 그런데 운전자로 하여금 때때로 잘못된 운전 형태를 보이도록
하여 이러한 문제를 해결하는 것은 바람직하지 않다. 학습된 신경망이 그런 잘못된
운전 형태를 따라할 수도 있기 때문이다.
대신 원래의 화상을 소프트웨어적으로
이동하거나 회전시켜서 14개의 부가적인 화상을 생성시켜 자동차가 서로 다른 위치에
있도록 해서 학습에 사용한다. 이렇게 해서 훈련시에 사용했던 도로 화상에 특화된
운행 각도와 14개의 부가적인 화상에 대한 학습 결과를 결합한다.
훈련
과정이 끝난 후, ALVINN은 도로 표식이 없는 포장 도로, 지프차가 지나간 도로, 도로
표식이 있는 일반 도시의 도로, 그리고 도시간 고속도로 등의 여러 환경에서 다양한
차종으로 실험되었는데, 성공적인 결과를 보였다. 고속도로 실험에서 ALVINN은 최대
100km/hr의 속도로 120km를 운행하였다.
위 절에서 본 ALVINN의
성능은 인상적이긴 하지만 만족스럽지는 않다. 왜냐하면 대부분의 로봇 작업에서는
보다 복잡한 고해상도의 화상처리가 필요하기 때문이다. 대부분의 로봇 작업이 배경
속의 물체를 인식하는 것을 필요로 하기 때문에, 여기서는 물체를 인식하는데 관련된
기술에 초점을 맞추려고 한다. 그러면 첫째 물체란 무엇인가? 건물의 내부와 같이
사람이 인위적으로 만든 환경에서의 물체란 출입구, 가구, 다른 에이전트, 사람들,
벽, 마루 등이고, 외부의 자연적인 환경에서의 물체는 동물, 식물, 인위적인 구조물,
자동차, 도로 등이라고 할 수 있다. 인위적인 환경은 물체들이 대부분 정형화된 모서리와
표면을 갖는 경향이 있으므로 로봇 시각의 분야에서는 보다 쉽게 여겨진다.
풍경
속 물체의 화상 윤곽선을 나타내는데 유용한 컴퓨터 시각 기술이 두 가지있다. 하나는
화상의 간선(edge)을 탐지하는 기술이다. 화상의 간선은 화상의 강도와 다른 속성들이
급작스럽게 변화하는 화상의 일부분이다. 다른 하나의 기술은 화상을 영역(region)으로
나누는 것이다. 영역은 화상의 강도와 다른 속성들이 점진적으로 변화하는 부분이다.
때때로, 화상의 간선과 영역간의 경계는 물체와 관련있는 불연속성(discontinuity)에
대응되며 이는 장면에서 화상을 생성하는데 중요한 것이다. 불연속성에 대한 몇 가지
예제가 그림 3에 나타나 있다.[Nalwa 1993, p.77] 조명의 강도, 표면 성질, 카메라의
위치에 따라 불연속성은 화상의 간선 또는 화상의 영역 경계로 표현된다. 따라서
이러한 화상의 속성을 추출하는 것은 로봇 시각 분야에서 상당히 중요하다.
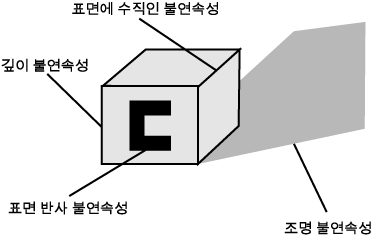
그림 3 장면 불연속성
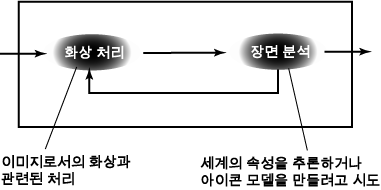
그림 4 로봇 시각의 두 단계
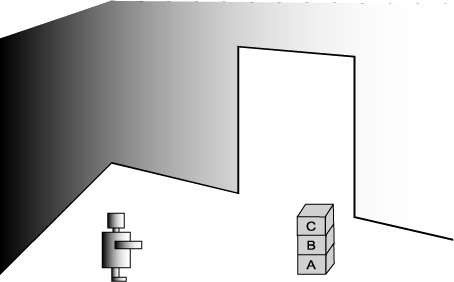
그림 5 방안에 있는 장난감 블록과 로봇
여기서는 그림 4에 나타나 있는
것과 같이 시각처리 과정을 두 단계로 나누고자 한다. 화상처리 단계(image processing
stage)는 원래의 화상을 배경 분석 단계에서 이용하기 쉬운 형태로 변형시키는 단계이다.
화상처리 단계는 다양한 필터링(filtering)을 이용해서 노이즈를 줄이고, 간선을
강조하기도 하며, 영역을 발견해내는 등의 여러 가지 작업을 한다. 배경 분석 단계(scene
analysis stage) 는 한 단계 처리된 화상으로부터 에이전트가 임무 수행에 필요로
하는 정보 형태를 생성해내는 단계이다. 로봇 시각 분야를 여기서처럼 두 단계로
나누는 것은 단지 설명을 위하여 단순화시킨 것이고, 실제 응용에서는 보다 많은
단계를 거치며 단계간의 상호작용도 훨씬 활발하다.
시각처리 과정의
두 단계에 대해서는 후반부에서 자세히 다룰 것이다. 일반적인 개념 이해를 위하여
그림 5에 나타나 있는 격자공간 속의 로봇을 고려해 보자. 로봇의 관점에서 보면
A, B, C 세 개의 블록이 있고, 출입구 그리고 방의 구석(corner)이 있다. 먼저, 화상처리
단계는 노이즈를 제거하고 물체의 간선과 불연속성을 강조한다. 그 다음, 환경이
물체들로 구성되며 직선으로 둘러싸인 경계면이 있다는 것을 파악하고, 배경 분석
단계가 배경을 컴퓨터 그래픽에서와 같이 아이콘 형태로 표현한다. 전형적으로 이러한
아이콘 형태는 기억 장치에 저장된 환경 모델을 보다 이해하기 쉬운 형태로 수정하는데
사용된다. 마지막으로 이렇게 추정된 모델에 적절한 행동이 계산된다.
에이전트가
수행하는 업무에 따라서 다르지만, 아이콘 형태의 모델은 컴퓨터 그래픽처럼 배경의
모든 부분을 자세하게 표현할 필요는 없다. 만약 장난감 블록만을 다루는 경우라면,
방 구석의 위치와 출입구는 업무와 직접적인 연관성이 없을 수도 있다. 오직 블록의
배열만 중요하다고 가정해 보자. 그렇다면 아이콘 형태의 적절한 표현은 ((C B A
FLOOR))이 될 것이고, 이 표현은 C는 B위에 있고, B는 A 위에 있으며, A는 마루 위에
있다는 것을 의미하게 된다. C가 마루로 이동한다면 아이콘 형태의 적절한 표현은
((C FLOOR)(B A FLOOR))로 변경된다. (이것은 ((B A FLOOR)(C FLOOR)로도 표현될
수 있지만, 수평선상의 상대적인 블록의 위치는 중요치 않다고 가정한다. 즉, 리스트의
첫 번째 인자는 별다른 의미를 갖지 않는다). 각 아이콘 형태의 표현 리스트의 마지막
요소는 FLOOR이므로, 이 요소를 삭제하여 리스트를 줄일 수도 있다.
아이콘
형태의 표현을 사용하지 않는 로봇의 경우, 배경 분석 단계는 앞 단계에서 처리된
화상을 로봇이 직접적으로 수행해야 할 업무에 적절한 형태의 속성으로 변환시켜야
한다. 예를 들어 C 블록 위에 다른 블록이 있는지의 여부가 중요하다면, 환경 표현에서
CLEAR_C 와 같은 위의 조건을 나타내는 속성을 포함하고 있어야 한다. 만약 C 위에
아무것도 없다면 이 값은 1 이 될 것이고, 그렇지 않으면 0 의 값을 가질 것이다(여기서는
이해의 편의를 위해서 특징을 나타내는데  대신 위와 같은 이름을 값만을 계산하면 된다. 이러한 예제들로부터 배경 분석
단계는 로봇이 수행해야 할 작업과 긴밀하게 연관되어 있음을 확인할 수 있다.
(1) 평균화
일반적으로
원래 화상은 화상 강도 배열(image intensity array)이라고 불리는 숫자로 구성된
 배열,
 로 표현되며, 이 배열은 화상공간을 화소(pixel)이라고 불리는 작은 구조(cell)로
분할한다. 배열의 숫자는 원래 화상 해당 공간의 광도(light intensity)를 나타낸다.
화상의 특정한 불규칙성들은 평균화에 의해서 제거될 수도 있다. 평균창(averaging
window)은 각 화소를 중심으로 하는 창으로, 평균창 내부의 모든 화소들의 가중합을
계산하는데 사용된다. 이 합은 중심 화소의 원래 값을 대치한다. 이러한 평균창을
이용한 이동과 합 연산을 컨벌루션(convolution)이라고 한다. 만약 컨벌루션을 이용해서
모든 배열의 값들을 이진값으로 만들려면, 가중합을 임계값과 비교하면 된다. 평균은
독립된 미세 노이즈 부분을 무시하는 경향이 있으나 화상의 손상되기 쉬운 성질(crispness)을
감소시키고, 또한 필요없는 작은 화상요소를 없애기도 한다.
컨벌루션은
신호처리 분야에서 개발된 연산이고, 파형(waveform)에 대한(시간축에 대해서 이동하는)
1차원 연산으로 설명되기도 한다. 만약 함수  에 대해서 이동(slide)하거나 컨벌브(convolve)하기를 원한다면 평균 신호,
 를 얻는다.

본문에서  는 컨벌루션을 의미한다.
화상처리에서, 컨벌루션의 2차원 이산처리
형태는 다음과 같다.

여기서  는 원 화상 배열을 나타내고,
 는 컨벌루션 가중치 함수이다. 이 경우
 거나
 이고,
 거나
 이면
 이라고 가정했다(따라서, 컨벌루션 연산은 화상 경계부근에서 간선 효과를 가진다).

그림 6 평균화의 요소들
때때로, 가중치 함수 의 값은,
 와
 의 직사각형 공간에 포함되면 1이고, 외부에 있으면 0이 된다.
 와
 의 직사각형 공간에 포함되면 1이고, 외부에 있으면 0이 된다.
 오
 로 구성되는 직사각형 공간의 크기는 평탄화(smoothing)의 정도를 결정하는데
그 값이 클수록 평탄화 정도는 증가한다. 그림 6은 직사각형 평탄화를 이용해서 이진
화상에 평균화를 한 후 임계값 연산을 한 예제를 보여주고 있다(이 그림에서, 검은
화소는 높은 값을 가지고 있고 반대로 흰 화소는 낮은 값, 또는 0을 의미한다. 이것은
그림을 단순히 하기 위한 방법이었다). 평탄화 연산이 간선을 간략히 하고 가는 선과
조그만 세부 사항들은 삭제하는 것에 주목할 필요가 있다.
평탄화
함수로 사용되는 가장 일반적인 함수는 2차원 가우시안 함수(Gaussian function)이다
:

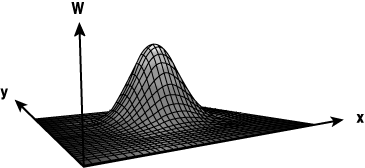
그림 7 가우시안 평탄화 함수
이 함수가 묘사하는 평면은 그림 7에 나타난 종 모양(bell-shaped)이다(가우시안
평면을 좀 더 자세히 묘사하기 위해 그림에서 축을 표시하였다). 가우시안의 표준
편차 σ는 평면의 넓이(width)뿐만 아니라 평탄화의 정도를 결정한다.  는
 와
 에 대한 단위 적분을 포함한다. 장애물과 로봇을 가지고 있는 격자공간에 대해서
서로 다른 평탄화 정도를 사용한 3가우시안-평탄화(three Gaussian-smoothed version)
화상이 원래 화상과 함께 나타나 있다(화상 평탄화와 필터링 연산의 이산
버전은 일반적으로 성능을 향상시키기 위해서 이산값들 사이에 삽입된다).[Charles
Richards]
화상들이 점차적으로 흐릿해지는 사실에 주목해야
한다. 이와 같은 희미해짐(blurring)에 대해서 생각해 볼 수 있는 한 가지 방법은
화상 강도 함수  가 직사각형 공간인 열전도 판(heat-conducting plate)에 대해서 초기 온도를
나타낸다고 생각하는 것이다. 시간이 지남에 따라, 열은 등방성(isotropically)으로
확산된다. 이렇게 생각하면, 그림 8의 화상들은 시간의 경과에 따른 온도 변화를
의미한다고 생각하면 된다. Koenderink[Koenderink 1984]는 실제적으로 표준 편차
σ를 가지는 가우시안 함수로 화상을 컨벌브시키는 것은, 초기 조건이 화상 강도
공간에 따라 주어진다면 시간 변수 σ를 가지는 확산식(diffusion equation)을 푸는
것과 동일하다고 했다.
(2) 간선 강조
앞에서
언급한 바와 마찬가지로, 컴퓨터 시각 기술은 화상 간선(edge) 추출 기술을 필요로
한다. 이러한 간선 형상들은 특정 종류의 선 그리기 방법으로 변환된다. 변환된 화상의
개략적인 모습들은 특정 화상이 반드시 포함하고 있어야 하는 전형적인 특징들과
비교될 수 있다. 물체의 윤곽을 추출해내는 한 가지 방법은 화상의 간선을 강조(enhance)하는
것이다. 간선(edge)은 화상에서 어떤 특정한 성질 때문에 서로 다른 값으로 표시되는
경계선이고, 그림 3에서 설명된 것처럼 중요한 개체 성질이다.
처음에는
화상이 단순히 1차원이라고 생각하였다. 즉,  가
 차원에서만 변화하는 것이다. 그리고 다시 2차원 경우로 일반화시켰다. 이제 1차원
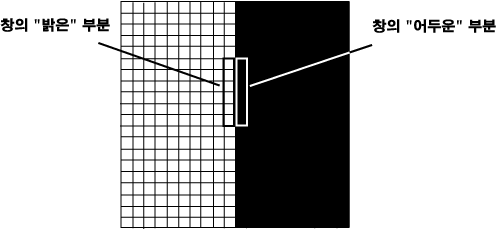
화상의 간선을 뚜렷이 하기 위해서 화상에 대해서 일부분은 밝고, 일부분은 어두운
창으로 컨벌브시킨다. 이러한 창은 그림 8에 나타나 있다. 창의 합은 화상의 어떤
부분에서도 항상 0이다.
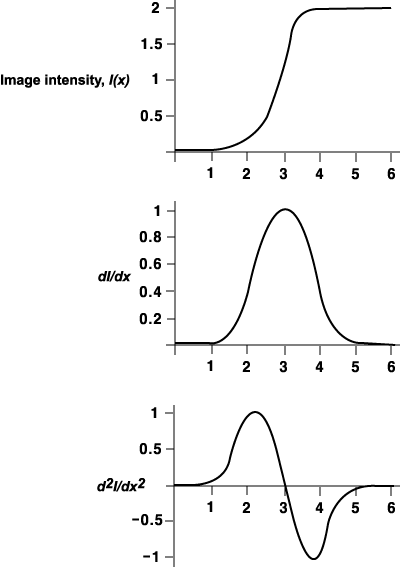
만약 그림 9에 나타난 창이  방향으로 컨벌브 한다면, 최고값은 간선이
 방향으로 정렬되는 지점에서 나타나게 된다. 이 연산은 화상강도 함수의
 에 대한 일차 미분값,
 와 유사하다. 게다가 만약 화상에 대ㅐㅎ서 이차 미분값을 구한다면 더욱 중요한
효과가 나타나는데, 간선에 대해서 한쪽은 양수값을 가지고 다른 쪽은 음수값을 가지는
띠를 볼 수 있다. 이 효과는 그림 9에 나타나 있다. 그림 9에서는 그림 8과는 달리
강도가 급격하게 변하지 않는 것을 볼 수 있다. 물론, 화상이 더욱 심하게 변화하면,
 의 변화폭은 더욱 좁아지게 된다. 화상의 간선에서는
 이 되고, 이것은 이차 미분값의 제로 클싱(zero-crossing)이다.
그림
8 간선 강조
그림
9 화상의 미분값
(3) 평균화와 간선 강조의 결합
간선
강조를 단독으로 할 경우에는 노이즈를 강조할 수 있다. 노이즈에 덜 민감하도록
하기 위해서, 우선 평균화를 하고 간선 강조를 한다. 지금까지와 동일하게, 일차원인
경우 역시 일차 가우시안을 사용할 것이다.

여기서 σ는 표준편차이고, 평탄화 연산의 폭을 결정한다.
가우시안을 이용한 평탄화는 아래와 같은 필터된 화상을 만든다.

여기에 간선 강조를 하면 다음과 같다.

이 식에서 미분과 적분의 차수는 서로 교환될 수 있기
때문에  와 동일하다. 즉, 간선 강조와 평탄화를 결합하기 위해서, 컨벌브된 하상의 이차
미분값을 구하는 대신 가우시안 곡선의 이차 미분값으로 일차원 화상을 컨벌브하면
된다는 것을 의미한다.
2차원인 경우, 임의의 방향을 간선을 강조하기
위해서 이차 미분 형태의 연산을 필요로 한다. 라플라시안(Laplacian)이 그러한 연산이다.
 의 라플라시안은 다음과 같이 정의된다.

만약 2차원 공간에서의 가우시안 평탄화를 이용하고
싶다면, 미분과 컨벌루션의 차수를 1차원의 경우에서처럼 교환하여,

를 유도해낼 수 있다. 2차원 가우시안의 라플라시안은
그림 10처럼 뒤집어진 모자처럼 생겼다. 이 함수는 솜브레로(sombrero) 함수라고
불려진다. 모자의 폭이 평탄화정도를 결정한다.

그림 10 라플라스 필터링에서 사용된 솜브레로
함수
화상 전체에 대한 평균/간선 찾기
연산은 화상을 솜브레로 함수로 컨벌브시켜서 찾을 수 있다. 이 연산을 라플라스
필터링(Laplacian filtering)이라고 한다. 척추 동물의 망막에서 일어나는 초기 시각처리
과정이 라플라스 필터링과 유사하다고 알려져 있다. 제로 크로스(zero-crossed)된
라플라스 필터 화상은 단순한 윤곽선을 발견하는데 사용된다. 전체적 과정인 라플라스
필터링과 제로 크로스 표시는 Marr-Hildreth 연산으로 불려진다[Marr &
Hidreth 1980][Marr-Hildreth 연산의 결과는 마(Marr)가 기본 스케치(primary sketch)라고
부른 요소이다]. 이 연산의 결과는 격자공간 화상으로 나타나 있다(화상을 계산할 때, 이장에서는 제로 크로싱 대신 밴드 크로싱(band crossing)을
사용했다. 화상 강도는 영점 주위의 밴드를 지나야 표시된다.). Marr-Hildreth 연산은
간단한 경계선을 갖는 화상의 간략한 스케치에 대해 적절한 기본 구조를 제공한다.
그러나 출입구에 있는 좀더 복잡한 형태의 로봇은 정확히 그려져 있지
않다.
설명하기 쉽고 유명한 Marr-Hildreth 연산 외에도 더 좋은
결과를 나타내는 간선강조와 윤곽선 찾기 연산들이 있다. 이 중 두드러진 것은 Canny
연산[Canny 1986], Sobel 연산([Pingle 1969]에서 Irwin Sobel이 만들었다는 것을
언급하였다), Huekel 연산[Huecke 1973], Nalwa-Binford 연산[Nalwa & Binford
1986] 등이 있다. Marr-Hildreth와 다른 간선 강조는 화소 중에서 화상 간선과 선이라고
생각되는 화소를 표시한다. 이 후보 화소들은 단순한 곡선이나 선들로 연결된다.
(4) 영역 찾기
화상을
처리하는 또 다른 방법은 전체 화상 중에서 변화되지 않는 특정 성질을 가지고 있는
화상 부분인 영역(region)을 찾는 것이다. 영역 찾기와 경계선 찾기는 모두 화상을
적절한 부분으로 분리한다. 그러나 경계선 찾기와 영역 찾기 둘 다 노이즈로 인해서
특이한 성향을 보이기 쉽기 때문에, 두 방법은 종종 서로 상호보완적으로 사용된다.
우선, 화상의 영역이 의미하는 것이 무엇인지 정의한다. 영역은 다음과
같은 두 가지 중요한 성질을 만족하는 연결된 화소들의 집합이다.
1.
영역은 동질성(homogeneous)을 가지고 있어야 한다. 일반적으로 사용되는 동질성
성질은 다음과 같다.
(a) 동일한 영역의
화소들 사이의 강도 차이는 임의의 값  을 초과하지 않는다.
(b) 미리 정해진
작은 값 범위(degree)  을 가지는 다항식 표면(surface)은
 보다는 작지만, 표면과 영역값 사이의 가장 큰 오차를 갖는 영역의 화소 강도값으로
결정될 수 있다.
2. 인접한 어떤 두 영역도 동질성을 만족하면
안된다.
일반적으로, 화상의 한 부분 이상이 영역으로
나누어지고, 각 영역은 물체(world object) 또는 물체의 의미있는 부분이 되어야
한다. 간선 강조와 윤곽선 찾기 기술을 위해, 하나의 영상을 여러 영역으로 구분하기
위해 다양한 기술들이 개발되어 있다. 이 장에서는 분할합병(split-and-merge) 방법[Horowitz
& Pavlidis 1976]을 소개한다. 설명하기 쉬운 방법의 경우, 알고리즘은 단 하나의
후보 영역인 전체 화상을 가지고 시작한다. 화상을  의 화소 행렬로 구성된 사각형이라고 가정하자. 화상 안의 모든 화소가 동질성
성질을 만족시킺 못하므로(동일한 밝기 강도의 화상을 제외하고)이 후보 영역은 영역의
정의를 만족시키지 못한다. 동질성 성질을 만족시키지 않는 모든 후보 영역들 각각은
4개의 동일 크기의 영역으로 분할된다. 더 이상 분할이 필요 없을 때까지 분할이
계속된다. 인공적인 8×8화상에 대해서 강도가 1유닛 이상 변화하지
않는 동질성을 이용한 분할 방법이 설명되어 있다. 더 이상의 분할이 필요하지 않게
된 후, 인접한 분할 영역들을 검사하여 만약 인접한 영역의 화소들이 동질성을 만족하면
두 영역을 합친다. 합병(merge)은 서로 다른 순서에 의해 수행되며, 그 결과 다른
최종 영역들이 생성될 수 있다. 사실 어떤 합병 방법들은 분할 과정이 종료되기 전에
수행되기도 한다. 과정에서는 설명을 쉽게 하기 위해서 모든 합병을 마지막
단계에 수행되도록 하였다.
영역 찾기 과정을 설명하기 위해서 화상은 낮은 해상도를 가지고 있다. 좀더 높은 해상도를 갖는 화상에
대한 결과를 설명하였다. 몇 개의 작은 영역들과 불규칙적인 영역
간선을 볼 수 있다. 분할 합병 알고리즘에 의해 발견된 영역들은 큰 영역들 사이의
전이 영역인 아주 작은 영역들을 삭제하거나, 간선들을 곧게 하고, 물체의 알려진
모양을 고려하는 등의 방법을 통해 정리(clean-up)할 수 있다.
가우시안을 이용한 화상 평탄화
과정에서 설명하였듯이 이 과정도 등방성 있는(isotropic) 열 확산과 관계가 있다.
Perona와 Malik[Perona & Malik 1990]은 영역 찾기에 사용될 수 있는 비등방성
확산(anisotropic diffusion) 과정 모델을 제안하였다. 이 방법은 조그만 강도 변화의
방향을 평탄화하도록 하고 큰 강도 변화 방향에 대해서는 평탄화하지 못하도록 한다.
[Nalwa 1993, p.96]에 설명되어 있듯이, 결과는 강도 변화(gradient)가 큰 부분을
교차하는 간선을 가진 동일 강도 영역의 형태(the formation of uniform-intensity
regions that have boundaries across which the intensity gradient is high)가
된다.
(5) 강도 이외의 다른 화상 특징의
사용
간선 강조와 영역 찾기는 화상 강도의 동질성 외에 여러 다른
화상 성질들에 의해서도 가능하다. 시각 텍스처(texture)도 이러한 성질 중의 하나이다.
많은 물체의 표면 반사도는 시각 텍스처라고 불리는 미세 변화(fine-grained variation)이다.
대표적인 예들로 초원, 카펫의 부분, 나뭇잎, 동물의 털 등의 차이를 생각할 수 있다.
이러한 반사도 변화는 화상 강도에 대해서도 유사한 미세 구조를 보인다.
컴퓨터
시각 연구가들도 텍스처의 많은 변종을 확인하였고 텍스처를 분석하기 위한 다양한
방법들을 개발하였다. 크게 구조적 방법(structural method)과 통계적 방법(statistical
method)으로 나뉜다. 이 방법들은 화상을 분류하거나, 화상을 특이한 성질을 가지고
있는 영역으로 분할하는 데 사용된다. 구조적 방법은 영역을 흰색과 검은색으로 이루어지는
작은 모양인 텍셀(texel)의 집합(tessellation)으로 표현한다([Balard & Brown
1982]의 6장 참고).
통계적 방법들은 화상 텍스처를 화상 전체 영역
강도에 대한 확률 분포로 표현하고자 하는 것이다. 간단한 예로 초원의 화상을 생각해
보자. 이 경우 확률 분포는 얇고 수직으로 분포딘 영역을 표현해야 한다. Zhu[Zhu,
Wu, & Mumford 1998] 등의 최근 연구에서는 다양한 시각 텍스처에 대한 확률
분포를 예측하였다. 일단 분포가 알려지면, 텍스처를 분류할 수 있고 텍스처에 기반하여
화상을 분류할 수 있다.
텍스처 이외에도 사용될 수 있는 여러 가지
특징이 있다. 만약 카메라와 물체 사이의 거리를 레이저 거리 측정기 등을 통해서
쉽게 알아낼 수 있다면, 각 화소값들이 카메라와 물체 사이의 거리를 나타내는 영역
화상(range image)을 만들 수 있고 급격한 차이를 찾을 수 있다. 그리고 움직임과
색깔 역시 화상처리 연산에서 사용될 수 있다.
일단 위에서 이야기한 기술로 화상을
처리한 후에 우리가 하고자 하는 일은 그 장면에서 필요한 정보를 추출해내는 것이다.
컴퓨터 시각에서는 이 단계를 장면 분석(scene analysis)이라고 한다. 장면에서 화상으로의
변환은 다대일 변환이므로, 장면 분석 단계에는 부가적인 화상, 또는 우리가 다루게
될 장면의 종류에 대한 일반적인 정보가 필요하다. 부가적인 화상에 대해서는 이후에
스테레오 시각을 설명할 때 설명하기로 하고, 여기서는 장면에 대한 지식을 장면에서
정보를 뽑아내는 데 어떻게 사용할 수 있는가에 대해 설명하겠다.
필요한
부가적 지식은 물체의 표면 반사성(reflectivity)과 같은 일반적인 것일 수도 있고,
이 장면에서는 문 옆에 박스가 몇 개 쌓여 있다는 등의 설명과 같은 구체적인 것일
수도 있다. 또한 명시적(explicit)일 수도 있고 내포적(implicit) 일 수도 있다.
예를 들어 선 찾기(line-finding) 알고리즘은 내부적으로 무엇이 선을 구성하는가에
대한 정보를 가지고 있다. 일반적인 것과 구체적인 것 사이에 있는 것이 장면에 대한
기타 자잘한 정보이다. 예를 들어 카메라의 위치, 조명의 위치라든가 장면이 실내의
장면인지 야외의 장면인지 등이 있다. 여기서는 이러한 여러 가지 측면 중 몇 가지를
선택하여 다룰 것이다. 더 자세한 것을 알고 싶다면 컴퓨터 시각에 대한 책을 읽을
것을 권한다.
화상의 표면 반사성과 음영 강도(shading of intensity)에
대한 지식은 장면에서 완만한 물건의 모양을 알아내는데 사용된다. 특히, 화상의
음영을 통해 물건 표면의 생김새를 계산해 낼 수 있다. 음영으로부터 모양을 추정하는
방법은 Horn 등에 의해 개발되었다([Horn 1986]은 보다 자세한 내용을 다루고 있다).
텍스처의 물체들은 원근법적으로 투영되어 화상에 나타나기 때문에 이것을 이용하면
텍스처로부터 물체의 모양과 중요한 깊이 정보를 알아낼 수 있다.
이미
이야기했듯이, 장면에 대한 아이콘 모델이 필요할 때도 있고, 장면에 대한 어떤 특징만으로
충분할 때도 있다. 아이콘기반 장면 분석은 종종 장면이나 그 장면의 일부분에 대한
모델을 만들어낸다. 특징기반 장면 분석은 현재 작업에 필요한 특징들을 장면으로부터
직접 추출해낸다. 작업 지향(task-oriented) 시각 혹은 의도적(purposive) 시각이라고
불리는 (예를 들자면 [Ballard 1991, Aloimonos 1993]) 컴퓨터 시각에서는 특징기반
장면 분석 방법을 사용한다.
(1) 화상의 선과 곡선에 대한 해석
빌딩 내부나 격자공간의 장면처럼 직선을 둘러싸인 물체를 포함한다는
사실이 알려져 있는 장면에 대해서는, 화상에 있는 선을 가정하는 것이(나중에 이것은
장면의 주요 성분과 관련이 있다). 장면 분석에서는 매우 중요한 단계이다. 화상의
선은 직선을 영역의 모서리나 가장자리에 맞추는 여러 가지 기술들을 이용하여 만들
수 있다. 곡선으로 이루어진 물체가 있는 장면에서, 화상의 곡선은 타원이나 포물선,
쌍곡선 등과 같은 구부러진 조각들을 그 물체의 영역에 맞추어서 만들 수 있다(예를
들어 [Nalwa & Pauchon 1987]). 그 이후 짧은 선들을 제거하거나, 짧은 선이나
곡선을 연결하는 등의 적합화(fitting)작업을 한 후에 이후의 해석을 위해 화상을
선 그리기(line drawing)로 변환한다.
장면의 속성을 선 그리기의
요소들과 연관시키는 여러 가지 방법이 있다. 이러한 연관을 선 그리기에 대한 해석(interpreting)이라고
한다. 예를 들기 위해 선 그리기의 해석 방법 중 하나를 소개한다. 우선, 장면에
나오는 평면 중에서 세 평면이 한점에서 만나는 경우는 없다고 가정한다[이런 면을
삼면체 꼭지점으로 구성된 다면체(trihedral vertex polyhedra)라고 한다]. 이런
장면의 일반적인 예가 그림 11에 있다. 이 그림에서 볼 수 있듯이, 그림의 장면 내부에는
벽과 바닥 그리고 천장이 있고, 바닥에는 입방체가 하나 있다. 이런 장면 내부에는
벽과 바닥 그리고 천장이 있고, 바닥에는 입방체가 하나 있다. 이런 장면에서 두
평면이 장면의 모서리에 교차하는 방법은 세 가지밖에 없다. 그 하나는 두 평면이
하나의 모서리를 이루는 것인데, 이 때 평면 중 하나가 다른 하나를 가린다(즉, 평면
중 하나만 장면에 보인다). 이러한 모서리를 가리는 모서리(occlude)라고 한다. 가리는
모서리에 대한 이름이 그림 11에 화살표로 나와 있다. 화살표의 머리가 모서리와
나란히 되어 있고 가리는 역할을 하고 있는 평면이 화살표의 오른쪽에 있다. 또 다른
방법은 두 평면이 모두 보이도록 교차하는 방법이다. 이러한 교차를 블레이드(blade)라고
하는데, 두 평면이 앞으로 볼록하다. 이러한 모서리를 더하기 기호(+)로 표시한다.
마지막 방법은 폴드(fold)라고 하는데, 모서리가 안으로 들어가 있다. 이러한 모서리를
빼기 기호(-)로 표시한다.

그림 11 방의 장면
주어진 장면에서 화상을 가져오고,
그림 11과 같이 화상을 선 그리기로 표현할 수 있다고 가정하자. 장면(scene)에서
볼 수 있는 간선의 종류를 정확히 설명할 수 있도록 화상(image)의 각 선들에 표식을
할 수 있을까? 어떤 상황에서는 가능하다. 먼저 한 장면의 화상은 두 간선이 일렬로
늘어서서 하나의 선을 만드는 경우는 없다고 가정하는 전체적 관점(general viewpoint)을
통해서 얻어져야 한다. 삼면체 꼭지점으로 구성된 다면체라는 가정하에서, 화상 안의
선에 표식을 다는 방법은 화상 안의 선의 결합점을 이용한 표식 방법이 몇 가지밖에
없다는 사실에 근거한다. 다른 종류의 표식 방법은 그림 12에서 볼 수 있다. 화상
결합점에서 선에 표식을 다는 방법들이 이 외에도 많이 있지만 주어진 다면체 장면에
표식을 달 수 있는 방법은 위의 방법밖에 없다.

그림 12 결합점에서 선에 대한 표식[Huffman 1971]
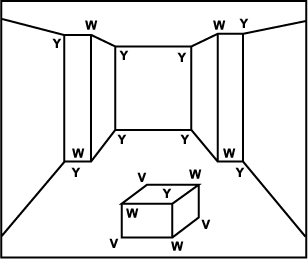
그림 13 이미지내의 교차점 분류
선-표식 장면 분석은 먼저 화상
안의 결합점의 모양에 따라 화상 안의 모든 결합점, 즉 V, W, Y, T형 결합점의 표식을
매기는 것에서 시작한다. 그림 13은 실내 화상에 대해서 이와 같은 작업을 한 결과이다.
그러나 이러한 작업은 그림 12에 설명된 방법 중 하나를 통해서 해야 한다. 또한
두 결합점을 연결하는 화상의 선은 일관된 표식을 가지고 있어야 한다. 이러한 제약을
통해서 가끔은(항상 그렇지는 않지만) 표식 방법이 하나만 유일하게 존재하게 된다.
일관된 표식이 없는 것은 화상을 선 그리기로 바꾸는 과정에서 오류가 존재하거나
장면이 삼면체 꼭지점으로 구성된 다면체가 아니기 때문이다. 이러한 제약 조건에
따라 화상의 선에 표식을 붙이는 문제는 AI 에서 제약조건만족문제(constraint satisfaction
problem) 라 불리는 문제군의 한 예이다. 이러한 일반적인 문제군을 푸는 방법에 대해서는
다음에 설명하기로 하고, 지금은 그림 13이 화상에 일관된 표식을 다는 방법을 가지고
실험해 보기로 하자(물론, 그림 11에서 표식이 있는 장면에 해당하는 화상의 표식
달기도 이러한 일관된 표식 달기 중의 하나이지만, 이 장면은 그러한 표식을 추측한
것이다. 화상 안의 선에 대해서 일관된 표식을 찾는 자동화된 방법을 생각할 수 있을까?).
삼각형 꼭지점으로 구성된 다면체 화상 안의 선과 선의 결합점에 표식을
다는 장면 분석 기술은 [Guzman 1968, Huffman 1971, Clowes 1971]에 의해서 시작되었고,
[Waltz 1975] 등은 이 부분을 광범위하게 연구하였다. 또한, 비평면 공간을 포함하는
장면에 대한 유사한 분석을 수행하는 것도 약간의 성공을 거두었다. 선 그리기를
해석하는 문제에 대한 더 완벽한 설명 (인용도 포함)은 [Nalwa 1993, 4장]을 참조하면
된다.
선 그리기의 직선과 곡선의 해석은 장면에 대한 유용한 정보를
많이 제공한다. 예를 들어, 수직 방향 폴드(장면에서 볼록한 간선)를 향해 나아가고
있는 로봇은 결국 모서리에 도착할 것이다. 다면체 장애물을 피해 이동하기 위해서는
수직 방향의 블레이드를 피해 지나가면 된다. 한 부류의 장면들에 대한 일반적인
지식을 충분히 가지고 있으면, 선 그리기를 해석함으로써 필요한 특징이나 특징기반
모델을 얻을 수 있다.
(2) 모델기반의 시각
장면에
대해 점점 더 늘어가는 지식을 이용하는 것에서 한 걸음 더 나아가, 장면에 나타나는
물체 모형의 이용에 대하여 고려해 보자. 예를 들어, 만약 한 장면이 로봇 제작에
쓰이는 각종 부속 및 부 재료들로 구성되어 있다는 것을 안다면, 이것들의 형상 모델이
이미지를 해석하는 과정에 도움을 줄 수 있다. 이 책에서는 모델 기반의 시각에 쓰이는
몇몇 방법에 대하여 대략 설명해 보고자 한다. 보다 자세한 내용을 원한다면 [Binford
1982, Grimson 1990, Shirai 1987]을 참조하면 될 것이다.
선이나
굴곡 등이 이미지를 구성하는 정보로 사용될 수 있듯이, 모델의 일부나 모델의 원근법적
투영 역시 이미지를 구성하는 용도로 사용될 수 있다. 예를 들어 하나의 장면에 직육면체가
포함되어 있다면(그림 11처럼), 이 장면에 대한 이미지 구성요소에 직유면체의 원근법적
투영을 포함시킬 수 있을 것이다. 직육면체를 정의하는 요소로는 크기, 위치 그리고
방향 정보 등이 포함된다. 이 정보들은 조절하여 적합한 이미지를 구성하는 직육면체의
투영된 형상을 찾게 된다.
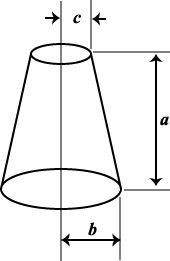
그림 14 일반화된 실린더
모델을 구성하는 블록으로 일반화된
실린더(generalized cylinders) [Binford 1987]가 사용되기도 한다. 그림 14는 일반화된
실린더의 모습을 보이고 있다. 각 실린더는 그림에서처럼 9개의 인자를 가지고 있다.
인간의 모습을 대략적으로 재구성한 예가 그림 15 이다. 이 방법은 계층적 표현에
적용될 수 있는데, 이는 형태를 보다 자세하게 표현할 수 있는 작은 실린더들을 결합하여
모델의 각 실린더를 표현하는 것이 가능하기 때문이다. 일반화된 실린더를 이용하여
장면 객체를 표현한다는 것은 Nalwa가 이야기하고 있듯이 [Nalwa 1993, p.293] 쉬운
일이 아니다. 그러나 개체를 인식하는 목적으로 이 방법을 사용한 예가 몇몇 존재한다[Brooks
1981]. 3차원 구조체의 표현에 있어서 모델을 사용하는 방법에 대한 보다 자세한
정보를 원한다면 [Ballard & Brown 1982, Ch.9]을 참고하길 바란다.
모델을
구성하는 다양한 요소들을 이용하여, 전체 장면의 아이콘 모델이 만들어질 때까지,
혹은 수행중인 작업에 필요한 자질을 얻어낼 수 있는 충분한 정보를 얻을 때까지
모델을 조절할 수 있다. 장면 분석으로부터 생성된 아이콘 모델로부터 이미지 시뮬레이션을
구성한 후 이것과 실제 이미지를 비교하여 모델기반 방법론의 정확도를 평가할 수
있다.
시뮬레이션한 화상은 화상처리(카메라 앵글 등)에서 사용된
매개변수를 가진 모델로부터 랜더링해 주어야 한다. 그렇게 하기 위해서는 조명,
표면 반사 특성과 컴퓨터 그래픽에서 사용하는 다른 모든 랜더링 처리에 대한 좋은
모델이 있어야 한다.
원근법적 투영을 이용하면, 크고
먼 물체가 작고 가까운 물체와 비슷한 화상으로 만들어질 수 있다. 따라서 하나의
화상으로부터 물체까지의 거리 측정이 어려워진다. 깊이 정보는 두 개 또는 그 이상의
화상(stereo vision)을 가지고, 삼각 계산법에 기반한 스테레오 시각을 이용해서
얻을 수 있다.
그러나 스테레오 시각에 대해서 이야기하기 전에,
특정 환경에서 적절한 사전 지식을 가지고 있으면 하나의 화상으로부터도 깊이 정보를
알아낼 수 있다는 사실을 살펴보자. 예를 들면, 화상에서의 텍스처 분석(장면 텍스처의
원근법적 변형의 설명)은 장면에 잇는 몇 개의 원소가 다른 것들보다 더 가깝다는
것을 알려줄 수 있다. 훨씬 더 중요한 깊이 정보는 특정한 상황에서 하나의 화상으로부터
얻어질 수 있다. 예를 들어, 물체가 바닥에 있고, 바닥으로부터의 카메라 높이를
안다면, 카메라 렌즈 중심으로부터 화상내의 적절한 점까지의 각을 사용해서, 물체까지의
거리를 계산할 수 있다. 그림 16에 그러한 계산의 예가 있다(각 α는 카메라 초점
길이와 화상 크기를 이용해서 계산될 수 있다). 비슷한 계산을 적용하면 물체까지의
거리와 물체의 크기 등을 구할 수 있다.
스테레오 시각에서도 삼각법을
사용한다. 기본 개념은 간단하다. 그림 17에서 보여주는 것과 같이 두 개의 화상을
생각하자. 기준선(baseline) b에 의해 중심이 분리된 두 개의 렌즈를 사용한다.
렌즈에 의해 생성된 거리 d에 있는 장면 점의 화상 점들은 그림에서와 같다.
그림에서 보여준 바와 같이 렌즈의 중심으로부터 각각의 화상 점들과의 각도를 이용해서
d를 계산할 수 있다. 각도의 기준선 측정의 정확도가 주어지면 기준선과 더
크고 물체 거리가 더 작을 경우 정확도는 더 높아진다. 그림 16은 광학축이 평행하고,
화상 평면이 같고, 장면 점이 두 개의 평행한 광학 축에 의해 형성된 것처럼 같은
평면에 있다고 가정함으로써 상황을 다소 단순화시켰다. 단순화시키지 않을 경우,
매우 복잡해지지만 삼각법의 기본적인 개념은 비슷하다(동물과 어떤 종류의 로봇에서는
광학 축이 하나의 장면에서 흥미있는 물체에서의 점으로 회전될 수 있다).
그러나
스테레오 시각에서 삼각 계산법은 그리 복잡한 것이 아니다. 하나 이상의 점이 포함된
장면에서(대개 그렇다!), 그 장면 점까지의 거리를 계산하기 위해서 두 화상의 한
쌍의 점들이 같은 장면 점에 대응해야 한다. 다시 말하자면, 어떤 장면의 한 점이
한 화상의 어느 화소에 해당한다는 것을 알았을 때 다른 이미지의 해당 화소도 찾아낼
수 있어야 한다. 이런 것을 일치문제(correspondence problem) 라고 기술하고자 한다.
우선 기하학적 분석에 따르면, 한 이미지의 화소에
대응하는 다른 이미지의 화소를 찾기 위해서는 (두 차원이 아니라) 한 차원을 따라서만
탐색을 행하면 된다. 이때 탐색에 이용되는 차원을 에피폴라 축(epipolar line)이라
한다. 1차원 탐색은 해당하는 에피폴라 축을 따라서 두 화상의 강도의 교차 상관관계(cross-correlation)를
계산함으로써 이루어진다. 그리고 대부분의 응용 분야의 경우, 화상의 각 점에 대한
일치 관계를 찾을 필요는 없고, 선(line)과 같이 더 큰 단위의 화상요소에 대해서
찾으면 된다. 각 화상에 대해 장면 분석을 행하면 어느 선끼리 대응하는지 알 수
있다. 스테레오 시각의 계산 방법에 대한 개관은[Nalwa 1993, 7장]에 잘 나와 있다.
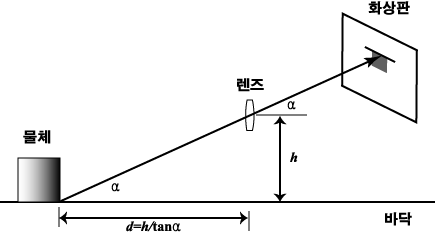
그림 16 하나의 화상으로부터의 거리 계산
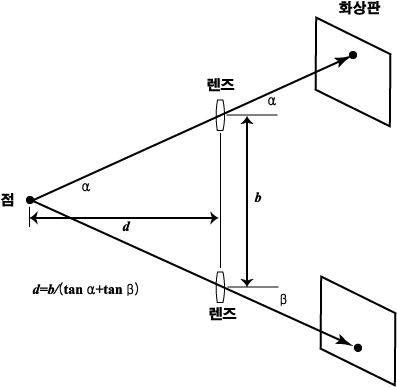
그림 17 스테레오 시각에서 삼각법
ALVINN 시스템의 개발자들은 계속해서 다른 자동운전
시스템을 개발하고 있으며 여기에 이 장의 논의와 관계된 기술들이 사용되고 있다
[Thorpe, et al. 1992 (Thorpe, C., Hebert, M., Kanade, T., and Shafer, S., "The
New Generation System for the CMU Nablab," in Masaki, I. (ed.), Vision-Based
Vehicle Guidance, nl pp.30-82, Berlin: Springer-Verlag, 1992.)]. 이와 관련해서
[Hebert, et al. 1997 (Hebert, M., et al., "Mobility for Unmanned Ground
Vehicles," in Firschein, O., and Strat, T. (eds.), Reconnaissance, Surveillance,
and Target Acquisition for the Unmanned Ground Vehicle: Providing the Surveillance
"Eyes" for an Autonomous Vehicle, San Francisco: Morgan Kaufmann,
1997.)] 은 스테레오 시각과 적외선 감지기를 사용하는 야외 자동 운전 시스템을
위한 이동 소프트웨어에 대해 기술하고 있다.
전체 장면에 대한 3 차원 모델을 요구하는 컴퓨터
시각 시스템의 응용도 있지만, 일반적으로 로봇은 행동을 지시하는 데 충분한 정보만
있으면 된다. 완전한 장면 모델을 계산하는 데 초점을 맞춘 기존의 연구에 비하여
몇몇 연구자들은 그들이 좀더 적절한 작업이라고 여기는 의도적 시각 (purposive
vision) 에 초점을 맞춰왔다. Horswill 은 명료하면서도 작업 기반적인 로봇 시각
시스템의 예를 보였다. 이런 작업기반 시스템은 종종 로봇의 안정된 이동에 적합하다.
[Churchland, Ramachandran, Sejnowski 1994 (Churchland, P. S., Ramachandran,
V. S., and Sejnowski, T. J., "A Critique of Pure Vision," in Koch,
C., and Davis, J. (eds.), large-Scale Neuronal Theories of the Brain,
pp.23-60, Cambridge, MA: MIT Press, 1994.)] 를 참고하라.
심리학과 신경생리학에서도 시각 인지처리의 상당
부분을 연구해왔다. [Gibson 1950 (Gibson, J. J., The Perception of the Visual
World, Boston: Houghton Mifflin, 1950.), Gibson 1979 (Gibson, J. J., The
Ecological Approach to Visual Perception, Boston: Houghton Mifflin, 1979.)]
는 시야 (visual field) 의 변화로부터 주위의 물체 중에서 움직이는 물체를 어떻게
알아내는지에 대해서 연구했다. [Julesz 1971 (Julesz, B., Foundations of Cyclopean
Perception, Chicago: The University of Chicago Press, 1971.)] 은 인간이
깊이를 인지하기 위해서 임의의 점들의 통계치로부터 불연속성을 이용한다는 것을
발견하였다. [Marr, Poggio 1979 (Marr, D., and Poggio, T., "A Computational
Theory of Human Stereo Vision," Proceedings of the Royal Society London,
B, 204:301-328, 1979.)] 는 스테레오 시각에 대한 적절한 신경 모델을 개발하였다.
개구리를 이용한 실험을 통해 [Letvinn, et al
1959 (Letvinn, J., Maturana, H., McCulloch, W., and Pitts, W., "What the
Frog's Eye Tells the Frog's Brain," Proc. IRE, 47:1940-1951, 1959.)]
에서는 개구리의 시각 시스템은 조명도의 변화 (커다란 동물이 다가옴에 따른 그림자나,
파리와 같은 작고 검은 물체의 빠른 움직임 등에 따른) 만을 알아챌 수 있을 뿐이라고
밝히고 있다. [Hubel & Wiesel 1968 (Hebel, D., and Wiesel, T., "Receptive
Fields and Functional Architecture of Mondey Striate Cortex," Journal
of Physiology (London), 195(1):215-23, March 1968.)] 은 원숭이를 이용한
실험을 통해 원숭이의 신경 피질이 시야에 포착되는 짧은 방향성 직선 조각에 의해
흥분된다는 것을 밝혀냈다. 참게 (horseshoe) 를 사용한 실험을 통해 참게의 시각
시스템에서 인접한 뉴런은 서로를 억제시킴 (측면 억제, lateral inhibition) 을
알 수 있었고, 후에 라플라스 필터링 (Laplacian filtering) [Reichardt 1965 (Reichardt,
W., "On the Theory of Lateral Nervous Inhibition in the Complex Eye of
Limulus," Progress in Brain Research, 17:64-73, 1965.)] 으로 알려진 것과
같은 정도의 효과를 거두었다. 생물학적 시각에 대한 더 많은 정보는 [Marr 1982
(Marr, D., Vision: A Computational Investigation into the Human Representation
and Processing of Visual Information, New York: W. H. Freeman, 1982.), Hubel
1988 (Hubel, D., Eye, Brain, and Vision, New York: W. H. Freeman, 1988.)]
에서 얻을 수 있다.
[Bhanu & Lee 1994 (Bhanu, B., and Lee, S.,
Genetic Learning for Adaptive Image Segmentation, Boston: Kluwer Academic
Publishers, 1994.)] 는 화상 분할을 위하여 유전학적인 기법을 도입하였다.
주요한 컴퓨터 시각 학회로는 International Conference
on Computer Vision (ICCV), European Conference on Computer Vision (ECCV), Computer
Vision and Pattern Recognition (CVPR) 등이 있다. 주요한 저널로는 International
Journal of Computer Vision 이 있다.
컴퓨터 시각에 대한 교재로는 [Nalwa 1993 (Nalwa,
V. S., A Guided Tour of Computer Vision, Reading, MA: Addison-Wesley,
1993.), Horn 1986 (Horn, B. K. P., Robot Vision, Cambridge, MA: MIT Press,
1986.), Ballad & Brown 1982 (Ballard, D. H., and Brown, C. M., Computer
Vision, Englewood Cliffs, NJ: Prentice Hall, 1982.), Jain, Kasturi, &
Schunck 1995 (Jain, R., Kasturi, R., and Schunck, B., Machine Vision,
New York: McGraw-Hill, 1995.), Faugeras 1993 (Faugeras, O., Three-Dimensional
Computer Vision: A Geometric Viewpoint, Cambridge, MA: MIT Press, 1993.)]
등이 있다. [Fischler & Firschein 1987 (Fischler, M. A., and Firschein, O.
(eds.), Readings in Computer Vision: Issues, Problems, Principles, and Paradigms,
San Francisco: Morgan Kaufmann, 1987.)] 에는 중요한 논문들을 모아 놓았다. 외부
장면에 대한 책으로는 [Strat 1992 (Strat, T., Natural Object Recognition,
Berlin: Springer-Verlag, 1992.)] 가 있다. [Gregory 1966 (Gregory, R., Eye
and Brain: The Psychology of Seeing, New York: McGraw-Hill, 1966.)] 에서는
우리가 어떻게 볼 수 있는가에 대한 일반적인 설명을 하고 있다.