
코그니트론 과 네오코그니트론
신경망 이론과 응용(1) : 김대수, 하이테크 정보, 1992, Page 243~279
5. 네오코그니트론의 자기조직화 (Self-organization)
(1) 자율학습과 최대 출력 셀들의 강화 (reinforcement)
9. 선택적 주의 (Selective Attention) 모델 [FUK86, FUK87b]
인간은 그리 어렵지 않게 패턴들을 인식할 수 있다. 두세달된 아이의 경우를 예로 들어보자. 아장아장 걷는 어린 아이는 특별한 노력없이도 주변에 있는 많은 얼굴들과 물건들을 인식할 수 있다. 더군다나 그 대상들이 멀리 떨어져 있거나 회전된 상태에서도 비교적 정확하게 인식할 수 있다.
그러면 컴퓨터가 어떻게 시각적인 패턴을 인식할 수 있을까? 가장 좋은 전략 중의 하나는 인간의 두뇌 그 자체로부터 배우는 것이라고 생각된다. 이러한 시각에 관련된 두뇌에 관한 연구는 오래전부터 시작되었으며, 60년대 이후 생리학적 연구가 활발히 진행되어 두뇌연구에 많은 공헌을 하였다. 특정한 방위들 (orientations) 에서 선 (line) 과 모서리 (edge) 와 같이 시각 패턴의 국부적인 특징들에 대하여 선택적으로 반응하는 뉴런들의 대뇌의 시각영역에서 발견되었다 [HUB62]. 시각 피질 (visual cortex) 보다 높은 영역 (inferotemporal cortex) 에서는 삼각형, 사각형과 같은 패턴에 선택적으로 반응할 뿐만 아니라 인간의 얼굴에 대해서도 선택적으로 반응을 나타내는 셀이 존재하는 것이 발견되었다 [BRU84]. 따라서 시각 시스템은 먼저 자극의 패턴에서 간단한 특징들을 추출하고, 추출된 특징들은 후에 복잡한 특징들로 모으는 계층적 구조를 가진 것으로 추측될 수 있다. 이와같이 보다 높은 단계의 계층에 있는 하나의 셀은 일반적으로 망막의 보다 넓은 영역으로부터 신호들을 받아들이며, 자극의 위치에는 보다 덜 민감하다.
두뇌에서의 그러한 신경망은 태어날 때부터 완성된 것은 아니다. 두뇌의 신경망은 출생 후의 주위 환경에 유연하게 순응하도록 점차 조정되어진다. 학습, 기억, 패턴인식과 같이 정교한 두뇌의 기능들이 신경망의 성장 과정을 통하여 획득되어진다고 믿어지며, 이러한 성장 과정에서 뉴런들이 가지를 확장하고 다른 많은 뉴런들과의 연결 관계를 형성한다.
인간의 두뇌와 유사한 능력을 가진 신경망 모델에 관한 연구는 지금도 계속 되고 있다. 앞에서 언급한 생리학적 증거를 바탕으로 '코그니트론' (Cognitron) [FUK75] 과 코그니트론의 새로운 (neo:new) 모델이라는 뜻을 가진 '네오코그니트론' (Neocognitron) [FUK82, FUK83, KHA90, FRE91] 이라 불리는 패턴인식 시스템이 일본의 후쿠시마 (K. Fukushima) 에 의해 1970 년대 중반과 1980 년대 초반에 각각 개발되었다.
코그니트론은 1975년 후쿠시마 (K.Fukushima) 에 의해 개발된 패턴인식 모델로서 경쟁 학습을 하는 다층의 신경망 모델이다. 이러한 코그니트론을 가지고 꾸준히 연구를 계속한 결과 후쿠시마와 그의 연구 그룹은 코그니트론보다 훨씬 정확한 신경망 패턴인식의 새로운 패러다임 (paradigm) 인 네오코그니트론을 개발했다. 네오코그니트론은 많은 셀들로 이루어진 층들이 여러개 모여 구성된 계층적 다층 네트워크이다. 이 네트워크는 셀들 사이에 가변적인 연결을 가지고 있으며, 학습에 의하여 패턴을 인식할 수 할 수 있는 능력을 가지고 있다. 학습 과정이 끝난 후에 네트워크에서 가장 높은 단계에 있는 셀들의 반응은 패턴인식의 최종 결과를 보여주며, 입력패턴의 범주에 대응하는 오직 하나의 셀만이 반응을 나타낸다. 네트워크에서의 패턴인식이 패턴들 사이의 모양에 있어서 유사성에 근간을 두고 수행되며, 입력패턴들의 일그러짐이나 크기의 변화, 위치의 이동에 크게 영향을 받지 않는다.
이 장에서는 2 절과 3 절에서 후쿠시마의 초기 모델인 코그니트론에 관하여 간략하게 기술하고, 그 이후에 네오코그니트론에 관하여 집중적으로 알아 보기로 한다. 일본의 NKH 연구소에서 오랜 기간동안 근무하다가 수년전 오사카 대학으로 근무지를 옮긴 그는 1991 년 가을에 한국에서 가진 세미나에서 네오코그니트론을 이용하여 한자를 인식하는 시스템에 대해 소개했는데, 인식 결과도 비교적 정확했으며 인식 속도도 별 문제가 없다는 견해를 밝혔다. 원래의 네오코그니트론보다 발전된 모델인 선택적 주의 (selective attention) 모델은 1986 년에 발표되었는데 [FUK86] 이 모델에 관하여는 9 절에서 간략히 기술하였다.
코그니트론은 1975 년 후쿠시마 (K. Fukushima) 에 의해 개발된 패턴인식 모델로서 경쟁 학습을 하는 다층의 신경망 모델이다. 이 모델은 인간의 인식 시스템에 대한 가설적인 (hypothetical) 수학적 모델인데, 그의 컴퓨터 시뮬레이션 결과는 그 당시에 매우 인상적인 패턴인식의 능력을 보여 주었고, 생리 학자들이 인간 두뇌의 메카니즘을 규명하도록 동기를 유발시켰다.
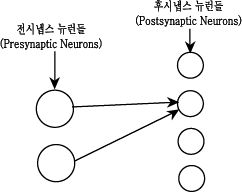
코그니트론은 시냅스에 의해 연결된 뉴런들의 층으로 이루어져 있다. <그림 1> [WAS89] 에서와 같이 한층의 전시냅스 (presynapse) 뉴런이 다음 층의 후시냅스 (postsynapse) 뉴런의 입력이 된다. 뉴런들은 2가지 형태로 나뉘어지는데 후시냅스 셀을 점화하려는 자극성 (excitatory) 셀과 자극을 억제하려는 억제성 (inhibitory) 셀로 나눌 수 있다. 뉴런의 점화는 자극성 입력과 억제성 입력의 가중화된 (weighted) 합에 좌우된다. 그러나 실제적인 메카니즘은 단순한 합보다는 더욱 복잡하다.
<그림
1> 전시냅스 뉴런과 후시냅스 뉴런
후쿠시마는 일반적으로 생물학적인 연관 관계가 적다고 믿어지는 지도학습 (supervised learning) 대신에 자율학습(unsupervised learning) 알고리즘을 사용하였다. 입력패턴의 훈련 세트가 주어지면 네트워크는 뉴런의 연결강도를 스스로 조정한다. 어느 층의 주어진 지역 (region) 에서 가장 활발히 점화하는 뉴런만이 학습을 받게 된다. 이것은 몇몇의 우수한 학생들만 선택되어 교육을 받는 '엘리트 교육' 과도 유사하다.
3 개의 층으로 이루어진 코그니트론의 연결 구역 (connection region) 은 <그림 2> 와 같다.
.GIF)
<그림 2> 코그니트론의 연결 구역 (connection region)
1981 년에 발표된 패턴인식을 위한 4 개의 층으로 된 코그니트론의 컴퓨터 시뮬레이션 결과는 다음과 같다. 각 층은 12 × 12 행렬의 자극성 뉴런들 및 그들과 같은 숫자의 억제성 뉴런들로 이루어졌다. 연결 지역은 5 × 5 뉴런들로 이루어 졌으며, 경쟁 지역은 높이와 폭이 5 개의 뉴런으로 된 마름모 (rhombic) 꼴의 모양으로 되어 있다. 측면 제어는 7 × 7개의 뉴런을 포함한다. 네트워크는 아라비아 숫자 0 에서 4 까지의 5 개 패턴을 가지고 훈련시켰는데, 이들 데이타에 의한 실험 결과는 0 의 경우를 제외하고는 매우 정확한 결과를 얻었다.
이러한 코그니트론을 가지고 꾸준히 연구를 계속한 결과 후쿠시마와 그의 연구 그룹은 신경망 패턴인식의 새로운 패러다임인 네오코그니트론을 개발했다.
코그니트론과 네오코그니트론은 상당한 유사점을 가지고 있지만 자세히 살펴보면 근본적인 차이점을 발견할 수 있다. 두 모델은 시각 피질 (visual cortex) 과 같이 조직된 다층의 (multilayer) 계층적인 (hierarchical) 네트워크들인데, 네오코그니트론은 허벨 (Hubel) 과 위젤 (Wiesel) [HUB62, HUB65, HUB77] 이 제안한 시각 시스템 모델과 더욱 유사하다. 따라서 네오코그니트론은 코그니트론보다 패턴을 인식하는 능력이 훨씬 좋다. 특히 패턴의 일그러짐, 크기의 변화, 그리고 위치의 이동 등에 영향을 덜 받는다. 일반적으로 네오코그니트론은 코그니트론과 같이 자기조직화 학습을 하며, 지도 (supervised) 학습이 쓰인 예 [FUK83] 도 있다.
코그니트론과 네오코그니트론은 인간의 학습 방법과 인지적인 능력을 흉내내어서 인간 두뇌의 기능을 이해하려는 시도로 볼 수 있다. 그러나 네오코그니트론은 상당히 복잡하고 또한 많은 계산을 필요로 하며, 한글 문자의 경우 한 문자를 인식하는데 약 20 분 가량 걸리는 큰 단점이 있다. 그러므로 오늘날의 패턴인식에 있어서 현재의 범용 컴퓨터 (PC 386) 를 이용할 경우에는 실용적인 패턴인식 모델이 될 수 없다. 그러나 컴퓨터 하드웨어의 급속한 발전과 주문형 VLSI 를 이용함으로써 복잡한 패턴인식 문제를 해결하는 실용적인 모델이 될 수도 있을 것이다.
네오코그니트론은 많은 셀들로 이루어진 층들이 여러개 연속적으로 (cascade) 연결된 구성을 갖는 다층 네트워크이다. 셀들은 아날로그 타입 (analog type) 이다. 즉, 셀들의 입력들과 출력들은 생물학적 뉴런들의 순간적인 점화 빈도들 (firing frequencies) 에 대응하는 양 (+) 의 아날로그 값을 취한다. <그림 3> [FUK88a] 은 네트워크에 사용된 셀들의 전형적인 예를 나타낸다.
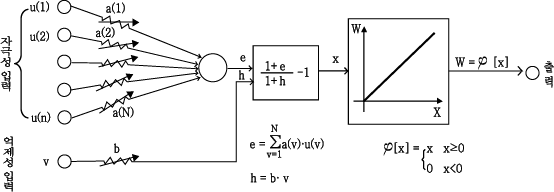
<그림 3> 하나의 S 셀에서 입력과 출력의 특성
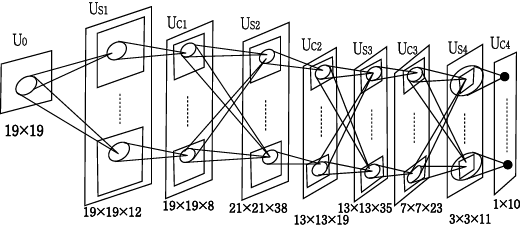
네트워크의 계층적 구조는 <그림 4> 에 예시되어 있다. 그림 밑에 있는 숫자는 뒤에서 논의될 필기 숫자 인식 시스템에 사용되는 네트워크의 각 층에 있는 S 셀들과 C 셀들의 총 수를 나타낸다. 이웃하는 층에 있는 셀들 사이에 전방향 (forward) 연결이 있다. 네트워크의 시작 단계는 U0 라고 불리는 입력층이며, 이 입력층은 수신자 셀들 U0 의 2 차원 배열로 구성되어 있다. 연속되는 각각의 단계들은 S 셀들 (S-cells) 에 의한 하나의 층을 가지며, C 셀들 (C-cells) 에 의한 하나의 층이 S 셀들 (S-cells) 에 의한 하나의 층을 뒤따른다. 그러므로 전체적인 네트워크에서 S 셀들과 C 셀들의 층이 교대로 배열된다. Usl과 Ucl 의 표현 (notation) 은 각각 l 번째 단계에 있는 S 셀들과 C셀들의 층들을 의미한다. 부수적으로 각 Us 층은 V 셀들이라고 불리는 보조의 억제성 (subsidiary inhibitory) 셀들을 포함하지만 <그림 4> 에서는 나타내지 않았다.
*
그림의 밑에 있는 숫자는 뒤에서 논의될 숫자 인식 시스템에서 사용되는
네트워크에서
각각의 층에 있는 S 셀들과 C 셀들의 총 갯수를 나타낸다.
<그림 4> 네오코그니트론의 계층적 네트워크의 구조
S 셀들은 특징 추출 셀들이다. 특징을 추출하는 S 셀들로 수렴하는 연결들은 가변적이며, 학습이나 훈련과정 동안 강화된다. 뒤는 논의될 학습과정을 마친 후에 S 셀들은 보조적인 V 셀들의 도움으로 입력패턴으로부터 특징을 추출할 수 있다. 바꾸어 말하면 입력층의 어떠한 위치에 특정한 하나의 특징이 나타날 때에만 S 셀은 활성화된다. S 셀이 추출할 특징들은 학습과정 동안에 결정된다. 일반적으로 특정한 방위 (orientation) 에서의 선 (line) 과 같은 국부적인 특징들은 낮은 단계에서 추출되며, 보다 높은 단계에서는 훈련패턴의 일부분과 같은 전체적인 특징들이 추출된다.
C 셀들은 자극의 특징들에 있어서 위치 오류를 허용할 수 있도록 네트워크내에 삽입되어 있다. S 셀들로부터 C 셀들로의 연결들은 고정되어 있고 비가변적이다. 각 C 셀은 똑같은 특징을 추출하는 S 셀들의 그룹으로부터 신호들을 수신하지만, 조금씩 다른 위치로부터 신호들을 수신한다. 이러한 S셀들 중 적어도 하나가 활성화되면 C 셀은 활성화된다. 비록 자극들의 특징이 위치에 있어서 이동되고 첫번째 S 셀 대신에 다른 S셀이 활성화된 경우에도 동일한 C 셀이 반응을 유지한다. 그러므로 C 셀의 반응이 입력패턴의 위치 이동에 보다 덜 민감하다.
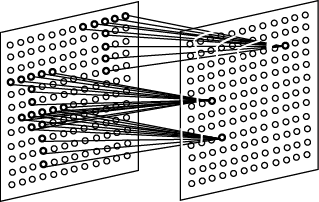
이러한 네트워크의 구조는 <그림 4> 에 보다 자세하세 나타나 있다. S 셀들과 C 셀들이 반응하는 특징들의 종류에 따라서 한 층에 있는 S 셀들과 C 셀들이 소그룹 (subgroup) 으로 구분되어 진다. 각 소그룹에 있는 셀들이 2차원의 배열로 되어 있으므로 이 소그룹을 셀 평면(cell-plan)이라 부른다. <그림 4>에서 굵은 선의 네모꼴은 셀 평면을 나타내며, 셀 평면을 둘러싸면서 수직적으로 길게 그려진 가는 네모꼴은 S 셀들 또는 C 셀들의 층을 나타낸다. <그림 5> [FUK89] 에 나타난 것과 같이 셀 평면에 있는 모든 셀들은 똑같은 공간적 분포 (spatial distribution) 의 입력 연결을 받아들이며, 단지 이전 (preceding) 셀들의 위치들만 평행하게 셀로부터 셀로 이동된다. 비록 셀들이 여러개로 나뉘어 존재하지만, <그림 4> 에서 각 셀 평면에 하나의 셀만이 그려져 있다. 그림에서 타원은 영역을 나타내고 다음 층에 있는 하나의 셀의 입력 연결은 그 영역으로부터 수신된다.
<그림
5> 셀 평면의 하나의 셀들로 수렴하는 연결들의
공간적
배열을 나타내는 예
각 층에서 셀의 밀도는 단계의 차수를 감소시키도록 설계된다. 왜냐하면 보다 높은 층에 있는 셀들은 보편적으로 입력층의 보다 큰 영역으로부터 신호들을 수신하고, 이웃하는 셀들이 유사한 신호들을 수신하게 되기 때문이다. 따라서 가장 높은 단계에서는 각 셀 평면에 오직 하나의 C 셀만이 존재한다.
이와같이 S 셀들과 C 셀들의 층들이 교대로 배열하는 전체적인 네트워크에서 S 셀에 의한 특징 추출 과정과 C 셀에 의한 위치 이동의 허용 과정이 반복된다. 이와 같은 과정 동안 낮은 단계에서 추출된 국부적인 특징들이 점차로 전체적인 특징들로 모아진다. <그림 6> [FUK89] 은 이러한 상황을 그림으로 나타낸 것이다. 가장 높은 단계에 있는 각 C 셀은 입력패턴의 모든 정보를 모으고, 오직 하나의 특정된 패턴에 대해서만 반응을 나타낸다. 바꾸어 말하면 가장 높은 단계에서, 입력패턴의 범주에 대응하는 오직 하나의 C 셀만이 활성화된다. 다른 셀들은 다른 범주들의 패턴에 대응한다. 그러므로 가장 높은 단계의 C 셀들은 '영지의 셀들 (gnostic cells)' 이라 불리며, 그들의 반응은 네트워크에 있어서 패턴인식의 최종 결과를 보여준다.
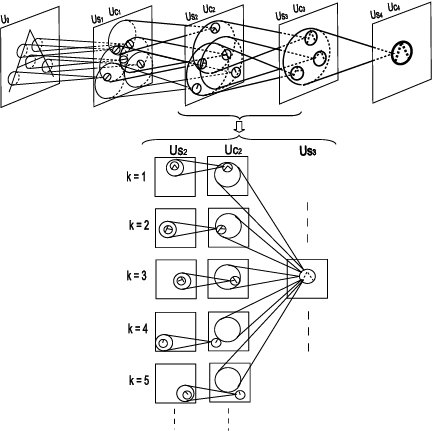
<그림 6> 네오코그니트론에서 패턴인식 과정의 예
각 단계에서 한번에 조금씩 위치 오류를 허용하는 동작 과정이 한 단계에서 모든 오류를 허용하는 것보다는 심지어 왜곡된 패턴들까지도 인식할 수 있는 능력을 네트워크에게 부여하는 데 중요한 역할을 한다. 국부적인 특징들이 상대적인 위치 오류가 특징들을 추출하고 모으는 과정에서 허용되고, 비록 입력 패턴이 일그러지거나 크기가 변하거나 위치가 이동한 경우에도 가장 높은 층에서 동일한 C 셀이 반응한다. 바꾸어 말하면 네오코그니트론이 패턴의 크기와 위치에 독립적으로 패턴의 모양을 인식한다.
S 셀들로 수렵하는 연결들은 가변적이고, 학습과정 동안에 네트워크에 주어진 자극에 따라서 점점 강화된다. 자율학습 (unsupervised learning) 과 지도학습 (supervised learning) 의 두 과정이 패턴을 인식하도록 네오코그니트론을 훈련하는 데 사용된다.
먼저 자율학습의 경우에 관하여 논의해 보자. 훈련패턴에 관한 집합을 반복적으로 표현하는 것이 네트워크 자신의 조직화에 충분하며, 이러한 패턴들이 분류되는 범주에 관한 어떠한 정보를 부여하는 것도 필요하지 않다. 네오코그니트론은 모양에서 유사성을 근간으로 정확하게 패턴을 인식하고 분류할 수 있는 능력을 자신 혼자서 획득한다.
네오코그니트론의 자기조직화는 2개의 원리로 수행된다. 첫번째 원리는 코그니트론 [FUK75, FUK81] 의 자기조직화를 위하여 도입된 것으로 두 셀 사이의 가변적인 연결이 다음의 두가지 조건을 동시에 만족할 때에 강화된다는 것이다.
① 연결을 수신하는
셀이 그 주위의 셀들 사이에서 가장 강하게 반응한다.
②
연결을 보내는 셀이 또한 반응한다.
이러한 원리는 다음과 같이 표현될
수 있다. 어떤 작은 영역내에 위치해 있는 셀들 사이에 가장 강하게 반응을 나타내고
있는 하나의 셀만이 강화된 입력 연결을 가진다. 최대 출력 셀에 연결된 각 입력
연결들에서 강화 (reinforcement) 와 양 (amount) 은 관련된 연결 셀의 반응 강도에 비례한다.
네오코그니트론에서 이러한 원리가 특징을 추출하는 S셀들로 수렴하는 가변적인 입력
연결에 적용된다.
<그림 7> 은 S 셀로 수렴하는 연결을 보여주고
있다. S 셀은 앞 층 C 셀들의 그룹으로부터 안내되는 가변적이고 자극성 연결을 받아
들인다. S 셀은 또한 V 셀이라 불리는 보조의 억제성 셀로부터 안내되는 가변적이고
억제성 연결을 받아 들인다. S 셀이 C 셀 그룹으로부터 연결을 받아들이는 것과 같이
V 셀도 C 셀의 똑같은 그룹으로부터 고정된 자극적 연결을 받아 들이고, 항상 C 셀 출력의
평균 강도로 반응하고 있다.
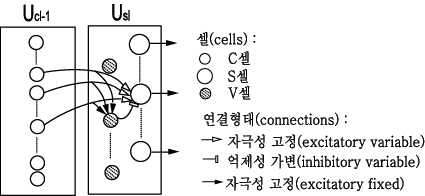
<그림 7> 특징을 추출하는 S셀로 수렴하는 연결들
이와같은 네트워크 구조와 학습 원리의 결과로 최대 출력 S셀로 연결된 가변적인 자극성 연결은 앞의 (preceding) 층에 잇는 셀들 반응의 공간적 분포에 정확하게 일치하는 '형틀 (template)' 로서 동작하도록 성장한다. 그러므로 최대 출력 S 셀은 훈련 기간 동안에 존재하는 자극의 특징을 추출하는 능력을 획득하도록 되어진다. 달리 표현하면, 자극적 연결을 통하여 S 셀은 추출될 적절한 특징의 존재를 지시하는 신호를 수신한다. 그러나, 만일 부적절한 특징이 표출된다면 V 셀로부터의 억제성 신호가 C 셀로부터의 직접적인 자극적 신호보다 강하게 되고, S 셀의 반응이 억제된다. 그러므로 S셀이 단지 적절한 특징이 표출되었을 때만 활성화된다. 부수적으로 V 셀은 부적절한 특징들의 존재를 감시한다고 볼 수 있다. 따라서 억제성 V 셀은 특징을 추출하는 S 셀들에게 부적절한 특징들을 차별할 수 있는 능력을 부여하는데 중요한 역할을 수행하며, 특징 추출의 선택력을 증가시키는 데 중요한 역할을 수행한다.
이와같은 원리에 따라서 어떤 작은 영역내에
있는 S 셀들 사이에, 최대 출력을 산출하는 한 셀만이 그의 강화된 입력 연결을 가지도록
선택된다. 이러한 원리의 '승자독점 (winner-takes-all)' 성질 때문에 똑같은 특징을
추출하는 셀들의 이중화 구성이 발생하지 않으며, 여분의 네트워크 형성이 방해를
받는다. 이러한 상황은 말하자면 '엘리트 교육 (elite education)' 과 유사하다. 훈련
자극에 가장 좋은 반응을 주는 오직 하나의 셀이 선택되고, 그 셀이 자극에 보다
적절하게 반응하도록 강화된다.
일단 하나의 셀이 하나의 특징에
반응하도록 선택되어 강화되고 나면 그 셀은 보통 다른 특징들에 대하여는 반응성을
상실한다. 하나의 다른 특징이 표출되었을 때 보편적으로 하나의 다른 셀이 최대
출력을 산출하고 그의 입력 연결이 강화된다. 따라서 셀 사이의 '일의 분배 (division
of labor)' 가 자동적으로 진행된다.
이와같은 원리로 네트워크는 스스로 정정하는 기능을 발전시킨다. 만약 자극에 대하여 강하게 반응하는 하나의 셀이 손상되어 반응을 못하게 되면, 다른 셀들보다 강하게 반응을 나타내는 다른 셀이 성장하기 시작하여 손상된 셀을 대신한다. 부수적으로 첫번째 셀이 보다 큰 반응을 하므로 그때까지 두번째 셀의 성장이 방해된다.
네오코그니트론의 자율학습을 위하여 두번째로 소개되는 원리는 최대 출력 셀이 성장할 뿐만 아니라 이웃하는 셀들의 성장을 제어한다는 것이다. 바꾸어 말하면, 최대 출력 셀이 수정 (crystal) 의 성장에서 시드 (seed) 와 같이 일하고, 이웃하는 셀들은 시드셀 (seed cell) 에서와 독같은 방법으로 강화된 그들의 입력 연결을 가진다. 시드셀들을 선택하는 과정은 뒤에서 보다 자세하게 논의될 것이다.
여기서 '하이퍼컬럼 (hypercolumn)' 이란 용어를 정의해 보자. 하이퍼컬럼이란 하나의 층에서 S셀들의 감응적 부분들 (receptive fields) 이 대략적으로 같은 위치에 처해있는 S 셀들의 그룹으로 정의된다. 달리 말하면, 각 하이퍼컬럼은 특징 추출 셀의 모든 종류를 다 포함하며, 이러한 셀들은 입력층에서 대략적으로 똑같은 장소로부터 특징들을 추출한다. 만일 층에 있는 셀 평면을 다시 배열하여 <그림 8> [FUK89] 에 보인 것과 같이 다시 쌓는다면, 하나의 하이퍼컬럼의 셀들은 하나의 열 구조 (columnar structure) 를 형성한다. 각 하이퍼컬럼은 모든 셀평면으로부터의 셀들을 포함한다.
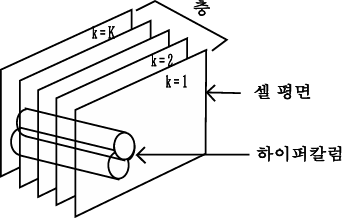
<그림 8> 하나의 층에서의 셀 평면과 하이퍼컬럼과의 관계
이제 훈련패턴을 네트워크에 제시하도록
하자. 각 하이퍼컬럼으로부터 가장 강하게 반응을 나타내는 S 셀이 시드셀의 후보로서
선택된다. 둘 또는 그 이상의 후보가 한꺼번에 똑같은 셀 평면에 나타났을 때, 가장
강하게 반응하는 하나의 셀이 그 셀 평면의 시드셀로서 선택된다. 오직 하나의 후보만이
셀 평면에 나타났을 때는 그 후보는 자동적으로 그 셀 평면의 시드셀이 된다. 만약
하나의 셀 평면에 후보가 나타나지 않으면, 그 셀 평면으로부터 시드셀이 선택되지
않는다. 그래서 적어도 하나의 시드셀이 한번에 S 셀들의 각 셀 평면으로부터 선택된다.
일반적으로 다른 훈련패턴이 주어졌을 때 다른 셀이 시드셀이 된다.
하나의
셀 평면으로부터 하나의 시드셀이 선택되었을 때 셀 평면에 있는 모든 다른 S 셀들은
그 시드셀로서 똑같은 공간 분포의 입력 연결을 가지도록 성장한다. 그 결과 셀 평면에
있는 모든 S 셀은 동일한 공간적 분포의 입력연결을 수신하도록 성장한다. 여기서
단지 앞의 C 셀들은 <그림 5> 에 예시된 바와 같이 셀에서 셀로 평행하게 이동된다.
다르게 말하면, 연결들이 하나의 셀 평면에서 반복적으로 발전한다. 그러므로 셀
평면에 있는 모든 S셀은 특별한 특징에 선택적으로 반응하도록 되고, 이러한 셀들
사이의 차이점은 추출되는 특징들의 위치 차이점으로부터 발생된다.
만일
학습되기 전에 초기상태에서 가변적인 연결강도가 모두 0이라면, 셀이 훈련패턴에
반응을 나타낼 수 없고 최대출력 셀들 (시드셀들) 이 선택될 수 없으므로, 네트워크에서의
자율학습은 시작될 수 없다. 그러므로 모든 가변적이고 자극성 연결들은 자율학습이
시작되기 전에 무조건 매우 작은 값을 가진다. 바꾸어 말하면 각 S셀은 자율학습의
초기 동안에만 일시적으로 약하고 분산된 자극적 입력 연결을 가진다. 일단 입력
연결들의 강화가 시작되면 약하고 분산된 초기의 연결들이 사라진다. 이러한 상황은
우연하게도 해부학적인 관찰 (anatomical observation) 과 일치한다. 즉, 신경 시스템
개발에 있어서 뉴런 사이의 시냅스의 열결강도는 초기에는 과다하게 생산되나 시간이
경과함에 따라 필요없는 축색들 (axons) 이 점차 사라지게 된다.
만일
이러한 일시적으로 약하고 분산된 연결들의 발생 기간이 보다 높은 단계에 있는 셀들을
위하여 조금 연기된다면 네트워크의 자율학습이 효과적으로 수행된다. 특히 앞의
단계에 있는 셀들의 성장이 안정될 때까지 일시적으로 약하고 분산된 연결의 발생
기간을 연기하는 것은 바람직하다.
앞에서 논의된 바와 같이 자율학습의 경우에 최대 출력 셀이 시드셀로서 자동적으로 선택된다. 그러나 지도학습의 경우에는 지도자 (teacher) 가 각 훈련패턴에 대하여 어느 셀이 시드셀이 될 것인지를 지정한다. 학습의 다른 과정은 자율학습 과정과 동일하다. 물론 모든 연결강도를 하나 하나씩 계산하고 조정하는 복잡한 과정을 수행할 필요는 없고, 어떤 셀들에 의하여 추출되어질 패턴이나 특징들을 지적해주는 것만으로 충분하다.
하나의 예로 모양의 유사성과 관습에 근거를 두고 손으로 쓴 글자들을 인식하는 훈련 시스템을 우리가 원한다면, 지도학습이 유용하다. 예를 들며 'O' 와 'O' 의 기하학적 유사성이 'O' 와 'Q' 의 기하학적 유사성과 비슷하지만, 'O' 와 'Q' 는 다른 범주로 분류되어야만 하는 반면에 'O' 와 'O' 는 반드시 같은 글자로 인식되어야만 한다. 그러나 자율학습의 경우 기하학적 유사성을 근간으로 분류하므로 자율학습에 의해서만 이와같은 글자들은 인식하도록 시스템을 훈련시키는 것은 매우 어렵다.
네오코그니트론의 능력을 보여주기 위하여 '0' 에서 '9' 까지의 손으로 쓴 숫자를 인식하는 시스템 [FUK83] 이 설계되었다. 이전의 시스템을 변형한 이 시스템은 하나의 배열 (array) 프로세서(FPS-5105)를 가진 마이크로 컴퓨터 (micro VAX-II) 에 구현되었으며, 똑같은 시스템이 16비트 메인 (main) 프로세서 8086 (384 Kbytes 메모리) 과 코프로세서 (coprocessor) 를 가진 컴퓨터 (NEC PC-9801) 에서 구현되었다 [FUK87a]. 시스템은 지도학습에 의하여 훈련되었는데, 자율학습을 적용한 실험 결과는 [FUK80, FUK82] 에서 보고되었다.
네트워크는 S 셀과 C 셀 층의 4 단계를 가지고 있으며, 각 층에 있는 다수의 S 셀들과 C 셀들의 연결 관계를 <그림 4> 에 나타내었다. 가장 높은 단계에서 UC4 층은 10개의 셀 평면을 가지고 있고, 각 셀 평면은 한개의 C 셀을 가지고 있다. 이러한 10 개의 셀들이 '0' 에서 '9' 까지의 열개의 숫자에 대응한다.
<그림 9> 는 다른 셀 평면에 있는 셀들이 공간적으로 어떻게 연결되어 잇는지를 보여준다. 각 층에 대하여 단지 하나의 셀 평면만이 그려진 이 그림은 S 셀들과 C 셀들 사이에 연결된 1차원 단면 (cross-section) 을 예시하고 있다. 이 그림으로부터 예를 들면, Us3 층에 있는 하나의 S 셀은 UC2 층의 각 셀 평면으로부터 5 × 5 크기의 자극적이며 가변적인 입력 연결을 가진다는 것을 알 수 있다. UC2 층이 19 개의 셀 평면을 가지므로, US3 층에 있는 각 S 셀로 연결된 가변적 입력 연결의 최대 수는 5 × 5 × 19 이다. 그러나 이러한 5 × 5 × 19 개의 모든 가변적 연결이 모두 학습에 의하여 강화될 필요가 없다는 것을 주의하는 것이 중요하다. 반면에 그러한 연결 중의 대부분이 학습이 끝난 후 조차도 강도 0 의 상태를 유지하고 있다. 강도 0 의 가변적 연결은 실질적으로 네트워크에서 존재할 (wired) 필요가 없기 때문에, 효과적인 연결의 수는 직접 그림으로부터 알 수 있는 값보다 훨씬 적다.
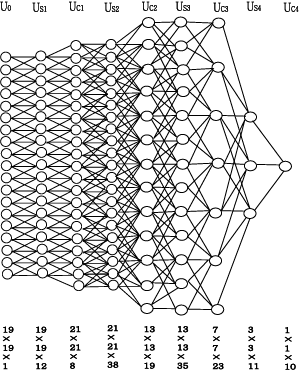
<그림
9> 다른 셀 평면들의 셀들간 상호연결들의 1차원적 관점.
각
층에 단지 하나의 셀 평면만이 그려져 있다.
네트워크에 있는 각 셀의 출력이 수학적으로 (식 1) 과 같이 묘사된다. 다음의 방정식에서 usl(n,k) 은 l 번째 단계에 있는 하나의 S 셀 출력을 나타내는 데 사용한다. 여기에서 n 은 입력층 U0 내 셀의 수신부 중심의 위치를 지시하는 좌표의 이차원 집합이며, k 는 셀평면의 순차적 번호 (serial number) 이다. S 들에 대하여 k 는 1 ≤ k ≤ Ksl 의 범위에 있으며, C 셀들에 대하여 k 는 1 ≤ k ≤ Kcl 의 범위에 있다. 하나의 S 셀의 출력은 (식 1) 에 의하여 주어진다.
usl(n,k)
=  (식 1)
여기에서,
|
φ[x] = |
|
x, if x ≥ 0 0, if x < 0 (식 2) |
(식 1) 에서 l = 1인 경우에, ucl-1(n,k) 은 u0(n) 또는 입력층의 수신자 셀의 출력을 나타내고, Kcl-1 = 1 을 가진다. 파라메터 σl 은 S 셀의 입력과 출력 특성에서 포화 (saturation) 가 시작되는 레벨을 결정하는 양의 상수이다.
al(ν, κ, k) ( ≥ 0) 는 앞 층에 있는 C 셀 ucl-1(n+ ν, κ) 로부터 들어오는 가변적이고 자극성 연결의 강도이고, Al 은 ν 범위의 합, 즉 하나의 S셀로 입력 되는 입력 연결의 공간적 분포의 크기를 표시한다. bl(k) ( ≥ 0) 은 보조적인 V셀 uvl(n) 로부터 들어오는 가변적인 억제성 연결의 강도이다. 앞의 <그림 5> 에서 연결을 논의한 바에 따라 하나의 셀 평면에 있는 모든 S셀들은 입력 연결의 동일한 집합을 가진다. 그러므로 al(ν, κ, k) 과 bl(k) 는 usl(n, k) 셀의 감응적 분야 위치를 나타내는 변수 n 을 포함하지 않는다. (식 1) 에서 볼 수 있듯이 셀에 억제성 입력이 분지 (shunting) 태도로 행한다. 양의 상수 rl 은 셀에 억제성 입력의 효율을 결정한다.
S 셀로 억제성 신호를 보내는 보조적인 V 셀은 전의 C 셀로부터 신호의 가중 평균 제곱근 (weighted root-mean-square) 과 같은 출력을 산출한다. 즉,
 (식 3)
여기에서 cl(ν) 는 고정된 자극적 연결 강도를 나타내고, 다음 (식 4) 를 만족하는 |ν| 에 대한 단조 감소 함수이다.
 (식
4)
특징 추출에서 평균 제곱근 셀의 역할이 [FUK81, FUK82]에서 논의되었다. 가변적인 연결 al(ν, κ, k) 과 bl(k) 는 지도자가 지적한 시드셀로 입력되는 입력의 강도에 따라서 강화된다. usl(n, k) 이 어떤 시간에 시드셀로 선택되었다고 하자. 이 시드셀로 연결된 가변적인 연결 al(ν, κ, k) 과 bl(k) 결과적으로 시드셀과 동일한 셀 평면에 있는 모든 S 셀로의 연결들로부터 다음의 양에 의하여 강화된다.
△al(ν,
κ,  ) = qlcl(v)ucl-1(
 + ν, κ) (식
5)
△bl( ) = qluvl(
 ) (식
6)
여기에서 ql 은 강호화
속도를 결정하는 양의 상수이다. 지도학습에 있어서, ql 은 각 시드셀로
입력되는 연결의 강화가 훈련패턴 연출의 2 ~ 3 단계에서 완성될 수 있도록 충분히
큰 값이 ql 로 주어진다.
위치 오류를 허용하기 위하여
네트워크에 삽입되어 있는 C 셀에 있어서, 그 출력은 다음과 같이 주어진다.
 (식 7)
여기에서 ψ[x] 는 C 셀의 포화특성을 설명하는 함수로서 다음과 같이 정의된다.
 (식
8)
지도학습에 의하여 훈련되는 네트워크에서 S 셀 평면의 많은 출력들이 때때로 하나의 C 셀 평면으로 함께 수렴한다. 뒤에서 논의될 이러한 수렴조건이 jl(κ, k) 에 의하여 표현된다. 변수 dl(ν) 는 고정된 자극적 연결의 강도를 나타내며, |ν| 에 관한 단조 감소함수이다. 따라서 만약 jl(κ, k) > 0 이고 적어도 하나의 S셀이 이러한 연결들이 전개되어 있는 κ 번째 셀 평면의 영역 Dl 안에서 활성화된다면, 이 C 셀이 활성화된다.
이제 jl(κ, k) 을 보다 자세하게 논의해보자. 문자 인식의 경우에 있어서 다른 서체의 문자들까지도 정확하게 인식되어야 한다. 바꾸어 말하면, 입력 글자들은 기하학적 유사성을 기본으로 할 뿐만 아니라 글을 쓴 사람에 따라 상당한 일그러짐을 허용하는 기본 위에서 분류되어야 한다. 때때로 그러한 일그러짐이 너무 클 때, 단 하나의 S 셀 평면이 특징의 일그러진 형태를 추출하기에 충분하지 않다. 그러한 경우에 다른 S 셀 평면이 특징의 일그러진 형태를 추출하는 데 사용되고, 이들의 S 셀 평면으로부터의 출력이 하나의 C 셀 평면으로 수렴한다. 이러한 연결 과정을 나타내는 것이 (식 7) 에 있는 jl(κ, k) 이다. k 번째 C 셀 평면이 κ 번째 S 셀 평면으로부터 신호를 받는지, 못 받는지에 따라서 jl(κ,k) 는 각각 양수값 또는 0 을 가진다. 따라서 각 κ 에 대하여 jl(κ,k) 는 k 에 대하여 하나의 특별한 값을 제외하고는 보편적으로 0 을 가진다.
네트워크를 훈련시키기 위하여 지도자는
훈련패턴을 제시하고 각 훈련패턴에 대하여 어느 셀이 시드셀이 될 것인지를 지적한다.
다른 학습에 대한 과정은 자동적으로 계속된다.
훈련은 낮은 단계에서부터
높은 단계로 단계적으로 수행된다. 바꾸어 말하면 보다 높은 단계의 훈련은 앞 단계에서의
훈련이 완전히 끝나고 난 후 수행된다. 다음의 예에서 네트워크는 손으로 쓴 '0'
에서
'9' 까지의 숫자를 인식하도록 훈련된다.
(1) US1 층의 훈련
US1
층은 다른 방위의 선 (line) 요소들을 추출하도록 훈련되어 진다. <그림 10>
은
US1 층의 12 개의 셀 평면들을 훈련시키기 위하여 사용된 12
개의 훈련패턴을
나타낸다. 각각의 훈련패턴은 오직 한번씩만 네트워크에게 소개되어진다. 훈련되어질
셀 평면의 중앙에서 셀이 항상 시드셀로서 임명되어 진다. <그림 9> 에서
볼 수 있는 바와 같이, 이 층의 각 셀은 크기에 있어서 3 × 3 의 감응적 부분을 가진다.
그러므로 각 훈련패턴의 단지 중앙의 3 × 3 영역만 훈련에 대하여 효과적이며, 단지
이 중심 영역만이 <그림 10> 에 보여진다.
S 셀들의 감응적
부분의 크기가 3 × 3 로 작기 때문에 선이 1 : 2 의 기울어짐을 가질 때 단지 하나의
셀 평면에 의하여 선의 모든 부분을 추출하는 것은 어렵다. 그러므로 2 개의 셀 평면이
그와 같이 기울어진 선 요소를 추출하는데에 사용되며, 2 개의 S 셀 평면으로부터의
출력이 함께 연결되고 단 하나의 C 셀 평면으로 수렴한다. <그림 10> 에서
훈련패턴의 왼쪽에 그려진 구부러진 모양의 선 (hooked line) 은 S 셀 평면에 상응하는
출력들이 어떻게 함께 연결되는 지를 보여준다.
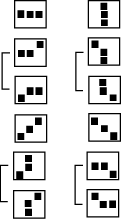
<그림 10> US1 층의 12 개 셀평면을 훈련시키는데 사용된 훈련 패턴들
구부러진 모양의 선은 S 셀 평면들에 상응하는 출력들이 함께 결합되고, UC1 에서 단 하나의 C 셀 평면으로 수렴하는 것을 보여준다. 중앙 3 × 3 영역 외부는 US1 층의 훈련에 대하여 효과적이지 않기 때문에 각 훈련 패턴의 단지 중앙 3 × 3 영역만이 보여져 있다.
(2) US2 층에서의 훈련
<그림 11> 은 US2 층의 38 개의 셀 평면을 훈련시키는데 사용된 훈련패턴을 나타내고, 크기에 있어서 9 × 9 의 감응적 분야를 가지기 때문에 여기서는 훈련패턴의 단지 중앙 9 × 9 영역만이 보여진다. 다시 훈련되어질 셀 평면의 중앙에서 셀이 시드셀로서 임명되어 진다.
때때로 단 하나의 셀 평면이 하나 이상의 훈련패턴으로 훈련되어 진다. 이것은 일그러진 특징들을 추출하는 S 셀의 능력을 증가시키는 데 효과적이다. <그림 11> 에서 수평선으로 배열되어 있는 패턴들의 그룹은 훈련패턴의 그러한 집합을 나타낸다. US1 층에서와 유사하게 여러 S 셀 평면들의 출력이 <그림 11> 에서 구부러진 모양의 선들로 지시되어진 바와 같이 서로 연결된다. <그림 11> 에 보여진 바와 같이 각 훈련패턴은 패턴인식의 과정 동안에 나타나게 될 숫자패턴의 일부분으로 구성되어 있다. 바꾸어 말하면, 일그러진 패턴의 전형적인 예들이 훈련패턴들로 네트워크에게 제시된다.
일반적으로 훈련패턴의 좋은 선택이 모든 층들 가운데 US2 층에 대하여 가장 중요하다. 만약 US2 층에 대한 훈련패턴이 적당하게 선택되었다면, 다른 층들에 대한 훈련패턴들의 선택이 완성되지 않았다 할지라도 보편적으로 네트워크가 패턴인식에 대하여 상당히 높은 인식 능력을 획득한다.
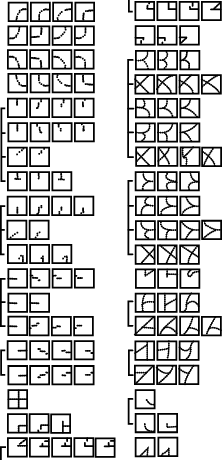
<그림 11> US2 층의 38 개 셀 평면을 훈련시키는데 사용된 훈련 패턴들
(3) US3 층의 훈련
<그림 12> 는 US3 층의 35 개 셀 평면을 훈련시키는데 사용되는 훈련패턴들을 보이고 있다. 이 층에서 S 셀의 감응적 부분이 입력층 U0 보다 크기 때문에 셀 평면의 중앙에 있는 셀이 항상 시드셀로 임명되어지지 않는다. 그때 시드셀의 위치 (즉, 시드셀의 감응적 부분의 중심) 가 <그림 12> 에서는 보여진 각 훈련패턴내의 교차점 (cross) 에 의하여 표시된다.
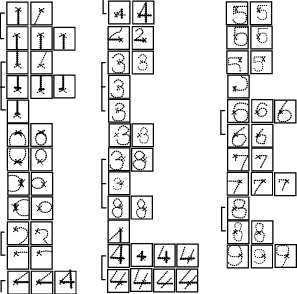
<그림
12> US3 층의 35 개의 셀평면들을 훈련시키기 위하여 사용된 훈련
패턴들.
시드셀의
감응적 부분의 중앙이 그림에서 'X' 로 표시되어 있다.
(4) US4 층의 훈련
<그림 13> 은 US4 층의 11개 셀 평면을 훈련시키는데 사용되는 훈련패턴들을 보여준다. US1, US2 층에서와 유사하게 각 셀 평면의 중앙에 있는 셀이 시드셀로 임명된다.
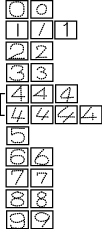
<그림
13> US4 층의 11개의 셀 평면들을 훈련시키기 위하여
사용된 훈련 패턴들
오직 하나의 셀 평면으로 '4' 와 '4' 를 인식하는 것은 어렵기 때문에 두개의 셀 평면이 사용된다. 그러나, 다른 숫자들에 대해서는 다른 문체로 쓰여진 패턴의 일그러진 각색까지도 단 하나의 셀 평면이 인식하기에 충분하다. 예를 들면 '9' 와 '9' 는 하나의 동일한 셀 평면에 의하여 정확하게 인식된다. 이것은 입력패턴의 모양에 있어서 대부분의 왜곡이 앞 단계에서의 과정 동안에 이미 흡수되었기 때문이다.
이제 학습을 끝낸 네트워크의 반응을 시험해 보자. 이 실험에서 입력패턴은 테블렛 (tablet) 에 그려진다. 테블렛이 손으로 쓰는 숫자의 입력장치로 사용되었지만 시스템은 그 글자의 자획 순서에 대한 어떠한 정보도 이용하지 않으며, 이미 쓰여진 글자를 네트워크에 대한 입력패턴으로 사용할 수 있다. C 셀 층의 반응이 컴퓨터에서 계산의 진전에 따라서 그래픽 터미널에 연속적으로 나타난다.
<그림 14> [FUK89] 는 이러한 과정의 한예를 나타낸다. 입력층 U0 에 숫자 '2' 가 제시되었고, 가장 높은 층, 가장 오른쪽에 보여진 UC4 에 단지 셀 '2' 가 활성화됨으로써 네오코그니트론이 입력패턴을 정확하게 인식하는 것을 보여준다.
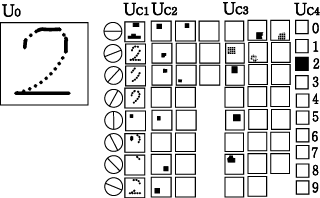
<그림 14> 손으로 쓴 숫자를 인식하도록 훈련된 네트워크에서 C 셀들의 반응 예
<그림 15> [FUK89] 는 네오코그니트론이 정확하게 인식하는 일그러진 입력 패턴에 대한 몇가지 예를 나타내고 있다. 입력패턴이 다른 위치에서 제시되었을 때, 중간층에 있는 셀의 반응, 특히 입력층에 가까이 있는 층의 셀들의 반응이 이동에 대하여 변한다. 그러나 보다 높은 층일수록 반응에 있어서 보다 작은 변화를 가진다. 가장 높은 층에 있는 셀들은 입력패턴의 위치에 따른 이동에 전혀 영향을 받지 않는다.
입력패턴이 커지거나 작아지거나 또는 비스듬한 모양을 한 경우에도 영향을 받지 않는다는 것이 보여졌다. 때때로 입력패턴이 너무 많이 왜곡되었을 때에는 가장 높은 층에서 셀의 반응이 약하지만 여전히 정확한 셀로부터 반응이 유도된다. 비록 입력패턴이 일부분 상실되거나 잡음에 의하여 손상되었을 때에도 네오코그니트론은 정확하게 입력패턴을 인식한다.
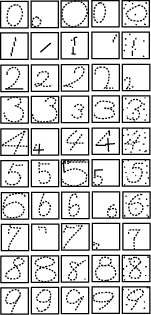
<그림 15> 네오코그니트론이 정확하게 인식한 왜곡된 입력 패턴의 몇가지 예
네오코그니트론은 대부분의 기존 컴퓨터와 패턴인식기가 가질 수 없는 많은 뚜렷한 성질들을 가지고 있다. 네오코그니트론은 많은 셀들로 이루어진 층들이 여러개 모여 구성된 계층적 네트워크이며, 이웃하는 층에 있는 셀들 사이에 다양한 연결을 가지고 있다. 이는 학습에 의하여 패턴을 인식할 수 있는 능력을 획득할 수 있으며, 아라비아 숫자뿐만 아니라 알파벳 문자나 기하학적 패턴, 또는 다른 어떤 패턴들의 집합까지 인식할 수 있도록 훈련될 수 있다. 학습과정이 끝난 후, 패턴 인식은 패턴들 사이의 모양에 있어서 유사성에 근간을 두고 수행되며, 입력 패턴들에 있어서 패턴의 일그러짐이나 크기의 변화, 위치의 이동에 크게 영향을 받지 않는다.
네오코그니트론의 계층적 네트워크에 있어서, 입력패턴의 국부적인 특징들 (local features) 은 낮은 단계 (lower stage) 에 있는 셀들에 의하여 추출되고 이 특징들은 점점 전체적인 특징 (global features) 으로 집중되어 진다. 가장 높은 단계 (the highest stage) 에 있는 각 셀은 입력패턴에 대한 모든 정보를 집중하고 하나의 특정한 패턴으로 반응한다. 그리하여 가장 높은 단계에 있는 셀들의 반응은 네트워크에 있어서의 패턴인식의 최종 결과를 나타낸다. 특징들을 추출하고 모으는 과정 동안 국부적인 특징들의 상대적 위치에 따른 오류 (error) 가 점진적으로 허용된다. 각 단계에서 한번에 조금씩 위치 오류(positional error) 를 허용하는 동작 과정은 한 단계 (one step) 에서 모든 오류를 허용하는 것보다 왜곡된 패턴들을 인식할 수 있는 능력면에서 훨씬 좋은 결과를 가져온다.
만일 인식되어야 할 패턴의 범주가 증가하면 네트워크의 각 층에 있는 셀 평면의 수도 또한 증가해야 한다. 그러나 셀 평면의 수는 패턴의 범주 수에 비례하여 증가할 필요는 없다. 셀 평면의 수는 낮은 단계에서 추출되어질 국부적인 특징들이 다른 범주들의 패턴에 공통으로 포함되어 있기 때문에 선형적 증가보다 적게 증가되는 것으로 충분하다. 이러한 시스템은 미니컴퓨터에서 구현되었으며, 손으로 쓴 아라비아 숫자를 인식하기 위하여 훈련되었다.
앞에서 네오코그니트론은 단지 전방향적 (forward) 인 연결만을 가지지만, 만약 후방향적 (backward) 인 연결이 더해지면 네트워크의 정보처리 능력은 매우 증가할 수 있다. 후쿠시마가 제안한 선택적 주의 (Selective attention) 모델 [FUK86, FUK87b] 이 이와같은 시스템의 예이다.
두개 이상의 패턴으로 이루어진 복잡한 그림이 패턴인식 시스템에 제시되었을 때 그것은 각각의 패턴으로 분할되고 각 패턴에 대해 따로 인식되어야 한다. 이를 위한 기존의 분할 (segmentation) 방법은 많은 잡음이 섞여 있거나 패턴의 일부가 손실되어 분리된 경우에는 적용하기가 매우 어렵다. 선택적 주의 방법이란 몇개의 패턴으로 이루어진 복잡한 그림으로부터 한번에 한 패턴씩을 선택하여 차례로 인식하는 것을 말한다.
후쿠시마가 제안한 이 선택적 주의 모델은 <그림 16> [FUK89] 과 같이 계층적 다층 네트워크로 이루어져 있는데, 이웃하는 세포들 사이에 구심성 (afferent) 연결과 원심성 (efferent) 연결을 가진다.
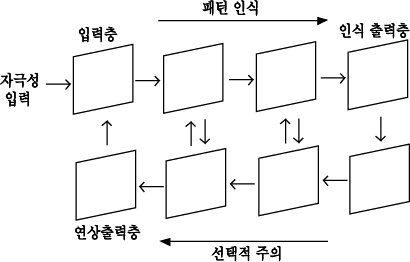
<그림 16> 선택적 주의 모델의 구조
이 모델에서 선택적 주의를 수행하는 과정은 다음과 같다. 2 개 이상의 패턴으로 이루어진 자극이 입력층에 제시되면, 주어진 자극에 대한 정보가 구심성 연결을 통해 모든 셀 (cell) 층에 전달되고, 가장 높은 단계인 인식 계층에서 가장 강하게 영향을 받는 영지 (gnostic) 의 셀들 중 하나가 활성화되어 하나의 패턴을 인식하게 된다. 그리고 이 패턴과 관련된 구심성 패스들만이 영지 셀로 부터의 원심성 신호 활동에 의해 촉진되고, 다른 패턴과 관련된 구심성 신호들은 촉진 (facilitation) 을 받지 못함으로 인하여 약화된다. 구심성 신호의 흐름에 의해 인도되는 이러한 원심성 신호들은 가장 낮은 단계인 입력층에 도달되고, 오직 이 패턴의 구성 요소들만이 촉진된다. 이는 자극내의 패턴들 중에서 오직 하나에만 선택적으로 주의가 집중되어 이 패턴이 네트워크에 의해 연상 (recall) 됨을 의미한다.
네트워크의 반응이 자극내의 패턴들 중 하나에 주의가 집중된 안정된 상태에 도달하였다면, 원심성 신호의 흐름에 순간적인 인터럽트 (interruption) 가 발생하여 인식된 패턴의 원심성 신호의 흐름을 약화시킴으로써 선택적 전환을 시도한다. 자극들 속에서 다른 패턴들에 관한 정보가 구심성 경로들을 통하여 더 쉽게 흘러가고 다른 영지 셀이 활성화된다. 결론적으로, 새로운 패턴에 대한 구심성 경로들이 새롭게 활성화된 영지 세포의 원심성 신호들에 의해 촉진된다. 이러한 일련의 과정을 통하여 자극내의 패턴들 각각에 대해 주의가 전환되며 한번에 하나씩 인식한다. 이 모델은 주의된 패턴이 일부 손실되어 있더라도 손실된 부분에 대한 복원을 시도하여 손실된 정도가 적은 경우에는 완전한 패턴이 상기되도록 하며, 자극내의 잡음에 대해서는 주의를 주지 않음으로써 그 의미를 감소시키는 특징을 가지고 있다.
지금까지는 숫자 (numeral) 을 인식하는 네오코그니트론의 응용에 관하여 기술하였다. 최근들어 숫자를 포함한 영문자 (alphanumeric) [FUK91a] 나 한자 [FUK91b] 에 관한 응용에 대해서 연구 실험되고 있다.
우리나라에서는 네오코그니트론을 이용한 한글 문자인식에 대한 연구가 진행되고 있는데 그 중에서 두 가지만 간략히 소개하기로 한다. 그 중의 한 모델인 한글 문자인식 시스템 [김91] 은 네오코그니트론의 기본 원리를 이용하였으며 각 한글 형태에 대응하는 6 개의 신경망으로 구성되어 있는데, 한글인식에 적합하도록 특징 추출 세포의 기능을 변경하였다. 인식 실험에서는 전처리를 거친 인쇄체 한글 문자를 사용하여 96.7 % 의 인식률을 얻었다.
한편 네오코그니트론을 이용하여 필기체 한글 음절인식을 위한 신경망도 연구되고 있다 [이92]. 이 모델에서는 자음 30 자, 모음 21 자 각각과 합친 자모 51 자의 인식을 실험하였는데, 각각에 대한 인식률은 모음인 경우는 92.8 %, 자음인 경우에는 85.4 % 였다. 이 모델에서 단순 자모로 이루어진 문자들에 대한 인식률은 어느정도 만족할 만한 수준이나 한 문자당 인식시간이 오래 걸리므로(MIPS 워크스테이션에서 20 분 정도) 실시간 인식을 위해서는 칩에 의한 구현이 요구되고 있다.
이 장에서는 시각적인 패턴의 인식을 위한 '코그니트론' 과 '네오코그니트론' 모델들에 관하여 살펴보았다. '코그니트론' 모델은 1975 년 일본의 후쿠시마에 의해 개발되었고, '네오코그니트론' 모델은 1982 년 후쿠시마와 그의 동료들에 의해 코그니트론을 개선함으로써 만들어진 모델이다.
1 절에서는 머리말을,
2 절에서는 코그니트론에 관하여 고찰하였으며,
코그니트론과 네오코그니트론의 유사점 및 상이점은 3
절에서 살펴 보았다.
4 절에서는 네오코그니트론의
기본적인 구조와 동작을 살펴보았다. 네오코그니트론의 계층적 네트워크의 구조가
설명되었으며 하나의 S 셀에서 입력과 출력의 특성이 언급되었다. 네오코그니트론에서의
패턴인식 과정을 예제를 통하여 고찰하였다.
5
절에서는 네트워크의 자기조직화가 논의되었다. 자율학습과 최대 출력셀들의 강화와
관련된 원리가 기술되었으며, 자율학습과 반복적인 연결의 발전도 기술되었다. 6
절에서는 숫자들을 인식할 때 지도학습에 관한 필요성이 간략히 기술되었다.
7
절에서는 네오코그니트론을 이용하여 '0' 에서 '9' 까지의 필기체 숫자를 인식하는
시스템에 관하여 살펴보았다. 이 시스템은 지도학습에 의하여 훈련되었는데 마이크로
벡스 (micro VAX-II) 에서 구현되었다. 네트워크의 자세한 구조와 각 층에서의 훈련
과정, 네트워크의 반응이 기술되었으며 구체적인 예들이 제시되었다.
8
절에서는 네오코그니트론 모델의 특징 등을 총괄적인 견지에서 고찰하였으며, 9
절에서는 선택적 주의 모델에 관해 간단하게 고찰하였고, 10
절에서는 네오코그니트론의 한글 문자에의 응용을 기술하였다.
◈ 생각할 점 ◈
1. 고양이의 시각 시스템을 응용하여 고안된 것으로 알려진 네오코그니트론은 숫자 등의 패턴인식에 매우 유용한 모델로 알려져 있다. 그러나 구현의 복잡성 등의 단점을 아울러 가지고 있다. 그 중에서 결정적인 단점이나 문제점들은 무엇인가?
2. 네오코그니트론의 학습 방법에는 자율학습과 지도학습이 있다. 어떤 경우에 지도학습이 더 유용한가?
3. 네오코그니트론은 지금까지 언급된 다른 신경망 모델들과는 매우 다른 독특한 구조를 가지고 있다. 어떤 면에서 독특한 지를 설명하고, S 셀, C 셀, V 셀의 역할은 각각 무엇인가?
4. 코그니트론과 네오코그니트론의 근본적인 차이점은 무엇이며, 공통점들은 무엇인가?
