1 언덕 오르기 탐색(Hill Climbing)이란 무엇인가?
"짙은 안개 속에서 산 정상을 오르는 사람" — 현재 위치의 발밑만을 살피며 올라가는 지역 탐색의 기본형
인간이 낯선 영역에서 문제를 풀 때 가장 보편적으로 사용하는 전략 중 하나는 "현재 상태와 목표 상태 사이의 격차(차이)를 줄여나가는 것"입니다. 인지심리학의 거두 존 R. 앤더슨(John R. Anderson)은 이를 차이 감소법 (Difference Reduction)이라 명명하였으며, 컴퓨터 과학과 인공지능에서는 이를 언덕 오르기 (Hill Climbing)라고 부릅니다.
🏔️ 안개 속 등산가의 비유
한 등산가가 짙은 안개가 자욱하게 낀 한밤중에 지형도나 나침반 없이 가장 높은 산 정상에 도달하려 합니다. 안개 때문에 멀리 내다볼 수는 없지만, 자신의 발밑 주변 360도를 더듬어보고 현재 디디고 있는 자리보다 고도가 조금이라도 더 높은 방향으로 한 걸음씩 내딛는 행동을 반복합니다. 주변에 더 이상 높은 발판이 없으면 그곳을 산 정상이라 판단하고 멈춥니다. 이것이 바로 언덕 오르기 탐색의 본질입니다.
⚡ 막강한 장점: 극도의 공간 효율성 O(1)
BFS나 A* 알고리즘처럼 수천만 개의 방문 노드와 프론티어를 메모리 트리에 보관할 필요가 전혀 없습니다. 오직 "현재 상태(Current State)"와 "인접한 이웃 상태(Neighbor State)" 하나만을 기억하므로 메모리 공간 복잡도가 O(1)로 극도로 가볍습니다. 거대한 최적화 문제에서 메모리 부족으로 멈추지 않는 유일한 대안이 됩니다.
⚠️ 치명적 단점: 근시안적 탐욕성 (Greedy Myopia)
오직 바로 다음 단계의 향상 여부만을 따지므로, 더 높은 산 정상을 향해 가기 위해 잠시 낮은 골짜기를 내려갔다가 올라가야 하는 전략적 후퇴(장기적 계획)를 결코 허용하지 않습니다. 따라서 전체 지형에서 가장 높은 전역 정상(Global Maximum)이 아닌 엉뚱한 동네 야산의 봉우리(Local Maximum)에 갇히게 됩니다.
2 언덕 오르기의 3대 지형적 함정과 시각적 다이어그램
상태 공간 지형(State Space Landscape)에서 언덕 오르기가 실패하는 구조적 원인
🗺️ 상태 공간 목적 함수 지형도 (State Space Landscape)
[도해] 왼쪽에서 출발한 탐색기는 인접 이웃보다 높은 지역 최대점(Local Max)에 도달하면 탐색을 조기 종료해 전역 최적해에 도달하지 못함
주변의 모든 인접 상태들보다 고도가 높지만, 전체 지형에서 가장 높은 전역 정상(Global Maximum)보다는 낮은 봉우리입니다. 언덕 오르기는 인접 노드가 모두 자신보다 낮다는 이유로 "여기가 정상이다"라고 잘못 판정하고 정지해 버립니다.
인접한 모든 이웃 상태들의 평가 함수 값이 현재 위치와 완전히 동일한 평평한 지형입니다. 경사도가 0(Slope = 0)이므로 알고리즘은 어느 방향으로 전진해야 정상이 나오는지 알 수 없어 방향 감각을 잃고 목적 없는 무작위 방황(Random Walk)에 빠집니다.
두 경사면이 맞닿아 생긴 좁고 가파른 능선 지형입니다. 능선의 꼭대기는 정상을 향해 완만하게 올라가고 있으나, 한 번에 한 축의 파라미터만 바꾸는 이웃 연산자로는 동서남북 어느 쪽을 보아도 낭떠러지만 보여 전진하지 못하고 좌우로 진동(Oscillation)하다 정지합니다.
3 고전 AI 연구 석학들의 분석과 원문 자료 보존
John R. Anderson 교수의 차이 감소법과 Nils J. Nilsson 교수의 함수 최적화 지형론
👤 존 R. 앤더슨 (John R. Anderson, 1995) : 인간 문제해결과 차이 감소법
인간은 문제해결 (Problem Solving)을 할 때 현재 상태와 목표 상태의 차이를 줄여서 접근하는 차이 감소법(Difference Reduction)과 유사성(Nearest Neighbor)에 의해 강력한 영향을 받습니다.
"만일 목표가 땅에서 가장 높은 지점이라고 상상할 때, 거기에 도달하는 방법은 항상 위로 올라가는 단계를 밟는 것이다. 차이 감소를 때로는 언덕 오르기 (Hill Climbing)라고 부른다. 그러나 언덕 오르기는 가장 높은 전역 정상보다 낮은 어떤 언덕의 꼭대기(Local Maxima)에 도달하게 될지도 모른다는 잠재적 위험을 갖는다. 그것은 다음 단계의 향상 여부만을 고려하고 더 큰 계획의 달성 여부는 고려하지 않는 근시안적 방법이다. 수단목표 분석 (Means Ends Analysis)은 이러한 한계를 넘어 더 총체적인 시각을 문제 해결에 도입하려는 시도이다."
👤 닐스 J. 닐슨 (Nils J. Nilsson, 1998) : 함수 최적화와 공간 지형
"어떤 문제는 명시적인 목표 조건 대신에 자료 구조에 대한 목적 함수 v(s)  가 있고, 이 함수가 최대(혹은 최소)가 되는 자료 구조를 찾고자 한다. 하나의 자료 구조를 공간에 있는 하나의 점이라고 생각하면, 이 함수는 이 공간상의 지형(Landscape)이라고 할 수 있다. 공간을 돌아다니는 기법 가운데 언덕 오르기(Hill Climbing) 방법은 한 점에서 고도가 가장 높은 인접한 점으로 이동하면서 다니는 것이다. 현재 점보다 높은 고도를 가진 인접한 점이 없으면 종료되므로 지역 최대값에 걸릴 수 있다."
📷 원본 보존 도해: 언덕 오르기 기본 원리
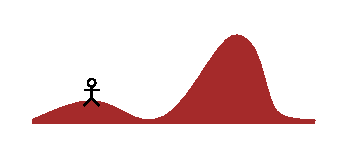
[그림] 고전 인공지능 아카이브에 수록된 언덕 오르기 개념 시각 자료 (hill.gif)
4 언덕 오르기의 변형 기법: 한계를 극복하는 실전 알고리즘
무작위 재시작(Random-Restart), 최초 향상, 모의 담금질(Simulated Annealing)로의 진화
"실패하면 다른 곳에서 다시 시작하라!"라는 가장 강력한 실전 전략입니다. 하나의 초기점에서 지역 최적해에 갇히면, 상태 공간의 완전히 다른 임의의 위치(Random Initial State)에서 새로이 언덕 오르기를 수행합니다.
수학적으로 충분한 횟수(k번)를 반복하면 전역 최적해에 도달할 확률이 1에 수렴하여 완전성(Completeness)을 확보할 수 있습니다.
• 확률적 언덕 오르기: 최고의 이웃 노드 하나만 고집하지 않고, 개선을 가져오는 여러 이웃 중 개선량의 크기에 비례하는 확률로 무작위 선택합니다.
• 최초 향상 언덕 오르기: 모든 이웃을 전부 계산하느라 시간을 허비하지 않고, 무작위로 생성한 첫 번째 개선 노드가 발견되는 즉시 바로 이동합니다. 이웃이 수만 개에 달할 때 연산 속도를 극대화합니다.
언덕 오르기가 지역 최적해에 갇히는 근본 원인은 "나쁜 방향(내리막길)으로의 이동을 절대 허용하지 않기 때문"입니다.
금속 공학의 풀림(Annealing) 원리를 빌려와, 초반에는 높은 온도(T)에서 확률적으로 언덕 아래로 내려가는 이동을 허용함으로써 지역 최대점을 탈출하고 점차 온도를 낮추며 전역 최적해로 수렴합니다.
단 하나의 탐색자 대신, 여러 개의 탐색자(개체군)를 동시에 유지하는 지역 빔 탐색(Local Beam Search)이나 유전자 교차(Crossover) 및 돌연변이(Mutation)를 결합하여 지형의 넓은 영역을 병렬적으로 탐색합니다.
정보를 공유하며 더 나은 봉우리가 발견되면 다른 탐색자들도 그쪽으로 집중하여 전역 최적해 도달률을 높입니다.
5 전통적 AI에서의 대표적 활용 분야
제약 조건 만족 문제(CSP), 외판원 순회(TSP), VLSI 반도체 칩 배치 및 기계학습 최적화
N개의 퀸이 서로를 공격하지 못하도록 N×N 체스판에 배치하는 제약 만족 문제(CSP)의 교과서적인 해결책입니다.
목적 함수 h(s): 서로를 공격하는 퀸의 쌍 수(충돌 수). 언덕 오르기는 각 열의 퀸을 한 칸씩 움직여 충돌 수가 가장 적어지는 방향으로 이동합니다. 무작위 재시작 언덕 오르기를 사용하면 수백만 개의 퀸을 배치하는 대형 문제도 수 초 만에 충돌 0(목표 달성)을 찾아냅니다.
여러 도시를 모두 거쳐 시작점으로 돌아오는 최단 순회 경로를 찾는 NP-Hard 최적화 문제입니다.
경로의 두 간선을 서로 교차 교환하는 2-Opt 이웃 연산자를 정의하고, 교환 후 총 이동 거리가 짧아질 때만 경로를 갱신하는 언덕 오르기 기법을 통해 물류 및 배송 최적화에서 초고속 근사 최적 경로를 산출합니다.
수십억 개의 트랜지스터와 전자 소자를 실리콘 웨이퍼 위에 배치할 때 배선 길이와 발열을 최소화해야 합니다.
부품들의 위치를 조금씩 바꾸며 전체 배선 길이와 전력 소모 목적 함수를 최소화하는 지역 언덕 오르기 탐색이 반도체 전자설계자동화(EDA) 소프트웨어의 핵심 엔진으로 활용됩니다.
딥러닝에서 모델 가중치를 학습시키는 경사 하강법(Gradient Descent)은 본질적으로 연속 공간에서의 역방향 언덕 오르기(Valley Finding / Hill Climbing)입니다.
손실 함수(Loss Function)의 기울기(Gradient) 벡터를 계산하여 가장 가파르게 감소하는 방향으로 가중치를 업데이트하며, 지역 최솟값(Local Minima)과 안장점(Saddle Points)을 극복하기 위해 모멘텀(Momentum)과 Adam 최적화 기법을 결합합니다.
6 최신 LLM과 인공지능 에이전트에서 언덕 오르기의 진화와 결정적 중요성
자연어 초안의 자가 수정(Self-Refine), 강화학습 정책 최적화 및 자동 프롬프트 튜닝(OPRO, TextGrad)
2024~2026년 최신 생성형 인공지능과 거대 언어 모델(LLM) 환경에서 언덕 오르기(Hill Climbing)는 단순한 고전 알고리즘을 넘어, "언어 모델이 스스로 작성한 텍스트를 지속적으로 평가하고 개선하는 자가 수정(Self-Correction) 및 추론 시점 최적화(Test-Time Search)"의 가장 핵심적인 작동 원리로 진화하였습니다.
최신 LLM 에이전트의 자기 개선 파이프라인은 고전 언덕 오르기의 상태-이웃 전이와 완벽하게 일치합니다:
OpenAI o1/o3 및 DeepSeek-R1의 핵심인 GRPO(Group Relative Policy Optimization)와 PPO는 보상 모델(Reward Model)의 기대 보상을 최대화하는 방향으로 모델의 확률 분포(Policy)를 고차원 잠재 공간에서 지속적으로 밀어 올리는 정책 언덕 오르기(Policy Gradient Ascent)입니다.
추론 과정에서 수학적 정답률과 논리적 일관성을 높이는 토큰 생성 패턴으로 모델의 가중치를 점진적으로 상승시킵니다.
구글 딥마인드의 OPRO(Optimization by PROmpting)와 스탠포드의 TextGrad는 프롬프트 자체를 하나의 상태(State)로 취급합니다.
벤치마크 테스트에서 오답이 발생하면, LLM이 오류 패턴을 분석하여 "더 효과적인 새 프롬프트"를 생성하고, 정확도가 올라갔을 때만 프롬프트를 교체하는 자연어 언덕 오르기를 통해 인간 엔지니어보다 뛰어난 프롬프트를 자동으로 찾아냅니다.
LLM이 자기 수정을 수행할 때 가장 자주 범하는 실수가 바로 "자신이 처음에 지어낸 오답(환각)에 집착하여, 겉표현만 다듬고 본질적 논리 오류를 벗어나지 못하는 인지적 지역 최대치(Local Maxima) 고착 현상"입니다.
이를 극복하기 위해 최신 시스템은 Best-of-N 다중 샘플링(무작위 재시작), 복수 에이전트 토론(Multi-Agent Debate), Temperature 조절(모의 담금질)을 결합하여 환각의 함정을 뚫고 전역 최적해로 도약합니다.
🎯 언덕 오르기 원리가 현대 AGI 개발에 주는 핵심 교훈
"완벽한 전역 지도를 모르는 상태에서도, 현재보다 조금 더 나은 방향을 정확히 측정하고 피드백할 수 있다면 거대한 지능의 도약이 가능하다." 언덕 오르기는 인공지능이 외부 감독자 없이 스스로를 지속적으로 성찰하고(Self-Critique), 점수를 매기며(Self-Reward), 더 정밀한 지능으로 수렴해가는 자율 학습(Self-Improvement)의 영원한 나침반입니다.
7 지역 탐색(Local Search) 알고리즘 비교표
기본 언덕 오르기, 무작위 재시작, 모의 담금질(Simulated Annealing), 유전 알고리즘 특성 비교
| 알고리즘 | 공간 복잡도 (메모리) | 지역 최대점 탈출 능력 | 완전성 (Completeness) | 연산 속도 | 핵심 특징 및 평가 |
|---|---|---|---|---|---|
| 기본 언덕 오르기 (Standard Hill Climbing) | O(1) [단일상태] | 불가 (즉시 갇힘) | 아니오 | 극도로 빠름 | 가장 단순하나 지역 최대치와 고원에 매우 취약 |
| 무작위 재시작 언덕 오르기 (Random-Restart) | O(1) | 우수 (다양한 출발점) | 예 (k → ∞ 시) | 반복 횟수에 비례 | 단순하면서도 전역 최적해 발견 확률이 가장 실전적임 |
| 모의 담금질 (Simulated Annealing) | O(1) | 매우 우수 (확률적 하향 허용) | 예 (냉각 스케줄 완만 시) | 보통 | 물리학 볼츠만 분포 확률로 골짜기를 탈출하여 수렴 |
| 유전 알고리즘 (Genetic Algorithms) | O(N × L) [개체군 크기] | 우수 (돌연변이 & 교차) | 휴리스틱 근사 | 다소 느림 | 개체군 간 정보 교환으로 다차원 복잡 지형 탐색에 적합 |
8 언덕 오르기 알고리즘 구현 (Python)
표준 가파른 언덕 오르기(Steepest-Ascent)와 무작위 재시작(Random-Restart) 구현 코드
# Hill Climbing Search & Random-Restart Implementation in Python
import random

def hill_climbing(problem):
    """
    표준 가파른 언덕 오르기 (Steepest-Ascent Hill Climbing)
    현재 상태의 이웃 중 목적 함수 값이 가장 높은 노드로 계속 이동
    """
    current = problem.initial_state()

    while True:
        neighbors = problem.get_neighbors(current)
        if not neighbors:
            break

        # 이웃 중 가장 높은 평가 값을 가진 최선 노드 선택
        best_neighbor = max(neighbors, key=lambda s: problem.value(s))

        # 최선의 이웃도 현재보다 고도가 높지 않으면 지역 최대치(Local Max) 도달로 종료
        if problem.value(best_neighbor) <= problem.value(current):
            break

        current = best_neighbor  # 더 높은 곳으로 한 걸음 전진

    return current

def random_restart_hill_climbing(problem, max_restarts=100):
    """
    무작위 재시작 언덕 오르기: 여러 임의의 시작점에서 시도하여 최고 결과 선택
    """
    best_overall = None
    best_val = -float('inf')

    for _ in range(max_restarts):
        candidate = hill_climbing(problem)
        cand_val = problem.value(candidate)

        if cand_val > best_val:
            best_val = cand_val
            best_overall = candidate

        # 완벽한 전역 최적해를 달성했으면 조기 탈출
        if problem.is_optimal(candidate):
            break

    return best_overall
이 코드는 루프 내부에서 current와 best_neighbor 단 두 개의 상태만을 비교하므로, 메모리 트리를 유지할 필요 없이 상수 공간 O(1)만으로 고속 연산을 수행합니다.
9 원문 학술 레퍼런스 & 멀티미디어 강의
하버드/버클리 대학의 정규 AI 지역 탐색 특강과 석학들의 원문 연구 페이지
Harvard CS50 AI - Local Search & Optimization (Hill Climbing)
언덕 오르기 탐색의 직관적 원리와 지역 최대치, 고원, 모의 담금질로의 확장을 다루는 하버드 대학 AI 정규 강의
Hill Climbing & Local Search Algorithms 해설
상태 공간 지형도 분석과 8-퀸 문제에서의 언덕 오르기 최적화 과정 시각 튜토리얼
📚 원문 학습 자료 및 고전 학술 링크 (Preserved Classical Links)
고전 아카이브의 핵심 논문, 석학 프로필, 인지과학 이론 및 케임브리지 대학 데모를 분야별로 체계적으로 재분류하였습니다.
🏛️ 석학 연구 및 고전 핵심 문헌 (Pioneering Classics)
차이 감소법 (Difference Reduction)
존 R. 앤더슨(John R. Anderson) 교수의 인지 심리학 저작. 인간의 문제 해결 기법과 언덕 오르기 탐색의 인지적 기원을 다룹니다.
함수 최적화 (Function Optimization)
닐스 J. 닐슨(Nils J. Nilsson) 교수의 AI 탐색 이론. 목적 함수 v(s)와 상태 공간 지형(Landscape)에서의 고도 탐색 원리를 정립합니다.
🧠 인지과학 및 문제 해결 기법 (Cognitive & Problem Solving Theory)
수단목표 분석 (Means-Ends Analysis)
언덕 오르기의 근시안적 한계를 넘어 하위 목표(Subgoals)를 통해 전역적 계획을 수립하는 심화 기법.
💻 온라인 인터랙티브 데모 및 핵심 탐색 알고리즘 (Demo & Search Series)
AI 탐색 알고리즘 시리즈 함께 보기
휴리스틱 탐색부터 A* 알고리즘, 지역 최적화 및 모의 담금질까지 단계별로 정복하세요.