복잡성 이론
행복한 프로그래밍 : 임백준, 한빛미디어, 2003, Page 149~155
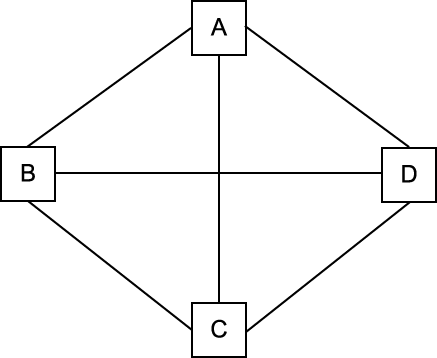
도시 A에서 도시 B에 이르는 도로의 길이를 확인하는데 필요한 계산을 1 이라고 정의하자. 즉 어느 도로의 길이를 측정하는데 걸리는 계산의 양이 1 이다. 그러면 도시 A에서 출발해서 B, C, D 를 거쳐서 다시 A 에 돌아오는데 걸리는 시간을 측정하기 위해서는 그림에서 보는 것처럼 4 만큼의 계산이 필요하다. 즉 해밀토니안 경로 하나가 갖는 전체 길이를 측정하기 위해서 수행해야 하는 계산의 양은 도시의 개수와 동일하다. 문제는 이러한 해밀토니안 경로가 모두 몇 개인가 하는 것이다.
N = 4 인 경우의 세일즈맨 여행 문제
도시의 개수가 N 이라면 출발점에서 선택할 수 있는 길은 모두 N-1 개다. 그림에서 A 가 출발점이라고 했을 때, A에서 선택할 수 있는 길은 3 개다. 두 번째 도시에서 선택할 수 있는 길은 자기 자신과 출발점을 제외한 N-2 가 된다. 이와같은 방식으로 한 걸음씩 전진해 나가면 선택할 수 있는 길의 개수가 하나씩 줄어들게 되므로 N-1 번째 도시에 도착했을 때 선택할 수 있는 길은 출발점으로 향하는 길 한 가지만 남게된다. 결국 가능한 경로의 총 개수는 (N-1)*(N-2)*(N-3)*.....*1, 즉 (N-1)! 이다.
그런데 이 안에는 ABCDA 라는 경로와 ADCBA 라는 경로가 모두 포함되어 있다. 이러한 경로는 방향만 서로 반대일뿐 경로의 전체 길이는 항상 동일하다. 따라서 최단 경로를 찾기위한 계산에서는 두가지 경로를 모두 계산할 필요가 없다. 그렇다고 한다면, 이제 여행하는 세일즈맨의 문제를 해결하기 위해서 수행해야 하는 계산의 총량은 다음과 같이 정해진다는 사실을 알 수 있다.

위의 그림처럼 N 이 4 인 경우에 가장 짧은 경로를 찾기 위해서 수행해야 하는 계산은 (4-1)! 의 값이 3*2*1 = 6 이므로 2 로 나누면 3 이된다. 우리가 1장에서 문제를 풀 때에는 중복되는 경로까지 포함해서 모두 경로 6 개에 대한 길이를 계산했다. 편의상 CPU 가 한번 깜빡거릴 수 있는 CPU (즉, 2 GHz 속도를 가지고 있는 CPU) 에게 3 이라는 계산은 시작과 동시에 끝나 버리는 싱거운 계산에 불과할 것이다.
그렇다면 도시가 4 개에서 5 개로 늘어나면 어떻게 될까? 그 경우에는 계산의 총량이 4!, 즉 4*3*2*1 = 24 를 2 로 나눈 12 가 된다. 이것도 여전히 싱겁다. 그렇다면 도대체 뭐가 '엄청난 계산' 이라는 것일까? 도시의 수를 차례로 증가시켜 보다. 믿기 어려운 일이 벌어진다.
|
N = 6, N = 7, N = 8, N = 9, N = 10, N = 11, N = 12, N = 13, N = 14, N = 15, N = 16, . . . N = 24, |
5!/2 6!/2 7!/2 8!/2 9!/2 10!/2 11!/2 12!/2 13!/2 14!/2 15!/2
23!/2 |
= 5*4*3*2*1/2 = 60 = 6*5*4*3*2*1/2 = 360 = 7*6*5*4*3*2*1/2 = 2,520 = 8*7*6*5*4*3*2*1/2 = 20,160 = 9*8*7*6*5*4*3*2*1/2 = 181,440 = 10*9*8*7*6*5*4*3*2*1/2 = 1,814,400 = 11*10*9*8*7*6*5*4*3*2*1/2 = 19,958,400 = 12*11*10*9*8*7*6*5*4*3*2*1/2 = 239,500,800 = 13*12*11*10*9*8*7*6*5*4*3*2*1/2 = 3,113,510,400 = 14*13*12*11*10*9*8*7*6*5*4*3*2*1/2 = 43,589,145,600 = 15*14*13*12*11*10*9*8*7*6*5*4*3*2*1/2 = 653,837,184,000
= 12,926,008,369,442,488,320,000 |
도시의 수가 16 개에 이르면 이제 최단 경로를 찾기 위해서 계산해봐야 하는 양은 무려 6 천억을 넘어서게 되고 24 개에 이르면 그야말로 상상을 초월하는 횟수의 계산을 필요로 하게 된다. 2 GHz 의 속도를 가지고 있는 CPU 가 한번 깜빡거릴 때마다 해밀토니안 경로 하나를 계산할 수 있다고 해도 도시 24 개에 대해서 계산을 수행하려면 상상을 초월하는 시간이 걸리게 되는 것이다. 하물며 도시의 수가 1,000 이나 10,000 을 넘어선다면 필요한 계산의 양을 하나의 숫자로 적기조차 어려울 지경이 된다. 결국 무식한 힘의 방법은 너무나 엄청난 계산을 필요로 하기 때문에 세일즈맨의 문제를 풀기에 적합한 실용적인 방법이 될 수 없다.
그렇지만 2001 년에 프린스턴 대학교와 라이스 대학교의 학자들은 110 대의 컴퓨터와 평면절단법 (Cutting-Plane Method) 이라는 알고리즘을 동원해서 독일을 뒤덮고 있는 무려 15,112 개에 달하는 도시들을 연결하고 있는 그래프를 대상으로 최적의 경로를 찾아내는데 성공했다. 그렇게 많은 도시를 연결하는 최단 경로를 다른 알고리즘이 아니라 무식한 힘의 방법으로 찾아야 했다고 생각해보자. N 이 15,112 이므로 전체 경로의 수는 15,111!/2 가 될텐데 그수가 얼마나 끔찍하게 큰수가 될지는 말하지 않아도 쉽게 상상할 수 있으리라고 생각한다.
'복잡성 이론 (Complexity Theory)' 이라는 컴퓨터 공학의 한 분야는 이렇게 엄청난 계산을 필요로 하는 복잡한 문제들을 다룬다. 이것은 말 그대로 컴퓨터가 계산하는 여러 가지 문제들에 대한 '복잡성' 자체를 연구하는 분야다. 이 분야의 연구는 구체적인 알고리즘을 개발하는 것과 직접적인 상관은 없지만 어떤 문제가 쉽게 풀릴 수 잇는 문제고 어떤 문제가 쉽게 풀릴 수 없는 문제인지를 구별하도록 해주기 때문에 프로그래머들이 해결할 가능성이 없는 문제를 붙들고 시간을 허비하는 우를 범하지 않도록 해준다. 예를 들어서 1 장에서 용이 세 번째 문제를 냈을 때 기사는 앞의 당구공 문제나 다리를 건너는 문제에서 처럼 절묘한 알고리즘을 찾으려고 노력하지 않고 그냥 "세일즈맨의 여행 문제로군" 이라고 말하면서 모든 경로에 대한 길이를 일일이 구해서 답을 찾았다. 길이 없다면 빨리 돌아갈 줄도 아는 것이 현명한 것이다.
앞서 프로그램의 속도를 분석하는 방법을 공부하면서 알고리즘의 속도가 n 으로표현되는가 아니면 n2 으로 표현되는가 등을 살펴본 바가 있다. 이렇게 속도를 분석할 때 n 이라는 변수에 붙은 지수가 1 이나 2 처럼 미리 정해진 값, 즉 상수 (constant) 로 표현되는 경우에는 그 알고리즘을 '쉬운' 문제라고 간주한다. 지수의 값이 아무리 크다고 해도 그것이 미리 정해진 상수 값이라면 그 알고리즘은 컴퓨터가 적당한 시간 안에 계산해 낼 수 있는 쉬운 알고리즘에 해당하는 것이다. 이렇게 변수위에 붙은 지수가 미리 정해진 상수인 수학 공식을 우리는 (중, 고등학교에서 수학에서 이미 배운 바와 같이) 다항식 (polynomial) 이라고 부른다. 다음은 다항식의 예다.

복잡성 이론에서 다항식의 반대말은 '지수 함수 (exponential function)'다 (고등학교 수학에서는 지수함수의 반대말은 로그함수였다). 지수함수란 변수 위에 붙은 지수가 미리 정해져 있는 상수 값이 아니라 그 자신도 변수로 표현되는 함수를 의미한다. 다음은 지수함수의 예다
2n
혹은 다음과 같다.

앞서 보았던 세일즈맨의 여행 문제를 풀기 위해서 사용했던 factorial 은 다음과 같은 수학 공식으로 표현되므로 다항식이라기보다는 지수함수에 속한다.
n*(n-1)*(n-2)*...*2*1
이 식을 모두 풀어쓰면 가장 차원이 높은 지수를 갖는 항은 맨 앞에 존재하는 n 으로 n-1 이라는 지수를 갖는다는 사실을 알 수 있다. 우리는 방금 n 의 크기가 증가하면 팩토리알 함수 전체의 값이 엄청난 속도로 커진다는 사실을 확인했다. 지수함수의 특징은 바로 n 이 조금만 커지면 함수 전체의 값이 기하 급수적으로 커진다는 사실이다. 현재의 전자식 컴퓨터가 계산을 수행할수 있는 속도에는 엄연히 한계가 존재하기 때문에 계산을 수행해야 하는 양이 지나치게 커지면 컴퓨터도 계산을 수행할수 없게된다. 이렇게 지수함수들은 n 값이 커짐에 따라서 함수의 결과가 엄청나게 빠른 속도로 증가하여 컴퓨터조차 쉽게 계산을 할 수 없기 때문에 '어려운' 문제라고 말한다. 즉 알고리즘의 속도가 다항식이 아니라 지수함수로 표현되면 그것은 어려운 알고리즘인 것이다.
복잡성 이론에서는 알고리즘의 속도가 다항식으로 표현되는 문제들을 묶어서 'P' 라고 부르고, 다항식으로 표현될 수 있는지 여부가 알려지지 않은 문제들을 묶어서 'NP' 라고 부른다. 여기서 P 는 Polynomial (다항식) 의 머리 글자고, NP 는 nondeterministic polynomial (비결정성 다항식) 의 머리 글자를 의미한다. 이때 NP 가 non-polynomial (비다항식) 을 의미하지 않는다는 사실에 유의할 필요가 있다. 다항식이 아니라는 사실과 다항식으로 표현되는지 여부가 아직 알려지지 않았다는 사실 사이에는 엄청난 차이가 존재하기 때문이다. 다항식으로 표현되는 알고리즘은 오늘날의 컴퓨터가 적당한 시간내에 해결할 수 있는 문제기 때문에 P 에 속한 문제들은 '쉬운' 문제들이고, NP 는 그와 반대로 '어려운' 문제를 의미한다.
복잡성 문제를 연구하는 학자들에게 가장 어려운 질문중의 하나는 바로 "NP 에 속하는 문제들이 궁극적으로는 모두 다항식, 즉 쉬운 알고리즘을 이용해서 해결될 수 있을까?" 라는 질문이다. 만약 그렇다면 NP 에 속한 문제나 P 에 속한 문제가 모두 종국에는 다항식으로 표현되기 때문에 'P = NP' 라는 등식이 성립하게 될 것이다. 하지만 NP 에 속하는 문제가 모두 다항식으로 해결될 수 있을지 여부를 파악하거나 증명하는 것이 너무나 어렵기 때문에 이 등식은 아직도 완전하게 입증되지 않은 어려운 명제증의 하나로 통하고 있다.
한편 'NP-hard' 라고 불리는 문제들은 세일즈맨의 여행 문제처럼 모든 경우의 수를 전부 확인해보는 방법 이외에는 정확한 답을 구할 수 있는 뾰족한 수가 없는 문제들을 뜻한다. 어떤 문제가 NP 에 속하면서, 즉 다항식으로 표현될 수 있는지 여부가 알려지지 않았으면서 동시에 NP-hard 에 속한다면, 즉 '무식한 힘' 의 방법말고 다른 절묘한 알고리즘이 알려져 있지 않다면 그 문제는 'NP 완전 문제 (NP complete)' 라고 부른다. 휴, 정말 복잡하다.
컴퓨터 학자들과 프로그래머들은 대개 NP 완전 문제를 실용적인 관점에서 해결하기 위해서 진짜 정답을 찾기를 포기하는 대신 휠씬 적은 양의 계산을 통해서 정답에 가까운 값을 찾는데 만족한다. 이러한 알고리즘은 근사 알고리즘 (approximation algorithm) 혹은 발견적 알고리즘 (heuristic algorithm) 이라고 부른다. 앞서 말한 MST, 탐욕 알고리즘 (Greedy algorithm), 평면절단 방법등은 모두 이러한 알고리즘의 예인데, 실전 프로그래밍의 세계에서는 이러한 근사 알고리즘이 생각보다 많이 사용된다. 예를들어서 1 장에서 보았던 '이상한 공식' 도 구태여 말하자면 근사 알고리즘에 해당하는 셈이다.
이러한 NP 완전 문제에 속하는 문제는 많다. 비밀번호를 깨뜨리기 위한 해킹 과정도 말하자면 이러한 NP 완전 문제에 속한다고 볼 수 있다. 비밀번호를 찾아내기 위한 알고리즘으로는 세일즈맨의 여행 문제에서처럼 문자를 하나씩 대입해 보는 것 말고는 다른 뾰족한 방법이 없기 때문이다. 그렇지만 이렇게 문자를 대입하는 경우에 시도해봐야 하는 경우의 수가 너무나 많기 때문에 이러한 방식으로 비밀번호를 찾아내는 것은 현실적으로 어렵다. 그러나 이론과 현실 사이에는 항상 간극이 존재하기 마련이다. 이론적으로 보았을 때 비밀번호를 깨뜨리는 문제는 NP 완전 문제에 속하도록 되어 있지만 현실은 그렇지 않기 때문에 문제가 발생한다. 우리는 이러한 간극을 뒤에서 곧 확인하게 될 것이다.