(Genetic Algorithms and Traditional Search Methods)
앞 절에서 GA 가 하는 일을 설명하기 위하여 "탐색 (search)" 이라는 용어를 사용하였다. 이 시점에서 "탐색" 의 의미를 컴퓨터 과학에서의 다른 의미들과 비교해 보는 것은 매우 중요하다.
"탐색" 에는 최소한 3 가지의 중복된 의미들이 있다 :
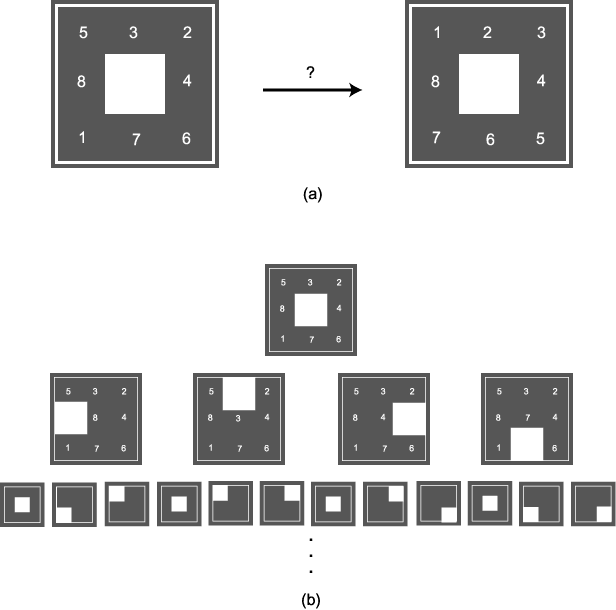
그림 1.2 8 - 퍼즐 (a) 초기상태에서 타일이 올바른 순서대로 놓여있는 상태 (목표상태) 가 되는 이동들의 배열을 찾는 문제 (b) 8 - 퍼즐에 대한 부분 탐색트리
여기서 문제는 컴퓨터 메모리에 저장되어 있는 정보를 효과적으로 추출하는 것이다. 어떤 순서에 의하여 이름과 주소의 대규모 데이터베이스를 가지고 있다고 가정하자. 주어진 이름에 해당하는 레코드를 탐색하는 가장 좋은 방법은 무엇인가? "이진탐색 (Binary search)" 은 원하는 레코드를 효과적으로 발견하는 한 방법이다. Knuth (1973) 은 많은 그러한 탐색방법들을 설명, 분석하고 있다.
주어진 초기상태로부터 주어진 목표에까지 이동하는 일련의 행동들을 효과적으로 찾아내는 것이다. 이런 형태의 탐색은 인공지능에서의 많은 접근방법에 있어서 중심적이다. 인공지능 과목을 수강한 사람에게는 누구나 친숙한 한 간단한 예가 그림 1.2 에 도시되어 있는 "8 - 퍼즐 (8 - puzzle)" 이다. 1 부터 8 까지 번호가 매겨져있는 타일들이 정사각형 형태로 배치되어 있고 한 구역이 빈칸으로 되어있다. 인접한 타일들 중 하나를 빈칸으로 보내는 것을 "이동 (move)" 이라고 부른다. 그림 1a 는 초기상태로부터 모든 타일들이 순서대로 나열된 상태가 되도록 하는 일련의 이동들을 찾아내는 문제를 보여준다. 이 문제와 관련된 부분 탐색트리가 그림 1b 에 예시되어 있다. "뿌리 (root)" 노드는 초기 상태를 보여주고 그것으로부터 가지쳐 나오는 노드들은 그 상태로부터의 한번 이동가능한 모든 경우들을 나타낸다. 대부분의 AI 문헌에서 논의되는 탐색 알고리즘들은 초기상태로부터 목표상태에 도달하는 그 트리에서 가장 좋은 (여기서는 가장 짧은) 경로를 효과적으로 찾아내는 방법들이다. 대표적인 알고리즘들은 "깊이-우선 탐색 (depth-first search)," "branch and bound," 그리고 "A*" 이다.
3) 해의 탐색 (search for solution) :
이것은 "목표에 이르는 경로의 탐색" 보다 더 일반적인 부류의 탐색이다. 이 아이디어는 어떤 문제에 대한 후보해들의 광범위한 공간에서 원하는 해를 효과적으로 찾아내는 것이다. 이것들은 유전자 알고리즘들이 사용될 수 있는 종류의 탐색문제들이다.
첫 번째 종류의 탐색과 다음의 두 탐색들과는 분명히 큰 차이가 있다. 첫 번째는 명확하게 저장되어 있는 정보들의 집합에서 부분정보 (예를 들어 전화번호) 를 찾아내어야 하는 문제를 다룬다. 다음 두 문제에서는 탐색될 정보가 명확하게 저장되어 있지 않고 탐색과정이 진행되어 감에 따라 후보해들이 만들어진다. 예를 들어 8 - 퍼즐을 풀기 위한 AI 탐색방법들은 모든 노드들이 메모리에 이미 저장되어 있는 완전한 탐색트리를 가지고 시작하지 않는다. 대부분의 흥미있는 문제들에 있어서는 탐색트리에서 가능한 노드들이 너무 많으므로 모두 저장할 수 없다. 그 보다는 특정 알고리즘에 따라 다른 방식으로 탐색트리가 단계적으로 구체화되고, 목표는 그 트리의 작은 부분만을 검색함으로써 최적 또는 좋은 해를 찾아내는 것이다. 마찬가지로 GA 를 가지고 후보해들의 공간을 탐색할 때에도 모든 가능한 후보해들이 먼저 만들어지고 평가하는 것이 아니다. GA 는 가능한 후보들의 일부분만을 검사함으로써 최적해 또는 좋은 해를 탐색하는 방법이다.
탐색트리에 있어서의 탐색경로는 후보해로써 부호화될 수 있으므로 "해의 탐색" 은 "목표에 도달하는 경로의 탐색" 을 내포하고 있다고 볼 수 있다. 8 - 퍼즐에 대해서 후보해들은 초기상태로부터 어떤 다른 상태로의 이동 (최종상태가 목표상태일 경우만 올바른) 들의 열거이다. 그러나 많은 "목표에 이르는 경로탐색" 문제들이 (평가되기 전에 전체 후보해들이 생성되어야 하는) GA 또는 GA 와 유사한 기술들보다 (부분해들이 평가될 수 있는) AI 의 트리탐색 기술에 의해 더 잘 해결될 수 있다.
그러나 표준 AI 트리탐색 (tree-search) (또는 보다 일반적으로 그래프탐색 (graph-search)) 방법들은 항상 적용되지는 않는다. 모든 문제들이 초기상태로부터 목표로의 경로를 찾아내어야 하는 것은 아니다. 예를 들어 아미노산의 배열로부터 어떤 단백질의 3 차원 구조를 예측하는 것은 단백질이 접혀져서 3 차원 구조로 되는 물리적인 이동의 배열을 반드시 알아야 되는 것은 아니고 최종 3 차원 구조가 예측될 수 있으면 된다. 또한 단백질 예측문제를 포함한 많은 문제들에 대해서 목표상태의 구성은 미리 알려져 있지 않다.
GA 는 (진화전략과 진화 프로그래밍과 같이 진화에 기반한 그 밖의 다른 기술들처럼) "해의 탐색" 문제들을 풀기 위한 일반적인 방법이다. 등반 (hill climbing), 시뮬레이티드 어닐링 (simulated annealing), 그리고 tabu 탐색 (tabu search) 은 다른 일반적인 방법들의 예이다. 이들 몇몇은 branch-and-bound 와 A* 와 같은 "목표에 이르는 경로의 탐색" 방법들과 비슷하다. 이들 그리고 다른 탐색방법들에 대한 설명은 Winston (1992), Glover (1989, 1990), 그리고 Kirkpatrick, Gellatt, and Vecchi (1983) 을 참조하라.
예를 들어 "최급 상승 (steepest-ascent)" 등반은 다음과 같이 동작한다 :
1. 후보해를 (예를 들어 비트 문자열로 부호화하여) 임의로 하나 선택한다. 이 문자열을 현재-문자열이라고 부른다.
2. 왼쪽에서 오른쪽으로 문자열에서의 각 비트를 체계적으로 돌연변이 시키면서 얻어지는 문자열의 적합도를 기록한다.
3. 결과로 얻어지는 문자열들 중에서 적합도가 증가한 것이 있으면, 현재-문자열을 적합도가 가장 많이 증가한 ("최급 상승") 문자열으로 바꾼다.
4. 적합도가 증가하지 않았으면 현재-문자열 ("봉우리") 을 저장하고 단계 1 로 간다. 그렇지 않으면 새로운 현재-문자열을 가지고 단계 2 로 간다.
5. 적합도-함수의 평가를 여러 번 실행하였을 때 발견된 가장 높은 봉우리를 돌려준다.
AI 에서는 그러한 일반적인 방법들 (아주 다양한 문제들에 적용될 수 있는 방법들) 을 "약한 방법 (weak methods)" 이라고 부르며, 특정한 문제들에 적용되도록 특별히 고안된 "강한 방법 (strong methods)" 들과 구별하고 있다. 모든 "해의 탐색" 방법들은 (1) 초기에 후보해들의 집합을 발생시키고 (GA 에서 이것은 초기 개체집단이고, 최급 상승 등반에서 이것은 초기 문자열과 그것의 1 비트 변형이다.) (2) 어떤 적합도 기준에 의해서 후보해들을 평가한다. (3) 이 평가에 기초하여 어떤 후보해를 보존하고 어떤 후보해를 버릴 것인지를 결정한다. (4) 살아남은 후보해들에 어떤 종류의 연산자를 적용하여 그 이상의 변형을 만들어 낸다.
유전자 알고리즘에서 원소들의 특정한 결합 - 많은 개체의 확률적인 선택, 확률적인 교배와 돌연변이를 가지는 병렬 개체 집단에 기초한 탐색 - 에 의해 다른 탐색방법들과 구별된다. 많은 다른 탐색방법들은 이들 원소중 몇몇은 가지고 있지만 이와 같이 결합되어 있지 않다.